

1. Introduction
Plus de 80% des données d'entreprise sont stockées dans des formats non structurés (manuels d'ingénierie au format PDF, procédures opérationnelles normalisées, certificats de conformité et schémas d'équipement) dans Cloud Storage. Étant donné que les catalogues traditionnels n'indexent que les schémas de tables relationnelles, ces documents restent des données obscures : invisibles pour la recherche d'entreprise, déconnectés des tables d'inventaire structurées et non vérifiés pour la conformité réglementaire.
Lorsqu'un auditeur ou un agent d'IA pose la question "Quels SKU matériels nécessitent la certification de sécurité UL-153 et quels sont leurs niveaux de risque thermique ?", un catalogue qui n'indexe que les tables SQL ne peut pas y répondre. Les faits sont enfermés dans des PDF non structurés dans Cloud Storage.
Solution architecturale : métadonnées multimodales en tant que code
Dans cet atelier de programmation, vous allez créer un pipeline Metadata-as-Code de bout en bout dans Google Cloud qui transforme les manuels PDF non structurés dans Cloud Storage en composants Knowledge Catalog avec validation du schéma à l'aide de Gemini Enterprise Agent Platform (SDK Google GenAI, google-genai) :
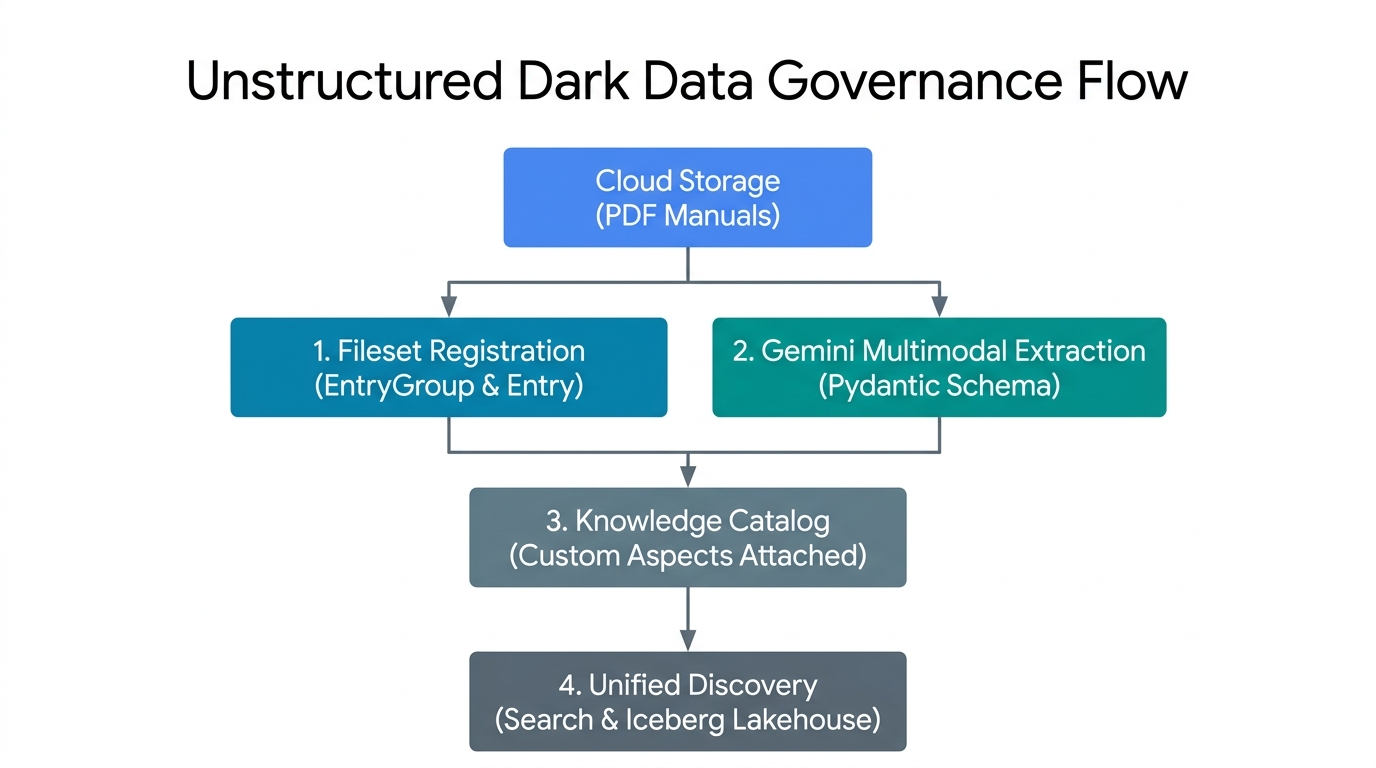
- Enregistrement d'ensembles de fichiers (
EntryGroupetEntry) : regroupe les PDF non structurés dans Cloud Storage en entrées d'ensembles de fichiers logiques régies dans Knowledge Catalog. - Gemini Multimodal Extraction (schéma Pydantic) : appelle Gemini Enterprise Agent Platform sur les octets PDF bruts avec une validation
response_schemadéterministe. - Liaison d'aspect du plan de contrôle : associe les charges utiles JSON validées pour les opérations et la conformité en tant qu'instances
Aspectfortement typées dans l'entrée de catalogue. - Découverte unifiée du catalogue : permet de découvrir les ensembles de fichiers PDF non structurés et leurs métadonnées extraites via
SearchEntriesRequest.
Concepts clés : primitives du plan de contrôle Knowledge Catalog
Imaginons que votre équipe stocke des centaines de manuels de produits au format PDF dans Cloud Storage. Pour retrouver et consulter facilement ces fichiers dans Knowledge Catalog, imaginez les cinq composants de base comme des manuels papier rangés dans un classeur de bureau :
EntryGroup(armoire verrouillée pour une équipe) : armoire avec une serrure. Seuls les membres de l'équipe disposant de l'autorisationroles/dataplex.entryCreatorpeuvent placer des dossiers à l'intérieur. Vous devez vider tous les dossiers du meuble avant de pouvoir le retirer.EntryType(libellé de catégorie de dossier) : libellé qui indique aux utilisateurs le type de composant que représente un dossier (par exemple, "Collection de manuels au format PDF" au lieu de "Table de base de données").Entry(dossier de fichiers avec un lien de stockage) : dossier de catalogue pour vos manuels au format PDF. Au lieu de contenir des copies papier volumineuses, le dossier contient une fiche d'emplacement indiquant le bucket Cloud Storage (gs://...) exact où se trouvent les fichiers PDF.AspectType(formulaire de checklist vide) : formulaire vide réutilisable avec des cases préremplies (par exemple, une checklist de sécurité demandantoperational_hazard_levelsous forme de texte etconfidence_scoresous forme de nombre compris entre0.0et1.0). Vous créez ce formulaire vide une seule fois et le réutilisez dans des milliers de dossiers.Aspect(Liste de contrôle remplie associée à un dossier) : une fois que Gemini Enterprise Agent Platform a lu le manuel au format PDF et rempli les champs vides, la liste de contrôle remplie est associée au dossierEntry. Comme chaque checklist possède sa propre clé (aspect_keys), l'équipe d'ingénieurs et l'équipe juridique peuvent chacune joindre leur propre checklist au même dossier sans écraser le travail de l'autre.
Les cinq ressources régionales se trouvent sous projects/{project}/locations/{location}/ :
Chemin primitif et relatif | Rôle dans Knowledge Catalog | Règle de suppression et IAM |
| Conteneur logique qui regroupe les entrées et contrôle l'accès des équipes ( | Doit contenir zéro ressource enfant |
| Définition de catégorie pour une classe d'assets ( | Ne supprimez-le qu'une fois que toutes les entrées utilisant ce type ont été supprimées. |
| Enregistrement de catalogue associant un URI Cloud Storage physique ( | Se trouve dans un |
| Modèle de schéma réutilisable définissant les | Créé une fois par région et partagé entre les entrées. |
| Métadonnées JSON validées correspondant à un | Mise à jour à l'aide de |
Ce que vous allez faire
À l'aide des scripts associés dans codelabs/metadata-as-code-lab, vous allez exécuter et inspecter un pipeline en sept étapes :
schemas.py: schémas PydanticBaseModeldoubles (DarkDataExtractedMetadataetDocumentGovernanceMetadata) associés un à un aux modèles Knowledge CatalogAspectType.step2_provision.py: provisionnement idempotent des plansEntryGroup,EntryTypeetAspectTypepersonnalisés.step3_register_fileset.py: importation deLUM-LIG-DES-8G8J_manual.pdfdans Cloud Storage et enregistrement en tant que Fileset régiEntry.step4_extract_metadata.py: découverte dynamique du modèle Gemini phare et extraction multimodale de PDF à l'aide degoogle-genai.step5_attach_aspects.py,step6_search_catalog.pyetstep7_verify_assertions.py: pièce jointe sur l'aspect chirurgical, recherche de catalogue avec interruption exponentielle et assertions de plan de contrôle de bout en bout.
Conditions préalables et ce dont vous avez besoin
- Un projet Google Cloud avec la facturation activée et Google Cloud Shell (préinstallé avec
gcloud,git,python3etpip). - Autorisations IAM pour gérer les ressources du catalogue de connaissances (
roles/dataplex.admin), provisionner les buckets et les objets Cloud Storage (roles/storage.admin) et appeler Gemini Enterprise Agent Platform (roles/aiplatform.user). - Un navigateur Web tel que Google Chrome.
2. Préparation
Cloner le dépôt associé dans Cloud Shell
Ouvrez la console Google Cloud, lancez Cloud Shell, puis effectuez un checkout sparse de codelabs/metadata-as-code-lab, qui inclut l'exemple de manuel d'ingénierie au format PDF (LUM-LIG-DES-8G8J_manual.pdf) et tous les scripts Python :
git clone --branch main --depth 1 --filter=blob:none --sparse \
  https://github.com/GoogleCloudPlatform/devrel-demos.git
cd devrel-demos
git sparse-checkout set codelabs/metadata-as-code-lab
cd codelabs/metadata-as-code-lab
ls -la
Configurer les variables d'environnement
Définissez votre ID de projet, l'emplacement du plan de contrôle régional et le bucket Cloud Storage cible dans Cloud Shell :
export PROJECT_ID="${PROJECT_ID:-$(gcloud config get-value project)}"
gcloud config set project $PROJECT_ID

export REGION="us-central1"
export BUCKET_NAME="${PROJECT_ID}-dark-data-manuals"
export GEMINI_LOCATION="global"

echo "Configured Project ID        : $PROJECT_ID"
echo "Knowledge Catalog Region     : $REGION"
echo "Gemini Endpoint Location     : $GEMINI_LOCATION"
echo "Target Cloud Storage Bucket  : $BUCKET_NAME"
Activer les API et installer les dépendances
Activez les API Google Cloud requises et installez les dépendances Python (google-genai, google-cloud-dataplex, pydantic et pandas) à partir de requirements.txt :
gcloud services enable \
  dataplex.googleapis.com \
  storage.googleapis.com \
  aiplatform.googleapis.com \
  --quiet
python3 -m pip install --upgrade --quiet --user --break-system-packages -r requirements.txt
3. Définir des schémas Pydantic et des modèles d'aspects
schemas.py définit deux contrats complémentaires qui associent la validation Pydantic côté client aux modèles Knowledge Catalog AspectType côté serveur :
DarkDataExtractedMetadata: attributs opérationnels extraits du PDF (titre du document, ontologie du domaine, niveau de risque pour la sécurité, provenance de l'auteur/de la version, résumé et score de confiance de l'extraction).DocumentGovernanceMetadata: codes de conformité réglementaire (UL-153, FCC Part 15, CE-LVD, RoHS), responsable de la gestion, règle de conservation et chaîne d'identifiant de table de référence (lakehouse_cross_ref_table) pour associer le manuel PDF aux tables d'inventaire en aval.
Inspecter schemas.py
Tout d'abord, DarkDataExtractedMetadata utilise les contraintes Pydantic Field (ge=0.0, le=1.0, c'est-à-dire supérieur/inférieur ou égal à, sur confidence_score) pour contraindre la sortie JSON de Gemini Enterprise Agent Platform :
class DarkDataExtractedMetadata(BaseModel):
    document_title: str = Field(
        description="Official document title or product model name extracted from the PDF manual."
    )
    # ... domain_ontology, operational_hazard_level, author_provenance ...
    version_provenance: str = Field(
        description="Document version, revision code, or publication standard identifier."
    )
    # ... document_summary ...
    confidence_score: float = Field(
        ge=0.0,
        le=1.0,
        description="AI extraction confidence metric between 0.0 and 1.0.",
    )
Ensuite, extracted_aspect_template reflète ces noms de champs exacts et mappe les types str et float de Python aux types string et double record_fields de Knowledge Catalog. Notez que le contrat protobuf AspectType.MetadataTemplate exige que chaque champ de record_fields déclare un index unique, strictement positif et basé sur 1 (de 1 à 7). Si vous omettez ou dupliquez index, create_aspect_type échouera avec 400 INVALID_ARGUMENT :
extracted_aspect_template = {
    "name": "DarkDataExtractedMetadata",
    "type": "record",
    "record_fields": [
        {
            "name": "document_title",
            "type": "string",
            "index": 1,
            "annotations": {"description": "Official document title or product model name."},
        },
        # ... fields 2 through 6 (string) ...
        {
            "name": "confidence_score",
            "type": "double",
            "index": 7,
            # ... annotations ...
        },
    ],
}
Valider le module de schéma
Exécutez schemas.py pour vérifier la configuration de votre environnement et compiler les deux schémas :
python3 schemas.py
Configured Project ID         : your-project-id
Knowledge Catalog Region      : us-central1
Gemini Endpoint Location      : global
Governed Fileset Storage URI  :
  gs://your-project-id-dark-data-manuals/sop-pdfs/LUM-LIG-DES-8G8J_manual.pdf
Target Fileset Entry ID       : sop-manuals-fileset-lum8g8j
✓ Defined DarkDataExtractedMetadata and DocumentGovernanceMetadata
  Pydantic schemas.
✓ Prepared Knowledge Catalog AspectType metadata templates.
4. Provisionner des espaces de noms et des types d'aspects personnalisés
Avant d'enregistrer des entrées d'ensemble de fichiers ou d'associer des métadonnées, step2_provision.py provisionne trois ressources de plan de contrôle dans Knowledge Catalog :
EntryGroup:dark-data-fileset-groupEntryType:unstructured-pdf-filesetAspectTypePlans :dark-data-extracted-metadataetdocument-governance-aspect
Provisionnement idempotent dans step2_provision.py
Chaque appel de création dans step2_provision.py encapsule l'opération de longue durée (op.result()) dans un bloc try / except AlreadyExists afin que le script puisse être réexécuté en toute sécurité sans échouer sur les ressources existantes :
# Provision AspectType 1: dark-data-extracted-metadata
try:
    at1_op = catalog_client.create_aspect_type(
        parent=parent_location,
        aspect_type_id=EXTRACTED_ASPECT_TYPE_ID,
        aspect_type=AspectType(
            name=extracted_aspect_type_name,
            display_name="Dark Data Multimodal Extracted Metadata",
            # ... description ...
            metadata_template=extracted_aspect_template,
        ),
    )
    if hasattr(at1_op, "result"):
        at1_op.result()
    print(f"Created AspectType: {extracted_aspect_type_name}")
except AlreadyExists:
    print(f"AspectType already exists; retrieving live resource: {extracted_aspect_type_name}")

live_extracted_aspect_type = catalog_client.get_aspect_type(name=extracted_aspect_type_name)
Une fois metadata_template=extracted_aspect_template enregistré, Knowledge Catalog applique le schéma à la limite de l'API. Tout appel update_entry() ultérieur qui transmet une chaîne à confidence_score (double) est refusé.
Exécuter step2_provision.py
Exécutez le script de provisionnement et vérifiez que les types d'aspect personnalisés sont enregistrés dans votre région :
python3 step2_provision.py
gcloud dataplex aspect-types list --location=$REGION
Created EntryGroup:
  projects/your-project-id/locations/us-central1/entryGroups/
  dark-data-fileset-group
Created EntryType :
  projects/your-project-id/locations/us-central1/entryTypes/
  unstructured-pdf-fileset
Created AspectType:
  projects/your-project-id/locations/us-central1/aspectTypes/
  dark-data-extracted-metadata
Created AspectType:
  projects/your-project-id/locations/us-central1/aspectTypes/
  document-governance-aspect
✓ All Knowledge Catalog namespaces and AspectType blueprints are active.
5. Enregistrer des entrées d'ensembles de fichiers non structurés
Au lieu d'encombrer le catalogue avec des millions de pointeurs de fichiers isolés, Knowledge Catalog regroupe les documents associés dans Cloud Storage (gs://YOUR_BUCKET/sop-pdfs/*.pdf) en entrées d'ensemble de fichiers logiques, soit par le biais d'analyses de découverte automatisées (DataScanServiceClient), soit par un enregistrement programmatique direct (CatalogServiceClient.create_entry).
Comment step3_register_fileset.py mappe le stockage au catalogue
step3_register_fileset.py importe LUM-LIG-DES-8G8J_manual.pdf dans gs://${BUCKET_NAME}/sop-pdfs/LUM-LIG-DES-8G8J_manual.pdf et enregistre le Entry régi :
fully_qualified_fileset_uri = f"gcs:{BUCKET_NAME}"
fileset_entry_spec = Entry(
    name=fileset_entry_name,
    entry_type=entry_type_resource_name,
    fully_qualified_name=fully_qualified_fileset_uri,
    entry_source=EntrySource(
        resource=VIRTUAL_STORAGE_URI,
        system="Cloud Storage",
        platform="Google Cloud",
        display_name="LUM-LIG-DES-8G8J Unstructured SOP & Technical Manual Fileset",
        # ... description ...
        location=REGION,
    ),
)

create_entry_op = catalog_client.create_entry(
    parent=entry_group_resource_name,
    entry_id=FILESET_ENTRY_ID,
    entry=fileset_entry_spec,
)
Notez les rôles distincts des deux champs URI sur Entry :
fully_qualified_name=fully_qualified_fileset_uri(f"gcs:{BUCKET_NAME}") : utilise le schéma FQNgcs:{bucket_name}canonique requis par Knowledge Catalog pour corréler l'entrée de catalogue logique avec le bucket Cloud Storage sous-jacent.entry_source.resource=VIRTUAL_STORAGE_URI: stocke l'URI de l'objetgs://physique inspecté par les workers d'extraction en aval.
Exécuter step3_register_fileset.py
python3 step3_register_fileset.py
Created Cloud Storage bucket:
  gs://your-project-id-dark-data-manuals in us-central1
Uploaded unstructured PDF manual to:
  gs://your-project-id-dark-data-manuals/sop-pdfs/LUM-LIG-DES-8G8J_manual.pdf
Registered governed Fileset Entry:
  projects/your-project-id/locations/us-central1/entryGroups/
  dark-data-fileset-group/entries/sop-manuals-fileset-lum8g8j
  -> Fully Qualified Name : gcs:your-project-id-dark-data-manuals
  -> Physical Resource URI:
  gs://your-project-id-dark-data-manuals/sop-pdfs/LUM-LIG-DES-8G8J_manual.pdf
  -> Source System        : Cloud Storage
6. Extraire les métadonnées d'un document avec Gemini
step4_extract_metadata.py lit les octets PDF bruts et appelle Gemini Enterprise Agent Platform (genai_client.models.generate_content) à l'aide de deux modèles clés :
1. Découverte dynamique des modèles phares
Au lieu de coder en dur des chaînes de version de modèle fragiles, le script interroge genai_client.models.list() et trie les candidats actifs par (is_ga_channel, semantic_version_tuple) pour choisir le modèle flash en disponibilité générale (DG) le plus récent :
genai_client = genai.Client(
    vertexai=True,
    project=PROJECT_ID,
    location=GEMINI_LOCATION,
)

for model_obj in genai_client.models.list():
    raw_id = (model_obj.name or "").split("/")[-1]
    # Filter to flagship Gemini Flash models (version >= 3.0) and prioritize GA over preview
    ...
    discovered_candidates.append((is_ga_channel, ver_tuple, raw_id))

discovered_candidates.sort(key=lambda item: (item[0], item[1]), reverse=True)
2. Extraction multimodale avec contraintes de schéma (Part.from_bytes + response_schema)
Le passage de response_mime_type="application/json" et response_schema=DarkDataExtractedMetadata (suivi de DocumentGovernanceMetadata) contraint le décodage des jetons directement au schéma JSON Pydantic :
with open(LOCAL_PDF_PATH, "rb") as pdf_file:
    raw_pdf_bytes = pdf_file.read()

extraction_response = genai_client.models.generate_content(
    model=candidate_model,
    contents=[
        types.Part.from_bytes(data=raw_pdf_bytes, mime_type="application/pdf"),
        extraction_prompt,
    ],
    config=types.GenerateContentConfig(
        response_mime_type="application/json",
        response_schema=DarkDataExtractedMetadata,
        temperature=0.1,
    ),
)

extracted_dark_data = json.loads(extraction_response.text)
validated_extraction = DarkDataExtractedMetadata(**extracted_dark_data)
Exécuter step4_extract_metadata.py
python3 step4_extract_metadata.py
Dynamically discovered active GA model currency :
  gemini-3.8-flash (version (3, 8))
Loaded unstructured PDF manual at: LUM-LIG-DES-8G8J_manual.pdf
Read unstructured PDF document (1184 bytes).
  Executing multimodal extraction with gemini-3.8-flash...
✓ Multimodal extraction completed using model: gemini-3.8-flash
✓ Governance classification completed using model: gemini-3.8-flash

--- Extracted Multimodal Operational Metadata ---
Extracted Attribute    Multimodal Value
document_title    LUM-LIG-DES-8G8J Contemporary Linen Desk Lamp
domain_ontology    Electrical Hardware & Lighting Systems
operational_hazard_level    MEDIUM
author_provenance    Global Hardware Safety & Lighting Systems Engin
version_provenance    Rev 4.2
document_summary    This document outlines standard operating proce
confidence_score    0.99

--- Extracted Governance & Inventory Cross-Reference Metadata ---
Governance Attribute    Classification Value
compliance_classifications    UL-153 Portable Luminaires, FCC Part 15, CE-LVD
stewardship_owner    Global Hardware Safety & Lighting Systems Engin
retention_policy    10-Year Active Product Lifecycle Archival
lakehouse_cross_ref_table    lakehouse.your-project-id.retail_hardware
governance_status    VERIFIED_PRODUCTION
7. Associer des aspects validés à des entrées de catalogue
step5_attach_aspects.py lie les charges utiles JSON validées (extracted_metadata.json et governance_metadata.json) à l'entrée sop-manuals-fileset-lum8g8j via catalog_client.update_entry().
Mutation de l'aspect chirurgical dans step5_attach_aspects.py
extracted_aspect_key = f"{PROJECT_ID}.{REGION}.{EXTRACTED_ASPECT_TYPE_ID}"
governance_aspect_key = f"{PROJECT_ID}.{REGION}.{GOVERNANCE_ASPECT_TYPE_ID}"

updated_entry_payload = Entry(
    name=fileset_entry_name,
    entry_type=entry_type_resource_name,
    fully_qualified_name=fully_qualified_fileset_uri,
    aspects={
        extracted_aspect_key: Aspect(
            aspect_type=extracted_aspect_type_name,
            data=extracted_data,
        ),
        governance_aspect_key: Aspect(
            aspect_type=governance_aspect_type_name,
            data=governance_data,
        ),
    },
)

update_op = catalog_client.update_entry(
    request=dataplex_v1.UpdateEntryRequest(
        entry=updated_entry_payload,
        update_mask={"paths": ["aspects"]},
        aspect_keys=[extracted_aspect_key, governance_aspect_key],
    )
)
Si vous transmettez les deux scopes update_mask={"paths": ["aspects"]} et aspect_keys=[extracted_aspect_key, governance_aspect_key], la mutation sera strictement limitée à ces deux clés d'aspect, ce qui laissera entry_source et tous les aspects appartenant à d'autres équipes intacts.
Exécuter step5_attach_aspects.py
python3 step5_attach_aspects.py
Successfully bound 2 Aspect(s) to Entry:
  projects/your-project-id/locations/us-central1/entryGroups/
  dark-data-fileset-group/entries/sop-manuals-fileset-lum8g8j

=== Live Attached Aspect: document-governance-aspect ===
Catalog Field    Authoritative Stored Value
compliance_classifications    UL-153 Portable Luminaires, FCC Part 15, CE-LVD
stewardship_owner    Global Hardware Safety & Lighting Systems Engin
retention_policy    10-Year Active Product Lifecycle Archival
lakehouse_cross_ref_table    lakehouse.your-project-id.retail_hardware
governance_status    VERIFIED_PRODUCTION

=== Live Attached Aspect: dark-data-extracted-metadata ===
Catalog Field    Authoritative Stored Value
document_title    LUM-LIG-DES-8G8J Contemporary Linen Desk Lamp
domain_ontology    Electrical Hardware & Lighting Systems
operational_hazard_level    MEDIUM
author_provenance    Global Hardware Safety & Lighting Systems Engin
version_provenance    Rev 4.2
document_summary    This document outlines standard operating proce
confidence_score    0.99
Validation à double canal
- Piste 1 (validation par CLI) : inspectez l'entrée avec tous les aspects associés via
gcloud:gcloud dataplex entries describe sop-manuals-fileset-lum8g8j \ --entry-group=dark-data-fileset-group \ --location=$REGION \ --view=ALL - Parcours 2 (Inspection de l'UI de la console) :
- Ouvrez la Search Console Knowledge Catalog, recherchez LUM-LIG-DES-8G8J Unstructured SOP & Technical Manual Fileset (
sop-manuals-fileset-lum8g8j), puis sélectionnez l'entrée correspondante dans les résultats. - Sous Tags et aspects facultatifs, vérifiez que les aspects Métadonnées extraites multimodales des données obscures et Aspect de référence croisée pour la gouvernance et l'inventaire des documents affichent le niveau de risque extrait (
MEDIUM), les codes de conformité (UL-153, FCC Part 15, CE-LVD, RoHS) et la chaîne de table de référence croisée (lakehouse_cross_ref_table).
- Ouvrez la Search Console Knowledge Catalog, recherchez LUM-LIG-DES-8G8J Unstructured SOP & Technical Manual Fileset (
8. Interroger les données obscures régies dans le catalogue
Une fois les aspects personnalisés associés, les manuels PDF non structurés dans Cloud Storage deviennent détectables grâce à la recherche Knowledge Catalog (catalog_client.search_entries()).
Sondage search_entries() dans step6_search_catalog.py
step6_search_catalog.py interroge search_entries() avec un intervalle exponentiel entre les tentatives et lit les clés d'aspect canoniques via .endswith() :
search_query = f"entrygroup={entry_group_resource_name} name:{FILESET_ENTRY_ID}"

while elapsed_seconds < max_wait_seconds:
    catalog_search_results = list(
        catalog_client.search_entries(
            request=dataplex_v1.SearchEntriesRequest(
                name=parent_location,
                query=search_query,
            )
        )
    )
    if catalog_search_results:
        break
    backoff_seconds = min(5 * (2 ** attempt), 30)
    time.sleep(backoff_seconds)
    ...

for k, asp in detailed_entry.aspects.items():
    if k.endswith(f".{REGION}.{EXTRACTED_ASPECT_TYPE_ID}"):
        print(f"    Domain Ontology     : {asp.data.get('domain_ontology')}")
        print(f"    Hazard Level        : {asp.data.get('operational_hazard_level')}")
    elif k.endswith(f".{REGION}.{GOVERNANCE_ASPECT_TYPE_ID}"):
        print(f"    Compliance Codes    : {asp.data.get('compliance_classifications')}")
        print(f"    Lakehouse Join Table: {asp.data.get('lakehouse_cross_ref_table')}")
Exécuter step6_search_catalog.py
python3 step6_search_catalog.py
Executing Knowledge Catalog search query:
  'entrygroup=projects/your-project-id/locations/us-central1/entryGroups/
  dark-data-fileset-group name:sop-manuals-fileset-lum8g8j'...

✓ Discovered 1 governed asset(s) in Knowledge Catalog:

[1] Entry Resource Name :
    projects/your-project-id/locations/us-central1/entryGroups/
    dark-data-fileset-group/entries/sop-manuals-fileset-lum8g8j
    Fully Qualified Name: gcs:your-project-id-dark-data-manuals
    Entry Type :
    projects/your-project-id/locations/us-central1/entryTypes/
    unstructured-pdf-fileset
    Physical Storage URI:
    gs://your-project-id-dark-data-manuals/sop-pdfs/LUM-LIG-DES-8G8J_manual.pdf
    Domain Ontology     : Electrical Hardware & Lighting Systems
    Hazard Level        : MEDIUM
    Compliance Codes    : UL-153 Portable Luminaires, FCC Part 15, CE-LVD, RoHS
    Lakehouse Join Table:
    lakehouse.your-project-id.retail_hardware.luminaire_sku_inventory_iceberg
Validation à double canal
- Piste 1 (recherche CLI) : interrogez l'index de recherche directement via
gcloud:gcloud dataplex entries search "name:sop-manuals-fileset-lum8g8j" --project=$PROJECT_ID - Piste 2 (recherche en langage naturel dans l'UI de la console) :
- Ouvrez la Search Console Knowledge Catalog et recherchez
LUM-LIG-DES-8G8JouUL-153. - Observez comment Knowledge Catalog affiche l'entrée d'ensemble de fichiers PDF Cloud Storage contrôlée et ses aspects de métadonnées associés.
- Ouvrez la Search Console Knowledge Catalog et recherchez
9. Valider les assertions de gouvernance de bout en bout
step7_verify_assertions.py exécute des assertions déterministes sur les réponses du plan de contrôle Knowledge Catalog en direct pour vérifier que les EntryGroup, EntryType, les deux plans personnalisés AspectType, les charges utiles d'aspect liées EntryView.ALL (limites confidence_score et chaîne lakehouse_cross_ref_table) et la découverte de l'index de recherche réussissent tous :
verify_eg = catalog_client.get_entry_group(name=entry_group_resource_name)
assert verify_eg.name == entry_group_resource_name, "EntryGroup resource name mismatch."

verify_entry = catalog_client.get_entry(
    request=dataplex_v1.GetEntryRequest(
        name=fileset_entry_name,
        view=dataplex_v1.EntryView.ALL,
    )
)
bound_extracted = next(
    (
        asp for k, asp in verify_entry.aspects.items()
        if k.endswith(f".{REGION}.{EXTRACTED_ASPECT_TYPE_ID}")
    ),
    None,
)
bound_governance = next(
    (
        asp for k, asp in verify_entry.aspects.items()
        if k.endswith(f".{REGION}.{GOVERNANCE_ASPECT_TYPE_ID}")
    ),
    None,
)

assert bound_extracted is not None, f"Aspect '{EXTRACTED_ASPECT_TYPE_ID}' not found on live Entry."
assert bound_governance is not None, (
    f"Aspect '{GOVERNANCE_ASPECT_TYPE_ID}' not found on live Entry."
)
assert (
    bound_extracted.data.get("document_title") == expected_extraction["document_title"]
), "Extracted title mismatch."
assert (
    0.0 <= float(bound_extracted.data.get("confidence_score", -1.0)) <= 1.0
), "Invalid confidence score in catalog."
assert (
    "lakehouse" in str(bound_governance.data.get("lakehouse_cross_ref_table", "")).lower()
), "Missing Lakehouse cross-reference."
...
assert len(search_results) >= 1, "Expected at least 1 search result in Knowledge Catalog."
Exécuter step7_verify_assertions.py
python3 step7_verify_assertions.py && echo "Verification exit code: $?"
Running substantive end-to-end verification assertions...
✓ All 5 substantive verification assertions passed
  against live Google Cloud control plane state!
Verification exit code: 0
10. Concevoir un pipeline basé sur des événements
L'exécution interactive de scripts Python dans Cloud Shell est idéale pour créer et tester vos contrats de gouvernance. Toutefois, les environnements d'entreprise reçoivent quotidiennement des milliers de manuels d'ingénierie, de certificats de conformité des fournisseurs et de documents de procédures opérationnelles (SOP) nouveaux ou révisés provenant des portails ERP, PLM (Product Lifecycle Management) et des fournisseurs. L'exécution manuelle de scripts de traitement par lot crée rapidement des angles morts de gouvernance entre l'importation de documents et l'indexation du catalogue.
En production, les équipes de plate-forme opérationnalisent le code exact que vous avez exécuté aux étapes 4 et 5 en tant que pipeline sans intervention et basé sur les événements :
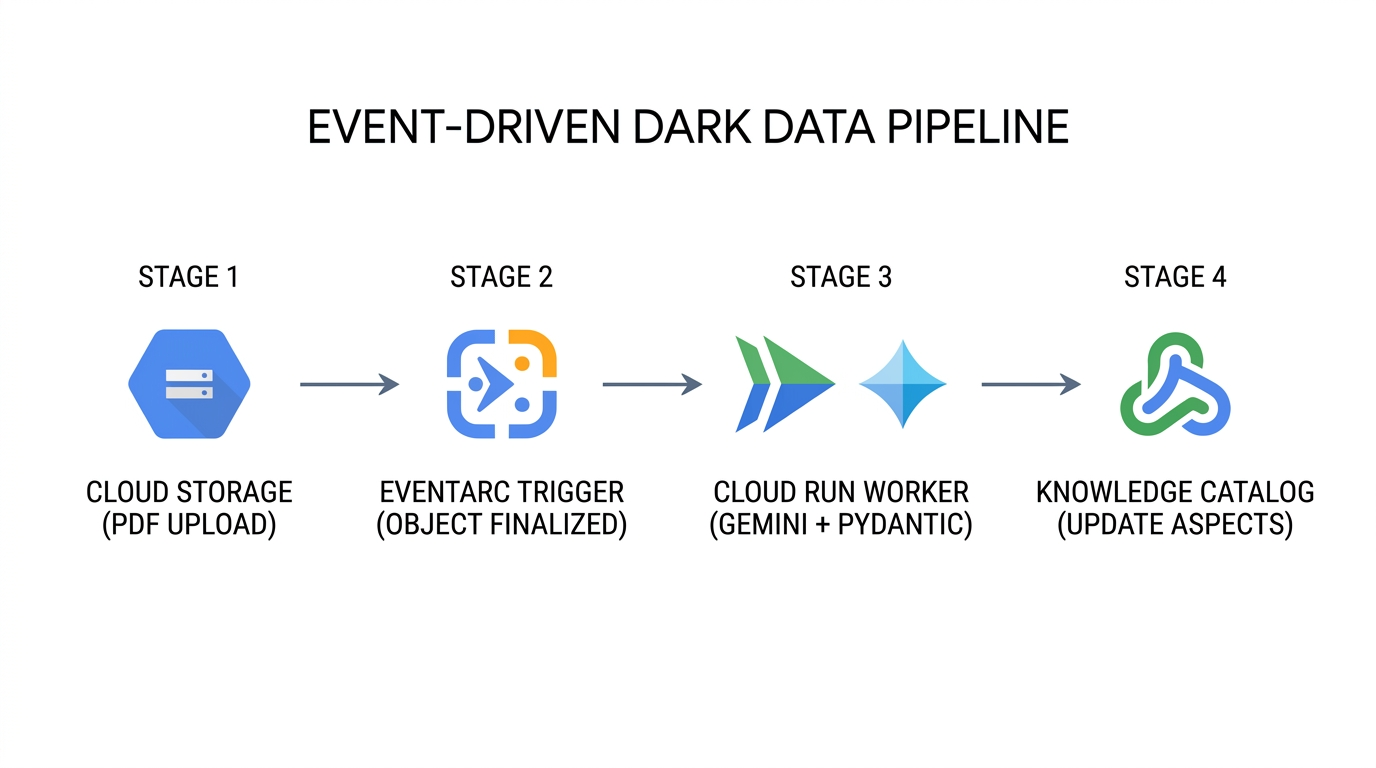
- Ingestion continue de documents (
Cloud Storage→Eventarc) : chaque fois qu'un nouveau manuel au format PDF est importé ou qu'une nouvelle révision remplace un objet existant dans Cloud Storage, le bucket émet un CloudEventgoogle.cloud.storage.object.v1.finalizedcontenant l'identifiant du bucket, le chemin d'accès à l'objet et le numéro de génération de l'objet. - Extraction multimodale sans état (
Eventarc→Cloud Run→Gemini Enterprise Agent Platform) : Eventarc achemine le CloudEvent vers un worker Cloud Run sans serveur qui regroupeschemas.py,step4_extract_metadata.pyetstep5_attach_aspects.py. Le worker transmet les octets PDF à Gemini Enterprise Agent Platform avecresponse_schemaappliqué, ce qui garantit que chaque attribut extrait est conforme àDarkDataExtractedMetadataetDocumentGovernanceMetadata. - Mise à jour du plan de contrôle chirurgical (
Cloud Run→Knowledge Catalog) : le worker résout le fichier parentEntryet exécutecatalog_client.update_entry()avecupdate_mask={"paths": ["aspects"]}etaspect_keysexplicite. Même si des dizaines de documents finissent d'être traités simultanément, chaque mutation ne met à jour que les clés d'aspect désignées. - Mise en quarantaine des responsables basée sur le degré de confiance : si l'extraction d'un ancien PDF analysé génère un
confidence_scoreinférieur à votre seuil opérationnel (par exemple,< 0.85), le responsable définitgovernance_status = "PENDING_STEWARD_REVIEW"sur l'aspect associé afin que les responsables des données puissent interroger Knowledge Catalog pour trouver les composants à faible degré de confiance nécessitant un examen humain.
Comment les entreprises appliquent ce modèle en production
Cas d'utilisation Enterprise | Fonctionnement pratique des métadonnées en tant que code | Impact commercial et opérationnel |
Audits réglementaires automatisés et préparation aux rappels | Les systèmes de conformité associent les aspects de sécurité des PDF non structurés ( | Lorsqu'une norme telle que |
Agents d'IA ancrés et préfiltrage RAG | Avant qu'un agent de génération augmentée par récupération (RAG) sur Gemini Enterprise Agent Platform ne réponde à la question d'un ingénieur sur le terrain, il filtre les entrées du Knowledge Catalog par | Empêche les assistants IA d'halluciner ou de citer des brouillons d'ingénierie obsolètes, des procédures opérationnelles standard expirées ou des manuels tiers non vérifiés. |
Enrichissement simultané par plusieurs équipes | Plusieurs pipelines indépendants enrichissent le même ensemble de fichiers | Étant donné que les modifications des champs |
Évolution du schéma CI/CD via GitOps | Les équipes chargées des plates-formes stockent | Élimine la dérive de schéma entre le code d'extraction d'application et le plan de contrôle Knowledge Catalog dans les projets |
11. Nettoyer votre environnement
Dans Knowledge Catalog, les conteneurs parents et les modèles de schéma ne peuvent pas être supprimés tant que des entrées enfants les référencent. cleanup.py supprime les ressources dans l'ordre inverse strict des dépendances (objets de bucket Cloud Storage → fichiers JSON temporaires → AspectTypes → EntryType → EntryGroup → Entry) :
# 1. Delete Fileset Entry first
catalog_client.delete_entry(name=target_entry_path)

# 2. Delete EntryGroup container
del_eg_op = catalog_client.delete_entry_group(name=target_eg_path)
if hasattr(del_eg_op, "result"):
    del_eg_op.result()

# 3. Delete EntryType and Custom AspectTypes
del_et_op = catalog_client.delete_entry_type(name=target_et_path)
if hasattr(del_et_op, "result"):
    del_et_op.result()
for aspect_id_val in (EXTRACTED_ASPECT_TYPE_ID, GOVERNANCE_ASPECT_TYPE_ID):
    target_at_path = f"{active_parent}/aspectTypes/{aspect_id_val}"
    del_at_op = catalog_client.delete_aspect_type(name=target_at_path)
    if hasattr(del_at_op, "result"):
        del_at_op.result()
Exécuter cleanup.py
python3 cleanup.py
Starting reverse-dependency resource cleanup in Knowledge Catalog...
Deleted Fileset Entry:
  projects/your-project-id/locations/us-central1/entryGroups/
  dark-data-fileset-group/entries/sop-manuals-fileset-lum8g8j
Deleted EntryGroup   :
  projects/your-project-id/locations/us-central1/entryGroups/
  dark-data-fileset-group
Deleted EntryType    :
  projects/your-project-id/locations/us-central1/entryTypes/
  unstructured-pdf-fileset
Deleted AspectType   :
  projects/your-project-id/locations/us-central1/aspectTypes/
  dark-data-extracted-metadata
Deleted AspectType   :
  projects/your-project-id/locations/us-central1/aspectTypes/
  document-governance-aspect
Deleted Cloud Storage object :
  gs://your-project-id-dark-data-manuals/sop-pdfs/LUM-LIG-DES-8G8J_manual.pdf
Deleted Cloud Storage bucket : gs://your-project-id-dark-data-manuals
Removed local temporary file : extracted_metadata.json
Removed local temporary file : governance_metadata.json
✓ Standalone teardown complete. Environment cleanly reset.
Supprimer le répertoire du dépôt cloné
Une fois que cleanup.py a fini de supprimer les ressources cloud, revenez à votre répertoire d'accueil et supprimez le dossier du dépôt devrel-demos cloné de Cloud Shell :
cd ~
rm -rf ~/devrel-demos
12. Félicitations !
Vous avez créé et validé un pipeline de gouvernance Metadata-as-Code de bout en bout qui transforme les PDF non structurés dans Cloud Storage en éléments Knowledge Catalog détectables et conformes au schéma à l'aide de Gemini Enterprise Agent Platform.
Étape suivante
- Automatisez avec Terraform : gérez les ressources
google_dataplex_aspect_typeetgoogle_dataplex_entry_groupde manière déclarative dans les pipelines CI/CD. - Déployer des workers Eventarc et Cloud Run : conteneurisez
step4_extract_metadata.pyetstep5_attach_aspects.pydans un service Cloud Run axé sur les événements. - Joindre l'inventaire en aval dans BigQuery : exportez les métadonnées de gouvernance extraites (
lakehouse_cross_ref_table) pour joindre les attributs de conformité des documents non structurés aux tables d'inventaire des SKU structurées.