

1. מבוא
יותר מ-80% מהנתונים של ארגונים נמצאים בפורמטים לא מובְנים – מדריכים הנדסיים בפורמט PDF, נהלי הפעלה סטנדרטיים (SOP), אישורי תאימות וסכימות של ציוד שמאוחסנים ב-Cloud Storage. מכיוון שקטלוגים מסורתיים מבצעים אינדוקס רק לסכימות של טבלאות יחסיות, המסמכים האלה נשארים "נתונים לא גלויים": הם לא גלויים לחיפוש פנים-ארגוני, לא מקושרים לטבלאות מלאי מובנות ולא עוברים אימות לצורך עמידה בתקנות.
כשבודק או סוכן AI שואלים "אילו מק"טים של חומרה דורשים אישור בטיחות UL-153 ומהן רמות הסיכון התרמי שלהם?", קטלוג שמבצע אינדוקס רק של טבלאות SQL לא יכול לענות. העובדות נעולות בתוך קובצי PDF לא מובְנים ב-Cloud Storage.
פתרון ארכיטקטוני: מטא-נתונים מולטי-מודאליים כקוד
בשיעור ה-Codelab הזה נסביר איך ליצור צינור Metadata-as-Code מקצה לקצה ב-Google Cloud, שממיר מדריכים לא מובנים בפורמט PDF ב-Cloud Storage לנכסי Knowledge Catalog עם אכיפת סכימה באמצעות Gemini Enterprise Agent Platform (Google GenAI SDK, google-genai):
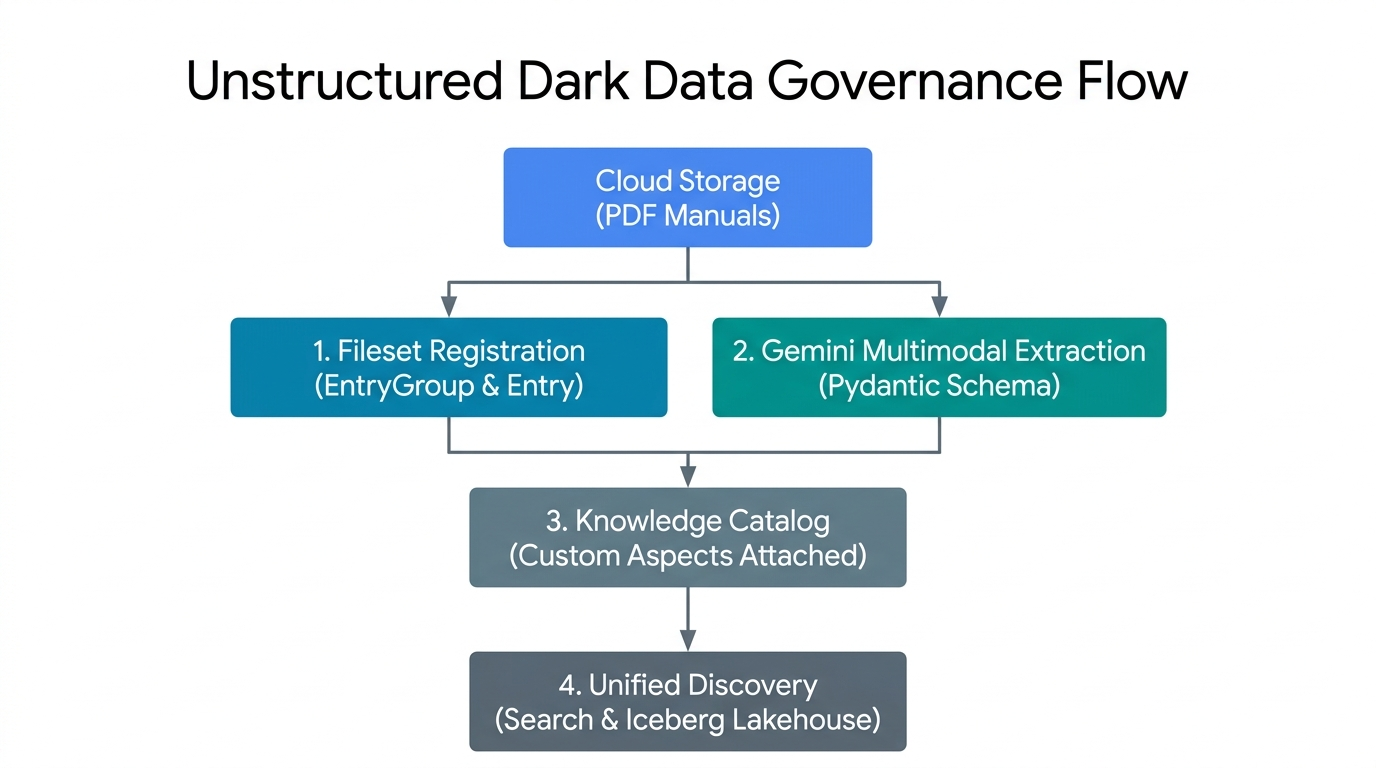
- רישום של קבוצת קבצים (
EntryGroupו-Entry): מקבץ קובצי PDF לא מובנים ב-Cloud Storage לרשומות מנוהלות של קבוצת קבצים לוגית ב-Knowledge Catalog. - Gemini Multimodal Extraction (Pydantic Schema): מפעיל את Gemini Enterprise Agent Platform על בייטים של PDF גולמיים עם אימות דטרמיניסטי של
response_schema. - Control Plane Aspect Binding: מחבר את מטען ה-JSON של התאימות והתפעול שאומת כמו מופעים מוקלדים חזק של
Aspectברשומה בקטלוג. - גילוי מאוחד של קטלוגים: מאפשר לגלות את קבוצות הקבצים הלא מובְנים בפורמט PDF ואת המטא-נתונים שחולצו מהם באמצעות
SearchEntriesRequest.
מושגי מפתח: פרימיטיבים של מישור הבקרה ב-Knowledge Catalog
נניח שהצוות שלכם מאחסן מאות מדריכים למוצרים בפורמט PDF ב-Cloud Storage. כדי שיהיה קל למצוא את הקבצים האלה ולבדוק אותם בKnowledge Catalog, אפשר לחשוב על חמש אבני הבניין כמו על ארגון של מדריכים מודפסים בארון מסמכים במשרד:
EntryGroup(ארון נעול לצוות אחד): ארון עם מנעול. רק חברי צוות שיש להם הרשאה (roles/dataplex.entryCreator) יכולים להוסיף תיקיות. כדי להסיר את הארון עצמו, צריך לרוקן את כל התיקיות שבו.EntryType(תווית של קטגוריית תיקייה): תווית שמסבירה לאנשים איזה סוג של נכס התיקייה מייצגת – לדוגמה, "אוסף מדריכים בפורמט PDF" במקום "טבלת מסד נתונים".-
Entry(תיקיית קבצים עם קישור לאחסון): תיקיית הקטלוג של מדריכי ה-PDF. במקום להחזיק עותקים כבדים מנייר, התיקייה מכילה כרטיס מיקום שמפנה לקטגוריה המדויקת (gs://...) ב-Cloud Storage שבה נמצאים קובצי ה-PDF האמיתיים. AspectType(טופס ריק של רשימת משימות): טופס ריק לשימוש חוזר עם תיבות מודפסות מראש (לדוגמה, רשימת משימות לבדיקת בטיחות שבה צריך להזין אתoperational_hazard_levelכטקסט ואתconfidence_scoreכמספר מ-0.0עד1.0). אתם יוצרים את הטופס הריק הזה פעם אחת ומשתמשים בו שוב ושוב באלפי תיקיות.-
Aspect(רשימת משימות מלאה שמצורפת לתיקייה): אחרי ש-Gemini Enterprise Agent Platform קורא את מדריך ה-PDF וממלא את החסר, רשימת המשימות המלאה הזו מצורפת לתיקייהEntry. לכל רשימת משימות יש מפתח משלה (aspect_keys), ולכן צוות ההנדסה והצוות המשפטי יכולים לצרף כל אחד רשימת משימות משלו לאותה תיקייה בלי לדרוס את העבודה של הצד השני.
כל חמשת המשאבים האזוריים נמצאים ב-projects/{project}/locations/{location}/:
נתיב פרימיטיבי ויחסי | התפקיד ב-Knowledge Catalog | כלל מחיקה ו-IAM |
| מאגר לוגי שכולל קבוצות של רשומות ושולט בגישה של הצוות ( | לפני המחיקה, לא יכולים להיות משאבי צאצא |
| הגדרת קטגוריה לסוג נכסים ( | מוחקים רק אחרי שמסירים את כל הרשומות שמשתמשות בסוג הזה. |
| רשומה בקטלוג שמקשרת URI פיזי של Cloud Storage ( | נמצא בתוך |
| תבנית סכימה לשימוש חוזר שמגדירה שדות מוקלדים | נוצר פעם אחת לכל אזור ומשותף בין כל הרשומות. |
| מטא-נתונים מאומתים בפורמט JSON שתואמים ל- | העדכון מתבצע באמצעות |
מה תפַתחו
באמצעות סקריפטים נלווים ב-codelabs/metadata-as-code-lab, תריצו ותבדקו צינור עיבוד נתונים בן 7 שלבים:
-
schemas.py— סכימות כפולות של PydanticBaseModel(DarkDataExtractedMetadataו-DocumentGovernanceMetadata) שמשויכות ביחס של 1:1 לתבניות של Knowledge CatalogAspectType. -
step2_provision.py— הקצאת הרשאות ידנית למכונות שלEntryGroup,EntryTypeו-AspectTypeבהתאמה אישית. -
step3_register_fileset.py— העלאה שלLUM-LIG-DES-8G8J_manual.pdfאל Cloud Storage ורישום כקובץ נתונים מנוהלEntry. -
step4_extract_metadata.py— גילוי דינמי של מודל Gemini מוביל וחילוץ מולטי-מודאלי של קובצי PDF באמצעותgoogle-genai. -
step5_attach_aspects.py,step6_search_catalog.pyו-step7_verify_assertions.py– צירוף של היבט כירורגי, חיפוש קטלוג עם נסיגה אקספוננציאלית וטענות של מישור בקרה מקצה לקצה.
דרישות מוקדמות ומה צריך להכין
- פרויקט ב-Google Cloud שבו מופעל החיוב ו-Google Cloud Shell (עם התקנה מראש של
gcloud,git,python3ו-pip). - הרשאות IAM לניהול משאבים של Knowledge Catalog (
roles/dataplex.admin), להקצאת קטגוריות ואובייקטים של Cloud Storage (roles/storage.admin) ולהפעלת Gemini Enterprise Agent Platform (roles/aiplatform.user). - דפדפן אינטרנט כמו Google Chrome.
2. הגדרה ודרישות
שכפול מאגר הנתונים הנלווה ב-Cloud Shell
פותחים את מסוף Google Cloud, מפעילים את Cloud Shell ומבצעים sparse checkout של codelabs/metadata-as-code-lab, שכולל את מדריך ההנדסה לדוגמה בפורמט PDF (LUM-LIG-DES-8G8J_manual.pdf) ואת כל סקריפטי Python:
git clone --branch main --depth 1 --filter=blob:none --sparse \
  https://github.com/GoogleCloudPlatform/devrel-demos.git
cd devrel-demos
git sparse-checkout set codelabs/metadata-as-code-lab
cd codelabs/metadata-as-code-lab
ls -la
הגדרת משתני סביבה
מגדירים את מזהה הפרויקט, את המיקום של מישור הבקרה האזורי ואת קטגוריית היעד של Cloud Storage ב-Cloud Shell:
export PROJECT_ID="${PROJECT_ID:-$(gcloud config get-value project)}"
gcloud config set project $PROJECT_ID

export REGION="us-central1"
export BUCKET_NAME="${PROJECT_ID}-dark-data-manuals"
export GEMINI_LOCATION="global"

echo "Configured Project ID        : $PROJECT_ID"
echo "Knowledge Catalog Region     : $REGION"
echo "Gemini Endpoint Location     : $GEMINI_LOCATION"
echo "Target Cloud Storage Bucket  : $BUCKET_NAME"
הפעלת ממשקי API והתקנת יחסי תלות
מפעילים את ממשקי ה-API הנדרשים של Google Cloud ומתקינים את יחסי התלות של Python (google-genai, google-cloud-dataplex, pydantic ו-pandas) מ-requirements.txt:
gcloud services enable \
  dataplex.googleapis.com \
  storage.googleapis.com \
  aiplatform.googleapis.com \
  --quiet
python3 -m pip install --upgrade --quiet --user --break-system-packages -r requirements.txt
3. הגדרת סכימות Pydantic ותבניות של היבטים
schemas.py מגדיר שני חוזים משלימים שמשלבים אימות Pydantic בצד הלקוח עם תבניות של Knowledge Catalog AspectType בצד השרת:
-
DarkDataExtractedMetadata: מאפיינים תפעוליים שחולצו מקובץ ה-PDF (שם המסמך, אונטולוגיה של הדומיין, רמת סיכון הבטיחותי, מקורות של יצירה/גרסה, סיכום מנהלים וציון רמת הביטחון בחילוץ). -
DocumentGovernanceMetadata: קודי עמידה בתקנות (UL-153, FCC Part 15, CE-LVD, RoHS), בעלים של ניהול מוצר, מדיניות שמירת נתונים ומחרוזת מזהה של טבלת הפניה (lakehouse_cross_ref_table) לקישור המדריך ב-PDF לטבלאות מלאי במורד הזרם.
בדיקה schemas.py
קודם כל, DarkDataExtractedMetadata משתמש באילוצים של Pydantic (Field, ge=0.0, le=1.0 כלומר גדול/קטן או שווה ל-, ב-confidence_score) כדי להגביל את פלט ה-JSON של Gemini Enterprise Agent Platform:
class DarkDataExtractedMetadata(BaseModel):
    document_title: str = Field(
        description="Official document title or product model name extracted from the PDF manual."
    )
    # ... domain_ontology, operational_hazard_level, author_provenance ...
    version_provenance: str = Field(
        description="Document version, revision code, or publication standard identifier."
    )
    # ... document_summary ...
    confidence_score: float = Field(
        ge=0.0,
        le=1.0,
        description="AI extraction confidence metric between 0.0 and 1.0.",
    )
בשלב השני, extracted_aspect_template משכפל את שמות השדות האלה בדיוק וממפה את הסוגים str ו-float של Python לסוגים string ו-double של Knowledge Catalog record_fields. שימו לב: בחוזה של AspectType.MetadataTemplate protobuf, כל שדה ב-record_fields צריך להצהיר על מספר שלם ייחודי וחיובי מ-1 (index) (1 עד 7). אם משמיטים את index או משכפלים אותו, create_aspect_type ייכשל עם השגיאה 400 INVALID_ARGUMENT:
extracted_aspect_template = {
    "name": "DarkDataExtractedMetadata",
    "type": "record",
    "record_fields": [
        {
            "name": "document_title",
            "type": "string",
            "index": 1,
            "annotations": {"description": "Official document title or product model name."},
        },
        # ... fields 2 through 6 (string) ...
        {
            "name": "confidence_score",
            "type": "double",
            "index": 7,
            # ... annotations ...
        },
    ],
}
אימות מודול הסכימה
מריצים את הפקודה schemas.py כדי לאמת את הגדרת הסביבה ולבצע קומפילציה של שתי הסכימות:
python3 schemas.py
Configured Project ID         : your-project-id
Knowledge Catalog Region      : us-central1
Gemini Endpoint Location      : global
Governed Fileset Storage URI  :
  gs://your-project-id-dark-data-manuals/sop-pdfs/LUM-LIG-DES-8G8J_manual.pdf
Target Fileset Entry ID       : sop-manuals-fileset-lum8g8j
✓ Defined DarkDataExtractedMetadata and DocumentGovernanceMetadata
  Pydantic schemas.
✓ Prepared Knowledge Catalog AspectType metadata templates.
4. הקצאת מרחבי שמות וסוגים של היבטים מותאמים אישית
לפני רישום של רשומות של קבוצת קבצים או צירוף מטא-נתונים, step2_provision.py מקצה שלושה משאבים של מישור הבקרה בקטלוג הידע:
EntryGroup:dark-data-fileset-groupEntryType:unstructured-pdf-fileset-
AspectTypeשרטוטים:dark-data-extracted-metadataו-document-governance-aspect
הקצאת הרשאות אידמפוטנטית ב-step2_provision.py
כל קריאה ליצירה ב-step2_provision.py עוטפת את הפעולה הממושכת (op.result()) בבלוק try / except AlreadyExists, כך שאפשר להריץ מחדש את הסקריפט בצורה בטוחה בלי שהוא ייכשל במשאבים קיימים:
# Provision AspectType 1: dark-data-extracted-metadata
try:
    at1_op = catalog_client.create_aspect_type(
        parent=parent_location,
        aspect_type_id=EXTRACTED_ASPECT_TYPE_ID,
        aspect_type=AspectType(
            name=extracted_aspect_type_name,
            display_name="Dark Data Multimodal Extracted Metadata",
            # ... description ...
            metadata_template=extracted_aspect_template,
        ),
    )
    if hasattr(at1_op, "result"):
        at1_op.result()
    print(f"Created AspectType: {extracted_aspect_type_name}")
except AlreadyExists:
    print(f"AspectType already exists; retrieving live resource: {extracted_aspect_type_name}")

live_extracted_aspect_type = catalog_client.get_aspect_type(name=extracted_aspect_type_name)
אחרי שרושמים את metadata_template=extracted_aspect_template, Knowledge Catalog אוכף את הסכימה בגבולות ה-API – כל קריאה ל-update_entry() שמעבירה מחרוזת ל-confidence_score (double) נדחית.
מריצים את step2_provision.py
מריצים את סקריפט ההקצאה ומוודאים שסוגי ההיבטים המותאמים אישית רשומים באזור שלכם:
python3 step2_provision.py
gcloud dataplex aspect-types list --location=$REGION
Created EntryGroup:
  projects/your-project-id/locations/us-central1/entryGroups/
  dark-data-fileset-group
Created EntryType :
  projects/your-project-id/locations/us-central1/entryTypes/
  unstructured-pdf-fileset
Created AspectType:
  projects/your-project-id/locations/us-central1/aspectTypes/
  dark-data-extracted-metadata
Created AspectType:
  projects/your-project-id/locations/us-central1/aspectTypes/
  document-governance-aspect
✓ All Knowledge Catalog namespaces and AspectType blueprints are active.
5. רישום של רשומות לא מובנות של קבוצת קבצים
במקום להעמיס על הקטלוג מיליוני מצביעים מבודדים לקבצים, Knowledge Catalog מקבץ מסמכים קשורים ב-Cloud Storage (gs://YOUR_BUCKET/sop-pdfs/*.pdf) לרשומות של קבוצות קבצים לוגיות – באמצעות סריקות גילוי אוטומטיות (DataScanServiceClient) או רישום תוכנתי ישיר (CatalogServiceClient.create_entry).
איך step3_register_fileset.py ממפה את האחסון לקטלוג
step3_register_fileset.py uploads LUM-LIG-DES-8G8J_manual.pdf to gs://${BUCKET_NAME}/sop-pdfs/LUM-LIG-DES-8G8J_manual.pdf and registers the governed Entry:
fully_qualified_fileset_uri = f"gcs:{BUCKET_NAME}"
fileset_entry_spec = Entry(
    name=fileset_entry_name,
    entry_type=entry_type_resource_name,
    fully_qualified_name=fully_qualified_fileset_uri,
    entry_source=EntrySource(
        resource=VIRTUAL_STORAGE_URI,
        system="Cloud Storage",
        platform="Google Cloud",
        display_name="LUM-LIG-DES-8G8J Unstructured SOP & Technical Manual Fileset",
        # ... description ...
        location=REGION,
    ),
)

create_entry_op = catalog_client.create_entry(
    parent=entry_group_resource_name,
    entry_id=FILESET_ENTRY_ID,
    entry=fileset_entry_spec,
)
שימו לב לתפקידים השונים של שני שדות ה-URI ב-Entry:
-
fully_qualified_name=fully_qualified_fileset_uri(f"gcs:{BUCKET_NAME}"): משתמש בסכימתgcs:{bucket_name}FQN קנונית שנדרשת על ידי Knowledge Catalog כדי ליצור קורלציה בין רשומת הקטלוג הלוגית לבין קטגוריית Cloud Storage הבסיסית. -
entry_source.resource=VIRTUAL_STORAGE_URI: מאחסן את ה-URI הפיזי של אובייקטgs://שנבדק על ידי עובדי חילוץ במורד הזרם.
מריצים את step3_register_fileset.py
python3 step3_register_fileset.py
Created Cloud Storage bucket:
  gs://your-project-id-dark-data-manuals in us-central1
Uploaded unstructured PDF manual to:
  gs://your-project-id-dark-data-manuals/sop-pdfs/LUM-LIG-DES-8G8J_manual.pdf
Registered governed Fileset Entry:
  projects/your-project-id/locations/us-central1/entryGroups/
  dark-data-fileset-group/entries/sop-manuals-fileset-lum8g8j
  -> Fully Qualified Name : gcs:your-project-id-dark-data-manuals
  -> Physical Resource URI:
  gs://your-project-id-dark-data-manuals/sop-pdfs/LUM-LIG-DES-8G8J_manual.pdf
  -> Source System        : Cloud Storage
6. חילוץ מטא-נתונים של מסמך באמצעות Gemini
step4_extract_metadata.py קורא את הבייטים הגולמיים של ה-PDF ומפעיל את Gemini Enterprise Agent Platform (genai_client.models.generate_content) באמצעות שני דפוסי מפתח:
1. גילוי דינמי של מודל הדגל
במקום להגדיר מחרוזות של גרסאות מודל בקידוד קשיח, הסקריפט שולח שאילתה אל genai_client.models.list() וממיין את המועמדים הפעילים לפי (is_ga_channel, semantic_version_tuple) כדי לבחור את מודל flash החדש ביותר שזמין לכולם:
genai_client = genai.Client(
    vertexai=True,
    project=PROJECT_ID,
    location=GEMINI_LOCATION,
)

for model_obj in genai_client.models.list():
    raw_id = (model_obj.name or "").split("/")[-1]
    # Filter to flagship Gemini Flash models (version >= 3.0) and prioritize GA over preview
    ...
    discovered_candidates.append((is_ga_channel, ver_tuple, raw_id))

discovered_candidates.sort(key=lambda item: (item[0], item[1]), reverse=True)
2. חילוץ מולטי-מודאלי מוגבל על ידי סכימה (Part.from_bytes + response_schema)
העברת response_mime_type="application/json" ו-response_schema=DarkDataExtractedMetadata (ואחריהם DocumentGovernanceMetadata) מגבילה את פענוח האסימון ישירות לסכימת ה-JSON של Pydantic:
with open(LOCAL_PDF_PATH, "rb") as pdf_file:
    raw_pdf_bytes = pdf_file.read()

extraction_response = genai_client.models.generate_content(
    model=candidate_model,
    contents=[
        types.Part.from_bytes(data=raw_pdf_bytes, mime_type="application/pdf"),
        extraction_prompt,
    ],
    config=types.GenerateContentConfig(
        response_mime_type="application/json",
        response_schema=DarkDataExtractedMetadata,
        temperature=0.1,
    ),
)

extracted_dark_data = json.loads(extraction_response.text)
validated_extraction = DarkDataExtractedMetadata(**extracted_dark_data)
מריצים את step4_extract_metadata.py
python3 step4_extract_metadata.py
Dynamically discovered active GA model currency :
  gemini-3.8-flash (version (3, 8))
Loaded unstructured PDF manual at: LUM-LIG-DES-8G8J_manual.pdf
Read unstructured PDF document (1184 bytes).
  Executing multimodal extraction with gemini-3.8-flash...
✓ Multimodal extraction completed using model: gemini-3.8-flash
✓ Governance classification completed using model: gemini-3.8-flash

--- Extracted Multimodal Operational Metadata ---
Extracted Attribute    Multimodal Value
document_title    LUM-LIG-DES-8G8J Contemporary Linen Desk Lamp
domain_ontology    Electrical Hardware & Lighting Systems
operational_hazard_level    MEDIUM
author_provenance    Global Hardware Safety & Lighting Systems Engin
version_provenance    Rev 4.2
document_summary    This document outlines standard operating proce
confidence_score    0.99

--- Extracted Governance & Inventory Cross-Reference Metadata ---
Governance Attribute    Classification Value
compliance_classifications    UL-153 Portable Luminaires, FCC Part 15, CE-LVD
stewardship_owner    Global Hardware Safety & Lighting Systems Engin
retention_policy    10-Year Active Product Lifecycle Archival
lakehouse_cross_ref_table    lakehouse.your-project-id.retail_hardware
governance_status    VERIFIED_PRODUCTION
7. צירוף היבטים מאומתים לרשומות בקטלוג
step5_attach_aspects.py קושר את מטען הייעודי (payload) של JSON שאומת (extracted_metadata.json ו-governance_metadata.json) לרשומה sop-manuals-fileset-lum8g8j באמצעות catalog_client.update_entry().
מוטציה של היבט כירורגי ב-step5_attach_aspects.py
extracted_aspect_key = f"{PROJECT_ID}.{REGION}.{EXTRACTED_ASPECT_TYPE_ID}"
governance_aspect_key = f"{PROJECT_ID}.{REGION}.{GOVERNANCE_ASPECT_TYPE_ID}"

updated_entry_payload = Entry(
    name=fileset_entry_name,
    entry_type=entry_type_resource_name,
    fully_qualified_name=fully_qualified_fileset_uri,
    aspects={
        extracted_aspect_key: Aspect(
            aspect_type=extracted_aspect_type_name,
            data=extracted_data,
        ),
        governance_aspect_key: Aspect(
            aspect_type=governance_aspect_type_name,
            data=governance_data,
        ),
    },
)

update_op = catalog_client.update_entry(
    request=dataplex_v1.UpdateEntryRequest(
        entry=updated_entry_payload,
        update_mask={"paths": ["aspects"]},
        aspect_keys=[extracted_aspect_key, governance_aspect_key],
    )
)
העברת שני ההיקפים update_mask={"paths": ["aspects"]} ו-aspect_keys=[extracted_aspect_key, governance_aspect_key] מגבילה את המוטציה לשני מפתחות ההיבטים האלה בלבד, כך שההיבטים entry_source וכל ההיבטים שבבעלות צוותים אחרים לא מושפעים.
מריצים את step5_attach_aspects.py
python3 step5_attach_aspects.py
Successfully bound 2 Aspect(s) to Entry:
  projects/your-project-id/locations/us-central1/entryGroups/
  dark-data-fileset-group/entries/sop-manuals-fileset-lum8g8j

=== Live Attached Aspect: document-governance-aspect ===
Catalog Field    Authoritative Stored Value
compliance_classifications    UL-153 Portable Luminaires, FCC Part 15, CE-LVD
stewardship_owner    Global Hardware Safety & Lighting Systems Engin
retention_policy    10-Year Active Product Lifecycle Archival
lakehouse_cross_ref_table    lakehouse.your-project-id.retail_hardware
governance_status    VERIFIED_PRODUCTION

=== Live Attached Aspect: dark-data-extracted-metadata ===
Catalog Field    Authoritative Stored Value
document_title    LUM-LIG-DES-8G8J Contemporary Linen Desk Lamp
domain_ontology    Electrical Hardware & Lighting Systems
operational_hazard_level    MEDIUM
author_provenance    Global Hardware Safety & Lighting Systems Engin
version_provenance    Rev 4.2
document_summary    This document outlines standard operating proce
confidence_score    0.99
אימות דו-שלבי
- מסלול 1 (אימות באמצעות CLI): בודקים את הרשומה עם כל ההיבטים המצורפים באמצעות
gcloud:gcloud dataplex entries describe sop-manuals-fileset-lum8g8j \ --entry-group=dark-data-fileset-group \ --location=$REGION \ --view=ALL - מסלול 2 (בדיקת ממשק המשתמש של הקונסולה):
- פותחים את Knowledge Catalog של Search Console, מחפשים את LUM-LIG-DES-8G8J Unstructured SOP & Technical Manual Fileset (
sop-manuals-fileset-lum8g8j) ובוחרים את הרשומה התואמת מתוצאות החיפוש. - בקטע תגים והיבטים אופציונליים, מוודאים שגם מטא-נתונים שחולצו מנתונים לא מובנים (Dark Data) בפורמט מולטימודאלי וגם היבט של משילות מסמכים ומלאי מסמכים עם הפניה צולבת מציגים את רמת הסיכון שחולצה (
MEDIUM), את קודי התאימות (UL-153, FCC Part 15, CE-LVD, RoHS) ואת מחרוזת הטבלה של ההפניה הצולבת (lakehouse_cross_ref_table).
- פותחים את Knowledge Catalog של Search Console, מחפשים את LUM-LIG-DES-8G8J Unstructured SOP & Technical Manual Fileset (
8. הרצת שאילתות על נתונים לא גלויים שמוגדרים בקטלוג
אחרי שמצרפים היבטים מותאמים אישית, אפשר לחפש מדריכים לא מובְנים בפורמט PDF ב-Cloud Storage באמצעות חיפוש ב-Knowledge Catalog (catalog_client.search_entries()).
סקר search_entries() ב-step6_search_catalog.py
step6_search_catalog.py polls search_entries() עם השהיה מעריכית לפני ניסיון חוזר (exponential backoff) וקורא את מפתחות ההיבטים הקנוניים באמצעות .endswith():
search_query = f"entrygroup={entry_group_resource_name} name:{FILESET_ENTRY_ID}"

while elapsed_seconds < max_wait_seconds:
    catalog_search_results = list(
        catalog_client.search_entries(
            request=dataplex_v1.SearchEntriesRequest(
                name=parent_location,
                query=search_query,
            )
        )
    )
    if catalog_search_results:
        break
    backoff_seconds = min(5 * (2 ** attempt), 30)
    time.sleep(backoff_seconds)
    ...

for k, asp in detailed_entry.aspects.items():
    if k.endswith(f".{REGION}.{EXTRACTED_ASPECT_TYPE_ID}"):
        print(f"    Domain Ontology     : {asp.data.get('domain_ontology')}")
        print(f"    Hazard Level        : {asp.data.get('operational_hazard_level')}")
    elif k.endswith(f".{REGION}.{GOVERNANCE_ASPECT_TYPE_ID}"):
        print(f"    Compliance Codes    : {asp.data.get('compliance_classifications')}")
        print(f"    Lakehouse Join Table: {asp.data.get('lakehouse_cross_ref_table')}")
מריצים את step6_search_catalog.py
python3 step6_search_catalog.py
Executing Knowledge Catalog search query:
  'entrygroup=projects/your-project-id/locations/us-central1/entryGroups/
  dark-data-fileset-group name:sop-manuals-fileset-lum8g8j'...

✓ Discovered 1 governed asset(s) in Knowledge Catalog:

[1] Entry Resource Name :
    projects/your-project-id/locations/us-central1/entryGroups/
    dark-data-fileset-group/entries/sop-manuals-fileset-lum8g8j
    Fully Qualified Name: gcs:your-project-id-dark-data-manuals
    Entry Type :
    projects/your-project-id/locations/us-central1/entryTypes/
    unstructured-pdf-fileset
    Physical Storage URI:
    gs://your-project-id-dark-data-manuals/sop-pdfs/LUM-LIG-DES-8G8J_manual.pdf
    Domain Ontology     : Electrical Hardware & Lighting Systems
    Hazard Level        : MEDIUM
    Compliance Codes    : UL-153 Portable Luminaires, FCC Part 15, CE-LVD, RoHS
    Lakehouse Join Table:
    lakehouse.your-project-id.retail_hardware.luminaire_sku_inventory_iceberg
אימות דו-שלבי
- טראק 1 (חיפוש ב-CLI): שליחת שאילתה לאינדקס החיפוש ישירות באמצעות
gcloud:gcloud dataplex entries search "name:sop-manuals-fileset-lum8g8j" --project=$PROJECT_ID - טראק 2 (חיפוש בשפה טבעית בממשק המשתמש של Search Console):
- פותחים את Knowledge Catalog ב-Search Console ומחפשים את
LUM-LIG-DES-8G8JאוUL-153. - שימו לב איך Knowledge Catalog מציג את הרשומה של קבוצת קבצי ה-PDF המנוהלת ב-Cloud Storage ואת היבטי המטא-נתונים שצורפו אליה.
- פותחים את Knowledge Catalog ב-Search Console ומחפשים את
9. אימות של הצהרות על ניהול מקצה לקצה
step7_verify_assertions.py מריץ טענות דטרמיניסטיות מול תגובות של מישור הבקרה של Knowledge Catalog בזמן אמת, כדי לוודא שEntryGroup, EntryType, שתי תוכניות ה-blueprint המותאמות אישית AspectType, מטען הנתונים של ההיבט המוגבל EntryView.ALL (גבולות confidence_score ומחרושת lakehouse_cross_ref_table) וגילוי אינדקס החיפוש מצליחים:
verify_eg = catalog_client.get_entry_group(name=entry_group_resource_name)
assert verify_eg.name == entry_group_resource_name, "EntryGroup resource name mismatch."

verify_entry = catalog_client.get_entry(
    request=dataplex_v1.GetEntryRequest(
        name=fileset_entry_name,
        view=dataplex_v1.EntryView.ALL,
    )
)
bound_extracted = next(
    (
        asp for k, asp in verify_entry.aspects.items()
        if k.endswith(f".{REGION}.{EXTRACTED_ASPECT_TYPE_ID}")
    ),
    None,
)
bound_governance = next(
    (
        asp for k, asp in verify_entry.aspects.items()
        if k.endswith(f".{REGION}.{GOVERNANCE_ASPECT_TYPE_ID}")
    ),
    None,
)

assert bound_extracted is not None, f"Aspect '{EXTRACTED_ASPECT_TYPE_ID}' not found on live Entry."
assert bound_governance is not None, (
    f"Aspect '{GOVERNANCE_ASPECT_TYPE_ID}' not found on live Entry."
)
assert (
    bound_extracted.data.get("document_title") == expected_extraction["document_title"]
), "Extracted title mismatch."
assert (
    0.0 <= float(bound_extracted.data.get("confidence_score", -1.0)) <= 1.0
), "Invalid confidence score in catalog."
assert (
    "lakehouse" in str(bound_governance.data.get("lakehouse_cross_ref_table", "")).lower()
), "Missing Lakehouse cross-reference."
...
assert len(search_results) >= 1, "Expected at least 1 search result in Knowledge Catalog."
מריצים את step7_verify_assertions.py
python3 step7_verify_assertions.py && echo "Verification exit code: $?"
Running substantive end-to-end verification assertions...
✓ All 5 substantive verification assertions passed
  against live Google Cloud control plane state!
Verification exit code: 0
10. תכנון צינור עיבוד נתונים מבוסס-אירועים
הפעלת סקריפטים של Python באופן אינטראקטיבי ב-Cloud Shell היא אידיאלית ליצירה ולבדיקה של חוזי ניהול גישה, אבל בסביבות ארגוניות מתקבלים מדי יום אלפי מדריכים הנדסיים חדשים או מתוקנים בפורמט PDF, אישורי תאימות של ספקים ומסמכי SOP מ-ERP, מניהול מחזור חיי מוצר (PLM) ומפורטלי ספקים. הפעלת סקריפטים של אצווה באופן ידני יוצרת במהירות נקודות עיוור בניהול בין העלאת המסמך לאינדוקס של הקטלוג.
בסביבת הייצור, צוותי הפלטפורמה מפעילים את הקוד המדויק שהרצתם בשלבים 4 ו-5 כצינור עיבוד נתונים אוטומטי מבוסס-אירועים:
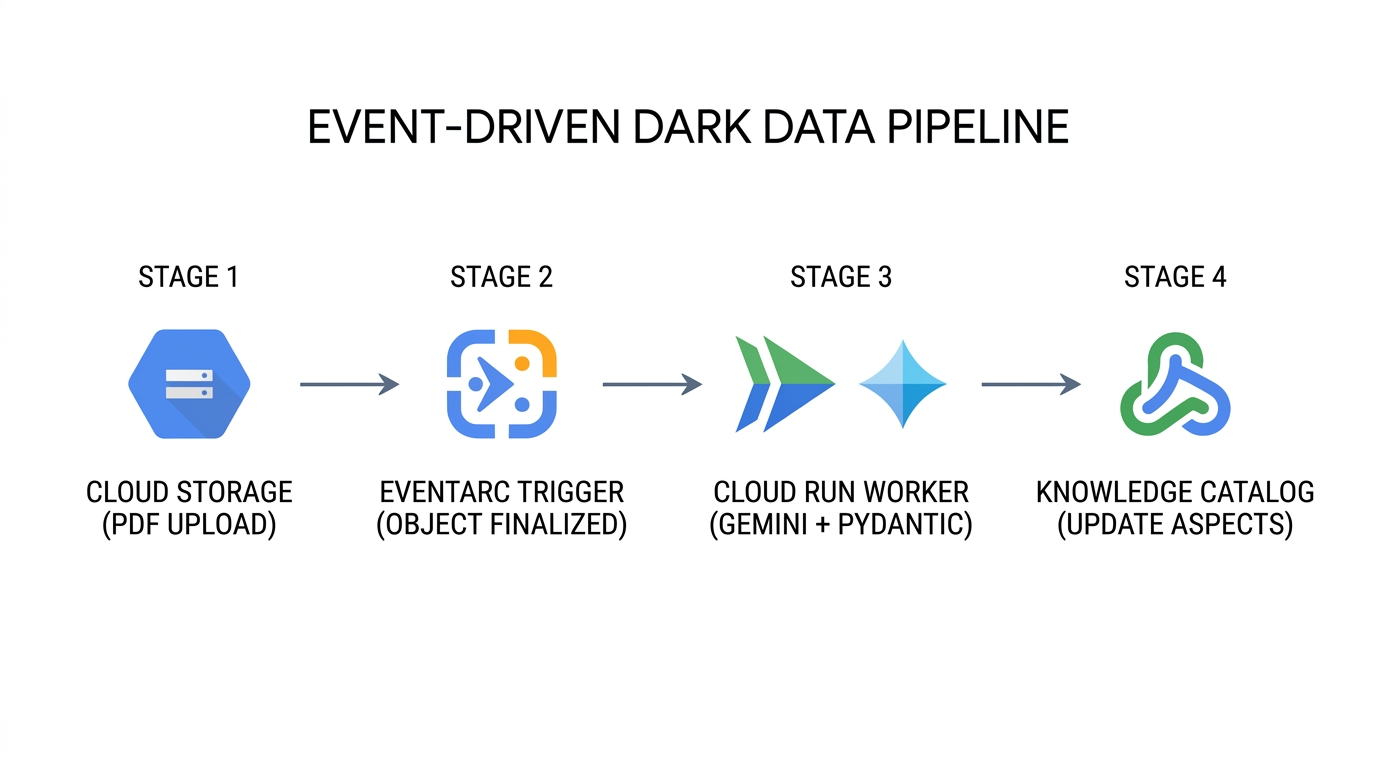
- הזנת מסמכים רציפה (
Cloud Storage←Eventarc): בכל פעם שמעלים מדריך PDF חדש או שגרסה חדשה מחליפה אובייקט קיים ב-Cloud Storage, מאגר הנתונים פולט CloudEventgoogle.cloud.storage.object.v1.finalizedשמכיל את מזהה מאגר הנתונים, נתיב האובייקט ומספר הדור של האובייקט. - Stateless Multimodal Extraction (
Eventarc→Cloud Run→Gemini Enterprise Agent Platform): שירות Eventarc מעביר את CloudEvent לעובד Cloud Run ללא שרת, שכולל אתschemas.py, step4_extract_metadata.pyו-step5_attach_aspects.py. העובד מעביר את בייטים של ה-PDF ל-Gemini Enterprise Agent Platform עםresponse_schema, וכך מבטיח שכל מאפיין שחולץ עומד בדרישות שלDarkDataExtractedMetadataושלDocumentGovernanceMetadata. - עדכון של מישור הבקרה של Surgical (
Cloud Run←Knowledge Catalog): תהליך ה-worker פותר את קבוצת הקבצים הראשיתEntryומבצע אתcatalog_client.update_entry()עםupdate_mask={"paths": ["aspects"]}ו-aspect_keysמפורש. גם אם עשרות מסמכים מסיימים את העיבוד בו-זמנית, כל מוטציה מעדכנת רק את מפתחות ההיבטים שמוגדרים לה. - הסגר של נאמן המידע על סמך סף מהימנות: אם סריקה של קובץ PDF מדור קודם מניבה חילוץ
confidence_scoreמתחת לסף התפעולי (לדוגמה,< 0.85), ה-worker מגדיר את הערךgovernance_status = "PENDING_STEWARD_REVIEW"בהיבט המצורף, כדי שנאמני המידע יוכלו לשלוח שאילתה לKnowledge Catalog לגבי נכסים עם מהימנות נמוכה שדורשים בדיקה אנושית.
איך ארגונים מיישמים את התבנית הזו בסביבת ייצור
תרחיש לדוגמה לשימוש ב-Enterprise | איך מטא-נתונים כקוד פועלים בפועל | ההשפעה על העסק ועל התפעול |
ביקורות רגולטוריות אוטומטיות ומוכנות לריקול | מערכות התאימות משלבות בין היבטי בטיחות של קובצי PDF לא מובנים ( | כשמתעדכן תקן כמו |
Grounded AI Agents & RAG Pre-Filtering | לפני שסוכן Retrieval-Augmented Generation (יצירה משולבת-אחזור, RAG) ב-Gemini Enterprise Agent Platform עונה על שאלה של מהנדס שטח, הוא מסנן את הרשומות ב-Knowledge Catalog לפי | ההגדרה הזו מונעת מיועצי AI להמציא מידע או לצטט טיוטות הנדסיות שיצאו משימוש, נהלים סטנדרטיים (SOP) שתוקפם פג או מדריכים של צד שלישי שלא אומתו. |
העשרה בו-זמנית של נתונים על ידי כמה צוותים | כמה צינורות עצמאיים מעשירים את אותו Fileset | מכיוון ששינויים בהיקפי |
CI/CD Schema Evolution via GitOps | צוותי פלטפורמה מאחסנים הגדרות של | מבטל את הסחף בסכימה בין קוד החילוץ של האפליקציה לבין מישור הבקרה של Knowledge Catalog בפרויקטים של |
11. ניקוי הסביבה
בKnowledge Catalog, אי אפשר למחוק מאגרי נתונים ראשיים ותבניות סכימה אם רשומות משניות עדיין מפנות אליהם. cleanup.py מוחק משאבים בסדר הפוך של התלות (Entry ← EntryGroup ← EntryType ← AspectTypes ← אובייקטים בקטגוריה Cloud Storage ← קובצי JSON זמניים):
# 1. Delete Fileset Entry first
catalog_client.delete_entry(name=target_entry_path)

# 2. Delete EntryGroup container
del_eg_op = catalog_client.delete_entry_group(name=target_eg_path)
if hasattr(del_eg_op, "result"):
    del_eg_op.result()

# 3. Delete EntryType and Custom AspectTypes
del_et_op = catalog_client.delete_entry_type(name=target_et_path)
if hasattr(del_et_op, "result"):
    del_et_op.result()
for aspect_id_val in (EXTRACTED_ASPECT_TYPE_ID, GOVERNANCE_ASPECT_TYPE_ID):
    target_at_path = f"{active_parent}/aspectTypes/{aspect_id_val}"
    del_at_op = catalog_client.delete_aspect_type(name=target_at_path)
    if hasattr(del_at_op, "result"):
        del_at_op.result()
מריצים את cleanup.py
python3 cleanup.py
Starting reverse-dependency resource cleanup in Knowledge Catalog...
Deleted Fileset Entry:
  projects/your-project-id/locations/us-central1/entryGroups/
  dark-data-fileset-group/entries/sop-manuals-fileset-lum8g8j
Deleted EntryGroup   :
  projects/your-project-id/locations/us-central1/entryGroups/
  dark-data-fileset-group
Deleted EntryType    :
  projects/your-project-id/locations/us-central1/entryTypes/
  unstructured-pdf-fileset
Deleted AspectType   :
  projects/your-project-id/locations/us-central1/aspectTypes/
  dark-data-extracted-metadata
Deleted AspectType   :
  projects/your-project-id/locations/us-central1/aspectTypes/
  document-governance-aspect
Deleted Cloud Storage object :
  gs://your-project-id-dark-data-manuals/sop-pdfs/LUM-LIG-DES-8G8J_manual.pdf
Deleted Cloud Storage bucket : gs://your-project-id-dark-data-manuals
Removed local temporary file : extracted_metadata.json
Removed local temporary file : governance_metadata.json
✓ Standalone teardown complete. Environment cleanly reset.
הסרת ספריית המאגר המשוכפל
אחרי ש-cleanup.py מסיים למחוק את משאבי הענן, חוזרים לספריית הבית ומסירים את תיקיית המאגר המשוכפל devrel-demos מ-Cloud Shell:
cd ~
rm -rf ~/devrel-demos
12. מעולה!
יצרתם ואימתתם צינור בקרה מקצה לקצה של מטא-נתונים כקוד, שהופך קובצי PDF לא מובנים ב-Cloud Storage לנכסים ניתנים לגילוי ב-Knowledge Catalog עם סכימה מחייבת באמצעות Gemini Enterprise Agent Platform.
מה השלב הבא?
- אוטומציה באמצעות Terraform: ניהול משאבי
google_dataplex_aspect_typeו-google_dataplex_entry_groupבאופן הצהרתי בצינורות עיבוד נתונים של CI/CD. - פריסת Eventarc + Cloud Run Workers: העברת
step4_extract_metadata.pyו-step5_attach_aspects.pyלקונטיינר לשירות Cloud Run מבוסס-אירועים. - צירופי מלאי במורד הזרם ב-BigQuery: ייצוא המטא-נתונים של ניהול הגישה שחולצו (
lakehouse_cross_ref_table) כדי לצרף מאפייני תאימות של מסמכים לא מובנים לטבלאות מלאי מובנות של מק"טים.