

1. परिचय
एंटरप्राइज़ का 80% से ज़्यादा डेटा, अनस्ट्रक्चर्ड फ़ॉर्मैट में होता है. जैसे, इंजीनियरिंग की PDF फ़ाइलें, स्टैंडर्ड ऑपरेटिंग प्रोसीजर (एसओपी), अनुपालन के सर्टिफ़िकेट, और Cloud Storage में सेव किए गए उपकरण के स्कीमैटिक. पारंपरिक कैटलॉग सिर्फ़ रिलेशनल टेबल स्कीमा को इंडेक्स करते हैं. इसलिए, ये दस्तावेज़ "डार्क डेटा" बने रहते हैं. इसका मतलब है कि ये दस्तावेज़, एंटरप्राइज़ सर्च में नहीं दिखते, स्ट्रक्चर्ड इन्वेंट्री टेबल से डिसकनेक्ट होते हैं, और नियमों का पालन करने के लिए इनकी पुष्टि नहीं की जाती.
जब कोई ऑडिटर या एआई एजेंट यह पूछता है कि "किन हार्डवेयर एसकेयू के लिए UL-153 सुरक्षा सर्टिफ़िकेट की ज़रूरत होती है और उनके थर्मल हैज़र्ड लेवल क्या हैं?", तो सिर्फ़ एसक्यूएल टेबल को इंडेक्स करने वाला कैटलॉग इसका जवाब नहीं दे सकता. तथ्य, Cloud Storage में मौजूद अनस्ट्रक्चर्ड PDF फ़ाइलों में लॉक हैं.
आर्किटेक्चरल समाधान: मल्टीमॉडल मेटाडेटा-एज़-कोड
इस कोडलैब में, Google Cloud में एक एंड-टू-एंड मेटाडेटा-एज़-कोड पाइपलाइन बनाई जाती है. यह पाइपलाइन, Cloud Storage में मौजूद बिना स्ट्रक्चर वाले PDF मैनुअल को, स्कीमा लागू की गई Knowledge Catalog ऐसेट में बदलती है. इसके लिए, Gemini Enterprise Agent Platform (Google GenAI SDK, google-genai) का इस्तेमाल किया जाता है:
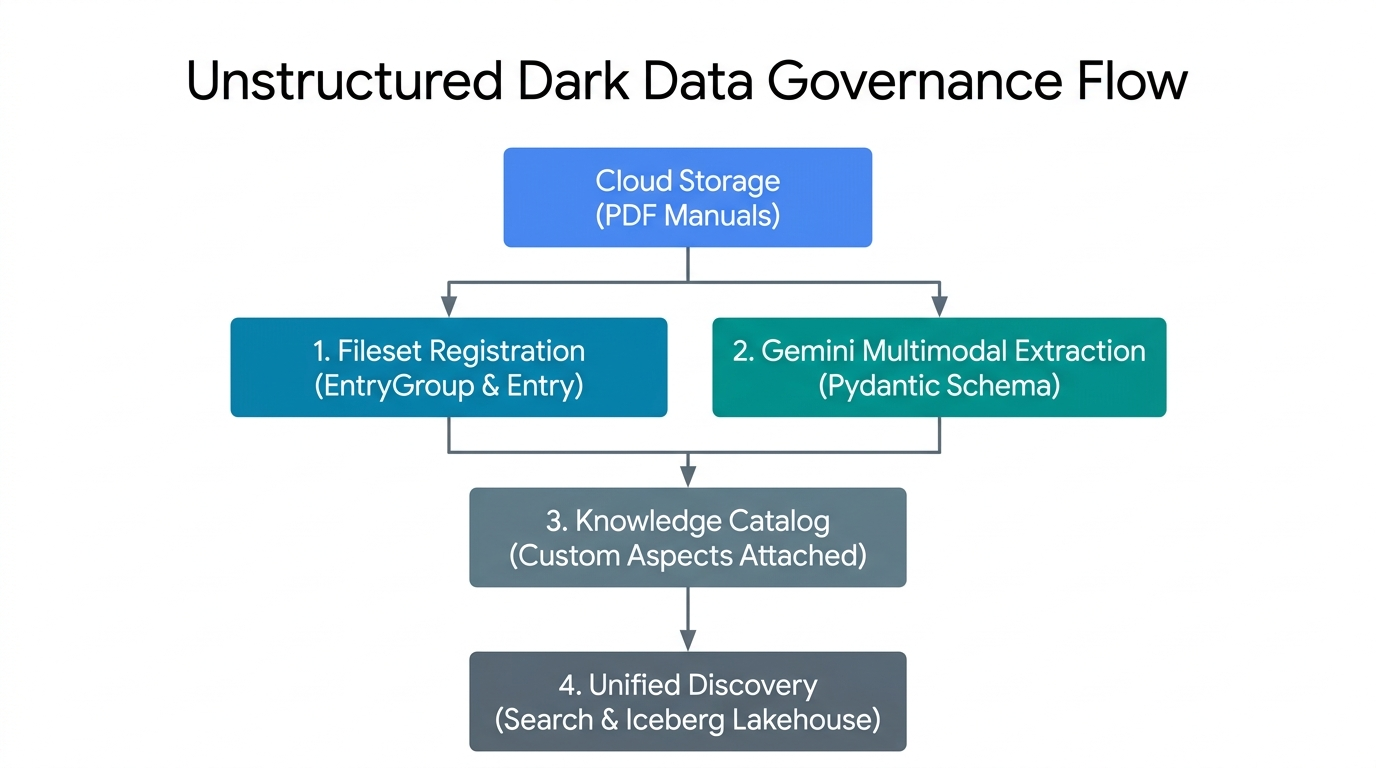
- फ़ाइलसेट रजिस्ट्रेशन (
EntryGroup&Entry): यह सुविधा, Cloud Storage में मौजूद बिना स्ट्रक्चर वाले PDF को, Knowledge Catalog में मौजूद लॉजिकल फ़ाइलसेट एंट्री के तौर पर ग्रुप करती है. - Gemini Multimodal Extraction (Pydantic Schema): यह फ़ंक्शन, Gemini Enterprise के एजेंट प्लैटफ़ॉर्म को PDF के रॉ बाइट पर कॉल करता है. साथ ही,
response_schemaकी पुष्टि करता है. - कंट्रोल प्लेन के पहलू को बाइंड करना: इससे, पुष्टि किए गए ऑपरेशनल और अनुपालन से जुड़े JSON पेलोड को कैटलॉग एंट्री पर, स्ट्रॉन्ग टाइप वाले
Aspectइंस्टेंस के तौर पर अटैच किया जाता है. - यूनिफ़ाइड कैटलॉग डिस्कवरी: इसकी मदद से, अनस्ट्रक्चर्ड PDF फ़ाइलसेट और उनसे निकाला गया मेटाडेटा,
SearchEntriesRequestके ज़रिए खोजा जा सकता है.
मुख्य सिद्धांत: नॉलेज कैटलॉग कंट्रोल प्लेन प्रिमिटिव
मान लें कि आपकी टीम ने Cloud Storage में, प्रॉडक्ट के सैकड़ों पीडीएफ़ मैनुअल सेव किए हैं. इन फ़ाइलों को आसानी से ढूंढने और नॉलेज कैटलॉग में देखने के लिए, पांच बिल्डिंग ब्लॉक के बारे में सोचें. जैसे, पेपर मैनुअल को ऑफ़िस के फ़ाइलिंग कैबिनेट में व्यवस्थित करना:
EntryGroup(एक टीम के लिए लॉक की गई अलमारी): एक ऐसी अलमारी जिस पर लॉक लगा हो. सिर्फ़ वे टीममेट फ़ोल्डर को अंदर रख सकते हैं जिनके पास अनुमति (roles/dataplex.entryCreator) है. कैबिनेट को हटाने से पहले, आपको कैबिनेट के हर फ़ोल्डर को खाली करना होगा.EntryType(फ़ोल्डर कैटगरी का लेबल): यह एक ऐसा लेबल होता है जिससे लोगों को पता चलता है कि कोई फ़ोल्डर किस तरह की ऐसेट को दिखाता है. उदाहरण के लिए, "डेटाबेस टेबल" के बजाय "पीडीएफ़ मैनुअल कलेक्शन".Entry(स्टोरेज लिंक वाला फ़ाइल फ़ोल्डर): यह आपके PDF मैनुअल का कैटलॉग फ़ोल्डर है. ज़्यादा कागज़ की कॉपी रखने के बजाय, फ़ोल्डर में एक लोकेशन कार्ड होता है. यह कार्ड, उस Cloud Storage बकेट (gs://...) की ओर इशारा करता है जहां असली PDF फ़ाइलें मौजूद होती हैं.AspectType(खाली चेकलिस्ट फ़ॉर्म): यह एक ऐसा खाली फ़ॉर्म होता है जिसे बार-बार इस्तेमाल किया जा सकता है. इसमें पहले से प्रिंट किए गए बॉक्स होते हैं. उदाहरण के लिए, "सुरक्षा चेकलिस्ट" मेंoperational_hazard_levelको टेक्स्ट के तौर पर औरconfidence_scoreको0.0से1.0तक की संख्या के तौर पर मांगा जाता है. इस खाली फ़ॉर्म को एक बार बनाया जाता है और इसे हज़ारों फ़ोल्डर में फिर से इस्तेमाल किया जाता है.Aspect(भरी हुई चेकलिस्ट, फ़ोल्डर से अटैच की गई है): Gemini Enterprise Agent Platform, PDF फ़ाइल में मौजूद मैनुअल को पढ़कर खाली जगहों में जानकारी भरता है. इसके बाद, भरी हुई चेकलिस्ट कोEntryफ़ोल्डर में क्लिप कर दिया जाता है. हर चेकलिस्ट की अपनी कुंजी (aspect_keys) होती है. इसलिए, इंजीनियरिंग टीम और कानूनी टीम, दोनों एक ही फ़ोल्डर में अपनी-अपनी चेकलिस्ट अटैच कर सकती हैं. इससे एक-दूसरे के काम पर कोई असर नहीं पड़ेगा.
क्षेत्र के हिसाब से उपलब्ध सभी पांच संसाधन, projects/{project}/locations/{location}/ में मौजूद हैं:
प्रिमिटिव और रिलेटिव पाथ | नॉलेज कैटलॉग में भूमिका | मिटाने और IAM से जुड़े नियम |
| लॉजिकल कंटेनर, जो एंट्री को ग्रुप करता है और टीम के ऐक्सेस को कंट्रोल करता है ( | मिटाने से पहले, इसमें बच्चों के लिए उपलब्ध |
| ऐसेट के किसी क्लास ( | इस तरह की सभी एंट्री हटाने के बाद ही इसे मिटाएं. |
| कैटलॉग रिकॉर्ड, जो फ़िज़िकल Cloud Storage यूआरआई ( | यह |
| टाइप किए गए | इसे हर इलाके के लिए एक बार बनाया जाता है और सभी एंट्री के साथ शेयर किया जाता है. |
| पुष्टि किया गया JSON मेटाडेटा, जो |
|
आपको क्या बनाना है
codelabs/metadata-as-code-lab में मौजूद कंपैनियन स्क्रिप्ट का इस्तेमाल करके, सात चरणों वाली पाइपलाइन को चलाया और उसकी जांच की जाएगी:
schemas.py— ड्यूअल PydanticBaseModelस्कीमा (DarkDataExtractedMetadataऔरDocumentGovernanceMetadata), नॉलेज कैटलॉगAspectTypeटेंप्लेट के साथ 1:1 पेयर किए जाते हैं.step2_provision.py— कस्टमEntryGroup,EntryType, औरAspectTypeब्लूप्रिंट को बार-बार लागू करने की सुविधा.step3_register_fileset.py—LUM-LIG-DES-8G8J_manual.pdfको Cloud Storage में अपलोड किया गया है और इसे नियंत्रित फ़ाइलसेटEntryके तौर पर रजिस्टर किया गया है.step4_extract_metadata.py—google-genaiका इस्तेमाल करके, Gemini के फ़्लैगशिप मॉडल की डाइनैमिक डिस्कवरी और अलग-अलग फ़ॉर्मैट में PDF से जानकारी निकालने की सुविधा.step5_attach_aspects.py,step6_search_catalog.py, औरstep7_verify_assertions.py— सर्जिकल ऐस्पेक्ट अटैचमेंट, एक्सपोनेंशियल-बैकऑफ़ कैटलॉग सर्च, और एंड-टू-एंड कंट्रोल प्लेन असर्शन.
ज़रूरी शर्तें और आपको इनकी ज़रूरत होगी
- बिलिंग की सुविधा वाला Google Cloud प्रोजेक्ट और Google Cloud Shell (इसमें
gcloud,git,python3, औरpipपहले से इंस्टॉल होते हैं). - Knowledge Catalog के संसाधनों (
roles/dataplex.admin) को मैनेज करने, Cloud Storage बकेट और ऑब्जेक्ट (roles/storage.admin) को प्रोविज़न करने, और Gemini Enterprise Agent Platform (roles/aiplatform.user) को चालू करने के लिए IAM अनुमतियां. - कोई वेब ब्राउज़र, जैसे कि Google Chrome.
2. सेटअप और ज़रूरी शर्तें
Cloud Shell में कंपैनियन रिपॉज़िटरी को क्लोन करना
Google Cloud Console खोलें, Cloud Shell लॉन्च करें, और codelabs/metadata-as-code-lab का स्पार्स चेकआउट करें. इसमें सैंपल के तौर पर पीडीएफ़ इंजीनियरिंग मैनुअल (LUM-LIG-DES-8G8J_manual.pdf) और सभी Python स्क्रिप्ट शामिल हैं:
git clone --branch main --depth 1 --filter=blob:none --sparse \
  https://github.com/GoogleCloudPlatform/devrel-demos.git
cd devrel-demos
git sparse-checkout set codelabs/metadata-as-code-lab
cd codelabs/metadata-as-code-lab
ls -la
एनवायरमेंट वैरिएबल कॉन्फ़िगर करना
Cloud Shell में, अपना प्रोजेक्ट आईडी, रीजनल कंट्रोल प्लैन की जगह, और टारगेट Cloud Storage बकेट सेट करें:
export PROJECT_ID="${PROJECT_ID:-$(gcloud config get-value project)}"
gcloud config set project $PROJECT_ID

export REGION="us-central1"
export BUCKET_NAME="${PROJECT_ID}-dark-data-manuals"
export GEMINI_LOCATION="global"

echo "Configured Project ID        : $PROJECT_ID"
echo "Knowledge Catalog Region     : $REGION"
echo "Gemini Endpoint Location     : $GEMINI_LOCATION"
echo "Target Cloud Storage Bucket  : $BUCKET_NAME"
एपीआई चालू करना और डिपेंडेंसी इंस्टॉल करना
ज़रूरी Google Cloud API चालू करें और requirements.txt से Python की डिपेंडेंसी (google-genai, google-cloud-dataplex, pydantic, और pandas) इंस्टॉल करें:
gcloud services enable \
  dataplex.googleapis.com \
  storage.googleapis.com \
  aiplatform.googleapis.com \
  --quiet
python3 -m pip install --upgrade --quiet --user --break-system-packages -r requirements.txt
3. Pydantic स्कीमा और पहलू के टेंप्लेट तय करना
schemas.py, दो मुफ़्त कानूनी समझौते तय करता है. इनमें क्लाइंट-साइड Pydantic की पुष्टि करने की सुविधा को सर्वर-साइड नॉलेज कैटलॉग AspectType टेंप्लेट के साथ जोड़ा जाता है:
DarkDataExtractedMetadata: PDF से निकाले गए ऑपरेशनल एट्रिब्यूट (दस्तावेज़ का टाइटल, डोमेन ऑन्टोलॉजी, सुरक्षा से जुड़े खतरे का लेवल, लेखक/वर्शन की जानकारी, एक्ज़ीक्यूटिव समरी, और एक्सट्रैक्शन कॉन्फ़िडेंस स्कोर).DocumentGovernanceMetadata: नियमों का पालन करने से जुड़े कोड (UL-153, FCC Part 15, CE-LVD, RoHS), stewardship owner, डेटा सुरक्षित रखने की नीति, और रेफ़रंस टेबल आइडेंटिफ़ायर स्ट्रिंग (lakehouse_cross_ref_table). इसका इस्तेमाल, पीडीएफ़ फ़ाइल में मौजूद मैन्युअल को डाउनस्ट्रीम इन्वेंट्री टेबल से लिंक करने के लिए किया जाता है.
schemas.py की जांच करें
सबसे पहले, DarkDataExtractedMetadata, Gemini Enterprise Agent Platform के JSON आउटपुट को सीमित करने के लिए, Pydantic Field की शर्तों (ge=0.0, le=1.0, जिसका मतलब है confidence_score पर इससे ज़्यादा/कम या इसके बराबर) का इस्तेमाल करता है:
class DarkDataExtractedMetadata(BaseModel):
    document_title: str = Field(
        description="Official document title or product model name extracted from the PDF manual."
    )
    # ... domain_ontology, operational_hazard_level, author_provenance ...
    version_provenance: str = Field(
        description="Document version, revision code, or publication standard identifier."
    )
    # ... document_summary ...
    confidence_score: float = Field(
        ge=0.0,
        le=1.0,
        description="AI extraction confidence metric between 0.0 and 1.0.",
    )
दूसरा, extracted_aspect_template में फ़ील्ड के वही नाम होते हैं और यह Python के str और float टाइप को नॉलेज कैटलॉग के string और double record_fields पर मैप करता है. ध्यान दें कि AspectType.MetadataTemplate प्रोटोबफ़ अनुबंध के लिए, record_fields में मौजूद हर फ़ील्ड को एक यूनीक, पूरी तरह से पॉज़िटिव 1-आधारित पूर्णांक index (1 से 7 तक) घोषित करना ज़रूरी है. index को शामिल न करने या डुप्लीकेट करने से, create_aspect_type में 400 INVALID_ARGUMENT की वजह से गड़बड़ी होती है:
extracted_aspect_template = {
    "name": "DarkDataExtractedMetadata",
    "type": "record",
    "record_fields": [
        {
            "name": "document_title",
            "type": "string",
            "index": 1,
            "annotations": {"description": "Official document title or product model name."},
        },
        # ... fields 2 through 6 (string) ...
        {
            "name": "confidence_score",
            "type": "double",
            "index": 7,
            # ... annotations ...
        },
    ],
}
स्कीमा मॉड्यूल की पुष्टि करना
अपने एनवायरमेंट कॉन्फ़िगरेशन की पुष्टि करने और दोनों स्कीमा को कंपाइल करने के लिए, schemas.py चलाएं:
python3 schemas.py
Configured Project ID         : your-project-id
Knowledge Catalog Region      : us-central1
Gemini Endpoint Location      : global
Governed Fileset Storage URI  :
  gs://your-project-id-dark-data-manuals/sop-pdfs/LUM-LIG-DES-8G8J_manual.pdf
Target Fileset Entry ID       : sop-manuals-fileset-lum8g8j
✓ Defined DarkDataExtractedMetadata and DocumentGovernanceMetadata
  Pydantic schemas.
✓ Prepared Knowledge Catalog AspectType metadata templates.
4. नेमस्पेस और कस्टम आसपेक्ट टाइप उपलब्ध कराना
फ़ाइलसेट की एंट्री रजिस्टर करने या मेटाडेटा अटैच करने से पहले, step2_provision.py नॉलेज कैटलॉग में तीन कंट्रोल प्लेन रिसॉर्स उपलब्ध कराता है:
EntryGroup:dark-data-fileset-groupEntryType:unstructured-pdf-filesetAspectTypeब्लूप्रिंट:dark-data-extracted-metadataऔरdocument-governance-aspect
step2_provision.py में एक ही कार्रवाई को बार-बार करने की सुविधा
step2_provision.py में हर क्रिएशन कॉल, ज़्यादा समय तक चलने वाली कार्रवाई (op.result()) को try / except AlreadyExists ब्लॉक में रैप करता है, ताकि स्क्रिप्ट को मौजूदा संसाधनों पर बिना किसी गड़बड़ी के सुरक्षित तरीके से फिर से चलाया जा सके:
# Provision AspectType 1: dark-data-extracted-metadata
try:
    at1_op = catalog_client.create_aspect_type(
        parent=parent_location,
        aspect_type_id=EXTRACTED_ASPECT_TYPE_ID,
        aspect_type=AspectType(
            name=extracted_aspect_type_name,
            display_name="Dark Data Multimodal Extracted Metadata",
            # ... description ...
            metadata_template=extracted_aspect_template,
        ),
    )
    if hasattr(at1_op, "result"):
        at1_op.result()
    print(f"Created AspectType: {extracted_aspect_type_name}")
except AlreadyExists:
    print(f"AspectType already exists; retrieving live resource: {extracted_aspect_type_name}")

live_extracted_aspect_type = catalog_client.get_aspect_type(name=extracted_aspect_type_name)
metadata_template=extracted_aspect_template रजिस्टर होने के बाद, Knowledge Catalog, एपीआई बाउंड्री पर स्कीमा लागू करता है. इसके बाद, update_entry() का कोई भी कॉल जो confidence_score (double) को स्ट्रिंग पास करता है उसे अस्वीकार कर दिया जाता है.
रन step2_provision.py
प्रोविज़निंग स्क्रिप्ट चलाएं और पुष्टि करें कि कस्टम पहलू के टाइप आपके इलाके में रजिस्टर किए गए हैं:
python3 step2_provision.py
gcloud dataplex aspect-types list --location=$REGION
Created EntryGroup:
  projects/your-project-id/locations/us-central1/entryGroups/
  dark-data-fileset-group
Created EntryType :
  projects/your-project-id/locations/us-central1/entryTypes/
  unstructured-pdf-fileset
Created AspectType:
  projects/your-project-id/locations/us-central1/aspectTypes/
  dark-data-extracted-metadata
Created AspectType:
  projects/your-project-id/locations/us-central1/aspectTypes/
  document-governance-aspect
✓ All Knowledge Catalog namespaces and AspectType blueprints are active.
5. बिना किसी स्ट्रक्चर वाली फ़ाइलसेट एंट्री रजिस्टर करना
कैटलॉग में लाखों फ़ाइल पॉइंटर जोड़ने के बजाय, Knowledge Catalog, Cloud Storage (gs://YOUR_BUCKET/sop-pdfs/*.pdf) में मौजूद मिलते-जुलते दस्तावेज़ों को लॉजिकल Fileset Entry में ग्रुप करता है. ऐसा, अपने-आप खोज करने वाली स्कैनिंग (DataScanServiceClient) या सीधे तौर पर प्रोग्राम के ज़रिए रजिस्ट्रेशन (CatalogServiceClient.create_entry) के ज़रिए किया जाता है.
step3_register_fileset.py, स्टोरेज को कैटलॉग में कैसे मैप करता है
step3_register_fileset.py, LUM-LIG-DES-8G8J_manual.pdf को gs://${BUCKET_NAME}/sop-pdfs/LUM-LIG-DES-8G8J_manual.pdf पर अपलोड करता है और Entry को रजिस्टर करता है:
fully_qualified_fileset_uri = f"gcs:{BUCKET_NAME}"
fileset_entry_spec = Entry(
    name=fileset_entry_name,
    entry_type=entry_type_resource_name,
    fully_qualified_name=fully_qualified_fileset_uri,
    entry_source=EntrySource(
        resource=VIRTUAL_STORAGE_URI,
        system="Cloud Storage",
        platform="Google Cloud",
        display_name="LUM-LIG-DES-8G8J Unstructured SOP & Technical Manual Fileset",
        # ... description ...
        location=REGION,
    ),
)

create_entry_op = catalog_client.create_entry(
    parent=entry_group_resource_name,
    entry_id=FILESET_ENTRY_ID,
    entry=fileset_entry_spec,
)
Entry पर मौजूद दो यूआरआई फ़ील्ड की अलग-अलग भूमिकाओं पर ध्यान दें:
fully_qualified_name=fully_qualified_fileset_uri(f"gcs:{BUCKET_NAME}"): यह नॉलेज कैटलॉग के लिए ज़रूरी कैननिकलgcs:{bucket_name}एफ़क्यूएन स्कीम का इस्तेमाल करता है, ताकि लॉजिकल कैटलॉग एंट्री को Cloud Storage बकेट से जोड़ा जा सके.entry_source.resource=VIRTUAL_STORAGE_URI: यह फ़िज़िकलgs://ऑब्जेक्ट के उस यूआरआई को सेव करता है जिसकी जांच, डाउनस्ट्रीम एक्सट्रैक्शन वर्कर करते हैं.
रन step3_register_fileset.py
python3 step3_register_fileset.py
Created Cloud Storage bucket:
  gs://your-project-id-dark-data-manuals in us-central1
Uploaded unstructured PDF manual to:
  gs://your-project-id-dark-data-manuals/sop-pdfs/LUM-LIG-DES-8G8J_manual.pdf
Registered governed Fileset Entry:
  projects/your-project-id/locations/us-central1/entryGroups/
  dark-data-fileset-group/entries/sop-manuals-fileset-lum8g8j
  -> Fully Qualified Name : gcs:your-project-id-dark-data-manuals
  -> Physical Resource URI:
  gs://your-project-id-dark-data-manuals/sop-pdfs/LUM-LIG-DES-8G8J_manual.pdf
  -> Source System        : Cloud Storage
6. Gemini की मदद से दस्तावेज़ का मेटाडेटा निकालना
step4_extract_metadata.py, PDF के रॉ बाइट पढ़ता है और दो मुख्य पैटर्न का इस्तेमाल करके Gemini Enterprise के एजेंट प्लैटफ़ॉर्म (genai_client.models.generate_content) को चालू करता है:
1. डाइनैमिक फ़्लैगशिप मॉडल डिस्कवरी
स्क्रिप्ट, मॉडल के वर्शन की स्ट्रिंग को हार्डकोड करने के बजाय, genai_client.models.list() से क्वेरी करती है. साथ ही, (is_ga_channel, semantic_version_tuple) के हिसाब से सक्रिय कैंडिडेट को क्रम से लगाती है, ताकि सामान्य तौर पर उपलब्ध (जीए) flash मॉडल को चुना जा सके:
genai_client = genai.Client(
    vertexai=True,
    project=PROJECT_ID,
    location=GEMINI_LOCATION,
)

for model_obj in genai_client.models.list():
    raw_id = (model_obj.name or "").split("/")[-1]
    # Filter to flagship Gemini Flash models (version >= 3.0) and prioritize GA over preview
    ...
    discovered_candidates.append((is_ga_channel, ver_tuple, raw_id))

discovered_candidates.sort(key=lambda item: (item[0], item[1]), reverse=True)
2. स्कीमा के हिसाब से मल्टीमॉडल एक्सट्रैक्शन (Part.from_bytes + response_schema)
response_mime_type="application/json" और response_schema=DarkDataExtractedMetadata (इसके बाद DocumentGovernanceMetadata) पास करने से, टोकन डिकोडिंग सीधे तौर पर Pydantic JSON स्कीमा तक सीमित हो जाती है:
with open(LOCAL_PDF_PATH, "rb") as pdf_file:
    raw_pdf_bytes = pdf_file.read()

extraction_response = genai_client.models.generate_content(
    model=candidate_model,
    contents=[
        types.Part.from_bytes(data=raw_pdf_bytes, mime_type="application/pdf"),
        extraction_prompt,
    ],
    config=types.GenerateContentConfig(
        response_mime_type="application/json",
        response_schema=DarkDataExtractedMetadata,
        temperature=0.1,
    ),
)

extracted_dark_data = json.loads(extraction_response.text)
validated_extraction = DarkDataExtractedMetadata(**extracted_dark_data)
रन step4_extract_metadata.py
python3 step4_extract_metadata.py
Dynamically discovered active GA model currency :
  gemini-3.8-flash (version (3, 8))
Loaded unstructured PDF manual at: LUM-LIG-DES-8G8J_manual.pdf
Read unstructured PDF document (1184 bytes).
  Executing multimodal extraction with gemini-3.8-flash...
✓ Multimodal extraction completed using model: gemini-3.8-flash
✓ Governance classification completed using model: gemini-3.8-flash

--- Extracted Multimodal Operational Metadata ---
Extracted Attribute    Multimodal Value
document_title    LUM-LIG-DES-8G8J Contemporary Linen Desk Lamp
domain_ontology    Electrical Hardware & Lighting Systems
operational_hazard_level    MEDIUM
author_provenance    Global Hardware Safety & Lighting Systems Engin
version_provenance    Rev 4.2
document_summary    This document outlines standard operating proce
confidence_score    0.99

--- Extracted Governance & Inventory Cross-Reference Metadata ---
Governance Attribute    Classification Value
compliance_classifications    UL-153 Portable Luminaires, FCC Part 15, CE-LVD
stewardship_owner    Global Hardware Safety & Lighting Systems Engin
retention_policy    10-Year Active Product Lifecycle Archival
lakehouse_cross_ref_table    lakehouse.your-project-id.retail_hardware
governance_status    VERIFIED_PRODUCTION
7. पुष्टि किए गए पहलुओं को कैटलॉग एंट्री में अटैच करना
step5_attach_aspects.py, पुष्टि किए गए JSON पेलोड (extracted_metadata.json और governance_metadata.json) को catalog_client.update_entry() के ज़रिए sop-manuals-fileset-lum8g8j एंट्री से बाइंड करता है.
step5_attach_aspects.py में सर्जिकल पहलू का म्यूटेशन
extracted_aspect_key = f"{PROJECT_ID}.{REGION}.{EXTRACTED_ASPECT_TYPE_ID}"
governance_aspect_key = f"{PROJECT_ID}.{REGION}.{GOVERNANCE_ASPECT_TYPE_ID}"

updated_entry_payload = Entry(
    name=fileset_entry_name,
    entry_type=entry_type_resource_name,
    fully_qualified_name=fully_qualified_fileset_uri,
    aspects={
        extracted_aspect_key: Aspect(
            aspect_type=extracted_aspect_type_name,
            data=extracted_data,
        ),
        governance_aspect_key: Aspect(
            aspect_type=governance_aspect_type_name,
            data=governance_data,
        ),
    },
)

update_op = catalog_client.update_entry(
    request=dataplex_v1.UpdateEntryRequest(
        entry=updated_entry_payload,
        update_mask={"paths": ["aspects"]},
        aspect_keys=[extracted_aspect_key, governance_aspect_key],
    )
)
दोनों update_mask={"paths": ["aspects"]} और aspect_keys=[extracted_aspect_key, governance_aspect_key] को पास करने से, म्यूटेशन सिर्फ़ इन दो आसपेक्ट कुंजियों के लिए होता है. इससे entry_source और अन्य टीमों के मालिकाना हक वाले आसपेक्ट पर कोई असर नहीं पड़ता.
रन step5_attach_aspects.py
python3 step5_attach_aspects.py
Successfully bound 2 Aspect(s) to Entry:
  projects/your-project-id/locations/us-central1/entryGroups/
  dark-data-fileset-group/entries/sop-manuals-fileset-lum8g8j

=== Live Attached Aspect: document-governance-aspect ===
Catalog Field    Authoritative Stored Value
compliance_classifications    UL-153 Portable Luminaires, FCC Part 15, CE-LVD
stewardship_owner    Global Hardware Safety & Lighting Systems Engin
retention_policy    10-Year Active Product Lifecycle Archival
lakehouse_cross_ref_table    lakehouse.your-project-id.retail_hardware
governance_status    VERIFIED_PRODUCTION

=== Live Attached Aspect: dark-data-extracted-metadata ===
Catalog Field    Authoritative Stored Value
document_title    LUM-LIG-DES-8G8J Contemporary Linen Desk Lamp
domain_ontology    Electrical Hardware & Lighting Systems
operational_hazard_level    MEDIUM
author_provenance    Global Hardware Safety & Lighting Systems Engin
version_provenance    Rev 4.2
document_summary    This document outlines standard operating proce
confidence_score    0.99
दो ट्रैक वाली पुष्टि
- ट्रैक 1 (सीएलआई की मदद से पुष्टि करना):
gcloudकी मदद से, सभी पहलुओं के साथ एंट्री की जांच करें:gcloud dataplex entries describe sop-manuals-fileset-lum8g8j \ --entry-group=dark-data-fileset-group \ --location=$REGION \ --view=ALL - ट्रैक 2 (Console UI Inspection):
- Knowledge Catalog Search Console खोलें. इसके बाद, LUM-LIG-DES-8G8J Unstructured SOP & Technical Manual Fileset (
sop-manuals-fileset-lum8g8j) खोजें और नतीजों में से मिलती-जुलती एंट्री चुनें. - ज़रूरी नहीं हैं, लेकिन काम के टैग और पहलू में जाकर, पुष्टि करें कि डार्क डेटा से निकाले गए मल्टीमॉडल मेटाडेटा और दस्तावेज़ के लिए तय किए गए नियम और इन्वेंट्री के क्रॉस-रेफ़रंस पहलू में, निकाले गए खतरे का लेवल (
MEDIUM), नियमों का पालन करने से जुड़े कोड (UL-153, FCC Part 15, CE-LVD, RoHS), और क्रॉस-रेफ़रंस टेबल स्ट्रिंग (lakehouse_cross_ref_table) दिख रहे हों.
- Knowledge Catalog Search Console खोलें. इसके बाद, LUM-LIG-DES-8G8J Unstructured SOP & Technical Manual Fileset (
8. कैटलॉग में मौजूद, मैनेज किए गए डार्क डेटा की क्वेरी करना
कस्टम पहलुओं को अटैच करने के बाद, Cloud Storage में मौजूद अनस्ट्रक्चर्ड PDF मैनुअल, Knowledge Catalog में खोज (catalog_client.search_entries()) के ज़रिए खोजे जा सकते हैं.
step6_search_catalog.py में search_entries() का पोल किया जा रहा है
यह एक्स्पोनेंशियल बैकऑफ़ के साथ step6_search_catalog.py पोल search_entries() करता है और .endswith() के ज़रिए कैननिकल किए गए पहलू की कुंजियां पढ़ता है:
search_query = f"entrygroup={entry_group_resource_name} name:{FILESET_ENTRY_ID}"

while elapsed_seconds < max_wait_seconds:
    catalog_search_results = list(
        catalog_client.search_entries(
            request=dataplex_v1.SearchEntriesRequest(
                name=parent_location,
                query=search_query,
            )
        )
    )
    if catalog_search_results:
        break
    backoff_seconds = min(5 * (2 ** attempt), 30)
    time.sleep(backoff_seconds)
    ...

for k, asp in detailed_entry.aspects.items():
    if k.endswith(f".{REGION}.{EXTRACTED_ASPECT_TYPE_ID}"):
        print(f"    Domain Ontology     : {asp.data.get('domain_ontology')}")
        print(f"    Hazard Level        : {asp.data.get('operational_hazard_level')}")
    elif k.endswith(f".{REGION}.{GOVERNANCE_ASPECT_TYPE_ID}"):
        print(f"    Compliance Codes    : {asp.data.get('compliance_classifications')}")
        print(f"    Lakehouse Join Table: {asp.data.get('lakehouse_cross_ref_table')}")
रन step6_search_catalog.py
python3 step6_search_catalog.py
Executing Knowledge Catalog search query:
  'entrygroup=projects/your-project-id/locations/us-central1/entryGroups/
  dark-data-fileset-group name:sop-manuals-fileset-lum8g8j'...

✓ Discovered 1 governed asset(s) in Knowledge Catalog:

[1] Entry Resource Name :
    projects/your-project-id/locations/us-central1/entryGroups/
    dark-data-fileset-group/entries/sop-manuals-fileset-lum8g8j
    Fully Qualified Name: gcs:your-project-id-dark-data-manuals
    Entry Type :
    projects/your-project-id/locations/us-central1/entryTypes/
    unstructured-pdf-fileset
    Physical Storage URI:
    gs://your-project-id-dark-data-manuals/sop-pdfs/LUM-LIG-DES-8G8J_manual.pdf
    Domain Ontology     : Electrical Hardware & Lighting Systems
    Hazard Level        : MEDIUM
    Compliance Codes    : UL-153 Portable Luminaires, FCC Part 15, CE-LVD, RoHS
    Lakehouse Join Table:
    lakehouse.your-project-id.retail_hardware.luminaire_sku_inventory_iceberg
दो ट्रैक वाली पुष्टि
- ट्रैक 1 (सीएलआई की मदद से खोज):
gcloudकी मदद से, सीधे तौर पर खोज इंडेक्स को क्वेरी करें:gcloud dataplex entries search "name:sop-manuals-fileset-lum8g8j" --project=$PROJECT_ID - ट्रैक 2 (कंसोल के यूज़र इंटरफ़ेस (यूआई) में नैचुरल लैंग्वेज में खोज करने की सुविधा):
- Knowledge Catalog Search Console खोलें और
LUM-LIG-DES-8G8JयाUL-153खोजें. - देखें कि Knowledge Catalog, Cloud Storage में मौजूद PDF फ़ाइलसेट की एंट्री और उससे जुड़े मेटाडेटा को कैसे दिखाता है.
- Knowledge Catalog Search Console खोलें और
9. एंड-टू-एंड गवर्नेंस के दावों की पुष्टि करना
step7_verify_assertions.py, लाइव नॉलेज कैटलॉग कंट्रोल प्लेन के जवाबों के ख़िलाफ़ डिटरमिनिस्टिक दावे करता है. इससे यह पुष्टि की जाती है कि EntryGroup, EntryType, दोनों कस्टम AspectType ब्लूप्रिंट, बाउंड EntryView.ALL पहलू के पेलोड (confidence_score बाउंड और lakehouse_cross_ref_table स्ट्रिंग), और खोज इंडेक्स की खोज, सभी सही तरीके से काम कर रहे हैं:
verify_eg = catalog_client.get_entry_group(name=entry_group_resource_name)
assert verify_eg.name == entry_group_resource_name, "EntryGroup resource name mismatch."

verify_entry = catalog_client.get_entry(
    request=dataplex_v1.GetEntryRequest(
        name=fileset_entry_name,
        view=dataplex_v1.EntryView.ALL,
    )
)
bound_extracted = next(
    (
        asp for k, asp in verify_entry.aspects.items()
        if k.endswith(f".{REGION}.{EXTRACTED_ASPECT_TYPE_ID}")
    ),
    None,
)
bound_governance = next(
    (
        asp for k, asp in verify_entry.aspects.items()
        if k.endswith(f".{REGION}.{GOVERNANCE_ASPECT_TYPE_ID}")
    ),
    None,
)

assert bound_extracted is not None, f"Aspect '{EXTRACTED_ASPECT_TYPE_ID}' not found on live Entry."
assert bound_governance is not None, (
    f"Aspect '{GOVERNANCE_ASPECT_TYPE_ID}' not found on live Entry."
)
assert (
    bound_extracted.data.get("document_title") == expected_extraction["document_title"]
), "Extracted title mismatch."
assert (
    0.0 <= float(bound_extracted.data.get("confidence_score", -1.0)) <= 1.0
), "Invalid confidence score in catalog."
assert (
    "lakehouse" in str(bound_governance.data.get("lakehouse_cross_ref_table", "")).lower()
), "Missing Lakehouse cross-reference."
...
assert len(search_results) >= 1, "Expected at least 1 search result in Knowledge Catalog."
रन step7_verify_assertions.py
python3 step7_verify_assertions.py && echo "Verification exit code: $?"
Running substantive end-to-end verification assertions...
✓ All 5 substantive verification assertions passed
  against live Google Cloud control plane state!
Verification exit code: 0
10. इवेंट के हिसाब से काम करने वाली पाइपलाइन बनाना
Cloud Shell में Python स्क्रिप्ट को इंटरैक्टिव तरीके से चलाना, गवर्नेंस कॉन्ट्रैक्ट बनाने और उनकी जांच करने के लिए सबसे सही तरीका है. हालांकि, एंटरप्राइज़ एनवायरमेंट को हर दिन ईआरपी, प्रॉडक्ट लाइफ़साइकल मैनेजमेंट (पीएलएम), और वेंडर पोर्टल से, हज़ारों नए या बदले गए PDF इंजीनियरिंग मैनुअल, सप्लायर के अनुपालन प्रमाणपत्र, और एसओपी दस्तावेज़ मिलते हैं. बैच स्क्रिप्ट को मैन्युअल तरीके से चलाने पर, दस्तावेज़ अपलोड करने और कैटलॉग इंडेक्स करने के बीच, गवर्नेंस से जुड़ी कमियां तुरंत दिखती हैं.
प्रोडक्शन में, प्लैटफ़ॉर्म टीमें उस कोड को लागू करती हैं जिसे आपने चौथे और पाँचवें चरण में चलाया था. यह कोड, बिना किसी मानवीय हस्तक्षेप के काम करने वाली, इवेंट पर आधारित पाइपलाइन के तौर पर काम करता है:
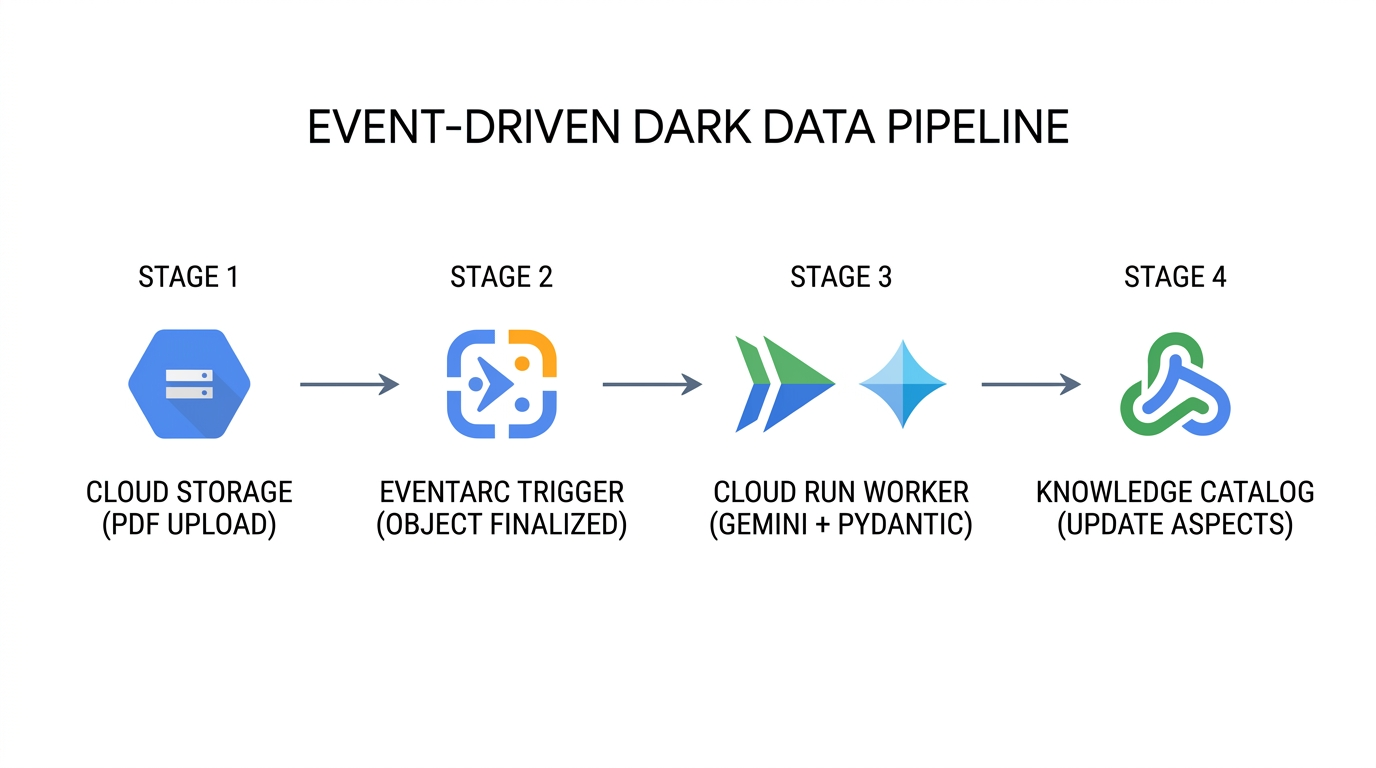
- दस्तावेज़ों को लगातार प्रोसेस करना (
Cloud Storage→Eventarc): जब भी कोई नया PDF मैन्युअल अपलोड किया जाता है या नया वर्शन Cloud Storage में मौजूद किसी ऑब्जेक्ट को बदल देता है, तो बकेट एकgoogle.cloud.storage.object.v1.finalizedCloudEvent भेजता है. इसमें बकेट आइडेंटिफ़ायर, ऑब्जेक्ट पाथ, और ऑब्जेक्ट जनरेशन नंबर शामिल होता है. - स्टेटलेस मल्टीमॉडल एक्सट्रैक्शन (
Eventarc→Cloud Run→Gemini Enterprise Agent Platform): Eventarc, CloudEvent को सर्वरलेस Cloud Run वर्कर पैकेजिंगschemas.py,step4_extract_metadata.py, औरstep5_attach_aspects.pyपर भेजता है. वर्कर, PDF के बाइट को Gemini Enterprise के एजेंट प्लैटफ़ॉर्म पर स्ट्रीम करता है. इसमेंresponse_schemaलागू होता है. इससे यह पक्का होता है कि निकाले गए हर एट्रिब्यूट मेंDarkDataExtractedMetadataऔरDocumentGovernanceMetadataका पालन किया गया हो. - सर्जिकल कंट्रोल प्लैन अपडेट (
Cloud Run→Knowledge Catalog): वर्कर, पैरंट फ़ाइलसेटEntryको हल करता है औरupdate_mask={"paths": ["aspects"]}और साफ़ तौर पर बताए गएaspect_keysके साथcatalog_client.update_entry()को लागू करता है. भले ही, एक साथ कई दस्तावेज़ों को प्रोसेस किया जा रहा हो, लेकिन हर बदलाव सिर्फ़ अपनी तय की गई पहलू कुंजियों को अपडेट करता है. - भरोसेमंद स्कोर के आधार पर, डेटा को अलग रखने की सुविधा: अगर स्कैन किए गए लेगसी पीडीएफ़ से, आपके तय किए गए थ्रेशोल्ड (उदाहरण के लिए,
< 0.85) से कमconfidence_scoreडेटा निकाला जाता है, तो वर्कर, अटैच किए गए पहलू परgovernance_status = "PENDING_STEWARD_REVIEW"सेट करता है. इससे डेटा स्टुअर्ड, नॉलेज कैटलॉग से उन ऐसेट के बारे में क्वेरी कर सकते हैं जिनके लिए मैन्युअल तरीके से समीक्षा करने की ज़रूरत होती है.
कंपनियां, प्रोडक्शन में इस पैटर्न को कैसे लागू करती हैं
एंटरप्राइज़ के इस्तेमाल का उदाहरण | मेटाडेटा-ऐज़-कोड का इस्तेमाल कैसे किया जाता है | कारोबार और ऑपरेशन पर असर |
नियमों के मुताबिक ऑडिट अपने-आप होने की सुविधा और प्रॉडक्ट वापस मंगाने की तैयारी | अनुपालन सिस्टम, BigQuery और Lakehouse for Apache Iceberg में, बिना स्ट्रक्चर वाले पीडीएफ़ में मौजूद सुरक्षा से जुड़ी जानकारी ( |
|
भरोसेमंद स्रोतों से जानकारी पाने वाले एआई एजेंट और आरएजी प्री-फ़िल्टरिंग | Gemini Enterprise Agent Platform पर मौजूद रिट्रीवल ऑगमेंटेड जनरेशन (आरएजी) एजेंट, फ़ील्ड इंजीनियर के सवाल का जवाब देने से पहले, | यह एआई असिस्टेंट को, ऐसी जानकारी देने से रोकता है जो भरोसेमंद स्रोतों से नहीं ली गई है. जैसे, इंजीनियरिंग के ऐसे ड्राफ़्ट जो अब इस्तेमाल में नहीं हैं, समयसीमा खत्म हो चुके एसओपी या तीसरे पक्ष के ऐसे मैनुअल जिनकी पुष्टि नहीं हुई है. |
एक साथ कई टीमों के लिए डेटा को बेहतर बनाना | एक ही फ़ाइलसेट को कई इंडिपेंडेंट पाइपलाइन बेहतर बनाती हैं |
|
GitOps के ज़रिए CI/CD स्कीमा का डेवलपमेंट | प्लैटफ़ॉर्म टीमें, Git में Terraform | यह |
11. अपने एनवायरमेंट को क्लीन अप करना
नॉलेज कैटलॉग में, पैरंट कंटेनर और स्कीमा टेंप्लेट को तब तक नहीं मिटाया जा सकता, जब तक चाइल्ड एंट्री उनका रेफ़रंस देती हैं. cleanup.py, संसाधनों को निर्भरता के क्रम में उलटकर मिटाता है (Entry → EntryGroup → EntryType → AspectTypes → Cloud Storage बकेट ऑब्जेक्ट → अस्थायी JSON फ़ाइलें):
# 1. Delete Fileset Entry first
catalog_client.delete_entry(name=target_entry_path)

# 2. Delete EntryGroup container
del_eg_op = catalog_client.delete_entry_group(name=target_eg_path)
if hasattr(del_eg_op, "result"):
    del_eg_op.result()

# 3. Delete EntryType and Custom AspectTypes
del_et_op = catalog_client.delete_entry_type(name=target_et_path)
if hasattr(del_et_op, "result"):
    del_et_op.result()
for aspect_id_val in (EXTRACTED_ASPECT_TYPE_ID, GOVERNANCE_ASPECT_TYPE_ID):
    target_at_path = f"{active_parent}/aspectTypes/{aspect_id_val}"
    del_at_op = catalog_client.delete_aspect_type(name=target_at_path)
    if hasattr(del_at_op, "result"):
        del_at_op.result()
रन cleanup.py
python3 cleanup.py
Starting reverse-dependency resource cleanup in Knowledge Catalog...
Deleted Fileset Entry:
  projects/your-project-id/locations/us-central1/entryGroups/
  dark-data-fileset-group/entries/sop-manuals-fileset-lum8g8j
Deleted EntryGroup   :
  projects/your-project-id/locations/us-central1/entryGroups/
  dark-data-fileset-group
Deleted EntryType    :
  projects/your-project-id/locations/us-central1/entryTypes/
  unstructured-pdf-fileset
Deleted AspectType   :
  projects/your-project-id/locations/us-central1/aspectTypes/
  dark-data-extracted-metadata
Deleted AspectType   :
  projects/your-project-id/locations/us-central1/aspectTypes/
  document-governance-aspect
Deleted Cloud Storage object :
  gs://your-project-id-dark-data-manuals/sop-pdfs/LUM-LIG-DES-8G8J_manual.pdf
Deleted Cloud Storage bucket : gs://your-project-id-dark-data-manuals
Removed local temporary file : extracted_metadata.json
Removed local temporary file : governance_metadata.json
✓ Standalone teardown complete. Environment cleanly reset.
क्लोन की गई रिपॉज़िटरी डायरेक्ट्री हटाएं
cleanup.py के क्लाउड रिसॉर्स मिटाने के बाद, अपनी होम डायरेक्ट्री पर वापस जाएं. इसके बाद, Cloud Shell से क्लोन की गई devrel-demos रिपॉज़िटरी फ़ोल्डर को हटाएं:
cd ~
rm -rf ~/devrel-demos
12. बधाई हो!
आपने Gemini Enterprise Agent Platform का इस्तेमाल करके, मेटाडेटा-एज़-कोड गवर्नेंस पाइपलाइन बनाई है और उसकी पुष्टि की है. यह पाइपलाइन, Cloud Storage में मौजूद बिना स्ट्रक्चर वाले PDF को, खोजे जा सकने वाले और स्कीमा के मुताबिक बनाए गए Knowledge Catalog ऐसेट में बदलती है.
आगे क्या करना है?
- Terraform की मदद से ऑटोमेट करें: सीआई/सीडी पाइपलाइन में
google_dataplex_aspect_typeऔरgoogle_dataplex_entry_groupसंसाधनों को मैनेज करें. - Eventarc + Cloud Run वर्कर डिप्लॉय करें:
step4_extract_metadata.pyऔरstep5_attach_aspects.pyको इवेंट-ड्रिवन Cloud Run सेवा में कंटेनर के तौर पर डिप्लॉय करें. - BigQuery में डाउनस्ट्रीम इन्वेंट्री जॉइन: निकाले गए गवर्नेंस मेटाडेटा (
lakehouse_cross_ref_table) को एक्सपोर्ट करें, ताकि अनस्ट्रक्चर्ड दस्तावेज़ के अनुपालन एट्रिब्यूट को स्ट्रक्चर्ड एसकेयू इन्वेंट्री टेबल के साथ जोड़ा जा सके.