

1. Introduzione
Oltre l'80% dei dati aziendali si trova in formati non strutturati: manuali di ingegneria in PDF, procedure operative standard, certificati di conformità e schemi di apparecchiature archiviati in Cloud Storage. Poiché i cataloghi tradizionali indicizzano solo gli schemi delle tabelle relazionali, questi documenti rimangono "Dark Data": invisibili alla ricerca a livello aziendale, disconnessi dalle tabelle di inventario strutturate e non verificati per la conformità legale.
Quando un revisore o un agente AI chiede: "Quali SKU hardware richiedono la certificazione di sicurezza UL-153 e quali sono i loro livelli di rischio termico?", un catalogo che indicizza solo le tabelle SQL non può rispondere. I fatti sono bloccati all'interno di PDF non strutturati in Cloud Storage.
Soluzione di architettura: metadati multimodali come codice
In questo codelab, crei una pipeline Metadata-as-Code end-to-end in Google Cloud che trasforma i manuali PDF non strutturati in Cloud Storage in asset Knowledge Catalog con schema applicato utilizzando la piattaforma agentica Gemini Enterprise (Google GenAI SDK, google-genai):
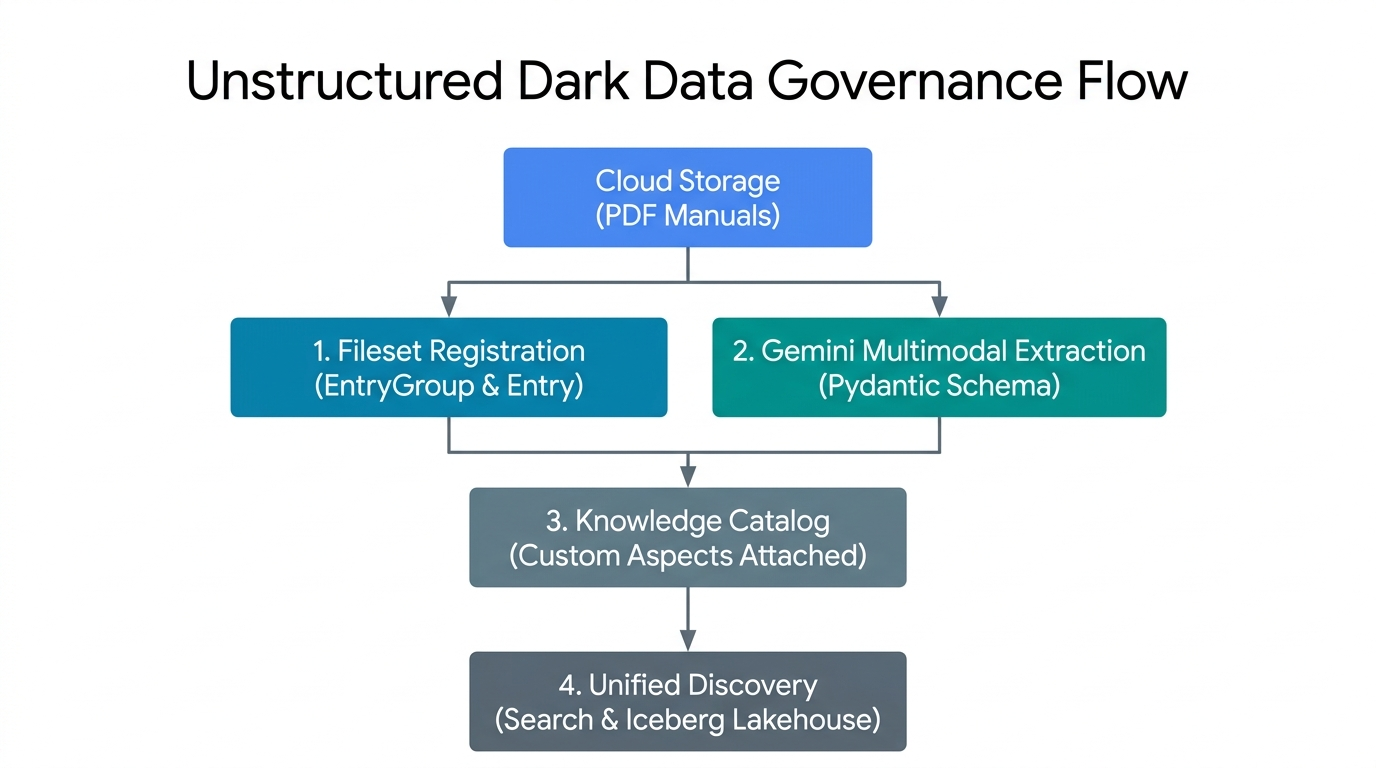
- Registrazione di Fileset (
EntryGroupeEntry): raggruppa i PDF non strutturati in Cloud Storage in voci di fileset logici controllati in Knowledge Catalog. - Estrazione multimodale di Gemini (schema Pydantic): richiama Gemini Enterprise Agent Platform su byte PDF non elaborati con convalida
response_schemadeterministica. - Control Plane Aspect Binding: collega i payload JSON operativi e di conformità convalidati come istanze
Aspectfortemente tipizzate nella voce di catalogo. - Unified Catalog Discovery: rende rilevabili i set di file PDF non strutturati e i relativi metadati estratti tramite
SearchEntriesRequest.
Concetti chiave: primitive del control plane di Knowledge Catalog
Immagina che il tuo team memorizzi centinaia di manuali di prodotto in formato PDF in Cloud Storage. Per trovare e controllare facilmente questi file in Knowledge Catalog, pensa ai cinque elementi costitutivi come all'organizzazione dei manuali cartacei in un archivio per ufficio:
EntryGroup(un armadietto chiuso per un team): un armadietto con una serratura. Solo i membri del team con autorizzazione (roles/dataplex.entryCreator) possono inserire cartelle. Devi svuotare ogni cartella dell'armadio prima di poter rimuovere l'armadio stesso.EntryType(un'etichetta di categoria di cartella): un'etichetta che indica agli utenti il tipo di asset rappresentato da una cartella, ad esempio "Raccolta di manuali in PDF" anziché "Tabella di database".Entry(una cartella di file con un link di archiviazione): la cartella del catalogo per i manuali in formato PDF. Anziché contenere pesanti copie cartacee, la cartella contiene una scheda di posizione che punta al bucket Cloud Storage esatto (gs://...) in cui si trovano i file PDF reali.AspectType(un modulo di elenco di controllo vuoto): un modulo vuoto riutilizzabile con caselle prestampate (ad esempio, un "Elenco di controllo della sicurezza" che chiedeoperational_hazard_levelcome testo econfidence_scorecome numero da0.0a1.0). Puoi creare questo modulo vuoto una sola volta e riutilizzarlo in migliaia di cartelle.Aspect(una lista di controllo compilata allegata a una cartella): dopo che Gemini Enterprise Agent Platform legge il manuale in formato PDF e compila gli spazi vuoti, la lista di controllo compilata viene allegata alla cartellaEntry. Poiché ogni elenco di controllo ha una propria chiave (aspect_keys), il team di ingegneria e il team legale possono allegare ciascuno il proprio elenco di controllo alla stessa cartella senza sovrascrivere il lavoro dell'altro.
Tutte e cinque le risorse di regione si trovano in projects/{project}/locations/{location}/:
Percorso primitivo e relativo | Ruolo in Knowledge Catalog | Regola di eliminazione e IAM |
| Contenitore logico che raggruppa le voci e controlla l'accesso del team ( | Prima dell'eliminazione, deve contenere zero risorse |
| Definizione della categoria per una classe di asset ( | Elimina solo dopo aver rimosso tutte le voci che utilizzano questo tipo. |
| Record del catalogo che collega un URI Cloud Storage fisico ( | Si trova all'interno di un |
| Modello di schema riutilizzabile che definisce | Creato una volta per regione e condiviso tra le voci. |
| Metadati JSON con convalida corrispondenti a un | Aggiornato utilizzando |
Cosa creerai
Utilizzando gli script complementari in codelabs/metadata-as-code-lab, eseguirai e ispezionerai una pipeline a 7 fasi:
schemas.py: schemi Dual PydanticBaseModel(DarkDataExtractedMetadataeDocumentGovernanceMetadata) accoppiati 1:1 con i modelli Knowledge CatalogAspectType.step2_provision.py: provisioning idempotente dei progetti base personalizzatiEntryGroup,EntryTypeeAspectType.step3_register_fileset.py- Caricamento diLUM-LIG-DES-8G8J_manual.pdfsu Cloud Storage e registrazione come Fileset controllatoEntry.step4_extract_metadata.py: rilevamento dinamico del modello Gemini di punta ed estrazione multimodale di PDF utilizzandogoogle-genai.step5_attach_aspects.py,step6_search_catalog.pyestep7_verify_assertions.py: allegato dell'aspetto chirurgico, ricerca nel catalogo con backoff esponenziale e asserzioni del control plane end-to-end.
Prerequisiti e cosa ti servirà
- Un progetto Google Cloud con la fatturazione abilitata e Google Cloud Shell (con
gcloud,git,python3epippreinstallati). - Autorizzazioni IAM per gestire le risorse Knowledge Catalog (
roles/dataplex.admin), eseguire il provisioning di bucket e oggetti Cloud Storage (roles/storage.admin) e richiamare Gemini Enterprise Agent Platform (roles/aiplatform.user). - Un browser web come Google Chrome.
2. Configurazione e requisiti
Clona il repository complementare in Cloud Shell
Apri la console Google Cloud, avvia Cloud Shell ed esegui un controllo sparso di codelabs/metadata-as-code-lab, che include il manuale di ingegneria PDF di esempio (LUM-LIG-DES-8G8J_manual.pdf) e tutti gli script Python:
git clone --branch main --depth 1 --filter=blob:none --sparse \
  https://github.com/GoogleCloudPlatform/devrel-demos.git
cd devrel-demos
git sparse-checkout set codelabs/metadata-as-code-lab
cd codelabs/metadata-as-code-lab
ls -la
Configura le variabili di ambiente
Imposta l'ID progetto, la posizione del control plane regionale e il bucket Cloud Storage di destinazione in Cloud Shell:
export PROJECT_ID="${PROJECT_ID:-$(gcloud config get-value project)}"
gcloud config set project $PROJECT_ID

export REGION="us-central1"
export BUCKET_NAME="${PROJECT_ID}-dark-data-manuals"
export GEMINI_LOCATION="global"

echo "Configured Project ID        : $PROJECT_ID"
echo "Knowledge Catalog Region     : $REGION"
echo "Gemini Endpoint Location     : $GEMINI_LOCATION"
echo "Target Cloud Storage Bucket  : $BUCKET_NAME"
Abilita le API e installa le dipendenze
Abilita le API Google Cloud richieste e installa le dipendenze Python (google-genai, google-cloud-dataplex, pydantic e pandas) da requirements.txt:
gcloud services enable \
  dataplex.googleapis.com \
  storage.googleapis.com \
  aiplatform.googleapis.com \
  --quiet
python3 -m pip install --upgrade --quiet --user --break-system-packages -r requirements.txt
3. Definisci schemi Pydantic e modelli di aspetti
schemas.py definisce due contratti complementari che abbinano la convalida Pydantic lato client ai modelli Knowledge Catalog AspectType lato server:
DarkDataExtractedMetadata: attributi operativi estratti dal PDF (titolo del documento, ontologia del dominio, livello di rischio per la sicurezza, provenienza della creazione/versione, riepilogo e punteggio di confidenza dell'estrazione).DocumentGovernanceMetadata: codici di conformità legale (UL-153, FCC Parte 15, CE-LVD, RoHS), proprietario della gestione, norma di conservazione e stringa identificatore di tabella di riferimento (lakehouse_cross_ref_table) per collegare il manuale in formato PDF alle tabelle di inventario downstream.
Ispeziona schemas.py
Innanzitutto, DarkDataExtractedMetadata utilizza i vincoli Pydantic Field (ge=0.0, le=1.0, ovvero maggiore/minore o uguale a, su confidence_score) per vincolare l'output JSON di Gemini Enterprise Agent Platform:
class DarkDataExtractedMetadata(BaseModel):
    document_title: str = Field(
        description="Official document title or product model name extracted from the PDF manual."
    )
    # ... domain_ontology, operational_hazard_level, author_provenance ...
    version_provenance: str = Field(
        description="Document version, revision code, or publication standard identifier."
    )
    # ... document_summary ...
    confidence_score: float = Field(
        ge=0.0,
        le=1.0,
        description="AI extraction confidence metric between 0.0 and 1.0.",
    )
In secondo luogo, extracted_aspect_template rispecchia esattamente i nomi dei campi e mappa i tipi str e float di Python con string e double record_fields di Knowledge Catalog. Tieni presente che il contratto protobuf AspectType.MetadataTemplate richiede che ogni campo di record_fields dichiari un numero intero index univoco, strettamente positivo e basato su 1 (da 1 a 7). L'omissione o la duplicazione di index causa l'errore di create_aspect_type con 400 INVALID_ARGUMENT:
extracted_aspect_template = {
    "name": "DarkDataExtractedMetadata",
    "type": "record",
    "record_fields": [
        {
            "name": "document_title",
            "type": "string",
            "index": 1,
            "annotations": {"description": "Official document title or product model name."},
        },
        # ... fields 2 through 6 (string) ...
        {
            "name": "confidence_score",
            "type": "double",
            "index": 7,
            # ... annotations ...
        },
    ],
}
Convalida il modulo dello schema
Esegui schemas.py per verificare la configurazione dell'ambiente e compilare entrambi gli schemi:
python3 schemas.py
Configured Project ID         : your-project-id
Knowledge Catalog Region      : us-central1
Gemini Endpoint Location      : global
Governed Fileset Storage URI  :
  gs://your-project-id-dark-data-manuals/sop-pdfs/LUM-LIG-DES-8G8J_manual.pdf
Target Fileset Entry ID       : sop-manuals-fileset-lum8g8j
✓ Defined DarkDataExtractedMetadata and DocumentGovernanceMetadata
  Pydantic schemas.
✓ Prepared Knowledge Catalog AspectType metadata templates.
4. Esegui il provisioning di spazi dei nomi e tipi di aspetto personalizzati
Prima di registrare le voci del fileset o allegare metadati, step2_provision.py esegue il provisioning di tre risorse del control plane in Knowledge Catalog:
EntryGroup:dark-data-fileset-groupEntryType:unstructured-pdf-filesetAspectTypeProgetti:dark-data-extracted-metadataedocument-governance-aspect
Provisioning idempotente in step2_provision.py
Ogni chiamata di creazione in step2_provision.py racchiude l'operazione a lunga esecuzione (op.result()) in un blocco try / except AlreadyExists in modo che lo script possa essere eseguito di nuovo in sicurezza senza errori sulle risorse esistenti:
# Provision AspectType 1: dark-data-extracted-metadata
try:
    at1_op = catalog_client.create_aspect_type(
        parent=parent_location,
        aspect_type_id=EXTRACTED_ASPECT_TYPE_ID,
        aspect_type=AspectType(
            name=extracted_aspect_type_name,
            display_name="Dark Data Multimodal Extracted Metadata",
            # ... description ...
            metadata_template=extracted_aspect_template,
        ),
    )
    if hasattr(at1_op, "result"):
        at1_op.result()
    print(f"Created AspectType: {extracted_aspect_type_name}")
except AlreadyExists:
    print(f"AspectType already exists; retrieving live resource: {extracted_aspect_type_name}")

live_extracted_aspect_type = catalog_client.get_aspect_type(name=extracted_aspect_type_name)
Una volta registrato metadata_template=extracted_aspect_template, Knowledge Catalog applica lo schema al limite dell'API: qualsiasi chiamata update_entry() successiva che passa una stringa a confidence_score (double) viene rifiutata.
Esegui step2_provision.py
Esegui lo script di provisioning e verifica che i tipi di aspetto personalizzati siano registrati nella tua regione:
python3 step2_provision.py
gcloud dataplex aspect-types list --location=$REGION
Created EntryGroup:
  projects/your-project-id/locations/us-central1/entryGroups/
  dark-data-fileset-group
Created EntryType :
  projects/your-project-id/locations/us-central1/entryTypes/
  unstructured-pdf-fileset
Created AspectType:
  projects/your-project-id/locations/us-central1/aspectTypes/
  dark-data-extracted-metadata
Created AspectType:
  projects/your-project-id/locations/us-central1/aspectTypes/
  document-governance-aspect
✓ All Knowledge Catalog namespaces and AspectType blueprints are active.
5. Registra le voci del set di file non strutturato
Anziché riempire il catalogo con milioni di puntatori di file isolati, Knowledge Catalog raggruppa i documenti correlati in Cloud Storage (gs://YOUR_BUCKET/sop-pdfs/*.pdf) in voci di set di file logiche, tramite scansioni di rilevamento automatico (DataScanServiceClient) o registrazione programmatica diretta (CatalogServiceClient.create_entry).
Come step3_register_fileset.py mappa l'archiviazione al catalogo
step3_register_fileset.py carica LUM-LIG-DES-8G8J_manual.pdf su gs://${BUCKET_NAME}/sop-pdfs/LUM-LIG-DES-8G8J_manual.pdf e registra Entry controllato:
fully_qualified_fileset_uri = f"gcs:{BUCKET_NAME}"
fileset_entry_spec = Entry(
    name=fileset_entry_name,
    entry_type=entry_type_resource_name,
    fully_qualified_name=fully_qualified_fileset_uri,
    entry_source=EntrySource(
        resource=VIRTUAL_STORAGE_URI,
        system="Cloud Storage",
        platform="Google Cloud",
        display_name="LUM-LIG-DES-8G8J Unstructured SOP & Technical Manual Fileset",
        # ... description ...
        location=REGION,
    ),
)

create_entry_op = catalog_client.create_entry(
    parent=entry_group_resource_name,
    entry_id=FILESET_ENTRY_ID,
    entry=fileset_entry_spec,
)
Nota i ruoli distinti dei due campi URI in Entry:
fully_qualified_name=fully_qualified_fileset_uri(f"gcs:{BUCKET_NAME}"): utilizza lo schema FQN canonicogcs:{bucket_name}richiesto da Knowledge Catalog per correlare la voce di catalogo logica al bucket Cloud Storage sottostante.entry_source.resource=VIRTUAL_STORAGE_URI: memorizza l'URI dell'oggettogs://fisico ispezionato dai worker di estrazione downstream.
Esegui step3_register_fileset.py
python3 step3_register_fileset.py
Created Cloud Storage bucket:
  gs://your-project-id-dark-data-manuals in us-central1
Uploaded unstructured PDF manual to:
  gs://your-project-id-dark-data-manuals/sop-pdfs/LUM-LIG-DES-8G8J_manual.pdf
Registered governed Fileset Entry:
  projects/your-project-id/locations/us-central1/entryGroups/
  dark-data-fileset-group/entries/sop-manuals-fileset-lum8g8j
  -> Fully Qualified Name : gcs:your-project-id-dark-data-manuals
  -> Physical Resource URI:
  gs://your-project-id-dark-data-manuals/sop-pdfs/LUM-LIG-DES-8G8J_manual.pdf
  -> Source System        : Cloud Storage
6. Estrai i metadati del documento con Gemini
step4_extract_metadata.py legge i byte PDF non elaborati e richiama Gemini Enterprise Agent Platform (genai_client.models.generate_content) utilizzando due pattern chiave:
1. Rilevamento dinamico del modello di punta
Anziché codificare in modo rigido stringhe di versione del modello fragili, lo script esegue query su genai_client.models.list() e ordina i candidati attivi in base a (is_ga_channel, semantic_version_tuple) per scegliere il modello flash disponibile a livello generale (GA) più recente:
genai_client = genai.Client(
    vertexai=True,
    project=PROJECT_ID,
    location=GEMINI_LOCATION,
)

for model_obj in genai_client.models.list():
    raw_id = (model_obj.name or "").split("/")[-1]
    # Filter to flagship Gemini Flash models (version >= 3.0) and prioritize GA over preview
    ...
    discovered_candidates.append((is_ga_channel, ver_tuple, raw_id))

discovered_candidates.sort(key=lambda item: (item[0], item[1]), reverse=True)
2. Estrazione multimodale vincolata dallo schema (Part.from_bytes + response_schema)
Il passaggio di response_mime_type="application/json" e response_schema=DarkDataExtractedMetadata (seguito da DocumentGovernanceMetadata) vincola la decodifica del token direttamente allo schema JSON di Pydantic:
with open(LOCAL_PDF_PATH, "rb") as pdf_file:
    raw_pdf_bytes = pdf_file.read()

extraction_response = genai_client.models.generate_content(
    model=candidate_model,
    contents=[
        types.Part.from_bytes(data=raw_pdf_bytes, mime_type="application/pdf"),
        extraction_prompt,
    ],
    config=types.GenerateContentConfig(
        response_mime_type="application/json",
        response_schema=DarkDataExtractedMetadata,
        temperature=0.1,
    ),
)

extracted_dark_data = json.loads(extraction_response.text)
validated_extraction = DarkDataExtractedMetadata(**extracted_dark_data)
Esegui step4_extract_metadata.py
python3 step4_extract_metadata.py
Dynamically discovered active GA model currency :
  gemini-3.8-flash (version (3, 8))
Loaded unstructured PDF manual at: LUM-LIG-DES-8G8J_manual.pdf
Read unstructured PDF document (1184 bytes).
  Executing multimodal extraction with gemini-3.8-flash...
✓ Multimodal extraction completed using model: gemini-3.8-flash
✓ Governance classification completed using model: gemini-3.8-flash

--- Extracted Multimodal Operational Metadata ---
Extracted Attribute    Multimodal Value
document_title    LUM-LIG-DES-8G8J Contemporary Linen Desk Lamp
domain_ontology    Electrical Hardware & Lighting Systems
operational_hazard_level    MEDIUM
author_provenance    Global Hardware Safety & Lighting Systems Engin
version_provenance    Rev 4.2
document_summary    This document outlines standard operating proce
confidence_score    0.99

--- Extracted Governance & Inventory Cross-Reference Metadata ---
Governance Attribute    Classification Value
compliance_classifications    UL-153 Portable Luminaires, FCC Part 15, CE-LVD
stewardship_owner    Global Hardware Safety & Lighting Systems Engin
retention_policy    10-Year Active Product Lifecycle Archival
lakehouse_cross_ref_table    lakehouse.your-project-id.retail_hardware
governance_status    VERIFIED_PRODUCTION
7. Allegare aspetti convalidati alle voci di catalogo
step5_attach_aspects.py associa i payload JSON convalidati (extracted_metadata.json e governance_metadata.json) alla voce sop-manuals-fileset-lum8g8j tramite catalog_client.update_entry().
Mutazione dell'aspetto chirurgico in step5_attach_aspects.py
extracted_aspect_key = f"{PROJECT_ID}.{REGION}.{EXTRACTED_ASPECT_TYPE_ID}"
governance_aspect_key = f"{PROJECT_ID}.{REGION}.{GOVERNANCE_ASPECT_TYPE_ID}"

updated_entry_payload = Entry(
    name=fileset_entry_name,
    entry_type=entry_type_resource_name,
    fully_qualified_name=fully_qualified_fileset_uri,
    aspects={
        extracted_aspect_key: Aspect(
            aspect_type=extracted_aspect_type_name,
            data=extracted_data,
        ),
        governance_aspect_key: Aspect(
            aspect_type=governance_aspect_type_name,
            data=governance_data,
        ),
    },
)

update_op = catalog_client.update_entry(
    request=dataplex_v1.UpdateEntryRequest(
        entry=updated_entry_payload,
        update_mask={"paths": ["aspects"]},
        aspect_keys=[extracted_aspect_key, governance_aspect_key],
    )
)
Il passaggio degli ambiti update_mask={"paths": ["aspects"]} e aspect_keys=[extracted_aspect_key, governance_aspect_key] limita la mutazione rigorosamente a queste due chiavi di aspetto, lasciando entry_source e tutti gli aspetti di proprietà di altri team invariati.
Esegui step5_attach_aspects.py
python3 step5_attach_aspects.py
Successfully bound 2 Aspect(s) to Entry:
  projects/your-project-id/locations/us-central1/entryGroups/
  dark-data-fileset-group/entries/sop-manuals-fileset-lum8g8j

=== Live Attached Aspect: document-governance-aspect ===
Catalog Field    Authoritative Stored Value
compliance_classifications    UL-153 Portable Luminaires, FCC Part 15, CE-LVD
stewardship_owner    Global Hardware Safety & Lighting Systems Engin
retention_policy    10-Year Active Product Lifecycle Archival
lakehouse_cross_ref_table    lakehouse.your-project-id.retail_hardware
governance_status    VERIFIED_PRODUCTION

=== Live Attached Aspect: dark-data-extracted-metadata ===
Catalog Field    Authoritative Stored Value
document_title    LUM-LIG-DES-8G8J Contemporary Linen Desk Lamp
domain_ontology    Electrical Hardware & Lighting Systems
operational_hazard_level    MEDIUM
author_provenance    Global Hardware Safety & Lighting Systems Engin
version_provenance    Rev 4.2
document_summary    This document outlines standard operating proce
confidence_score    0.99
Verifica a doppio binario
- Traccia 1 (verifica CLI): esamina la voce con tutti gli aspetti allegati tramite
gcloud:gcloud dataplex entries describe sop-manuals-fileset-lum8g8j \ --entry-group=dark-data-fileset-group \ --location=$REGION \ --view=ALL - Traccia 2 (ispezione della UI della console):
- Apri la Knowledge Catalog Search Console, cerca LUM-LIG-DES-8G8J Unstructured SOP & Technical Manual Fileset (
sop-manuals-fileset-lum8g8j) e seleziona la voce corrispondente dai risultati. - Nella sezione Tag e aspetti facoltativi, verifica che sia Metadati multimodali estratti da dati oscuri sia Aspetto di governance e inventario dei documenti con riferimenti incrociati mostrino il livello di rischio estratto (
MEDIUM), i codici di conformità (UL-153, FCC Part 15, CE-LVD, RoHS) e la stringa della tabella di riferimenti incrociati (lakehouse_cross_ref_table).
- Apri la Knowledge Catalog Search Console, cerca LUM-LIG-DES-8G8J Unstructured SOP & Technical Manual Fileset (
8. Eseguire query sui dati oscuri controllati nel catalogo
Una volta collegati gli aspetti personalizzati, i manuali PDF non strutturati in Cloud Storage diventano rilevabili tramite la ricerca di Knowledge Catalog (catalog_client.search_entries()).
Sondaggio search_entries() in step6_search_catalog.py
step6_search_catalog.py esegue il polling search_entries() con backoff esponenziale e legge le chiavi di aspetto canonizzate tramite .endswith():
search_query = f"entrygroup={entry_group_resource_name} name:{FILESET_ENTRY_ID}"

while elapsed_seconds < max_wait_seconds:
    catalog_search_results = list(
        catalog_client.search_entries(
            request=dataplex_v1.SearchEntriesRequest(
                name=parent_location,
                query=search_query,
            )
        )
    )
    if catalog_search_results:
        break
    backoff_seconds = min(5 * (2 ** attempt), 30)
    time.sleep(backoff_seconds)
    ...

for k, asp in detailed_entry.aspects.items():
    if k.endswith(f".{REGION}.{EXTRACTED_ASPECT_TYPE_ID}"):
        print(f"    Domain Ontology     : {asp.data.get('domain_ontology')}")
        print(f"    Hazard Level        : {asp.data.get('operational_hazard_level')}")
    elif k.endswith(f".{REGION}.{GOVERNANCE_ASPECT_TYPE_ID}"):
        print(f"    Compliance Codes    : {asp.data.get('compliance_classifications')}")
        print(f"    Lakehouse Join Table: {asp.data.get('lakehouse_cross_ref_table')}")
Esegui step6_search_catalog.py
python3 step6_search_catalog.py
Executing Knowledge Catalog search query:
  'entrygroup=projects/your-project-id/locations/us-central1/entryGroups/
  dark-data-fileset-group name:sop-manuals-fileset-lum8g8j'...

✓ Discovered 1 governed asset(s) in Knowledge Catalog:

[1] Entry Resource Name :
    projects/your-project-id/locations/us-central1/entryGroups/
    dark-data-fileset-group/entries/sop-manuals-fileset-lum8g8j
    Fully Qualified Name: gcs:your-project-id-dark-data-manuals
    Entry Type :
    projects/your-project-id/locations/us-central1/entryTypes/
    unstructured-pdf-fileset
    Physical Storage URI:
    gs://your-project-id-dark-data-manuals/sop-pdfs/LUM-LIG-DES-8G8J_manual.pdf
    Domain Ontology     : Electrical Hardware & Lighting Systems
    Hazard Level        : MEDIUM
    Compliance Codes    : UL-153 Portable Luminaires, FCC Part 15, CE-LVD, RoHS
    Lakehouse Join Table:
    lakehouse.your-project-id.retail_hardware.luminaire_sku_inventory_iceberg
Verifica a doppio binario
- Traccia 1 (ricerca CLI): esegui query sull'indice di ricerca direttamente tramite
gcloud:gcloud dataplex entries search "name:sop-manuals-fileset-lum8g8j" --project=$PROJECT_ID - Traccia 2 (ricerca in linguaggio naturale nell'interfaccia utente della console):
- Apri Knowledge Catalog Search Console e cerca
LUM-LIG-DES-8G8JoUL-153. - Osserva come Knowledge Catalog mostra la voce del set di file PDF di Cloud Storage controllato e i relativi aspetti dei metadati allegati.
- Apri Knowledge Catalog Search Console e cerca
9. Verifica le asserzioni di governance end-to-end
step7_verify_assertions.py esegue asserzioni deterministiche sulle risposte del piano di controllo di Knowledge Catalog in tempo reale per verificare che EntryGroup, EntryType, entrambi i blueprint personalizzati AspectType, i payload degli aspetti associati EntryView.ALL (limiti confidence_score e stringa lakehouse_cross_ref_table) e l'individuazione dell'indice di ricerca vadano a buon fine:
verify_eg = catalog_client.get_entry_group(name=entry_group_resource_name)
assert verify_eg.name == entry_group_resource_name, "EntryGroup resource name mismatch."

verify_entry = catalog_client.get_entry(
    request=dataplex_v1.GetEntryRequest(
        name=fileset_entry_name,
        view=dataplex_v1.EntryView.ALL,
    )
)
bound_extracted = next(
    (
        asp for k, asp in verify_entry.aspects.items()
        if k.endswith(f".{REGION}.{EXTRACTED_ASPECT_TYPE_ID}")
    ),
    None,
)
bound_governance = next(
    (
        asp for k, asp in verify_entry.aspects.items()
        if k.endswith(f".{REGION}.{GOVERNANCE_ASPECT_TYPE_ID}")
    ),
    None,
)

assert bound_extracted is not None, f"Aspect '{EXTRACTED_ASPECT_TYPE_ID}' not found on live Entry."
assert bound_governance is not None, (
    f"Aspect '{GOVERNANCE_ASPECT_TYPE_ID}' not found on live Entry."
)
assert (
    bound_extracted.data.get("document_title") == expected_extraction["document_title"]
), "Extracted title mismatch."
assert (
    0.0 <= float(bound_extracted.data.get("confidence_score", -1.0)) <= 1.0
), "Invalid confidence score in catalog."
assert (
    "lakehouse" in str(bound_governance.data.get("lakehouse_cross_ref_table", "")).lower()
), "Missing Lakehouse cross-reference."
...
assert len(search_results) >= 1, "Expected at least 1 search result in Knowledge Catalog."
Esegui step7_verify_assertions.py
python3 step7_verify_assertions.py && echo "Verification exit code: $?"
Running substantive end-to-end verification assertions...
✓ All 5 substantive verification assertions passed
  against live Google Cloud control plane state!
Verification exit code: 0
10. Progetta una pipeline basata su eventi
L'esecuzione interattiva di script Python in Cloud Shell è ideale per creare e testare i contratti di governance, ma gli ambienti aziendali ricevono quotidianamente migliaia di manuali di ingegneria in formato PDF nuovi o rivisti, certificati di conformità dei fornitori e documenti SOP da ERP, Product Lifecycle Management (PLM) e portali dei fornitori. L'esecuzione manuale di script batch crea rapidamente punti ciechi di governance tra il caricamento dei documenti e l'indicizzazione del catalogo.
In produzione, i team della piattaforma rendono operativo il codice esatto che hai eseguito nei passaggi 4 e 5 come pipeline zero-touch basata su eventi:
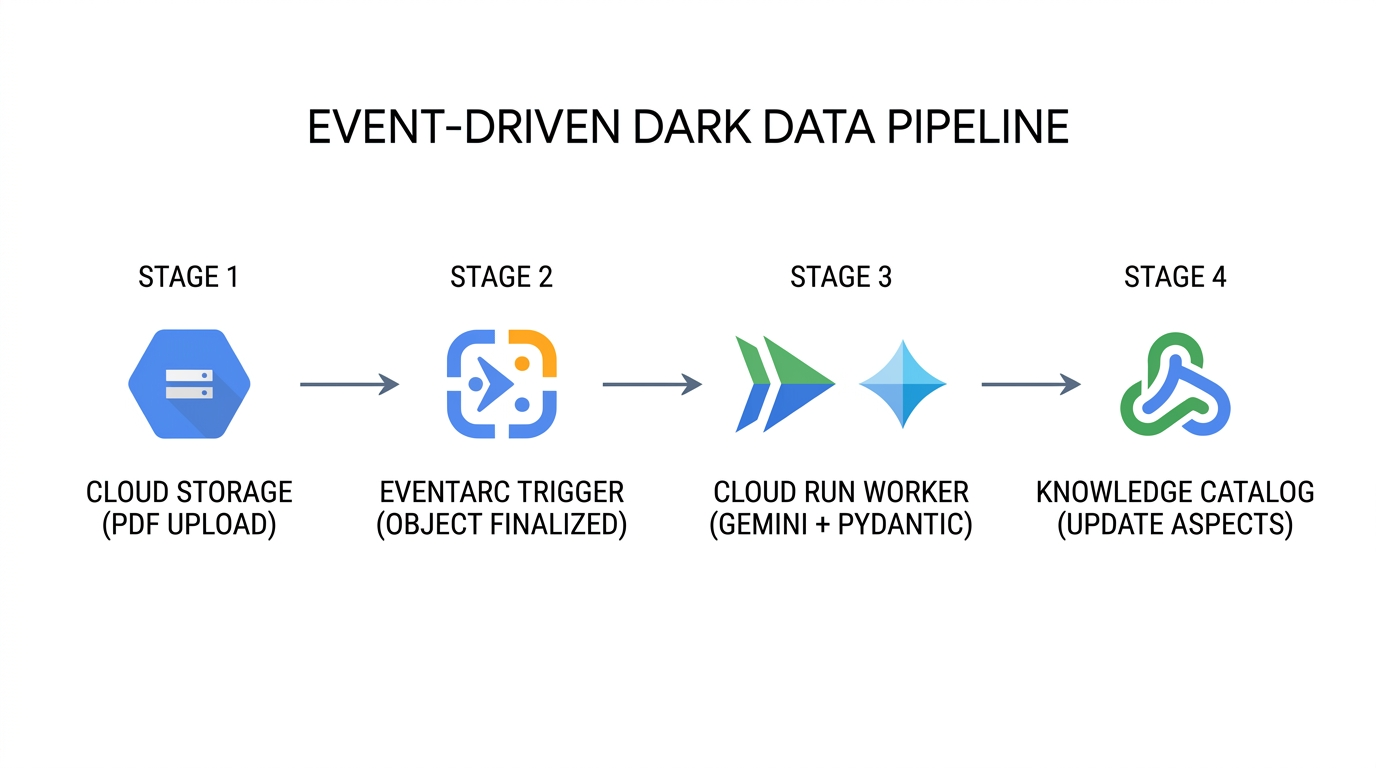
- Importazione continua di documenti (
Cloud Storage→Eventarc): ogni volta che viene caricato un nuovo manuale in PDF o una nuova revisione sovrascrive un oggetto esistente in Cloud Storage, il bucket emette un CloudEventgoogle.cloud.storage.object.v1.finalizedcontenente l'identificatore del bucket, il percorso dell'oggetto e il numero di generazione dell'oggetto. - Estrazione multimodale stateless (
Eventarc→Cloud Run→Gemini Enterprise Agent Platform): Eventarc indirizza CloudEvent a un worker Cloud Run serverless che includeschemas.py,step4_extract_metadata.pyestep5_attach_aspects.py. Il worker trasmette in streaming i byte del PDF a Gemini Enterprise Agent Platform conresponse_schemaapplicato, garantendo che ogni attributo estratto sia conforme aDarkDataExtractedMetadataeDocumentGovernanceMetadata. - Aggiornamento del piano di controllo chirurgico (
Cloud Run→Knowledge Catalog): il worker risolve il Fileset principaleEntryed eseguecatalog_client.update_entry()conupdate_mask={"paths": ["aspects"]}easpect_keysesplicito. Anche se l'elaborazione di decine di documenti termina contemporaneamente, ogni mutazione aggiorna solo le chiavi degli aspetti designate. - Quarantena con controllo di confidenza: se un PDF legacy scansionato produce un'estrazione
confidence_scoreal di sotto della soglia operativa (ad esempio,< 0.85), il worker impostagovernance_status = "PENDING_STEWARD_REVIEW"sull'aspetto allegato in modo che i responsabili dei dati possano eseguire query su Knowledge Catalog per gli asset a bassa confidenza che richiedono una revisione umana.
Come le aziende applicano questo pattern in produzione
Caso d'uso aziendale | Come funziona in pratica Metadata-as-Code | Impatto operativo e sul business |
Controlli normativi automatizzati e preparazione al ritiro | I sistemi di conformità uniscono gli aspetti di sicurezza dei PDF non strutturati ( | Quando viene aggiornato uno standard come |
Agenti AI fondati e pre-filtraggio RAG | Prima che un agente di Retrieval-Augmented Generation (RAG) su Gemini Enterprise Agent Platform risponda alla domanda di un tecnico sul campo, filtra le voci del Knowledge Catalog in base a | Impedisce agli assistenti AI di avere allucinazioni o di citare bozze di ingegneria ritirate, procedure operative standard scadute o manuali di terze parti non verificati. |
Arricchimento simultaneo di più team | Più pipeline indipendenti arricchiscono lo stesso Fileset | Poiché |
Evoluzione dello schema CI/CD tramite GitOps | I team della piattaforma archiviano le definizioni di | Elimina la deriva dello schema tra il codice di estrazione dell'applicazione e il piano di controllo di Knowledge Catalog nei progetti |
11. Pulizia dell'ambiente
In Knowledge Catalog, i contenitori principali e i modelli di schema non possono essere eliminati finché le voci secondarie fanno ancora riferimento a questi elementi. cleanup.py elimina le risorse in ordine inverso di dipendenza rigoroso (Entry → EntryGroup → EntryType → AspectTypes → oggetti bucket Cloud Storage → file JSON temporanei):
# 1. Delete Fileset Entry first
catalog_client.delete_entry(name=target_entry_path)

# 2. Delete EntryGroup container
del_eg_op = catalog_client.delete_entry_group(name=target_eg_path)
if hasattr(del_eg_op, "result"):
    del_eg_op.result()

# 3. Delete EntryType and Custom AspectTypes
del_et_op = catalog_client.delete_entry_type(name=target_et_path)
if hasattr(del_et_op, "result"):
    del_et_op.result()
for aspect_id_val in (EXTRACTED_ASPECT_TYPE_ID, GOVERNANCE_ASPECT_TYPE_ID):
    target_at_path = f"{active_parent}/aspectTypes/{aspect_id_val}"
    del_at_op = catalog_client.delete_aspect_type(name=target_at_path)
    if hasattr(del_at_op, "result"):
        del_at_op.result()
Esegui cleanup.py
python3 cleanup.py
Starting reverse-dependency resource cleanup in Knowledge Catalog...
Deleted Fileset Entry:
  projects/your-project-id/locations/us-central1/entryGroups/
  dark-data-fileset-group/entries/sop-manuals-fileset-lum8g8j
Deleted EntryGroup   :
  projects/your-project-id/locations/us-central1/entryGroups/
  dark-data-fileset-group
Deleted EntryType    :
  projects/your-project-id/locations/us-central1/entryTypes/
  unstructured-pdf-fileset
Deleted AspectType   :
  projects/your-project-id/locations/us-central1/aspectTypes/
  dark-data-extracted-metadata
Deleted AspectType   :
  projects/your-project-id/locations/us-central1/aspectTypes/
  document-governance-aspect
Deleted Cloud Storage object :
  gs://your-project-id-dark-data-manuals/sop-pdfs/LUM-LIG-DES-8G8J_manual.pdf
Deleted Cloud Storage bucket : gs://your-project-id-dark-data-manuals
Removed local temporary file : extracted_metadata.json
Removed local temporary file : governance_metadata.json
✓ Standalone teardown complete. Environment cleanly reset.
Rimuovi la directory del repository clonato
Dopo che cleanup.py ha terminato l'eliminazione delle risorse cloud, torna alla home directory e rimuovi la cartella del repository devrel-demos clonata da Cloud Shell:
cd ~
rm -rf ~/devrel-demos
12. Complimenti!
Hai creato e verificato una pipeline di governance Metadata-as-Code end-to-end che trasforma i PDF non strutturati in Cloud Storage in asset Knowledge Catalog rilevabili e con schema applicato utilizzando Gemini Enterprise Agent Platform.
Passaggi successivi
- Automatizza con Terraform: gestisci le risorse
google_dataplex_aspect_typeegoogle_dataplex_entry_groupin modo dichiarativo nelle pipeline CI/CD. - Esegui il deployment di Eventarc + Cloud Run Workers: containerizza
step4_extract_metadata.pyestep5_attach_aspects.pyin un servizio Cloud Run basato su eventi. - Unioni dell'inventario downstream in BigQuery: esporta i metadati di governance estratti (
lakehouse_cross_ref_table) per unire gli attributi di conformità dei documenti non strutturati alle tabelle dell'inventario SKU strutturato.