

1. はじめに
企業データの 80% 以上は、非構造化形式(Cloud Storage に保存されている PDF エンジニアリング マニュアル、標準業務手順(SOP)、コンプライアンス証明書、機器の回路図など)で存在しています。従来のカタログはリレーショナル テーブル スキーマのみをインデックスに登録するため、これらのドキュメントは「ダークデータ」のままです。つまり、エンタープライズ検索では認識されず、構造化されたインベントリ テーブルから切り離され、規制遵守の検証も行われません。
監査担当者や AI エージェントが「どのハードウェア SKU に UL-153 安全認証が必要ですか?また、それらの熱的危険レベルは何ですか?」と質問した場合、SQL テーブルのみをインデックス登録するカタログでは回答できません。事実が Cloud Storage の非構造化 PDF にロックされている。
アーキテクチャ ソリューション: マルチモーダル メタデータ コード
この Codelab では、Google Cloud でエンドツーエンドの Metadata-as-Code パイプラインを構築します。このパイプラインは、Cloud Storage 内の構造化されていない PDF マニュアルを、Gemini Enterprise Agent Platform(Google GenAI SDK、google-genai)を使用してスキーマが適用された Knowledge Catalog アセットに変換します。
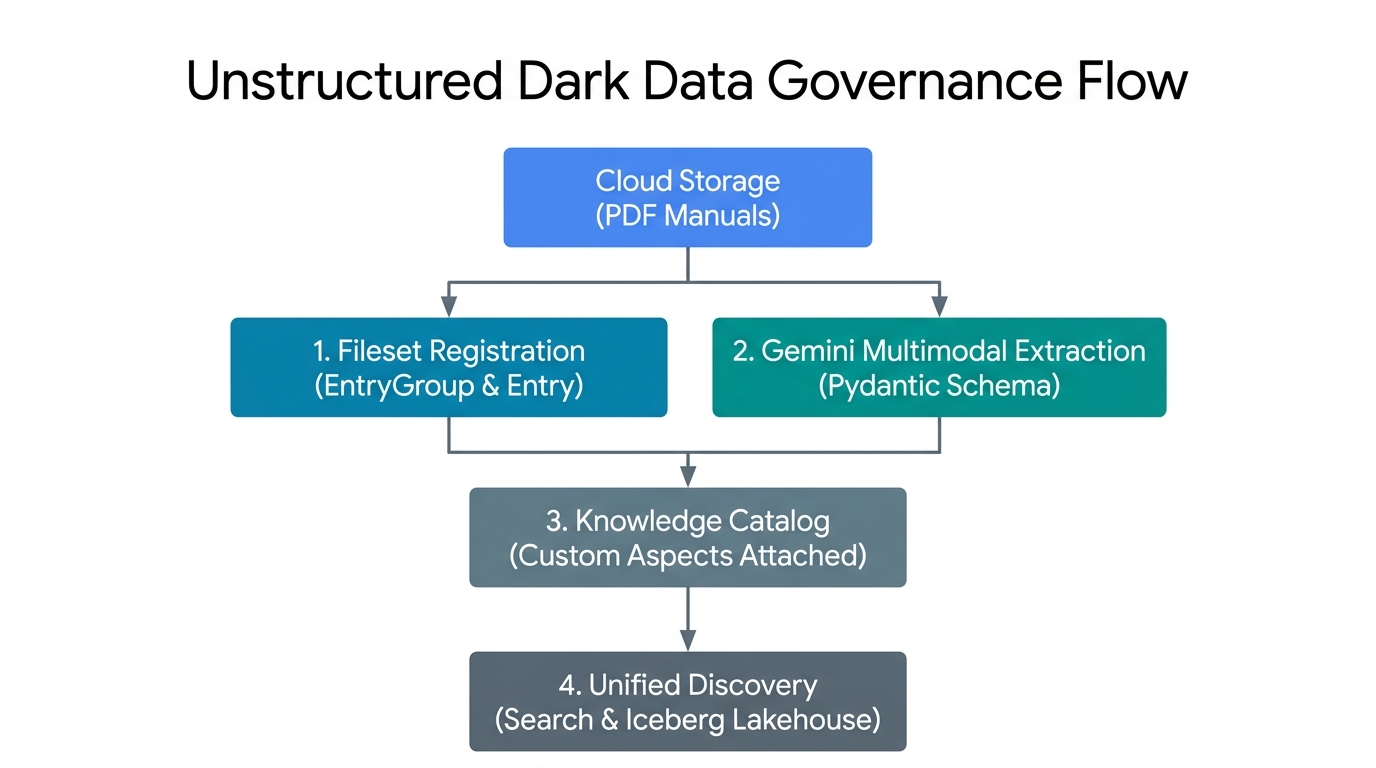
- Fileset 登録(
EntryGroupとEntry): Cloud Storage 内の非構造化 PDF を Knowledge Catalog 内のガバナンス対象の論理ファイルセット エントリにグループ化します。 - Gemini Multimodal Extraction(Pydantic スキーマ): 決定論的な
response_schema検証を使用して、未加工の PDF バイトで Gemini Enterprise Agent Platform を呼び出します。 - コントロール プレーンのアスペクト バインディング: 検証済みの運用とコンプライアンスの JSON ペイロードを、カタログ エントリの厳密に型指定された
Aspectインスタンスとして関連付けます。 - 統合カタログ検出: 非構造化 PDF ファイルセットとその抽出されたメタデータを
SearchEntriesRequestで検出できるようにします。
主なコンセプト: Knowledge Catalog コントロール プレーン プリミティブ
たとえば、チームが数百もの PDF 製品マニュアルを Cloud Storage に保存しているとします。これらのファイルを Knowledge Catalog で簡単に見つけて確認できるようにするには、5 つの構成要素を オフィス ファイル キャビネットに紙のマニュアルを整理するようなものだと考えます。
EntryGroup(1 つのチーム用のロックされたキャビネット): ロック付きのキャビネット。フォルダを入れられるのは、権限(roles/dataplex.entryCreator)を持つチームメンバーのみです。キャビネット自体を削除するには、キャビネット内のすべてのフォルダを空にする必要があります。EntryType(フォルダ カテゴリのラベル): フォルダが表すアセットの種類をユーザーに伝えるラベル。たとえば、「データベース テーブル」ではなく「PDF マニュアル コレクション」など。Entry(ストレージ リンク付きのファイル フォルダ): PDF マニュアルのカタログ フォルダ。重い紙のコピーを保持する代わりに、フォルダには、実際の PDF ファイルが保存されている正確な Cloud Storage バケット(gs://...)を指すロケーション カードが保持されます。AspectType(空白のチェックリスト フォーム): 再利用可能な空白のフォーム。あらかじめ印刷されたボックスがあります(例: 「安全チェックリスト」。テキストとしてoperational_hazard_level、数値として0.0~1.0のconfidence_scoreを求めるもの)。この空白のフォームを一度作成すると、数千のフォルダで再利用できます。Aspect(フォルダに添付されたチェックリストに記入済み): Gemini Enterprise Agent Platform が PDF マニュアルを読み取り、空欄を埋めると、完成したチェックリストがEntryフォルダにクリップされます。各チェックリストには独自のキー(aspect_keys)があるため、エンジニアリング チームと法務チームは、互いの作業を上書きすることなく、同じフォルダに独自のチェックリストを添付できます。
5 つのリージョン リソースはすべて projects/{project}/locations/{location}/ の下にあります。
プリミティブと相対パス | Knowledge Catalog のロール | 削除と IAM ルール |
| エントリをグループ化し、チームのアクセスを制御する論理コンテナ( | 削除する前に、子 |
| アセットのクラスのカテゴリ定義( | このタイプを使用するすべてのエントリが削除された後にのみ削除します。 |
| 物理的な Cloud Storage URI( |
|
| 型付き | リージョンごとに 1 回作成され、エントリ間で共有されます。 |
|
|
|
作成するアプリの概要
codelabs/metadata-as-code-lab のコンパニオン スクリプトを使用して、7 ステージのパイプラインを実行して検査します。
schemas.py- Knowledge CatalogAspectTypeテンプレートと 1 対 1 でペア設定されたデュアル PydanticBaseModelスキーマ(DarkDataExtractedMetadataとDocumentGovernanceMetadata)。step2_provision.py- カスタムEntryGroup、EntryType、AspectTypeブループリントのべき等プロビジョニング。step3_register_fileset.py-LUM-LIG-DES-8G8J_manual.pdfの Cloud Storage へのアップロードと、管理対象 FilesetEntryとしての登録。step4_extract_metadata.py-google-genaiを使用した動的なフラッグシップ Gemini モデルの検出とマルチモーダル PDF の抽出。step5_attach_aspects.py、step6_search_catalog.py、step7_verify_assertions.py- 手術用アスペクトの添付、指数バックオフ カタログ検索、エンドツーエンドのコントロール プレーン アサーション。
前提条件と必要なもの
- 課金が有効になっている Google Cloud プロジェクトと Google Cloud Shell(
gcloud、git、python3、pipがプリインストールされています)。 - Knowledge Catalog リソース(
roles/dataplex.admin)の管理、Cloud Storage バケットとオブジェクト(roles/storage.admin)のプロビジョニング、Gemini Enterprise Agent Platform(roles/aiplatform.user)の呼び出しを行うための IAM 権限。 - ウェブブラウザ(Google Chrome など)。
2. 設定と要件
Cloud Shell でコンパニオン リポジトリのクローンを作成する
Google Cloud コンソールを開き、Cloud Shell を起動して、codelabs/metadata-as-code-lab のスパース チェックアウトを実行します。これには、サンプル PDF エンジニアリング マニュアル(LUM-LIG-DES-8G8J_manual.pdf)とすべての Python スクリプトが含まれます。
git clone --branch main --depth 1 --filter=blob:none --sparse \
  https://github.com/GoogleCloudPlatform/devrel-demos.git
cd devrel-demos
git sparse-checkout set codelabs/metadata-as-code-lab
cd codelabs/metadata-as-code-lab
ls -la
環境変数を構成する
Cloud Shell で、プロジェクト ID、リージョン コントロール プレーンのロケーション、ターゲットの Cloud Storage バケットを設定します。
export PROJECT_ID="${PROJECT_ID:-$(gcloud config get-value project)}"
gcloud config set project $PROJECT_ID

export REGION="us-central1"
export BUCKET_NAME="${PROJECT_ID}-dark-data-manuals"
export GEMINI_LOCATION="global"

echo "Configured Project ID        : $PROJECT_ID"
echo "Knowledge Catalog Region     : $REGION"
echo "Gemini Endpoint Location     : $GEMINI_LOCATION"
echo "Target Cloud Storage Bucket  : $BUCKET_NAME"
API を有効にして依存関係をインストールする
必要な Google Cloud API を有効にし、requirements.txt から Python の依存関係(google-genai、google-cloud-dataplex、pydantic、pandas)をインストールします。
gcloud services enable \
  dataplex.googleapis.com \
  storage.googleapis.com \
  aiplatform.googleapis.com \
  --quiet
python3 -m pip install --upgrade --quiet --user --break-system-packages -r requirements.txt
3. Pydantic スキーマとアスペクト テンプレートを定義する
schemas.py は、クライアントサイドの Pydantic 検証とサーバーサイドの Knowledge Catalog AspectType テンプレートを組み合わせた 2 つの補完的なコントラクトを定義します。
DarkDataExtractedMetadata: PDF から抽出された運用属性(ドキュメントのタイトル、ドメイン オントロジー、安全上の危険レベル、作成/バージョンの来歴、要約、抽出の信頼度スコア)。DocumentGovernanceMetadata: 規制遵守コード(UL-153、FCC Part 15、CE-LVD、RoHS)、スチュワードシップ オーナー、保持ポリシー、PDF マニュアルを下流のインベントリ テーブルにリンクするための参照テーブル識別子文字列(lakehouse_cross_ref_table)。
schemas.py を検査する
まず、DarkDataExtractedMetadata は Pydantic Field 制約(confidence_score の ge=0.0, le=1.0、つまり以上/以下)を使用して、Gemini Enterprise Agent Platform の JSON 出力を制約します。
class DarkDataExtractedMetadata(BaseModel):
    document_title: str = Field(
        description="Official document title or product model name extracted from the PDF manual."
    )
    # ... domain_ontology, operational_hazard_level, author_provenance ...
    version_provenance: str = Field(
        description="Document version, revision code, or publication standard identifier."
    )
    # ... document_summary ...
    confidence_score: float = Field(
        ge=0.0,
        le=1.0,
        description="AI extraction confidence metric between 0.0 and 1.0.",
    )
次に、extracted_aspect_template はこれらのフィールド名をミラーリングし、Python の str 型と float 型を Knowledge Catalog の string 型と double 型 record_fields にマッピングします。AspectType.MetadataTemplate protobuf 契約では、record_fields のすべてのフィールドで一意の厳密に正の 1 ベースの整数 index(1~7)を宣言する必要があります。index を省略または重複させると、create_aspect_type が 400 INVALID_ARGUMENT で失敗します。
extracted_aspect_template = {
    "name": "DarkDataExtractedMetadata",
    "type": "record",
    "record_fields": [
        {
            "name": "document_title",
            "type": "string",
            "index": 1,
            "annotations": {"description": "Official document title or product model name."},
        },
        # ... fields 2 through 6 (string) ...
        {
            "name": "confidence_score",
            "type": "double",
            "index": 7,
            # ... annotations ...
        },
    ],
}
スキーマ モジュールを検証する
schemas.py を実行して、環境構成を確認し、両方のスキーマをコンパイルします。
python3 schemas.py
Configured Project ID         : your-project-id
Knowledge Catalog Region      : us-central1
Gemini Endpoint Location      : global
Governed Fileset Storage URI  :
  gs://your-project-id-dark-data-manuals/sop-pdfs/LUM-LIG-DES-8G8J_manual.pdf
Target Fileset Entry ID       : sop-manuals-fileset-lum8g8j
✓ Defined DarkDataExtractedMetadata and DocumentGovernanceMetadata
  Pydantic schemas.
✓ Prepared Knowledge Catalog AspectType metadata templates.
4. Namespace とカスタム アスペクト タイプをプロビジョニングする
ファイルセット エントリを登録したり、メタデータを関連付けたりする前に、step2_provision.py は Knowledge Catalog に 3 つのコントロール プレーン リソースをプロビジョニングします。
EntryGroup:dark-data-fileset-groupEntryType:unstructured-pdf-filesetAspectTypeブループリント:dark-data-extracted-metadata、document-governance-aspect
step2_provision.py でのべき等プロビジョニング
step2_provision.py の各作成呼び出しは、長時間実行オペレーション(op.result())を try / except AlreadyExists ブロックでラップします。これにより、既存のリソースで失敗することなく、スクリプトを安全に再実行できます。
# Provision AspectType 1: dark-data-extracted-metadata
try:
    at1_op = catalog_client.create_aspect_type(
        parent=parent_location,
        aspect_type_id=EXTRACTED_ASPECT_TYPE_ID,
        aspect_type=AspectType(
            name=extracted_aspect_type_name,
            display_name="Dark Data Multimodal Extracted Metadata",
            # ... description ...
            metadata_template=extracted_aspect_template,
        ),
    )
    if hasattr(at1_op, "result"):
        at1_op.result()
    print(f"Created AspectType: {extracted_aspect_type_name}")
except AlreadyExists:
    print(f"AspectType already exists; retrieving live resource: {extracted_aspect_type_name}")

live_extracted_aspect_type = catalog_client.get_aspect_type(name=extracted_aspect_type_name)
metadata_template=extracted_aspect_template が登録されると、Knowledge Catalog は API 境界でスキーマを適用します。以降、confidence_score(double)に文字列を渡す update_entry() 呼び出しは拒否されます。
step2_provision.py を実行します
プロビジョニング スクリプトを実行し、カスタム アスペクト タイプがリージョンに登録されていることを確認します。
python3 step2_provision.py
gcloud dataplex aspect-types list --location=$REGION
Created EntryGroup:
  projects/your-project-id/locations/us-central1/entryGroups/
  dark-data-fileset-group
Created EntryType :
  projects/your-project-id/locations/us-central1/entryTypes/
  unstructured-pdf-fileset
Created AspectType:
  projects/your-project-id/locations/us-central1/aspectTypes/
  dark-data-extracted-metadata
Created AspectType:
  projects/your-project-id/locations/us-central1/aspectTypes/
  document-governance-aspect
✓ All Knowledge Catalog namespaces and AspectType blueprints are active.
5. 非構造化ファイルセット エントリを登録する
Knowledge Catalog は、数百万もの孤立したファイル ポインタでカタログを埋め尽くすのではなく、関連するドキュメントを Cloud Storage(gs://YOUR_BUCKET/sop-pdfs/*.pdf)内の論理的なファイルセット エントリにグループ化します。これは、自動検出スキャン(DataScanServiceClient)または直接のプログラム登録(CatalogServiceClient.create_entry)のいずれかで行われます。
step3_register_fileset.py がストレージをカタログにマッピングする方法
step3_register_fileset.py は LUM-LIG-DES-8G8J_manual.pdf を gs://${BUCKET_NAME}/sop-pdfs/LUM-LIG-DES-8G8J_manual.pdf にアップロードし、ガバナンス対象の Entry を登録します。
fully_qualified_fileset_uri = f"gcs:{BUCKET_NAME}"
fileset_entry_spec = Entry(
    name=fileset_entry_name,
    entry_type=entry_type_resource_name,
    fully_qualified_name=fully_qualified_fileset_uri,
    entry_source=EntrySource(
        resource=VIRTUAL_STORAGE_URI,
        system="Cloud Storage",
        platform="Google Cloud",
        display_name="LUM-LIG-DES-8G8J Unstructured SOP & Technical Manual Fileset",
        # ... description ...
        location=REGION,
    ),
)

create_entry_op = catalog_client.create_entry(
    parent=entry_group_resource_name,
    entry_id=FILESET_ENTRY_ID,
    entry=fileset_entry_spec,
)
Entry の 2 つの URI フィールドの役割が異なることに注意してください。
fully_qualified_name=fully_qualified_fileset_uri(f"gcs:{BUCKET_NAME}"): Knowledge Catalog で必要な正規のgcs:{bucket_name}FQN スキーマを使用して、論理カタログ エントリと基盤となる Cloud Storage バケットを関連付けます。entry_source.resource=VIRTUAL_STORAGE_URI: 下流の抽出ワーカーによって検査された物理gs://オブジェクト URI を保存します。
step3_register_fileset.py を実行します
python3 step3_register_fileset.py
Created Cloud Storage bucket:
  gs://your-project-id-dark-data-manuals in us-central1
Uploaded unstructured PDF manual to:
  gs://your-project-id-dark-data-manuals/sop-pdfs/LUM-LIG-DES-8G8J_manual.pdf
Registered governed Fileset Entry:
  projects/your-project-id/locations/us-central1/entryGroups/
  dark-data-fileset-group/entries/sop-manuals-fileset-lum8g8j
  -> Fully Qualified Name : gcs:your-project-id-dark-data-manuals
  -> Physical Resource URI:
  gs://your-project-id-dark-data-manuals/sop-pdfs/LUM-LIG-DES-8G8J_manual.pdf
  -> Source System        : Cloud Storage
6. Gemini を使用してドキュメントのメタデータを抽出する
step4_extract_metadata.py は、未加工の PDF バイトを読み取り、次の 2 つのキーパターンを使用して Gemini Enterprise Agent Platform(genai_client.models.generate_content)を呼び出します。
1. 動的な最上位モデルの検出
脆弱なモデル バージョン文字列をハードコードする代わりに、スクリプトは genai_client.models.list() をクエリし、(is_ga_channel, semantic_version_tuple) でアクティブな候補を並べ替えて、最新の一般提供(GA)flash モデルを選択します。
genai_client = genai.Client(
    vertexai=True,
    project=PROJECT_ID,
    location=GEMINI_LOCATION,
)

for model_obj in genai_client.models.list():
    raw_id = (model_obj.name or "").split("/")[-1]
    # Filter to flagship Gemini Flash models (version >= 3.0) and prioritize GA over preview
    ...
    discovered_candidates.append((is_ga_channel, ver_tuple, raw_id))

discovered_candidates.sort(key=lambda item: (item[0], item[1]), reverse=True)
2. スキーマ制約付きマルチモーダル抽出(Part.from_bytes + response_schema)
response_mime_type="application/json" と response_schema=DarkDataExtractedMetadata(DocumentGovernanceMetadata が続く)を渡すと、トークンのデコードが Pydantic JSON スキーマに直接制約されます。
with open(LOCAL_PDF_PATH, "rb") as pdf_file:
    raw_pdf_bytes = pdf_file.read()

extraction_response = genai_client.models.generate_content(
    model=candidate_model,
    contents=[
        types.Part.from_bytes(data=raw_pdf_bytes, mime_type="application/pdf"),
        extraction_prompt,
    ],
    config=types.GenerateContentConfig(
        response_mime_type="application/json",
        response_schema=DarkDataExtractedMetadata,
        temperature=0.1,
    ),
)

extracted_dark_data = json.loads(extraction_response.text)
validated_extraction = DarkDataExtractedMetadata(**extracted_dark_data)
step4_extract_metadata.py を実行します
python3 step4_extract_metadata.py
Dynamically discovered active GA model currency :
  gemini-3.8-flash (version (3, 8))
Loaded unstructured PDF manual at: LUM-LIG-DES-8G8J_manual.pdf
Read unstructured PDF document (1184 bytes).
  Executing multimodal extraction with gemini-3.8-flash...
✓ Multimodal extraction completed using model: gemini-3.8-flash
✓ Governance classification completed using model: gemini-3.8-flash

--- Extracted Multimodal Operational Metadata ---
Extracted Attribute    Multimodal Value
document_title    LUM-LIG-DES-8G8J Contemporary Linen Desk Lamp
domain_ontology    Electrical Hardware & Lighting Systems
operational_hazard_level    MEDIUM
author_provenance    Global Hardware Safety & Lighting Systems Engin
version_provenance    Rev 4.2
document_summary    This document outlines standard operating proce
confidence_score    0.99

--- Extracted Governance & Inventory Cross-Reference Metadata ---
Governance Attribute    Classification Value
compliance_classifications    UL-153 Portable Luminaires, FCC Part 15, CE-LVD
stewardship_owner    Global Hardware Safety & Lighting Systems Engin
retention_policy    10-Year Active Product Lifecycle Archival
lakehouse_cross_ref_table    lakehouse.your-project-id.retail_hardware
governance_status    VERIFIED_PRODUCTION
7. 検証済みの側面をカタログ エントリに添付する
step5_attach_aspects.py は、検証済みの JSON ペイロード(extracted_metadata.json と governance_metadata.json)を catalog_client.update_entry() 経由で sop-manuals-fileset-lum8g8j エントリにバインドします。
step5_attach_aspects.py の外科的側面ミューテーション
extracted_aspect_key = f"{PROJECT_ID}.{REGION}.{EXTRACTED_ASPECT_TYPE_ID}"
governance_aspect_key = f"{PROJECT_ID}.{REGION}.{GOVERNANCE_ASPECT_TYPE_ID}"

updated_entry_payload = Entry(
    name=fileset_entry_name,
    entry_type=entry_type_resource_name,
    fully_qualified_name=fully_qualified_fileset_uri,
    aspects={
        extracted_aspect_key: Aspect(
            aspect_type=extracted_aspect_type_name,
            data=extracted_data,
        ),
        governance_aspect_key: Aspect(
            aspect_type=governance_aspect_type_name,
            data=governance_data,
        ),
    },
)

update_op = catalog_client.update_entry(
    request=dataplex_v1.UpdateEntryRequest(
        entry=updated_entry_payload,
        update_mask={"paths": ["aspects"]},
        aspect_keys=[extracted_aspect_key, governance_aspect_key],
    )
)
update_mask={"paths": ["aspects"]} と aspect_keys=[extracted_aspect_key, governance_aspect_key] の両方を渡すと、ミューテーションはこれらの 2 つのアスペクトキーに厳密にスコープ設定され、entry_source と他のチームが所有するアスペクトは変更されません。
step5_attach_aspects.py を実行します
python3 step5_attach_aspects.py
Successfully bound 2 Aspect(s) to Entry:
  projects/your-project-id/locations/us-central1/entryGroups/
  dark-data-fileset-group/entries/sop-manuals-fileset-lum8g8j

=== Live Attached Aspect: document-governance-aspect ===
Catalog Field    Authoritative Stored Value
compliance_classifications    UL-153 Portable Luminaires, FCC Part 15, CE-LVD
stewardship_owner    Global Hardware Safety & Lighting Systems Engin
retention_policy    10-Year Active Product Lifecycle Archival
lakehouse_cross_ref_table    lakehouse.your-project-id.retail_hardware
governance_status    VERIFIED_PRODUCTION

=== Live Attached Aspect: dark-data-extracted-metadata ===
Catalog Field    Authoritative Stored Value
document_title    LUM-LIG-DES-8G8J Contemporary Linen Desk Lamp
domain_ontology    Electrical Hardware & Lighting Systems
operational_hazard_level    MEDIUM
author_provenance    Global Hardware Safety & Lighting Systems Engin
version_provenance    Rev 4.2
document_summary    This document outlines standard operating proce
confidence_score    0.99
デュアルトラックの確認
- トラック 1(CLI 検証):
gcloudを使用して、すべての関連付けられたアスペクトを含むエントリを検査します。gcloud dataplex entries describe sop-manuals-fileset-lum8g8j \ --entry-group=dark-data-fileset-group \ --location=$REGION \ --view=ALL - トラック 2(コンソール UI の検査):
- Knowledge Catalog Search Console を開き、「LUM-LIG-DES-8G8J Unstructured SOP & Technical Manual Fileset」(
sop-manuals-fileset-lum8g8j)を検索し、結果から一致するエントリを選択します。 - [オプションのタグとアスペクト] で、[Dark Data Multimodal Extracted Metadata] と [Document Governance & Inventory Cross-Reference Aspect] の両方に、抽出された危険レベル(
MEDIUM)、コンプライアンス コード(UL-153, FCC Part 15, CE-LVD, RoHS)、相互参照テーブル文字列(lakehouse_cross_ref_table)が表示されていることを確認します。
- Knowledge Catalog Search Console を開き、「LUM-LIG-DES-8G8J Unstructured SOP & Technical Manual Fileset」(
8. カタログ内のガバナンス対象のダークデータをクエリする
カスタム アスペクトが関連付けられると、Cloud Storage 内の非構造化 PDF マニュアルが Knowledge Catalog 検索(catalog_client.search_entries())で検出可能になります。
step6_search_catalog.py で search_entries() をポーリングする
step6_search_catalog.py は、指数バックオフで search_entries() をポーリングし、.endswith() を介して正規化されたアスペクトキーを読み取ります。
search_query = f"entrygroup={entry_group_resource_name} name:{FILESET_ENTRY_ID}"

while elapsed_seconds < max_wait_seconds:
    catalog_search_results = list(
        catalog_client.search_entries(
            request=dataplex_v1.SearchEntriesRequest(
                name=parent_location,
                query=search_query,
            )
        )
    )
    if catalog_search_results:
        break
    backoff_seconds = min(5 * (2 ** attempt), 30)
    time.sleep(backoff_seconds)
    ...

for k, asp in detailed_entry.aspects.items():
    if k.endswith(f".{REGION}.{EXTRACTED_ASPECT_TYPE_ID}"):
        print(f"    Domain Ontology     : {asp.data.get('domain_ontology')}")
        print(f"    Hazard Level        : {asp.data.get('operational_hazard_level')}")
    elif k.endswith(f".{REGION}.{GOVERNANCE_ASPECT_TYPE_ID}"):
        print(f"    Compliance Codes    : {asp.data.get('compliance_classifications')}")
        print(f"    Lakehouse Join Table: {asp.data.get('lakehouse_cross_ref_table')}")
step6_search_catalog.py を実行します
python3 step6_search_catalog.py
Executing Knowledge Catalog search query:
  'entrygroup=projects/your-project-id/locations/us-central1/entryGroups/
  dark-data-fileset-group name:sop-manuals-fileset-lum8g8j'...

✓ Discovered 1 governed asset(s) in Knowledge Catalog:

[1] Entry Resource Name :
    projects/your-project-id/locations/us-central1/entryGroups/
    dark-data-fileset-group/entries/sop-manuals-fileset-lum8g8j
    Fully Qualified Name: gcs:your-project-id-dark-data-manuals
    Entry Type :
    projects/your-project-id/locations/us-central1/entryTypes/
    unstructured-pdf-fileset
    Physical Storage URI:
    gs://your-project-id-dark-data-manuals/sop-pdfs/LUM-LIG-DES-8G8J_manual.pdf
    Domain Ontology     : Electrical Hardware & Lighting Systems
    Hazard Level        : MEDIUM
    Compliance Codes    : UL-153 Portable Luminaires, FCC Part 15, CE-LVD, RoHS
    Lakehouse Join Table:
    lakehouse.your-project-id.retail_hardware.luminaire_sku_inventory_iceberg
デュアルトラックの確認
- トラック 1(CLI 検索):
gcloudを介して検索インデックスを直接クエリします。gcloud dataplex entries search "name:sop-manuals-fileset-lum8g8j" --project=$PROJECT_ID - トラック 2(コンソール UI の自然言語検索):
- Knowledge Catalog Search Console を開き、
LUM-LIG-DES-8G8JまたはUL-153を検索します。 - Knowledge Catalog が、ガバナンスが適用された Cloud Storage PDF ファイルセット エントリと、その添付メタデータ アスペクトを表示する方法を確認します。
- Knowledge Catalog Search Console を開き、
9. エンドツーエンドのガバナンス アサーションを検証する
step7_verify_assertions.py は、ライブ Knowledge Catalog コントロール プレーンのレスポンスに対して決定論的アサーションを実行し、EntryGroup、EntryType、両方のカスタム AspectType ブループリント、バインドされた EntryView.ALL アスペクト ペイロード(confidence_score バウンドと lakehouse_cross_ref_table 文字列)、検索インデックスの検出がすべて成功したことを確認します。
verify_eg = catalog_client.get_entry_group(name=entry_group_resource_name)
assert verify_eg.name == entry_group_resource_name, "EntryGroup resource name mismatch."

verify_entry = catalog_client.get_entry(
    request=dataplex_v1.GetEntryRequest(
        name=fileset_entry_name,
        view=dataplex_v1.EntryView.ALL,
    )
)
bound_extracted = next(
    (
        asp for k, asp in verify_entry.aspects.items()
        if k.endswith(f".{REGION}.{EXTRACTED_ASPECT_TYPE_ID}")
    ),
    None,
)
bound_governance = next(
    (
        asp for k, asp in verify_entry.aspects.items()
        if k.endswith(f".{REGION}.{GOVERNANCE_ASPECT_TYPE_ID}")
    ),
    None,
)

assert bound_extracted is not None, f"Aspect '{EXTRACTED_ASPECT_TYPE_ID}' not found on live Entry."
assert bound_governance is not None, (
    f"Aspect '{GOVERNANCE_ASPECT_TYPE_ID}' not found on live Entry."
)
assert (
    bound_extracted.data.get("document_title") == expected_extraction["document_title"]
), "Extracted title mismatch."
assert (
    0.0 <= float(bound_extracted.data.get("confidence_score", -1.0)) <= 1.0
), "Invalid confidence score in catalog."
assert (
    "lakehouse" in str(bound_governance.data.get("lakehouse_cross_ref_table", "")).lower()
), "Missing Lakehouse cross-reference."
...
assert len(search_results) >= 1, "Expected at least 1 search result in Knowledge Catalog."
step7_verify_assertions.py を実行します
python3 step7_verify_assertions.py && echo "Verification exit code: $?"
Running substantive end-to-end verification assertions...
✓ All 5 substantive verification assertions passed
  against live Google Cloud control plane state!
Verification exit code: 0
10. イベント ドリブン パイプラインを設計する
Cloud Shell で Python スクリプトをインタラクティブに実行することは、ガバナンス契約の構築とテストに最適ですが、エンタープライズ環境では、ERP、プロダクト ライフサイクル管理(PLM)、ベンダー ポータルから、毎日数千もの新規または改訂された PDF エンジニアリング マニュアル、サプライヤーのコンプライアンス証明書、SOP ドキュメントが届きます。バッチ スクリプトを手動で実行すると、ドキュメントのアップロードとカタログのインデックス登録の間にガバナンスの盲点が生じやすくなります。
本番環境では、プラットフォーム チームはステップ 4 とステップ 5 で実行したコードを、ゼロタッチのイベント ドリブン パイプラインとして運用します。
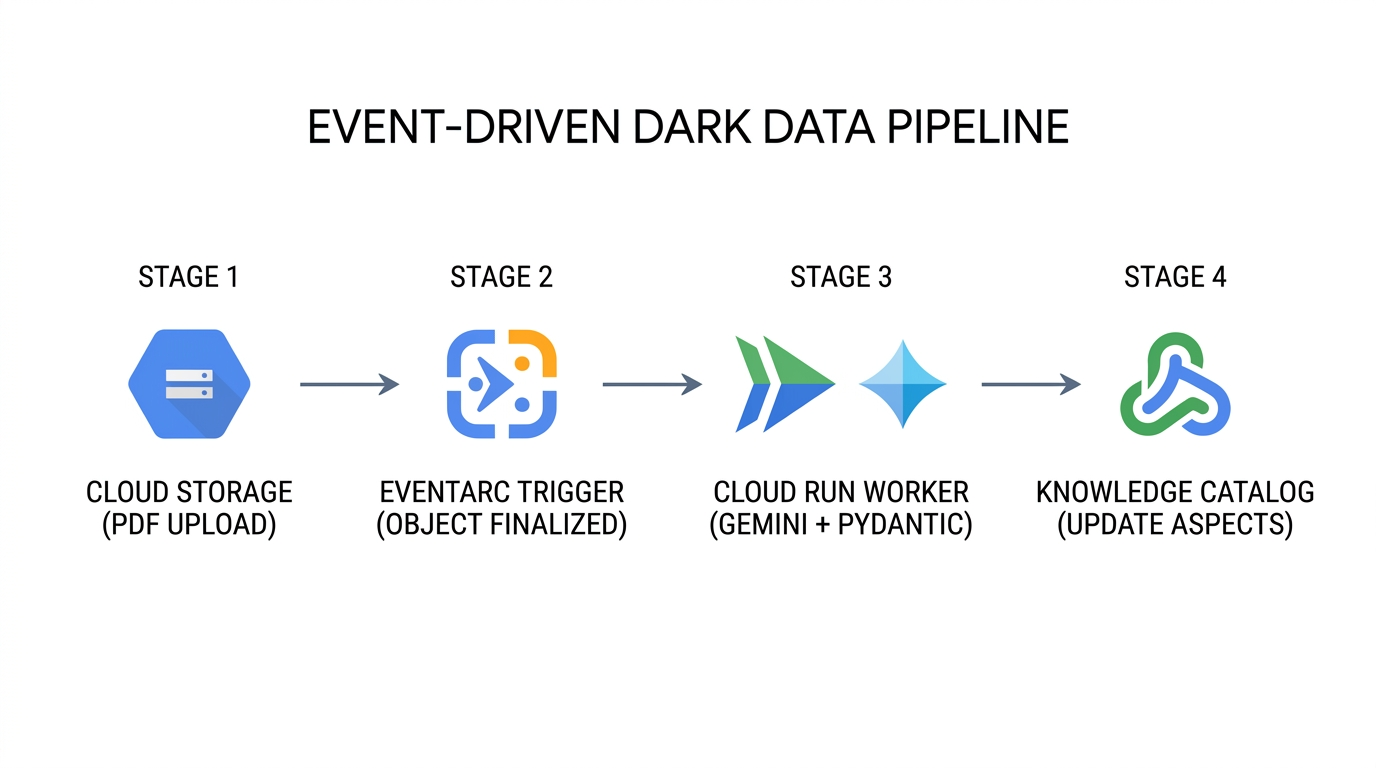
- 継続的なドキュメントの取り込み(
Cloud Storage→Eventarc): 新しい PDF マニュアルがアップロードされるたび、または新しいリビジョンが Cloud Storage の既存のオブジェクトを上書きするたびに、バケットはバケット ID、オブジェクト パス、オブジェクト世代番号を含むgoogle.cloud.storage.object.v1.finalizedCloudEvent を発行します。 - ステートレス マルチモーダル抽出(
Eventarc→Cloud Run→Gemini Enterprise Agent Platform): Eventarc は、CloudEvent をschemas.py、step4_extract_metadata.py、step5_attach_aspects.pyをパッケージ化するサーバーレス Cloud Run ワーカーに転送します。ワーカーは、response_schemaが適用された状態で PDF バイトを Gemini Enterprise Agent Platform にストリーミングします。これにより、抽出されたすべての属性がDarkDataExtractedMetadataとDocumentGovernanceMetadataに準拠することが保証されます。 - Surgical Control Plane Update(
Cloud Run→Knowledge Catalog): ワーカーは親 FilesetEntryを解決し、update_mask={"paths": ["aspects"]}と明示的なaspect_keysを使用してcatalog_client.update_entry()を実行します。数十件のドキュメントの処理が同時に完了した場合でも、各ミューテーションは指定されたアスペクトキーのみを更新します。 - 信頼度ゲート付きスチュワード隔離: スキャンされた以前の PDF から抽出された
confidence_scoreが運用しきい値(< 0.85など)を下回る場合、ワーカーは添付されたアスペクトにgovernance_status = "PENDING_STEWARD_REVIEW"を設定します。これにより、データ スチュワードは Knowledge Catalog に対して、人間によるレビューが必要な信頼度の低いアセットをクエリできます。
企業が本番環境でこのパターンを適用する方法
Enterprise のユースケース | Metadata-as-Code の実際の運用 | ビジネスと業務への影響 |
規制監査とリコール準備の自動化 | コンプライアンス システムは、非構造化 PDF の安全性に関する側面( |
|
グラウンディングされた AI エージェントと RAG 事前フィルタリング | Gemini Enterprise Agent Platform の検索拡張生成(RAG)エージェントは、フィールド エンジニアの質問に回答する前に、 | AI アシスタントが幻覚を見たり、廃止されたエンジニアリング ドラフト、期限切れの SOP、未確認のサードパーティ マニュアルを引用したりすることを防ぎます。 |
マルチチーム同時エンリッチメント | 複数の独立したパイプラインが同じ Fileset |
|
GitOps による CI/CD スキーマの進化 | プラットフォーム チームは、Terraform |
|
11. 環境をクリーンアップする
Knowledge Catalog では、子エントリが親コンテナとスキーマ テンプレートを参照している間は、親コンテナとスキーマ テンプレートを削除できません。cleanup.py は、厳密な逆依存関係の順序(Entry → EntryGroup → EntryType → AspectTypes → Cloud Storage バケット オブジェクト → 一時 JSON ファイル)でリソースを削除します。
# 1. Delete Fileset Entry first
catalog_client.delete_entry(name=target_entry_path)

# 2. Delete EntryGroup container
del_eg_op = catalog_client.delete_entry_group(name=target_eg_path)
if hasattr(del_eg_op, "result"):
    del_eg_op.result()

# 3. Delete EntryType and Custom AspectTypes
del_et_op = catalog_client.delete_entry_type(name=target_et_path)
if hasattr(del_et_op, "result"):
    del_et_op.result()
for aspect_id_val in (EXTRACTED_ASPECT_TYPE_ID, GOVERNANCE_ASPECT_TYPE_ID):
    target_at_path = f"{active_parent}/aspectTypes/{aspect_id_val}"
    del_at_op = catalog_client.delete_aspect_type(name=target_at_path)
    if hasattr(del_at_op, "result"):
        del_at_op.result()
cleanup.py を実行します
python3 cleanup.py
Starting reverse-dependency resource cleanup in Knowledge Catalog...
Deleted Fileset Entry:
  projects/your-project-id/locations/us-central1/entryGroups/
  dark-data-fileset-group/entries/sop-manuals-fileset-lum8g8j
Deleted EntryGroup   :
  projects/your-project-id/locations/us-central1/entryGroups/
  dark-data-fileset-group
Deleted EntryType    :
  projects/your-project-id/locations/us-central1/entryTypes/
  unstructured-pdf-fileset
Deleted AspectType   :
  projects/your-project-id/locations/us-central1/aspectTypes/
  dark-data-extracted-metadata
Deleted AspectType   :
  projects/your-project-id/locations/us-central1/aspectTypes/
  document-governance-aspect
Deleted Cloud Storage object :
  gs://your-project-id-dark-data-manuals/sop-pdfs/LUM-LIG-DES-8G8J_manual.pdf
Deleted Cloud Storage bucket : gs://your-project-id-dark-data-manuals
Removed local temporary file : extracted_metadata.json
Removed local temporary file : governance_metadata.json
✓ Standalone teardown complete. Environment cleanly reset.
クローンを作成したリポジトリ ディレクトリを削除する
cleanup.py によるクラウド リソースの削除が完了したら、ホーム ディレクトリに戻り、Cloud Shell からクローンされた devrel-demos リポジトリ フォルダを削除します。
cd ~
rm -rf ~/devrel-demos
12. 完了
Gemini Enterprise Agent Platform を使用して、Cloud Storage の非構造化 PDF を検出可能なスキーマ適用済みの Knowledge Catalog アセットに変換するエンドツーエンドの Metadata-as-Code ガバナンス パイプラインを構築して検証しました。
次のステップ
- Terraform で自動化する: CI/CD パイプラインで
google_dataplex_aspect_typeリソースとgoogle_dataplex_entry_groupリソースを宣言的に管理します。 - Eventarc + Cloud Run ワーカーをデプロイする:
step4_extract_metadata.pyとstep5_attach_aspects.pyをイベント ドリブンの Cloud Run サービスにコンテナ化します。 - BigQuery のダウンストリーム インベントリ結合: 抽出されたガバナンス メタデータ(
lakehouse_cross_ref_table)をエクスポートして、非構造化ドキュメントのコンプライアンス属性を構造化 SKU インベントリ テーブルと結合します。