

1. Wprowadzenie
Ponad 80% danych przedsiębiorstwa jest przechowywanych w formacie nieustrukturyzowanym – są to np. instrukcje obsługi w formacie PDF, standardowe procedury operacyjne, certyfikaty zgodności i schematy urządzeń przechowywane w Cloud Storage. Tradycyjne katalogi indeksują tylko schematy tabel relacyjnych, więc te dokumenty pozostają „ciemnymi danymi”: są niewidoczne dla wyszukiwania dla przedsiębiorstw, odłączone od tabel z danymi o asortymencie i niezweryfikowane pod kątem zgodności z przepisami.
Gdy audytor lub agent AI zada pytanie „Które numery SKU sprzętu wymagają certyfikatu bezpieczeństwa UL-153 i jakie są poziomy zagrożenia termicznego?”, katalog, który indeksuje tylko tabele SQL, nie będzie w stanie na nie odpowiedzieć. Fakty są zamknięte w nieuporządkowanych plikach PDF w Cloud Storage.
Rozwiązanie architektoniczne: metadane multimodalne jako kod
W tym ćwiczeniu utworzysz w Google Cloud kompleksowy potok Metadata-as-Code, który przekształca nieustrukturyzowane instrukcje PDF w Cloud Storage w zasoby Knowledge Catalog z wymuszonym schematem za pomocą Gemini Enterprise Agent Platform (pakiet SDK Google GenAI, google-genai):
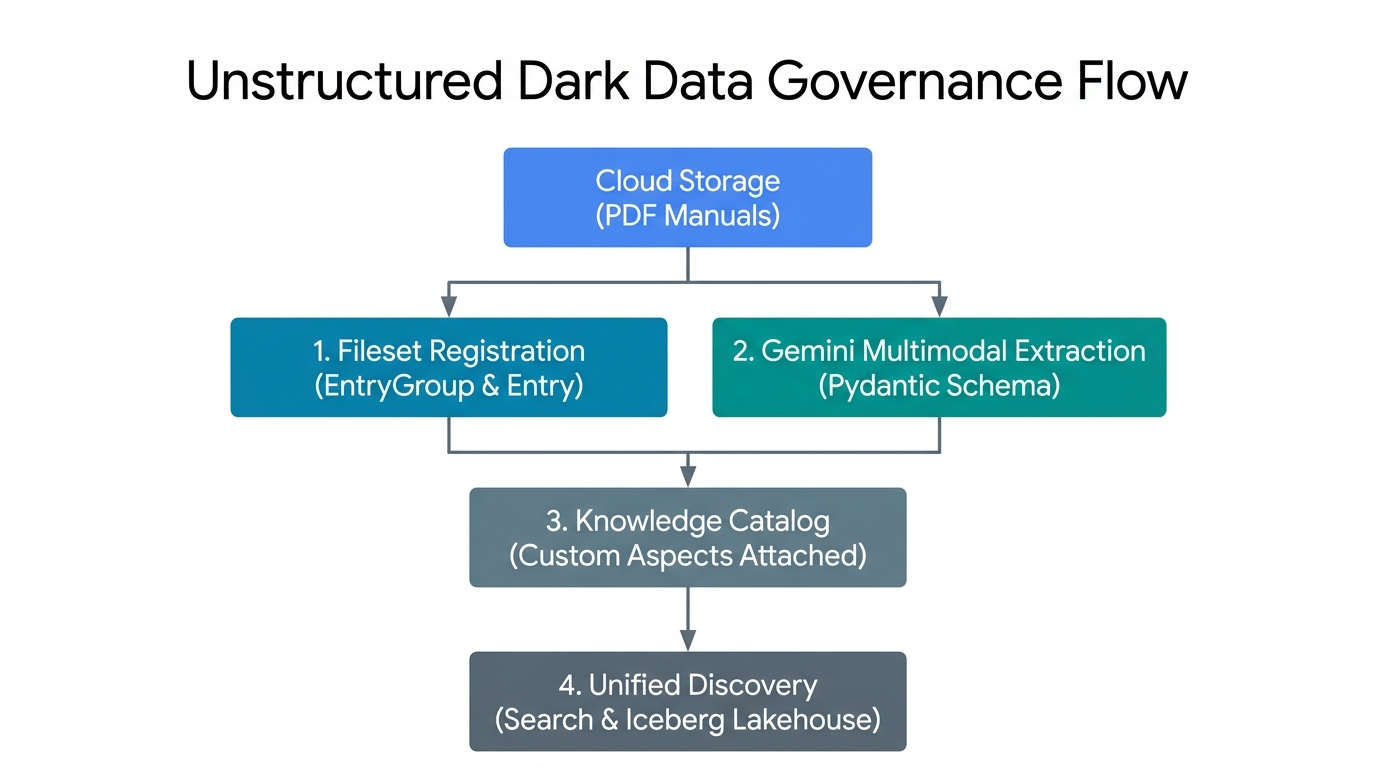
- Rejestracja zestawu plików (
EntryGroupiEntry): grupuje nieustrukturyzowane pliki PDF w Cloud Storage w zarządzane logiczne wpisy zestawu plików w Katalogu wiedzy. - Gemini Multimodal Extraction (Pydantic Schema): wywołuje Gemini Enterprise Agent Platform na surowych bajtach PDF z deterministyczną
response_schemaweryfikacją. - Powiązanie aspektu płaszczyzny sterowania: dołącza zweryfikowane ładunki JSON dotyczące operacji i zgodności jako silnie typizowane instancje
Aspectw pozycji katalogu. - Wykrywanie w ujednoliconym katalogu: umożliwia wykrywanie nieuporządkowanych zestawów plików PDF i wyodrębnionych z nich metadanych za pomocą
SearchEntriesRequest.
Kluczowe pojęcia: podstawowe elementy platformy sterującej Knowledge Catalog
Wyobraź sobie, że Twój zespół przechowuje setki instrukcji obsługi produktów w formacie PDF w Cloud Storage. Aby ułatwić znajdowanie tych plików i sprawdzanie ich w Knowledge Catalog, pomyśl o 5 elementach składowych jak o porządkowaniu papierowych instrukcji w szafie biurowej:
EntryGroup(Zamykana szafka dla jednego zespołu): szafka z zamkiem. Tylko członkowie zespołu z uprawnieniami (roles/dataplex.entryCreator) mogą umieszczać w nim foldery. Zanim usuniesz szafę, musisz opróżnić wszystkie foldery.EntryType(Etykieta kategorii folderu): etykieta, która informuje użytkowników, jaki rodzaj komponentu reprezentuje folder, np. „Kolekcja instrukcji w formacie PDF” zamiast „Tabela bazy danych”.Entry(Folder z linkiem do pamięci): folder katalogu z instrukcjami w formacie PDF. Zamiast ciężkich papierowych kopii folder zawiera kartę lokalizacji wskazującą dokładny zasobnik Cloud Storage (gs://...), w którym znajdują się prawdziwe pliki PDF.AspectType(Pusty formularz listy kontrolnej): pusty formularz wielokrotnego użytku z wstępnie wydrukowanymi polami (np. „Lista kontrolna bezpieczeństwa” z prośbą o podanieoperational_hazard_levelw formie tekstu iconfidence_scorew formie liczby z zakresu od0.0do1.0). Ten pusty formularz tworzysz raz i używasz go w tysiącach folderów.Aspect(Wypełniona lista kontrolna dołączona do folderu): po tym, jak Gemini Enterprise Agent Platform odczyta instrukcję w formacie PDF i wypełni puste pola, wypełniona lista kontrolna zostanie przypięta do folderuEntry. Każda lista kontrolna ma własny klucz (aspect_keys), więc zespół inżynierów i zespół prawny mogą dołączyć własne listy kontrolne do tego samego folderu bez zastępowania pracy innych osób.
Wszystkie 5 zasobów regionalnych znajduje się w domenie projects/{project}/locations/{location}/:
Ścieżka podstawowa i względna | Rola w Knowledge Catalog | Reguła usuwania i reguła uprawnień |
| Kontener logiczny, który grupuje wpisy i kontroluje dostęp zespołu ( | Przed usunięciem nie może zawierać żadnych zasobów podrzędnych |
| Definicja kategorii dla klasy zasobów ( | Usuń go dopiero po usunięciu wszystkich wpisów korzystających z tego typu. |
| Rekord katalogu łączący fizyczny identyfikator URI Cloud Storage ( | Znajduje się w |
| Szablon schematu wielokrotnego użytku definiujący typowane | Utworzone raz na region i udostępniane w ramach wszystkich zgłoszeń. |
| Zweryfikowane metadane JSON pasujące do | Aktualizacje są przeprowadzane za pomocą funkcji |
Co utworzysz
Za pomocą skryptów towarzyszących w codelabs/metadata-as-code-lab uruchomisz i sprawdzisz 7-etapowy potok:
schemas.py– 2 schematy PydanticBaseModel(DarkDataExtractedMetadataiDocumentGovernanceMetadata) sparowane 1:1 z szablonamiAspectTypeKnowledge Catalog.step2_provision.py– idempotentne udostępnianie niestandardowych planówEntryGroup,EntryTypeiAspectType.step3_register_fileset.py– przesłanieLUM-LIG-DES-8G8J_manual.pdfdo Cloud Storage i zarejestrowanie go jako zarządzanego zbioru plikówEntry.step4_extract_metadata.py– dynamiczne wykrywanie flagowego modelu Gemini i multimodalne wyodrębnianie danych z plików PDF za pomocągoogle-genai.step5_attach_aspects.py,step6_search_catalog.pyistep7_verify_assertions.py– przyłącze aspektu chirurgicznego, wyszukiwanie w katalogu z wzrastającym czasem do ponowienia i potwierdzenia w platformie sterującej typu end-to-end.
Wymagania wstępne i potrzebne elementy
- Projekt Google Cloud z włączonym rozliczeniem i Google Cloud Shell (z wstępnie zainstalowanymi narzędziami
gcloud,git,python3ipip). - Uprawnienia IAM do zarządzania zasobami Knowledge Catalog (
roles/dataplex.admin), udostępniania zasobników i obiektów Cloud Storage (roles/storage.admin) oraz wywoływania Gemini Enterprise Agent Platform (roles/aiplatform.user). - przeglądarka internetowa, np. Google Chrome;
2. Konfiguracja i wymagania
Klonowanie repozytorium towarzyszącego w Cloud Shell
Otwórz konsolę Google Cloud, uruchom Cloud Shell i wykonaj rzadkie wyewidencjonowanie codelabs/metadata-as-code-lab, które obejmuje przykładowy podręcznik inżynierski w formacie PDF (LUM-LIG-DES-8G8J_manual.pdf) i wszystkie skrypty w Pythonie:
git clone --branch main --depth 1 --filter=blob:none --sparse \
  https://github.com/GoogleCloudPlatform/devrel-demos.git
cd devrel-demos
git sparse-checkout set codelabs/metadata-as-code-lab
cd codelabs/metadata-as-code-lab
ls -la
Konfigurowanie zmiennych środowiskowych
Ustaw identyfikator projektu, lokalizację regionalnej platformy sterującej i docelowy zasobnik Cloud Storage w Cloud Shell:
export PROJECT_ID="${PROJECT_ID:-$(gcloud config get-value project)}"
gcloud config set project $PROJECT_ID

export REGION="us-central1"
export BUCKET_NAME="${PROJECT_ID}-dark-data-manuals"
export GEMINI_LOCATION="global"

echo "Configured Project ID        : $PROJECT_ID"
echo "Knowledge Catalog Region     : $REGION"
echo "Gemini Endpoint Location     : $GEMINI_LOCATION"
echo "Target Cloud Storage Bucket  : $BUCKET_NAME"
Włączanie interfejsów API i instalowanie zależności
Włącz wymagane interfejsy Google Cloud API i zainstaluj zależności Pythona (google-genai, google-cloud-dataplex, pydantic i pandas) z requirements.txt:
gcloud services enable \
  dataplex.googleapis.com \
  storage.googleapis.com \
  aiplatform.googleapis.com \
  --quiet
python3 -m pip install --upgrade --quiet --user --break-system-packages -r requirements.txt
3. Definiowanie schematów Pydantic i szablonów aspektów
schemas.py definiuje 2 uzupełniające się kontrakty, które łączą walidację Pydantic po stronie klienta z szablonami Knowledge Catalog po stronie serwera:AspectType
DarkDataExtractedMetadata: atrybuty operacyjne wyodrębnione z pliku PDF (tytuł dokumentu, ontologia domeny, poziom zagrożenia, pochodzenie autora lub wersji, podsumowanie i poziom ufności wyodrębniania).DocumentGovernanceMetadata: kody zgodności z przepisami (UL-153, FCC Part 15, CE-LVD, RoHS), właściciel zarządzania produktem, zasady przechowywania i ciąg znaków identyfikatora tabeli referencyjnej (lakehouse_cross_ref_table) do łączenia instrukcji w formacie PDF z tabelami danych o produktach.
Sprawdź schemas.py
Po pierwsze, DarkDataExtractedMetadata używa ograniczeń Field Pydantic (ge=0.0, le=1.0, czyli większe/mniejsze lub równe, na confidence_score), aby ograniczyć dane wyjściowe JSON platformy Gemini Enterprise Agent Platform:
class DarkDataExtractedMetadata(BaseModel):
    document_title: str = Field(
        description="Official document title or product model name extracted from the PDF manual."
    )
    # ... domain_ontology, operational_hazard_level, author_provenance ...
    version_provenance: str = Field(
        description="Document version, revision code, or publication standard identifier."
    )
    # ... document_summary ...
    confidence_score: float = Field(
        ge=0.0,
        le=1.0,
        description="AI extraction confidence metric between 0.0 and 1.0.",
    )
Po drugie, extracted_aspect_template odzwierciedla te same nazwy pól i mapuje typy str i float w Pythonie na typy string i double record_fields w Knowledge Catalog. Pamiętaj, że kontrakt protobuf AspectType.MetadataTemplate wymaga, aby każde pole w record_fields deklarowało unikalną, ściśle dodatnią liczbę całkowitą zaczynającą się od 1 index (od 1 do 7). Pominięcie lub zduplikowanie index spowoduje, że create_aspect_type zakończy się niepowodzeniem z błędem 400 INVALID_ARGUMENT:
extracted_aspect_template = {
    "name": "DarkDataExtractedMetadata",
    "type": "record",
    "record_fields": [
        {
            "name": "document_title",
            "type": "string",
            "index": 1,
            "annotations": {"description": "Official document title or product model name."},
        },
        # ... fields 2 through 6 (string) ...
        {
            "name": "confidence_score",
            "type": "double",
            "index": 7,
            # ... annotations ...
        },
    ],
}
Weryfikacja modułu schematu
Uruchom schemas.py, aby sprawdzić konfigurację środowiska i skompilować oba schematy:
python3 schemas.py
Configured Project ID         : your-project-id
Knowledge Catalog Region      : us-central1
Gemini Endpoint Location      : global
Governed Fileset Storage URI  :
  gs://your-project-id-dark-data-manuals/sop-pdfs/LUM-LIG-DES-8G8J_manual.pdf
Target Fileset Entry ID       : sop-manuals-fileset-lum8g8j
✓ Defined DarkDataExtractedMetadata and DocumentGovernanceMetadata
  Pydantic schemas.
✓ Prepared Knowledge Catalog AspectType metadata templates.
4. Tworzenie przestrzeni nazw i niestandardowych typów aspektów
Przed zarejestrowaniem wpisów zbioru plików lub dołączeniem metadanych usługa step2_provision.py udostępnia 3 zasoby platformy sterującej w Knowledge Catalog:
EntryGroup:dark-data-fileset-groupEntryType:unstructured-pdf-filesetAspectTypePlany:dark-data-extracted-metadataidocument-governance-aspect
Idempotentna obsługa administracyjna w usłudze step2_provision.py
Każde wywołanie tworzenia w step2_provision.py otacza długo trwającą operację (op.result()) blokiem try / except AlreadyExists, dzięki czemu skrypt można bezpiecznie uruchamiać ponownie bez niepowodzenia w przypadku istniejących zasobów:
# Provision AspectType 1: dark-data-extracted-metadata
try:
    at1_op = catalog_client.create_aspect_type(
        parent=parent_location,
        aspect_type_id=EXTRACTED_ASPECT_TYPE_ID,
        aspect_type=AspectType(
            name=extracted_aspect_type_name,
            display_name="Dark Data Multimodal Extracted Metadata",
            # ... description ...
            metadata_template=extracted_aspect_template,
        ),
    )
    if hasattr(at1_op, "result"):
        at1_op.result()
    print(f"Created AspectType: {extracted_aspect_type_name}")
except AlreadyExists:
    print(f"AspectType already exists; retrieving live resource: {extracted_aspect_type_name}")

live_extracted_aspect_type = catalog_client.get_aspect_type(name=extracted_aspect_type_name)
Po zarejestrowaniu metadata_template=extracted_aspect_template Knowledge Catalog wymusza schemat na granicy interfejsu API – każde kolejne wywołanie update_entry(), które przekazuje ciąg znaków do confidence_score (double), jest odrzucane.
Uruchom step2_provision.py
Uruchom skrypt udostępniania i sprawdź, czy niestandardowe typy aspektów są zarejestrowane w Twoim regionie:
python3 step2_provision.py
gcloud dataplex aspect-types list --location=$REGION
Created EntryGroup:
  projects/your-project-id/locations/us-central1/entryGroups/
  dark-data-fileset-group
Created EntryType :
  projects/your-project-id/locations/us-central1/entryTypes/
  unstructured-pdf-fileset
Created AspectType:
  projects/your-project-id/locations/us-central1/aspectTypes/
  dark-data-extracted-metadata
Created AspectType:
  projects/your-project-id/locations/us-central1/aspectTypes/
  document-governance-aspect
✓ All Knowledge Catalog namespaces and AspectType blueprints are active.
5. Rejestrowanie wpisów nieuporządkowanego zbioru plików
Zamiast zaśmiecać katalog milionami odseparowanych wskaźników plików, Knowledge Catalog grupuje powiązane dokumenty w Cloud Storage (gs://YOUR_BUCKET/sop-pdfs/*.pdf) w logiczne wpisy zestawu plików – za pomocą automatycznych skanów wykrywania (DataScanServiceClient) lub bezpośredniej rejestracji programowej (CatalogServiceClient.create_entry).
Jak step3_register_fileset.py mapuje pamięć masową na katalog
step3_register_fileset.py przesyła LUM-LIG-DES-8G8J_manual.pdf do gs://${BUCKET_NAME}/sop-pdfs/LUM-LIG-DES-8G8J_manual.pdf i rejestruje zarządzane Entry:
fully_qualified_fileset_uri = f"gcs:{BUCKET_NAME}"
fileset_entry_spec = Entry(
    name=fileset_entry_name,
    entry_type=entry_type_resource_name,
    fully_qualified_name=fully_qualified_fileset_uri,
    entry_source=EntrySource(
        resource=VIRTUAL_STORAGE_URI,
        system="Cloud Storage",
        platform="Google Cloud",
        display_name="LUM-LIG-DES-8G8J Unstructured SOP & Technical Manual Fileset",
        # ... description ...
        location=REGION,
    ),
)

create_entry_op = catalog_client.create_entry(
    parent=entry_group_resource_name,
    entry_id=FILESET_ENTRY_ID,
    entry=fileset_entry_spec,
)
Zwróć uwagę na różne role 2 pól identyfikatora URI na stronie Entry:
fully_qualified_name=fully_qualified_fileset_uri(f"gcs:{BUCKET_NAME}"): używa kanonicznego schematugcs:{bucket_name}pełnej i jednoznacznej nazwy wymaganej przez Knowledge Catalog do powiązania logicznego wpisu katalogu z bazowym zasobnikiem Cloud Storage.entry_source.resource=VIRTUAL_STORAGE_URI: przechowuje fizyczny identyfikator URI obiektugs://sprawdzany przez podrzędne procesy wyodrębniania.
Uruchom step3_register_fileset.py
python3 step3_register_fileset.py
Created Cloud Storage bucket:
  gs://your-project-id-dark-data-manuals in us-central1
Uploaded unstructured PDF manual to:
  gs://your-project-id-dark-data-manuals/sop-pdfs/LUM-LIG-DES-8G8J_manual.pdf
Registered governed Fileset Entry:
  projects/your-project-id/locations/us-central1/entryGroups/
  dark-data-fileset-group/entries/sop-manuals-fileset-lum8g8j
  -> Fully Qualified Name : gcs:your-project-id-dark-data-manuals
  -> Physical Resource URI:
  gs://your-project-id-dark-data-manuals/sop-pdfs/LUM-LIG-DES-8G8J_manual.pdf
  -> Source System        : Cloud Storage
6. Wyodrębnianie metadanych dokumentu za pomocą Gemini
step4_extract_metadata.py odczytuje surowe bajty pliku PDF i wywołuje Gemini Enterprise Agent Platform (genai_client.models.generate_content) za pomocą 2 kluczowych wzorców:
1. Dynamiczne wykrywanie flagowego modelu
Zamiast na stałe kodować niepewne ciągi znaków wersji modelu, skrypt wysyła zapytanie do genai_client.models.list() i sortuje aktywne kandydatury według (is_ga_channel, semantic_version_tuple), aby wybrać najnowszy model flash ogólnodostępny:
genai_client = genai.Client(
    vertexai=True,
    project=PROJECT_ID,
    location=GEMINI_LOCATION,
)

for model_obj in genai_client.models.list():
    raw_id = (model_obj.name or "").split("/")[-1]
    # Filter to flagship Gemini Flash models (version >= 3.0) and prioritize GA over preview
    ...
    discovered_candidates.append((is_ga_channel, ver_tuple, raw_id))

discovered_candidates.sort(key=lambda item: (item[0], item[1]), reverse=True)
2. Wielomodalne wyodrębnianie z ograniczeniami schematu (Part.from_bytes + response_schema)
Przekazanie response_mime_type="application/json" i response_schema=DarkDataExtractedMetadata (po którym następuje DocumentGovernanceMetadata) ogranicza dekodowanie tokena bezpośrednio do schematu JSON Pydantic:
with open(LOCAL_PDF_PATH, "rb") as pdf_file:
    raw_pdf_bytes = pdf_file.read()

extraction_response = genai_client.models.generate_content(
    model=candidate_model,
    contents=[
        types.Part.from_bytes(data=raw_pdf_bytes, mime_type="application/pdf"),
        extraction_prompt,
    ],
    config=types.GenerateContentConfig(
        response_mime_type="application/json",
        response_schema=DarkDataExtractedMetadata,
        temperature=0.1,
    ),
)

extracted_dark_data = json.loads(extraction_response.text)
validated_extraction = DarkDataExtractedMetadata(**extracted_dark_data)
Uruchom step4_extract_metadata.py
python3 step4_extract_metadata.py
Dynamically discovered active GA model currency :
  gemini-3.8-flash (version (3, 8))
Loaded unstructured PDF manual at: LUM-LIG-DES-8G8J_manual.pdf
Read unstructured PDF document (1184 bytes).
  Executing multimodal extraction with gemini-3.8-flash...
✓ Multimodal extraction completed using model: gemini-3.8-flash
✓ Governance classification completed using model: gemini-3.8-flash

--- Extracted Multimodal Operational Metadata ---
Extracted Attribute    Multimodal Value
document_title    LUM-LIG-DES-8G8J Contemporary Linen Desk Lamp
domain_ontology    Electrical Hardware & Lighting Systems
operational_hazard_level    MEDIUM
author_provenance    Global Hardware Safety & Lighting Systems Engin
version_provenance    Rev 4.2
document_summary    This document outlines standard operating proce
confidence_score    0.99

--- Extracted Governance & Inventory Cross-Reference Metadata ---
Governance Attribute    Classification Value
compliance_classifications    UL-153 Portable Luminaires, FCC Part 15, CE-LVD
stewardship_owner    Global Hardware Safety & Lighting Systems Engin
retention_policy    10-Year Active Product Lifecycle Archival
lakehouse_cross_ref_table    lakehouse.your-project-id.retail_hardware
governance_status    VERIFIED_PRODUCTION
7. Dołączanie zweryfikowanych aspektów do wpisów w katalogu
step5_attach_aspects.py wiąże zweryfikowane ładunki JSON (extracted_metadata.json i governance_metadata.json) z wpisem sop-manuals-fileset-lum8g8j za pomocą catalog_client.update_entry().
Zmiana aspektu chirurgicznego w step5_attach_aspects.py
extracted_aspect_key = f"{PROJECT_ID}.{REGION}.{EXTRACTED_ASPECT_TYPE_ID}"
governance_aspect_key = f"{PROJECT_ID}.{REGION}.{GOVERNANCE_ASPECT_TYPE_ID}"

updated_entry_payload = Entry(
    name=fileset_entry_name,
    entry_type=entry_type_resource_name,
    fully_qualified_name=fully_qualified_fileset_uri,
    aspects={
        extracted_aspect_key: Aspect(
            aspect_type=extracted_aspect_type_name,
            data=extracted_data,
        ),
        governance_aspect_key: Aspect(
            aspect_type=governance_aspect_type_name,
            data=governance_data,
        ),
    },
)

update_op = catalog_client.update_entry(
    request=dataplex_v1.UpdateEntryRequest(
        entry=updated_entry_payload,
        update_mask={"paths": ["aspects"]},
        aspect_keys=[extracted_aspect_key, governance_aspect_key],
    )
)
Przekazanie obu zakresów update_mask={"paths": ["aspects"]} i aspect_keys=[extracted_aspect_key, governance_aspect_key] ogranicza modyfikację wyłącznie do tych 2 kluczy aspektów, pozostawiając entry_source i wszystkie aspekty należące do innych zespołów bez zmian.
Uruchom step5_attach_aspects.py
python3 step5_attach_aspects.py
Successfully bound 2 Aspect(s) to Entry:
  projects/your-project-id/locations/us-central1/entryGroups/
  dark-data-fileset-group/entries/sop-manuals-fileset-lum8g8j

=== Live Attached Aspect: document-governance-aspect ===
Catalog Field    Authoritative Stored Value
compliance_classifications    UL-153 Portable Luminaires, FCC Part 15, CE-LVD
stewardship_owner    Global Hardware Safety & Lighting Systems Engin
retention_policy    10-Year Active Product Lifecycle Archival
lakehouse_cross_ref_table    lakehouse.your-project-id.retail_hardware
governance_status    VERIFIED_PRODUCTION

=== Live Attached Aspect: dark-data-extracted-metadata ===
Catalog Field    Authoritative Stored Value
document_title    LUM-LIG-DES-8G8J Contemporary Linen Desk Lamp
domain_ontology    Electrical Hardware & Lighting Systems
operational_hazard_level    MEDIUM
author_provenance    Global Hardware Safety & Lighting Systems Engin
version_provenance    Rev 4.2
document_summary    This document outlines standard operating proce
confidence_score    0.99
Weryfikacja dwutorowa
- Ścieżka 1 (weryfikacja za pomocą interfejsu wiersza poleceń): sprawdź wpis ze wszystkimi dołączonymi aspektami za pomocą
gcloud:gcloud dataplex entries describe sop-manuals-fileset-lum8g8j \ --entry-group=dark-data-fileset-group \ --location=$REGION \ --view=ALL - Ścieżka 2 (sprawdzanie interfejsu Konsoli):
- Otwórz Knowledge Catalog Search Console, wyszukaj LUM-LIG-DES-8G8J Unstructured SOP & Technical Manual Fileset (
sop-manuals-fileset-lum8g8j) i wybierz pasujący wpis z wyników. - W sekcji Opcjonalne tagi i aspekty sprawdź, czy w przypadku tagów Dark Data Multimodal Extracted Metadata i Document Governance & Inventory Cross-Reference Aspect wyświetla się wyodrębniony poziom zagrożenia (
MEDIUM), kody zgodności (UL-153, FCC Part 15, CE-LVD, RoHS) i ciąg tabeli odniesień (lakehouse_cross_ref_table).
- Otwórz Knowledge Catalog Search Console, wyszukaj LUM-LIG-DES-8G8J Unstructured SOP & Technical Manual Fileset (
8. Wysyłanie zapytań o zarządzane dane niejawne w katalogu
Po dołączeniu aspektów niestandardowych nieustrukturyzowane instrukcje PDF w Cloud Storage stają się wykrywalne w wyszukiwarce Knowledge Catalog (catalog_client.search_entries()).
Ankieta search_entries() za step6_search_catalog.py
step6_search_catalog.py wysyła zapytania do search_entries() ze wzrastającym czasem do ponowienia i odczytuje kanoniczne klucze aspektów za pomocą .endswith():
search_query = f"entrygroup={entry_group_resource_name} name:{FILESET_ENTRY_ID}"

while elapsed_seconds < max_wait_seconds:
    catalog_search_results = list(
        catalog_client.search_entries(
            request=dataplex_v1.SearchEntriesRequest(
                name=parent_location,
                query=search_query,
            )
        )
    )
    if catalog_search_results:
        break
    backoff_seconds = min(5 * (2 ** attempt), 30)
    time.sleep(backoff_seconds)
    ...

for k, asp in detailed_entry.aspects.items():
    if k.endswith(f".{REGION}.{EXTRACTED_ASPECT_TYPE_ID}"):
        print(f"    Domain Ontology     : {asp.data.get('domain_ontology')}")
        print(f"    Hazard Level        : {asp.data.get('operational_hazard_level')}")
    elif k.endswith(f".{REGION}.{GOVERNANCE_ASPECT_TYPE_ID}"):
        print(f"    Compliance Codes    : {asp.data.get('compliance_classifications')}")
        print(f"    Lakehouse Join Table: {asp.data.get('lakehouse_cross_ref_table')}")
Uruchom step6_search_catalog.py
python3 step6_search_catalog.py
Executing Knowledge Catalog search query:
  'entrygroup=projects/your-project-id/locations/us-central1/entryGroups/
  dark-data-fileset-group name:sop-manuals-fileset-lum8g8j'...

✓ Discovered 1 governed asset(s) in Knowledge Catalog:

[1] Entry Resource Name :
    projects/your-project-id/locations/us-central1/entryGroups/
    dark-data-fileset-group/entries/sop-manuals-fileset-lum8g8j
    Fully Qualified Name: gcs:your-project-id-dark-data-manuals
    Entry Type :
    projects/your-project-id/locations/us-central1/entryTypes/
    unstructured-pdf-fileset
    Physical Storage URI:
    gs://your-project-id-dark-data-manuals/sop-pdfs/LUM-LIG-DES-8G8J_manual.pdf
    Domain Ontology     : Electrical Hardware & Lighting Systems
    Hazard Level        : MEDIUM
    Compliance Codes    : UL-153 Portable Luminaires, FCC Part 15, CE-LVD, RoHS
    Lakehouse Join Table:
    lakehouse.your-project-id.retail_hardware.luminaire_sku_inventory_iceberg
Weryfikacja dwutorowa
- Ścieżka 1 (wyszukiwanie w interfejsie wiersza poleceń): wysyłaj zapytania do indeksu wyszukiwania bezpośrednio za pomocą
gcloud:gcloud dataplex entries search "name:sop-manuals-fileset-lum8g8j" --project=$PROJECT_ID - Ścieżka 2 (wyszukiwanie w języku naturalnym w interfejsie konsoli):
- Otwórz Search Console Knowledge Catalog i wyszukaj
LUM-LIG-DES-8G8JlubUL-153. - Zobacz, jak Knowledge Catalog wyświetla zarządzany wpis zbioru plików PDF Cloud Storage i jego dołączone aspekty metadanych.
- Otwórz Search Console Knowledge Catalog i wyszukaj
9. Weryfikowanie asercji dotyczących zarządzania kompleksowego
step7_verify_assertions.py wykonuje deterministyczne asercje na podstawie odpowiedzi z płaszczyzny sterowania Knowledge Catalog, aby sprawdzić, czy EntryGroup, EntryType, oba niestandardowe schematy AspectType, powiązane ładunki aspektów EntryView.ALL (confidence_score zakresy i lakehouse_cross_ref_table ciągi znaków) oraz wykrywanie indeksu wyszukiwania działają prawidłowo:
verify_eg = catalog_client.get_entry_group(name=entry_group_resource_name)
assert verify_eg.name == entry_group_resource_name, "EntryGroup resource name mismatch."

verify_entry = catalog_client.get_entry(
    request=dataplex_v1.GetEntryRequest(
        name=fileset_entry_name,
        view=dataplex_v1.EntryView.ALL,
    )
)
bound_extracted = next(
    (
        asp for k, asp in verify_entry.aspects.items()
        if k.endswith(f".{REGION}.{EXTRACTED_ASPECT_TYPE_ID}")
    ),
    None,
)
bound_governance = next(
    (
        asp for k, asp in verify_entry.aspects.items()
        if k.endswith(f".{REGION}.{GOVERNANCE_ASPECT_TYPE_ID}")
    ),
    None,
)

assert bound_extracted is not None, f"Aspect '{EXTRACTED_ASPECT_TYPE_ID}' not found on live Entry."
assert bound_governance is not None, (
    f"Aspect '{GOVERNANCE_ASPECT_TYPE_ID}' not found on live Entry."
)
assert (
    bound_extracted.data.get("document_title") == expected_extraction["document_title"]
), "Extracted title mismatch."
assert (
    0.0 <= float(bound_extracted.data.get("confidence_score", -1.0)) <= 1.0
), "Invalid confidence score in catalog."
assert (
    "lakehouse" in str(bound_governance.data.get("lakehouse_cross_ref_table", "")).lower()
), "Missing Lakehouse cross-reference."
...
assert len(search_results) >= 1, "Expected at least 1 search result in Knowledge Catalog."
Uruchom step7_verify_assertions.py
python3 step7_verify_assertions.py && echo "Verification exit code: $?"
Running substantive end-to-end verification assertions...
✓ All 5 substantive verification assertions passed
  against live Google Cloud control plane state!
Verification exit code: 0
10. Projektowanie potoku opartego na zdarzeniach
Interaktywne uruchamianie skryptów w Pythonie w Cloud Shell jest idealne do tworzenia i testowania umów dotyczących zarządzania, ale w środowiskach przedsiębiorstw codziennie pojawiają się tysiące nowych lub zmienionych instrukcji technicznych w formacie PDF, certyfikatów zgodności dostawców i dokumentów SOP z systemów ERP, PLM i portali dostawców. Ręczne uruchamianie skryptów wsadowych szybko tworzy luki w nadzorze między przesyłaniem dokumentów a indeksowaniem katalogu.
W środowisku produkcyjnym zespoły platformy wdrażają kod, który został uruchomiony w krokach 4 i 5, jako bezobsługowy potok oparty na zdarzeniach:
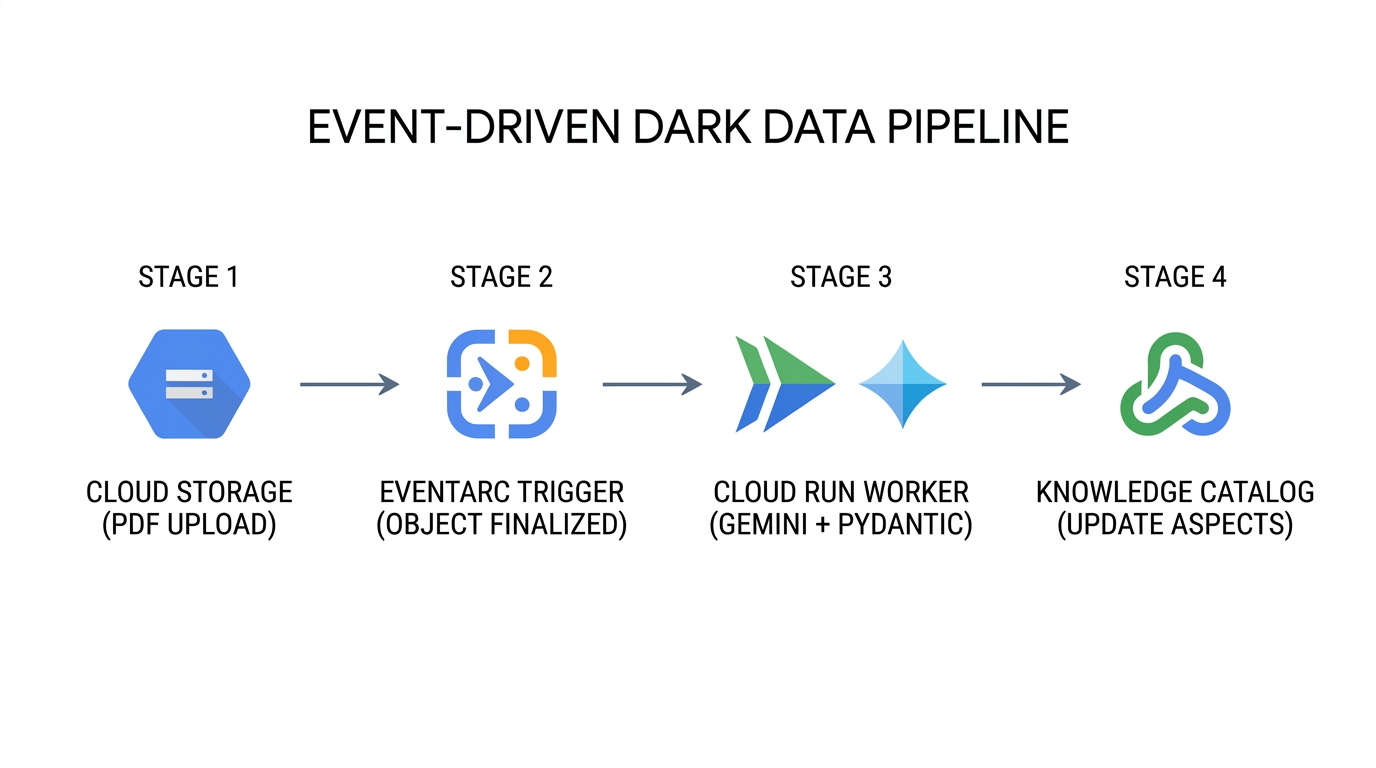
- Ciągłe wczytywanie dokumentów (
Cloud Storage→Eventarc): gdy nowy podręcznik w formacie PDF zostanie przesłany lub nowa wersja zastąpi istniejący obiekt w Cloud Storage, zasobnik wyemitujegoogle.cloud.storage.object.v1.finalizedCloudEvent zawierający identyfikator zasobnika, ścieżkę obiektu i numer generacji obiektu. - Stateless Multimodal Extraction (
Eventarc→Cloud Run→Gemini Enterprise Agent Platform): Eventarc kieruje CloudEvent do bezserwerowego procesu Cloud Run, który zawieraschemas.py,step4_extract_metadata.pyistep5_attach_aspects.py. Proces roboczy przesyła strumieniowo bajty PDF do platformy agentowej Gemini Enterprise zresponse_schema, co gwarantuje, że każdy wyodrębniony atrybut jest zgodny zDarkDataExtractedMetadataiDocumentGovernanceMetadata. - Aktualizacja platformy sterującej operacji (
Cloud Run→Knowledge Catalog): proces roboczy rozwiązuje nadrzędny zestaw plikówEntryi wykonujecatalog_client.update_entry()zupdate_mask={"paths": ["aspects"]}i jawnymaspect_keys. Nawet jeśli dziesiątki dokumentów zakończą przetwarzanie w tym samym czasie, każda modyfikacja zaktualizuje tylko wyznaczone klucze aspektów. - Kwarantanna nadzorowana na podstawie poziomu ufności: jeśli zeskanowany starszy plik PDF wygeneruje wyodrębnianie
confidence_scoreponiżej progu operacyjnego (np.< 0.85), pracownik ustawi wartośćgovernance_status = "PENDING_STEWARD_REVIEW"w powiązanym aspekcie, aby administratorzy danych mogli wysyłać zapytania do Knowledge Catalog dotyczące zasobów o niskim poziomie ufności, które wymagają sprawdzenia przez człowieka.
Jak przedsiębiorstwa stosują ten wzorzec w środowisku produkcyjnym
Przypadek użycia w firmie | Jak w praktyce działa podejście Metadane jako kod | Wpływ na działalność i operacje |
Automatyczne audyty zgodności z przepisami i gotowość do wycofania | Systemy zgodności łączą nieustrukturyzowane aspekty bezpieczeństwa plików PDF ( | Gdy standard, np. |
Agenty AI oparte na wiedzy i wstępne filtrowanie RAG | Zanim agent generowania wspomaganego wyszukiwaniem (RAG) na Gemini Enterprise Agent Platform odpowie na pytanie inżyniera terenowego, filtruje wpisy Knowledge Catalog według | Zapobiega halucynacjom asystentów AI i cytowaniu przez nich wycofanych projektów technicznych, nieaktualnych standardowych procedur operacyjnych lub niezweryfikowanych instrukcji obsługi innych firm. |
Wzbogacanie danych przez wiele zespołów jednocześnie | Wiele niezależnych potoków wzbogaca ten sam zbiór plików | Ponieważ |
Ewolucja schematu CI/CD za pomocą GitOps | Zespoły platformowe przechowują definicje | Eliminuje dryf schematu między kodem wyodrębniania aplikacji a platformą sterującą Knowledge Catalog w projektach |
11. Czyszczenie środowiska
W Knowledge Catalog nie można usuwać kontenerów nadrzędnych i szablonów schematów, jeśli wpisy podrzędne nadal się do nich odwołują. cleanup.py usuwa zasoby w ścisłej odwrotnej kolejności zależności (Entry → EntryGroup → EntryType → AspectTypes → obiekty zasobnika Cloud Storage → tymczasowe pliki JSON):
# 1. Delete Fileset Entry first
catalog_client.delete_entry(name=target_entry_path)

# 2. Delete EntryGroup container
del_eg_op = catalog_client.delete_entry_group(name=target_eg_path)
if hasattr(del_eg_op, "result"):
    del_eg_op.result()

# 3. Delete EntryType and Custom AspectTypes
del_et_op = catalog_client.delete_entry_type(name=target_et_path)
if hasattr(del_et_op, "result"):
    del_et_op.result()
for aspect_id_val in (EXTRACTED_ASPECT_TYPE_ID, GOVERNANCE_ASPECT_TYPE_ID):
    target_at_path = f"{active_parent}/aspectTypes/{aspect_id_val}"
    del_at_op = catalog_client.delete_aspect_type(name=target_at_path)
    if hasattr(del_at_op, "result"):
        del_at_op.result()
Uruchom cleanup.py
python3 cleanup.py
Starting reverse-dependency resource cleanup in Knowledge Catalog...
Deleted Fileset Entry:
  projects/your-project-id/locations/us-central1/entryGroups/
  dark-data-fileset-group/entries/sop-manuals-fileset-lum8g8j
Deleted EntryGroup   :
  projects/your-project-id/locations/us-central1/entryGroups/
  dark-data-fileset-group
Deleted EntryType    :
  projects/your-project-id/locations/us-central1/entryTypes/
  unstructured-pdf-fileset
Deleted AspectType   :
  projects/your-project-id/locations/us-central1/aspectTypes/
  dark-data-extracted-metadata
Deleted AspectType   :
  projects/your-project-id/locations/us-central1/aspectTypes/
  document-governance-aspect
Deleted Cloud Storage object :
  gs://your-project-id-dark-data-manuals/sop-pdfs/LUM-LIG-DES-8G8J_manual.pdf
Deleted Cloud Storage bucket : gs://your-project-id-dark-data-manuals
Removed local temporary file : extracted_metadata.json
Removed local temporary file : governance_metadata.json
✓ Standalone teardown complete. Environment cleanly reset.
Usuwanie sklonowanego katalogu repozytorium
Gdy cleanup.py zakończy usuwanie zasobów w chmurze, wróć do katalogu głównego i usuń sklonowany folder repozytorium devrel-demos z Cloud Shell:
cd ~
rm -rf ~/devrel-demos
12. Gratulacje!
Masz utworzoną i zweryfikowaną kompleksową ścieżkę zarządzania metadanymi jako kodem, która przekształca nieustrukturyzowane pliki PDF w Cloud Storage w wykrywalne zasoby Knowledge Catalog z wymuszonym schematem za pomocą Gemini Enterprise Agent Platform.
Co dalej?
- Automatyzacja za pomocą Terraform: deklaratywne zarządzanie zasobami
google_dataplex_aspect_typeigoogle_dataplex_entry_groupw potokach CI/CD. - Wdrażanie Eventarc i procesów roboczych Cloud Run: skonteneryzuj
step4_extract_metadata.pyistep5_attach_aspects.pyw usłudze Cloud Run opartej na zdarzeniach. - Łączenie zasobów podrzędnych w BigQuery: eksportuj wyodrębnione metadane dotyczące zarządzania (
lakehouse_cross_ref_table), aby połączyć atrybuty zgodności nieuporządkowanych dokumentów z uporządkowanymi tabelami zasobów SKU.