

1. Introdução
Mais de 80% dos dados corporativos estão em formatos não estruturados: manuais de engenharia em PDF, procedimentos operacionais padrão (POPs), certificados de compliance e esquemas de equipamentos armazenados no Cloud Storage. Como os catálogos tradicionais indexam apenas esquemas de tabelas relacionais, esses documentos permanecem "dados ocultos": invisíveis para a pesquisa enterprise, desconectados das tabelas de inventário estruturadas e não verificados para conformidade regulatória.
Quando um auditor ou agente de IA pergunta: "Quais SKUs de hardware exigem certificação de segurança UL-153 e quais são os níveis de risco térmico deles?", um catálogo que indexa apenas tabelas SQL não pode responder. Os fatos estão bloqueados em PDFs não estruturados no Cloud Storage.
Solução de arquitetura: metadados multimodais como código
Neste codelab, você vai criar um pipeline Metadata-as-Code completo no Google Cloud que transforma manuais em PDF não estruturados no Cloud Storage em recursos do Knowledge Catalog com esquema aplicado usando a Gemini Enterprise Agent Platform (SDK GenAI do Google, google-genai):
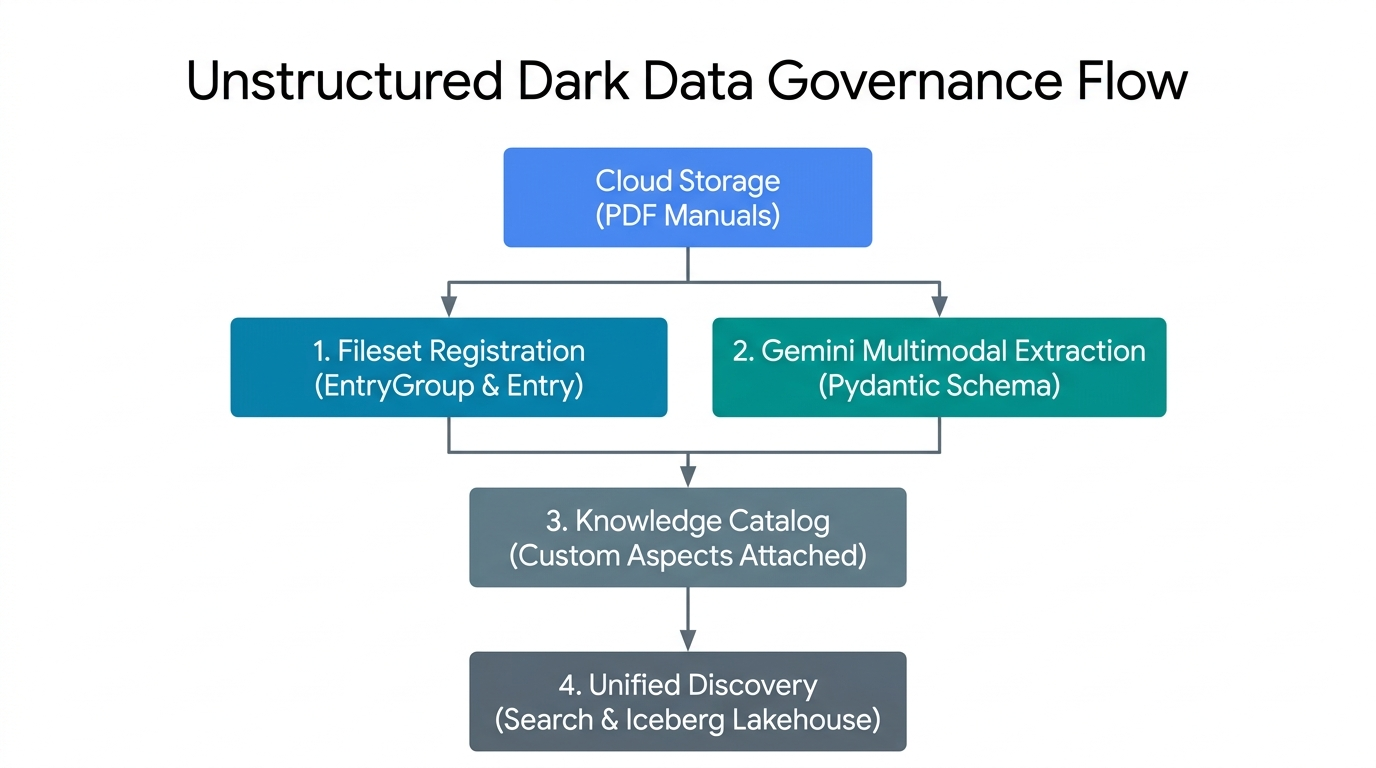
- Registro de conjunto de arquivos (
EntryGroupeEntry): agrupa PDFs não estruturados no Cloud Storage em entradas de conjunto de arquivos lógicos gerenciados no Knowledge Catalog. - Extração multimodal do Gemini (esquema Pydantic): invoca a Gemini Enterprise Agent Platform em bytes brutos de PDF com validação determinística de
response_schema. - Vinculação de aspecto do plano de controle: anexa os payloads JSON operacionais e de compliance validados como instâncias
Aspectfortemente tipadas na entrada do catálogo. - Descoberta unificada de catálogo: torna os conjuntos de arquivos PDF não estruturados e os metadados extraídos deles detectáveis via
SearchEntriesRequest.
Principais conceitos: primitivos do plano de controle do Knowledge Catalog
Imagine que sua equipe armazena centenas de manuais de produtos em PDF no Cloud Storage. Para facilitar a localização e a verificação desses arquivos no Knowledge Catalog, pense nos cinco elementos básicos como se estivesse organizando manuais em papel em um arquivo de escritório:
EntryGroup(um armário trancado para uma equipe): um armário com uma fechadura. Somente colegas de equipe com permissão (roles/dataplex.entryCreator) podem colocar pastas dentro. É necessário esvaziar todas as pastas do armário antes de remover o próprio armário.EntryType(um marcador de categoria de pasta): um marcador que informa às pessoas qual tipo de recurso uma pasta representa. Por exemplo, "Coleção de manuais em PDF" em vez de "Tabela de banco de dados".Entry(uma pasta de arquivos com um link de armazenamento): a pasta do catálogo para seus manuais em PDF. Em vez de cópias em papel pesadas, a pasta contém um cartão de localização que aponta para o bucket exato do Cloud Storage (gs://...) em que os arquivos PDF reais estão armazenados.AspectType(um formulário de lista de verificação em branco): um formulário em branco reutilizável com caixas pré-impressas (por exemplo, uma "Lista de verificação de segurança" pedindooperational_hazard_levelcomo texto econfidence_scorecomo um número de0.0a1.0). Você cria esse formulário em branco uma vez e o reutiliza em milhares de pastas.Aspect(uma lista de verificação preenchida anexada a uma pasta): depois que a Gemini Enterprise Agent Platform lê o manual em PDF e preenche os espaços em branco, a lista de verificação concluída é anexada à pastaEntry. Como cada lista de verificação tem uma chave própria (aspect_keys), as equipes de engenharia e jurídica podem anexar as próprias listas à mesma pasta sem substituir o trabalho uma da outra.
Todos os cinco recursos regionais estão em projects/{project}/locations/{location}/:
Caminho primitivo e relativo | Função no Knowledge Catalog | Regra de exclusão e do IAM |
| Contêiner lógico que agrupa entradas e controla o acesso da equipe ( | Precisa conter zero recursos filhos |
| Definição de categoria para uma classe de recursos ( | Exclua somente depois que todas as entradas que usam esse tipo forem removidas. |
| Registro do catálogo que vincula um URI físico do Cloud Storage ( | Fica dentro de um |
| Modelo de esquema reutilizável que define | Criado uma vez por região e compartilhado entre entradas. |
| Metadados JSON validados que correspondem a um | Atualizado usando |
O que você vai criar
Usando os scripts complementares em codelabs/metadata-as-code-lab, você vai executar e inspecionar um pipeline de sete etapas:
schemas.py: esquemas duplos do PydanticBaseModel(DarkDataExtractedMetadataeDocumentGovernanceMetadata) pareados 1:1 com modelos do Knowledge CatalogAspectType.step2_provision.py: provisionamento idempotente de modelos personalizadosEntryGroup,EntryTypeeAspectType.step3_register_fileset.py: upload deLUM-LIG-DES-8G8J_manual.pdfpara o Cloud Storage e registro como um conjunto de arquivos gerenciadoEntry.step4_extract_metadata.py: descoberta dinâmica do modelo principal do Gemini e extração multimodal de PDF usandogoogle-genai.step5_attach_aspects.py,step6_search_catalog.pyestep7_verify_assertions.py: vinculação de aspectos cirúrgicos, pesquisa de catálogo com espera exponencial e asserções de plano de controle de ponta a ponta.
Pré-requisitos e o que você vai precisar
- Um projeto do Google Cloud com o faturamento ativado e o Google Cloud Shell (pré-instalado com
gcloud,git,python3epip). - Permissões do IAM para gerenciar recursos do Knowledge Catalog (
roles/dataplex.admin), provisionar buckets e objetos do Cloud Storage (roles/storage.admin) e invocar a Gemini Enterprise Agent Platform (roles/aiplatform.user). - Um navegador da Web, como o Google Chrome.
2. Configuração e requisitos
Clonar o repositório complementar no Cloud Shell
Abra o console do Google Cloud, inicie o Cloud Shell e faça um checkout esparso de codelabs/metadata-as-code-lab, que inclui o manual de engenharia em PDF de exemplo (LUM-LIG-DES-8G8J_manual.pdf) e todos os scripts Python:
git clone --branch main --depth 1 --filter=blob:none --sparse \
  https://github.com/GoogleCloudPlatform/devrel-demos.git
cd devrel-demos
git sparse-checkout set codelabs/metadata-as-code-lab
cd codelabs/metadata-as-code-lab
ls -la
Configure as variáveis de ambiente
Defina o ID do projeto, o local do plano de controle regional e o bucket de destino do Cloud Storage no Cloud Shell:
export PROJECT_ID="${PROJECT_ID:-$(gcloud config get-value project)}"
gcloud config set project $PROJECT_ID

export REGION="us-central1"
export BUCKET_NAME="${PROJECT_ID}-dark-data-manuals"
export GEMINI_LOCATION="global"

echo "Configured Project ID        : $PROJECT_ID"
echo "Knowledge Catalog Region     : $REGION"
echo "Gemini Endpoint Location     : $GEMINI_LOCATION"
echo "Target Cloud Storage Bucket  : $BUCKET_NAME"
Ativar APIs e instalar dependências
Ative as APIs necessárias do Google Cloud e instale as dependências do Python (google-genai, google-cloud-dataplex, pydantic e pandas) em requirements.txt:
gcloud services enable \
  dataplex.googleapis.com \
  storage.googleapis.com \
  aiplatform.googleapis.com \
  --quiet
python3 -m pip install --upgrade --quiet --user --break-system-packages -r requirements.txt
3. Definir esquemas Pydantic e modelos de aspectos
schemas.py define dois contratos complementares que combinam a validação Pydantic do lado do cliente com modelos do Knowledge Catalog AspectType do lado do servidor:
DarkDataExtractedMetadata: atributos operacionais extraídos do PDF (título do documento, ontologia de domínio, nível de risco à segurança, autoria/proveniência da versão, resumo executivo e pontuação de confiança da extração).DocumentGovernanceMetadata: códigos de conformidade regulamentar (UL-153, FCC Parte 15, CE-LVD, RoHS), proprietário da administração, política de retenção e uma string de identificador de tabela de referência (lakehouse_cross_ref_table) para vincular o manual em PDF às tabelas de inventário downstream.
Inspecionar schemas.py
Primeiro, o DarkDataExtractedMetadata usa restrições Field do Pydantic (ge=0.0, le=1.0, ou seja, maior/menor que ou igual a, em confidence_score) para restringir a saída JSON da Gemini Enterprise Agent Platform:
class DarkDataExtractedMetadata(BaseModel):
    document_title: str = Field(
        description="Official document title or product model name extracted from the PDF manual."
    )
    # ... domain_ontology, operational_hazard_level, author_provenance ...
    version_provenance: str = Field(
        description="Document version, revision code, or publication standard identifier."
    )
    # ... document_summary ...
    confidence_score: float = Field(
        ge=0.0,
        le=1.0,
        description="AI extraction confidence metric between 0.0 and 1.0.",
    )
Segundo, extracted_aspect_template espelha esses nomes de campo exatos e mapeia os tipos str e float do Python para string e double record_fields do Knowledge Catalog. O contrato protobuf AspectType.MetadataTemplate exige que cada campo em record_fields declare um inteiro index exclusivo, estritamente positivo e de base 1 (1 a 7). Omitir ou duplicar index faz com que create_aspect_type falhe com 400 INVALID_ARGUMENT:
extracted_aspect_template = {
    "name": "DarkDataExtractedMetadata",
    "type": "record",
    "record_fields": [
        {
            "name": "document_title",
            "type": "string",
            "index": 1,
            "annotations": {"description": "Official document title or product model name."},
        },
        # ... fields 2 through 6 (string) ...
        {
            "name": "confidence_score",
            "type": "double",
            "index": 7,
            # ... annotations ...
        },
    ],
}
Validar o módulo de esquema
Execute schemas.py para verificar a configuração do ambiente e compilar os dois esquemas:
python3 schemas.py
Configured Project ID         : your-project-id
Knowledge Catalog Region      : us-central1
Gemini Endpoint Location      : global
Governed Fileset Storage URI  :
  gs://your-project-id-dark-data-manuals/sop-pdfs/LUM-LIG-DES-8G8J_manual.pdf
Target Fileset Entry ID       : sop-manuals-fileset-lum8g8j
✓ Defined DarkDataExtractedMetadata and DocumentGovernanceMetadata
  Pydantic schemas.
✓ Prepared Knowledge Catalog AspectType metadata templates.
4. Provisionar namespaces e tipos de aspectos personalizados
Antes de registrar entradas de conjunto de arquivos ou anexar metadados, o step2_provision.py provisiona três recursos de plano de controle no Knowledge Catalog:
EntryGroup:dark-data-fileset-groupEntryType:unstructured-pdf-filesetAspectTypeBlueprints:dark-data-extracted-metadataedocument-governance-aspect
Provisionamento idempotente em step2_provision.py
Cada chamada de criação em step2_provision.py envolve a operação de longa duração (op.result()) em um bloco try / except AlreadyExists para que o script possa ser executado novamente com segurança sem falhar em recursos atuais:
# Provision AspectType 1: dark-data-extracted-metadata
try:
    at1_op = catalog_client.create_aspect_type(
        parent=parent_location,
        aspect_type_id=EXTRACTED_ASPECT_TYPE_ID,
        aspect_type=AspectType(
            name=extracted_aspect_type_name,
            display_name="Dark Data Multimodal Extracted Metadata",
            # ... description ...
            metadata_template=extracted_aspect_template,
        ),
    )
    if hasattr(at1_op, "result"):
        at1_op.result()
    print(f"Created AspectType: {extracted_aspect_type_name}")
except AlreadyExists:
    print(f"AspectType already exists; retrieving live resource: {extracted_aspect_type_name}")

live_extracted_aspect_type = catalog_client.get_aspect_type(name=extracted_aspect_type_name)
Depois que metadata_template=extracted_aspect_template é registrado, o Knowledge Catalog aplica o esquema no limite da API. Qualquer chamada update_entry() subsequente que transmita uma string para confidence_score (double) será rejeitada.
Executar step2_provision.py
Execute o script de provisionamento e confirme se os tipos de aspectos personalizados estão registrados na sua região:
python3 step2_provision.py
gcloud dataplex aspect-types list --location=$REGION
Created EntryGroup:
  projects/your-project-id/locations/us-central1/entryGroups/
  dark-data-fileset-group
Created EntryType :
  projects/your-project-id/locations/us-central1/entryTypes/
  unstructured-pdf-fileset
Created AspectType:
  projects/your-project-id/locations/us-central1/aspectTypes/
  dark-data-extracted-metadata
Created AspectType:
  projects/your-project-id/locations/us-central1/aspectTypes/
  document-governance-aspect
✓ All Knowledge Catalog namespaces and AspectType blueprints are active.
5. Registrar entradas de conjunto de arquivos não estruturados
Em vez de poluir o catálogo com milhões de ponteiros de arquivos isolados, o Knowledge Catalog agrupa documentos relacionados no Cloud Storage (gs://YOUR_BUCKET/sop-pdfs/*.pdf) em entradas de conjunto de arquivos lógicas, seja por verificações de descoberta automatizadas (DataScanServiceClient) ou registro programático direto (CatalogServiceClient.create_entry).
Como o step3_register_fileset.py mapeia o armazenamento para o catálogo
O step3_register_fileset.py faz upload de LUM-LIG-DES-8G8J_manual.pdf para gs://${BUCKET_NAME}/sop-pdfs/LUM-LIG-DES-8G8J_manual.pdf e registra o Entry controlado:
fully_qualified_fileset_uri = f"gcs:{BUCKET_NAME}"
fileset_entry_spec = Entry(
    name=fileset_entry_name,
    entry_type=entry_type_resource_name,
    fully_qualified_name=fully_qualified_fileset_uri,
    entry_source=EntrySource(
        resource=VIRTUAL_STORAGE_URI,
        system="Cloud Storage",
        platform="Google Cloud",
        display_name="LUM-LIG-DES-8G8J Unstructured SOP & Technical Manual Fileset",
        # ... description ...
        location=REGION,
    ),
)

create_entry_op = catalog_client.create_entry(
    parent=entry_group_resource_name,
    entry_id=FILESET_ENTRY_ID,
    entry=fileset_entry_spec,
)
Observe as funções distintas dos dois campos de URI em Entry:
fully_qualified_name=fully_qualified_fileset_uri(f"gcs:{BUCKET_NAME}"): usa o esquema de FQNgcs:{bucket_name}canônico exigido pelo Knowledge Catalog para correlacionar a entrada de catálogo lógica com o bucket do Cloud Storage.entry_source.resource=VIRTUAL_STORAGE_URI: armazena o URI do objetogs://físico inspecionado por trabalhadores de extração downstream.
Executar step3_register_fileset.py
python3 step3_register_fileset.py
Created Cloud Storage bucket:
  gs://your-project-id-dark-data-manuals in us-central1
Uploaded unstructured PDF manual to:
  gs://your-project-id-dark-data-manuals/sop-pdfs/LUM-LIG-DES-8G8J_manual.pdf
Registered governed Fileset Entry:
  projects/your-project-id/locations/us-central1/entryGroups/
  dark-data-fileset-group/entries/sop-manuals-fileset-lum8g8j
  -> Fully Qualified Name : gcs:your-project-id-dark-data-manuals
  -> Physical Resource URI:
  gs://your-project-id-dark-data-manuals/sop-pdfs/LUM-LIG-DES-8G8J_manual.pdf
  -> Source System        : Cloud Storage
6. Extrair metadados de documentos com o Gemini
O step4_extract_metadata.py lê os bytes brutos do PDF e invoca a Gemini Enterprise Agent Platform (genai_client.models.generate_content) usando dois padrões principais:
1. Descoberta dinâmica de modelos principais
Em vez de codificar strings de versão de modelo frágeis, o script consulta genai_client.models.list() e classifica os candidatos ativos por (is_ga_channel, semantic_version_tuple) para escolher o modelo flash de disponibilidade geral (GA) mais recente:
genai_client = genai.Client(
    vertexai=True,
    project=PROJECT_ID,
    location=GEMINI_LOCATION,
)

for model_obj in genai_client.models.list():
    raw_id = (model_obj.name or "").split("/")[-1]
    # Filter to flagship Gemini Flash models (version >= 3.0) and prioritize GA over preview
    ...
    discovered_candidates.append((is_ga_channel, ver_tuple, raw_id))

discovered_candidates.sort(key=lambda item: (item[0], item[1]), reverse=True)
2. Extração multimodal restrita por esquema (Part.from_bytes + response_schema)
A transmissão de response_mime_type="application/json" e response_schema=DarkDataExtractedMetadata (seguida por DocumentGovernanceMetadata) restringe a decodificação de token diretamente ao esquema JSON do Pydantic:
with open(LOCAL_PDF_PATH, "rb") as pdf_file:
    raw_pdf_bytes = pdf_file.read()

extraction_response = genai_client.models.generate_content(
    model=candidate_model,
    contents=[
        types.Part.from_bytes(data=raw_pdf_bytes, mime_type="application/pdf"),
        extraction_prompt,
    ],
    config=types.GenerateContentConfig(
        response_mime_type="application/json",
        response_schema=DarkDataExtractedMetadata,
        temperature=0.1,
    ),
)

extracted_dark_data = json.loads(extraction_response.text)
validated_extraction = DarkDataExtractedMetadata(**extracted_dark_data)
Executar step4_extract_metadata.py
python3 step4_extract_metadata.py
Dynamically discovered active GA model currency :
  gemini-3.8-flash (version (3, 8))
Loaded unstructured PDF manual at: LUM-LIG-DES-8G8J_manual.pdf
Read unstructured PDF document (1184 bytes).
  Executing multimodal extraction with gemini-3.8-flash...
✓ Multimodal extraction completed using model: gemini-3.8-flash
✓ Governance classification completed using model: gemini-3.8-flash

--- Extracted Multimodal Operational Metadata ---
Extracted Attribute    Multimodal Value
document_title    LUM-LIG-DES-8G8J Contemporary Linen Desk Lamp
domain_ontology    Electrical Hardware & Lighting Systems
operational_hazard_level    MEDIUM
author_provenance    Global Hardware Safety & Lighting Systems Engin
version_provenance    Rev 4.2
document_summary    This document outlines standard operating proce
confidence_score    0.99

--- Extracted Governance & Inventory Cross-Reference Metadata ---
Governance Attribute    Classification Value
compliance_classifications    UL-153 Portable Luminaires, FCC Part 15, CE-LVD
stewardship_owner    Global Hardware Safety & Lighting Systems Engin
retention_policy    10-Year Active Product Lifecycle Archival
lakehouse_cross_ref_table    lakehouse.your-project-id.retail_hardware
governance_status    VERIFIED_PRODUCTION
7. Anexar aspectos validados a entradas de catálogo
O step5_attach_aspects.py vincula os payloads JSON validados (extracted_metadata.json e governance_metadata.json) à entrada sop-manuals-fileset-lum8g8j usando catalog_client.update_entry().
Mutação do aspecto cirúrgico em step5_attach_aspects.py
extracted_aspect_key = f"{PROJECT_ID}.{REGION}.{EXTRACTED_ASPECT_TYPE_ID}"
governance_aspect_key = f"{PROJECT_ID}.{REGION}.{GOVERNANCE_ASPECT_TYPE_ID}"

updated_entry_payload = Entry(
    name=fileset_entry_name,
    entry_type=entry_type_resource_name,
    fully_qualified_name=fully_qualified_fileset_uri,
    aspects={
        extracted_aspect_key: Aspect(
            aspect_type=extracted_aspect_type_name,
            data=extracted_data,
        ),
        governance_aspect_key: Aspect(
            aspect_type=governance_aspect_type_name,
            data=governance_data,
        ),
    },
)

update_op = catalog_client.update_entry(
    request=dataplex_v1.UpdateEntryRequest(
        entry=updated_entry_payload,
        update_mask={"paths": ["aspects"]},
        aspect_keys=[extracted_aspect_key, governance_aspect_key],
    )
)
A transmissão de ambos os escopos update_mask={"paths": ["aspects"]} e aspect_keys=[extracted_aspect_key, governance_aspect_key] restringe a mutação estritamente a essas duas chaves de aspecto, deixando entry_source e todos os aspectos pertencentes a outras equipes intactos.
Executar step5_attach_aspects.py
python3 step5_attach_aspects.py
Successfully bound 2 Aspect(s) to Entry:
  projects/your-project-id/locations/us-central1/entryGroups/
  dark-data-fileset-group/entries/sop-manuals-fileset-lum8g8j

=== Live Attached Aspect: document-governance-aspect ===
Catalog Field    Authoritative Stored Value
compliance_classifications    UL-153 Portable Luminaires, FCC Part 15, CE-LVD
stewardship_owner    Global Hardware Safety & Lighting Systems Engin
retention_policy    10-Year Active Product Lifecycle Archival
lakehouse_cross_ref_table    lakehouse.your-project-id.retail_hardware
governance_status    VERIFIED_PRODUCTION

=== Live Attached Aspect: dark-data-extracted-metadata ===
Catalog Field    Authoritative Stored Value
document_title    LUM-LIG-DES-8G8J Contemporary Linen Desk Lamp
domain_ontology    Electrical Hardware & Lighting Systems
operational_hazard_level    MEDIUM
author_provenance    Global Hardware Safety & Lighting Systems Engin
version_provenance    Rev 4.2
document_summary    This document outlines standard operating proce
confidence_score    0.99
Verificação de duas vias
- Track 1 (CLI Verification): inspecione a entrada com todos os aspectos anexados via
gcloud:gcloud dataplex entries describe sop-manuals-fileset-lum8g8j \ --entry-group=dark-data-fileset-group \ --location=$REGION \ --view=ALL - Track 2 (inspeção da interface do console):
- Abra o Search Console do Knowledge Catalog, pesquise LUM-LIG-DES-8G8J Unstructured SOP & Technical Manual Fileset (
sop-manuals-fileset-lum8g8j) e selecione a entrada correspondente nos resultados. - Em Tags e aspectos opcionais, verifique se Metadados extraídos multimodais de dados inativos e Aspecto de governança e inventário de documentos com referências cruzadas mostram o nível de risco extraído (
MEDIUM), os códigos de compliance (UL-153, FCC Part 15, CE-LVD, RoHS) e a string da tabela de referências cruzadas (lakehouse_cross_ref_table).
- Abra o Search Console do Knowledge Catalog, pesquise LUM-LIG-DES-8G8J Unstructured SOP & Technical Manual Fileset (
8. Consultar dados secundários governados no catálogo
Depois que os aspectos personalizados são anexados, os manuais em PDF não estruturados no Cloud Storage podem ser descobertos pela pesquisa do Knowledge Catalog (catalog_client.search_entries()).
Enquete search_entries() em step6_search_catalog.py
O step6_search_catalog.py pesquisa search_entries() com espera exponencial e lê as chaves de aspecto canonizadas usando .endswith():
search_query = f"entrygroup={entry_group_resource_name} name:{FILESET_ENTRY_ID}"

while elapsed_seconds < max_wait_seconds:
    catalog_search_results = list(
        catalog_client.search_entries(
            request=dataplex_v1.SearchEntriesRequest(
                name=parent_location,
                query=search_query,
            )
        )
    )
    if catalog_search_results:
        break
    backoff_seconds = min(5 * (2 ** attempt), 30)
    time.sleep(backoff_seconds)
    ...

for k, asp in detailed_entry.aspects.items():
    if k.endswith(f".{REGION}.{EXTRACTED_ASPECT_TYPE_ID}"):
        print(f"    Domain Ontology     : {asp.data.get('domain_ontology')}")
        print(f"    Hazard Level        : {asp.data.get('operational_hazard_level')}")
    elif k.endswith(f".{REGION}.{GOVERNANCE_ASPECT_TYPE_ID}"):
        print(f"    Compliance Codes    : {asp.data.get('compliance_classifications')}")
        print(f"    Lakehouse Join Table: {asp.data.get('lakehouse_cross_ref_table')}")
Executar step6_search_catalog.py
python3 step6_search_catalog.py
Executing Knowledge Catalog search query:
  'entrygroup=projects/your-project-id/locations/us-central1/entryGroups/
  dark-data-fileset-group name:sop-manuals-fileset-lum8g8j'...

✓ Discovered 1 governed asset(s) in Knowledge Catalog:

[1] Entry Resource Name :
    projects/your-project-id/locations/us-central1/entryGroups/
    dark-data-fileset-group/entries/sop-manuals-fileset-lum8g8j
    Fully Qualified Name: gcs:your-project-id-dark-data-manuals
    Entry Type :
    projects/your-project-id/locations/us-central1/entryTypes/
    unstructured-pdf-fileset
    Physical Storage URI:
    gs://your-project-id-dark-data-manuals/sop-pdfs/LUM-LIG-DES-8G8J_manual.pdf
    Domain Ontology     : Electrical Hardware & Lighting Systems
    Hazard Level        : MEDIUM
    Compliance Codes    : UL-153 Portable Luminaires, FCC Part 15, CE-LVD, RoHS
    Lakehouse Join Table:
    lakehouse.your-project-id.retail_hardware.luminaire_sku_inventory_iceberg
Verificação de duas vias
- Track 1 (CLI Search): consulte o índice de pesquisa diretamente via
gcloud:gcloud dataplex entries search "name:sop-manuals-fileset-lum8g8j" --project=$PROJECT_ID - Faixa 2 (pesquisa em linguagem natural na interface do console):
- Abra o Search Console do Knowledge Catalog e pesquise
LUM-LIG-DES-8G8JouUL-153. - Observe como o Knowledge Catalog mostra a entrada do conjunto de arquivos PDF governado do Cloud Storage e os aspectos de metadados anexados.
- Abra o Search Console do Knowledge Catalog e pesquise
9. Verificar declarações de governança de ponta a ponta
O step7_verify_assertions.py executa declarações determinísticas em relação às respostas do plano de controle do Knowledge Catalog em tempo real para verificar se o EntryGroup, o EntryType, os dois blueprints personalizados AspectType, os payloads de aspecto vinculados EntryView.ALL (limites confidence_score e string lakehouse_cross_ref_table) e a descoberta do índice de pesquisa foram concluídos com êxito:
verify_eg = catalog_client.get_entry_group(name=entry_group_resource_name)
assert verify_eg.name == entry_group_resource_name, "EntryGroup resource name mismatch."

verify_entry = catalog_client.get_entry(
    request=dataplex_v1.GetEntryRequest(
        name=fileset_entry_name,
        view=dataplex_v1.EntryView.ALL,
    )
)
bound_extracted = next(
    (
        asp for k, asp in verify_entry.aspects.items()
        if k.endswith(f".{REGION}.{EXTRACTED_ASPECT_TYPE_ID}")
    ),
    None,
)
bound_governance = next(
    (
        asp for k, asp in verify_entry.aspects.items()
        if k.endswith(f".{REGION}.{GOVERNANCE_ASPECT_TYPE_ID}")
    ),
    None,
)

assert bound_extracted is not None, f"Aspect '{EXTRACTED_ASPECT_TYPE_ID}' not found on live Entry."
assert bound_governance is not None, (
    f"Aspect '{GOVERNANCE_ASPECT_TYPE_ID}' not found on live Entry."
)
assert (
    bound_extracted.data.get("document_title") == expected_extraction["document_title"]
), "Extracted title mismatch."
assert (
    0.0 <= float(bound_extracted.data.get("confidence_score", -1.0)) <= 1.0
), "Invalid confidence score in catalog."
assert (
    "lakehouse" in str(bound_governance.data.get("lakehouse_cross_ref_table", "")).lower()
), "Missing Lakehouse cross-reference."
...
assert len(search_results) >= 1, "Expected at least 1 search result in Knowledge Catalog."
Executar step7_verify_assertions.py
python3 step7_verify_assertions.py && echo "Verification exit code: $?"
Running substantive end-to-end verification assertions...
✓ All 5 substantive verification assertions passed
  against live Google Cloud control plane state!
Verification exit code: 0
10. Arquitetar um pipeline orientado a eventos
Embora a execução interativa de scripts Python no Cloud Shell seja ideal para criar e testar seus contratos de governança, os ambientes empresariais recebem diariamente milhares de manuais de engenharia em PDF novos ou revisados, certificados de conformidade de fornecedores e documentos de POP de ERP, gerenciamento do ciclo de vida do produto (PLM) e portais de fornecedores. Executar scripts em lote manualmente cria rapidamente pontos cegos de governança entre o upload de documentos e a indexação do catálogo.
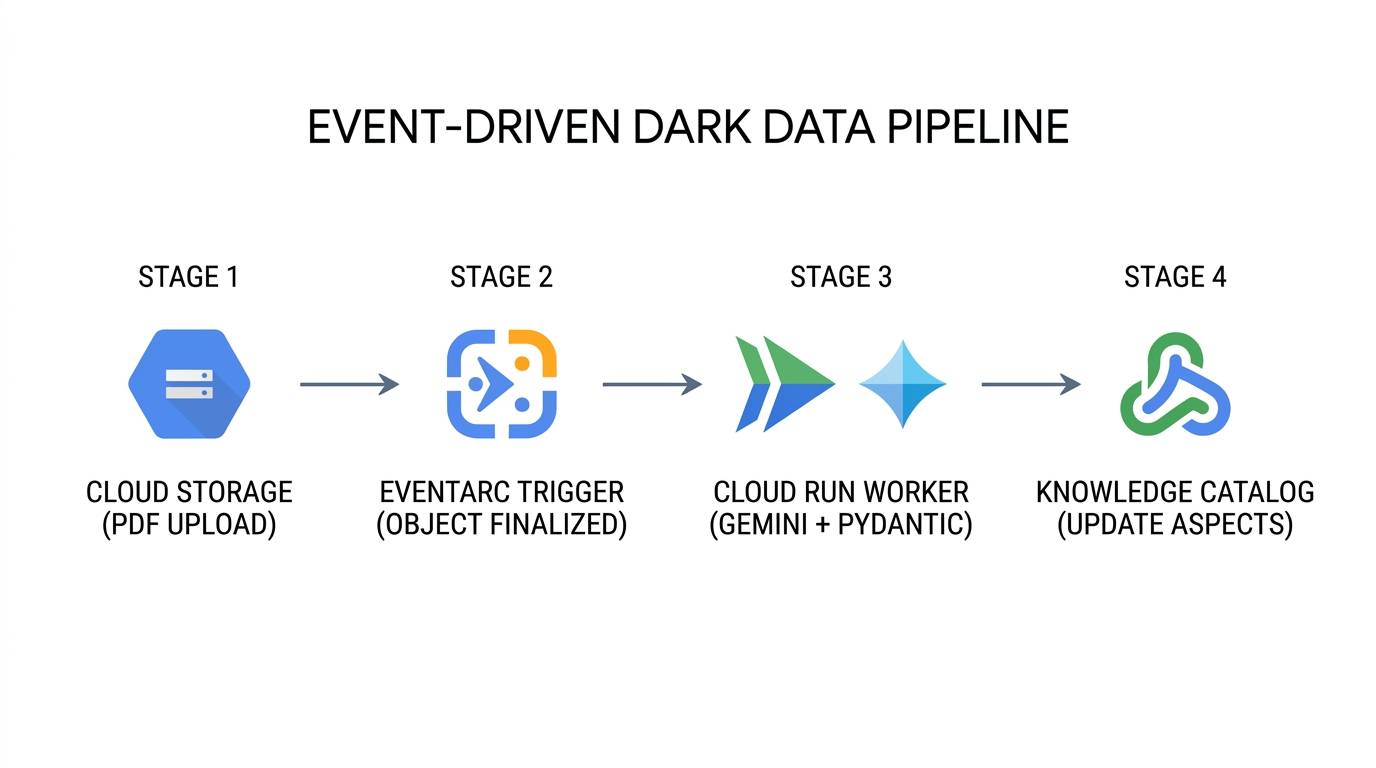
Em produção, as equipes de plataforma operacionalizam o código exato que você executou nas etapas 4 e 5 como um pipeline sem toque e orientado a eventos:
- Ingestão contínua de documentos (
Cloud Storage→Eventarc): sempre que um novo manual em PDF é enviado ou uma nova revisão substitui um objeto existente no Cloud Storage, o bucket emite um CloudEventgoogle.cloud.storage.object.v1.finalizedque contém o identificador do bucket, o caminho do objeto e o número de geração do objeto. - Extração multimodal sem estado (
Eventarc→Cloud Run→Gemini Enterprise Agent Platform): o Eventarc encaminha o CloudEvent para um pacote de trabalho Cloud Run sem servidorschemas.py,step4_extract_metadata.pyestep5_attach_aspects.py. O worker transmite os bytes do PDF para a Gemini Enterprise Agent Platform com aresponse_schemaaplicada, garantindo que todos os atributos extraídos estejam em conformidade comDarkDataExtractedMetadataeDocumentGovernanceMetadata. - Atualização cirúrgica do plano de controle (
Cloud Run→Knowledge Catalog): o worker resolve o Fileset principalEntrye executacatalog_client.update_entry()comupdate_mask={"paths": ["aspects"]}easpect_keysexplícito. Mesmo que dezenas de documentos terminem o processamento simultaneamente, cada mutação atualiza apenas as chaves de aspecto designadas. - Quarentena de administrador com restrição de confiança: se um PDF legado digitalizado gerar uma extração
confidence_scoreabaixo do seu limite operacional (por exemplo,< 0.85), o worker vai definirgovernance_status = "PENDING_STEWARD_REVIEW"no aspecto anexado para que os administradores de dados possam consultar o Knowledge Catalog em busca de recursos de baixa confiança que exigem revisão humana.
Como as empresas aplicam esse padrão na produção
Caso de uso empresarial | Como os metadados como código funcionam na prática | Impacto operacional e nos negócios |
Auditorias regulatórias automatizadas e preparação para recall | Os sistemas de compliance combinam aspectos de segurança de PDF não estruturados ( | Quando um padrão como |
Agentes de IA embasados e pré-filtragem de RAG | Antes de um agente de geração aumentada por recuperação (RAG) na Gemini Enterprise Agent Platform responder à pergunta de um engenheiro de campo, ele filtra as entradas do Knowledge Catalog por | Impede que os assistentes de IA tenham alucinações ou citem rascunhos de engenharia descontinuados, POs expirados ou manuais de terceiros não verificados. |
Enriquecimento simultâneo de várias equipes | Vários pipelines independentes enriquecem o mesmo conjunto de arquivos | Como os escopos do |
Evolução do esquema de CI/CD via GitOps | As equipes de plataforma armazenam | Elimina a deriva de esquema entre o código de extração de aplicativos e o plano de controle do Knowledge Catalog em projetos |
11. Limpar o ambiente
No Knowledge Catalog, não é possível excluir contêineres principais e modelos de esquema enquanto as entradas secundárias ainda os referenciam. cleanup.py exclui recursos em ordem estrita de dependência inversa (Entry → EntryGroup → EntryType → AspectTypes → objetos de bucket do Cloud Storage → arquivos JSON temporários):
# 1. Delete Fileset Entry first
catalog_client.delete_entry(name=target_entry_path)

# 2. Delete EntryGroup container
del_eg_op = catalog_client.delete_entry_group(name=target_eg_path)
if hasattr(del_eg_op, "result"):
    del_eg_op.result()

# 3. Delete EntryType and Custom AspectTypes
del_et_op = catalog_client.delete_entry_type(name=target_et_path)
if hasattr(del_et_op, "result"):
    del_et_op.result()
for aspect_id_val in (EXTRACTED_ASPECT_TYPE_ID, GOVERNANCE_ASPECT_TYPE_ID):
    target_at_path = f"{active_parent}/aspectTypes/{aspect_id_val}"
    del_at_op = catalog_client.delete_aspect_type(name=target_at_path)
    if hasattr(del_at_op, "result"):
        del_at_op.result()
Executar cleanup.py
python3 cleanup.py
Starting reverse-dependency resource cleanup in Knowledge Catalog...
Deleted Fileset Entry:
  projects/your-project-id/locations/us-central1/entryGroups/
  dark-data-fileset-group/entries/sop-manuals-fileset-lum8g8j
Deleted EntryGroup   :
  projects/your-project-id/locations/us-central1/entryGroups/
  dark-data-fileset-group
Deleted EntryType    :
  projects/your-project-id/locations/us-central1/entryTypes/
  unstructured-pdf-fileset
Deleted AspectType   :
  projects/your-project-id/locations/us-central1/aspectTypes/
  dark-data-extracted-metadata
Deleted AspectType   :
  projects/your-project-id/locations/us-central1/aspectTypes/
  document-governance-aspect
Deleted Cloud Storage object :
  gs://your-project-id-dark-data-manuals/sop-pdfs/LUM-LIG-DES-8G8J_manual.pdf
Deleted Cloud Storage bucket : gs://your-project-id-dark-data-manuals
Removed local temporary file : extracted_metadata.json
Removed local temporary file : governance_metadata.json
✓ Standalone teardown complete. Environment cleanly reset.
Remova o diretório do repositório clonado
Depois que cleanup.py terminar de excluir os recursos da nuvem, volte para o diretório inicial e remova a pasta do repositório devrel-demos clonado do Cloud Shell:
cd ~
rm -rf ~/devrel-demos
12. Parabéns!
Você criou e verificou um pipeline de governança de metadados como código de ponta a ponta que transforma PDFs não estruturados no Cloud Storage em recursos detectáveis do Knowledge Catalog com aplicação de esquema usando a Gemini Enterprise Agent Platform.
A seguir
- Automatize com o Terraform: gerencie recursos
google_dataplex_aspect_typeegoogle_dataplex_entry_groupde forma declarativa em pipelines de CI/CD. - Implantar o Eventarc + os workers do Cloud Run: coloque
step4_extract_metadata.pyestep5_attach_aspects.pyem contêineres em um serviço Cloud Run orientado a eventos. - Junções de inventário downstream no BigQuery: exporte os metadados de governança extraídos (
lakehouse_cross_ref_table) para unir atributos de conformidade de documentos não estruturados com tabelas de inventário de SKUs estruturadas.