

1. Введение
Более 80% корпоративных данных хранятся в неструктурированных форматах — PDF-файлы инженерных руководств, стандартных операционных процедур (СОП), сертификатов соответствия и схем оборудования, хранящихся в облачном хранилище . Поскольку традиционные каталоги индексируют только схемы реляционных таблиц, эти документы остаются «теневыми данными» : невидимыми для корпоративного поиска, оторванными от структурированных таблиц инвентаризации и не проверенными на соответствие нормативным требованиям.
Когда аудитор или агент искусственного интеллекта спрашивает: «Какие модели оборудования требуют сертификации безопасности UL-153 и каков их уровень термической опасности?» , каталог, индексирующий только таблицы SQL, не может ответить. Эти данные хранятся в неструктурированных PDF-файлах в облачном хранилище .
Архитектурное решение: многомодальные метаданные как код.
В этом практическом занятии вы создадите сквозной конвейер обработки метаданных как кода в Google Cloud , который преобразует неструктурированные PDF-руководства из Cloud Storage в ресурсы каталога знаний с соблюдением схемы с помощью платформы Gemini Enterprise Agent Platform ( Google GenAI SDK , google-genai ):
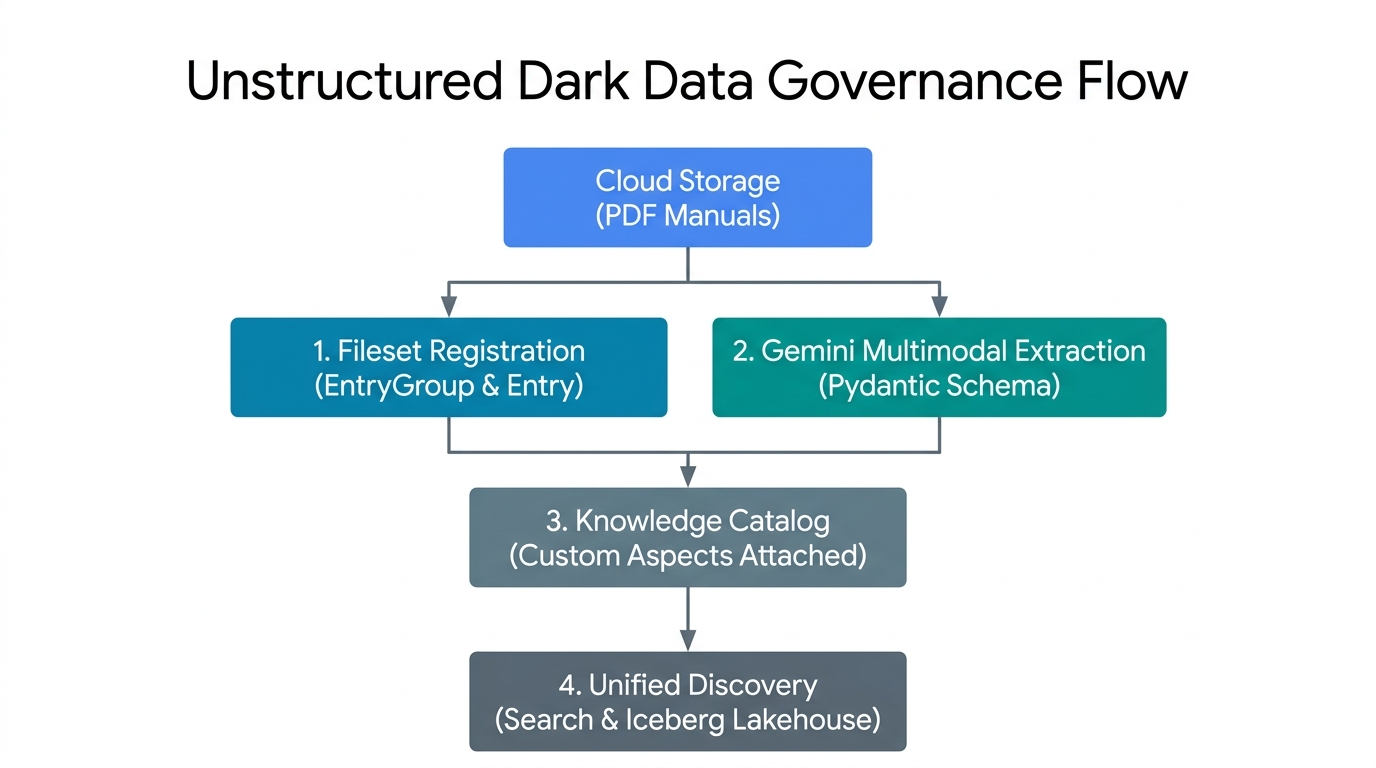
- Регистрация наборов файлов (
EntryGroupиEntry) : группирует неструктурированные PDF-файлы в облачном хранилище в управляемые логические записи наборов файлов в каталоге знаний . - Gemini Multimodal Extraction ( Pydantic Schema) : Запускает платформу Gemini Enterprise Agent Platform на основе необработанных байтов PDF-файла с детерминированной проверкой
response_schema. - Привязка аспектов плоскости управления : Прикрепляет проверенные операционные и соответствующие требованиям JSON-данные в виде строго типизированных экземпляров
Aspectк записи в каталоге. - Единый каталог поиска : позволяет находить неструктурированные PDF-файлы и извлеченные из них метаданные с помощью
SearchEntriesRequest.
Ключевые понятия: Примитивы плоскости управления каталога знаний
Представьте, что ваша команда хранит сотни PDF-руководств по продуктам в облачном хранилище . Чтобы эти файлы было легко найти и проверить в каталоге знаний , представьте себе пять основных элементов как организацию бумажных руководств в офисном картотечном шкафу :
-
EntryGroup(Запертый шкаф для одной команды): Шкаф с замком. Только члены команды, имеющие соответствующие права (roles/dataplex.entryCreator), могут размещать в нем папки. Перед тем как удалить сам шкаф, необходимо очистить его от всех папок. -
EntryType(метка категории папки): метка, указывающая, к какому типу ресурсов относится папка — например, «Коллекция руководств по PDF» вместо «Таблица базы данных». -
Entry(папка с ссылкой на хранилище): папка-каталог для ваших PDF-руководств. Вместо хранения толстых бумажных копий, папка содержит карточку местоположения, указывающую на точное хранилище Cloud Storage (gs://...), где хранятся реальные PDF-файлы. -
AspectType(пустой бланк контрольного списка): Многоразовый пустой бланк с предварительно напечатанными полями (например, «Контрольный список безопасности», в котором необходимо указатьoperational_hazard_levelв текстовом формате иconfidence_scoreв виде числа от0.0до1.0). Вы создаете этот пустой бланк один раз и используете его в тысячах папок. -
Aspect(заполненный контрольный список, прикрепленный к папке): После того, как платформа Gemini Enterprise Agent Platform прочитает руководство в формате PDF и заполнит поля, заполненный контрольный список будет прикреплен к папкеEntry. Поскольку каждый контрольный список имеет свой собственный ключ (aspect_keys), команда разработчиков и юридическая команда могут прикрепить свои собственные контрольные списки к одной и той же папке, не перезаписывая работу друг друга.
Все пять региональных ресурсов находятся в папке projects/{project}/locations/{location}/ :
Первобытный и относительный путь | Роль в каталоге знаний | Удаление и правило IAM |
| Логический контейнер, который группирует записи и контролирует доступ команды ( | Перед удалением файл не должен содержать дочерних |
| Определение категории для класса активов ( | Удалять только после удаления всех записей, относящихся к этому типу. |
| Запись в каталоге, связывающая физический URI облачного хранилища ( | Находится внутри |
| Многоразовый шаблон схемы, определяющий типизированные | Создается один раз для каждого региона и используется для всех записей. |
| Проверенные метаданные JSON, соответствующие | Обновлено с использованием |
Что вы построите
Используя прилагаемые скрипты из codelabs/metadata-as-code-lab , вы запустите и проанализируете 7-этапный конвейер обработки данных:
-
schemas.py— Двойные схемы PydanticBaseModel(DarkDataExtractedMetadataиDocumentGovernanceMetadata), объединенные в соотношении 1:1 с шаблонамиAspectTypeкаталога знаний . -
step2_provision.py— Идемпотентное выделение ресурсов для пользовательских шаблоновEntryGroup,EntryTypeиAspectType. -
step3_register_fileset.py— Загрузка файлаLUM-LIG-DES-8G8J_manual.pdfв облачное хранилище и регистрация его в качестве управляемойEntryфайлов. -
step4_extract_metadata.py— Динамическое обнаружение флагманской модели Gemini и извлечение мультимодальных PDF-файлов с использованиемgoogle-genai. -
step5_attach_aspects.py,step6_search_catalog.pyиstep7_verify_assertions.py— Прикрепление хирургических аспектов, поиск по каталогу с экспоненциальной задержкой и сквозные утверждения плоскости управления.
Предварительные требования и то, что вам понадобится
- Проект Google Cloud с включенной функцией выставления счетов и Google Cloud Shell (предустановлены
gcloud,git,python3иpip). - Разрешения IAM для управления ресурсами каталога знаний (
roles/dataplex.admin), выделения сегментов и объектов облачного хранилища (roles/storage.admin) и вызова платформы корпоративных агентов Gemini (roles/aiplatform.user). - Веб-браузер, например, Google Chrome .
2. Настройка и требования
Клонируйте сопутствующий репозиторий в Cloud Shell.
Откройте консоль Google Cloud , запустите Cloud Shell и выполните частичную проверку репозитория codelabs/metadata-as-code-lab , который включает в себя пример инженерного руководства в формате PDF ( LUM-LIG-DES-8G8J_manual.pdf ) и все скрипты Python:
git clone --branch main --depth 1 --filter=blob:none --sparse \
  https://github.com/GoogleCloudPlatform/devrel-demos.git
cd devrel-demos
git sparse-checkout set codelabs/metadata-as-code-lab
cd codelabs/metadata-as-code-lab
ls -la
Настройка переменных среды
Укажите идентификатор проекта, местоположение региональной плоскости управления и целевой сегмент Cloud Storage в Cloud Shell:
export PROJECT_ID="${PROJECT_ID:-$(gcloud config get-value project)}"
gcloud config set project $PROJECT_ID

export REGION="us-central1"
export BUCKET_NAME="${PROJECT_ID}-dark-data-manuals"
export GEMINI_LOCATION="global"

echo "Configured Project ID        : $PROJECT_ID"
echo "Knowledge Catalog Region     : $REGION"
echo "Gemini Endpoint Location     : $GEMINI_LOCATION"
echo "Target Cloud Storage Bucket  : $BUCKET_NAME"
Включите API и установите зависимости.
Включите необходимые API Google Cloud и установите зависимости Python ( google-genai , google-cloud-dataplex , pydantic и pandas ) из requirements.txt :
gcloud services enable \
  dataplex.googleapis.com \
  storage.googleapis.com \
  aiplatform.googleapis.com \
  --quiet
python3 -m pip install --upgrade --quiet --user --break-system-packages -r requirements.txt
3. Определите пидантические схемы и шаблоны аспектов.
schemas.py определяет два взаимодополняющих контракта, которые связывают клиентскую проверку Pydantic с серверными шаблонами AspectType для каталога знаний :
-
DarkDataExtractedMetadata: Операционные атрибуты, извлеченные из PDF-файла (заголовок документа, онтология предметной области, уровень опасности для безопасности, происхождение авторства/версии, краткое содержание и оценка достоверности извлечения). -
DocumentGovernanceMetadata: Коды соответствия нормативным требованиям (UL-153, FCC Part 15, CE-LVD, RoHS), ответственный за управление, политика хранения и строка идентификатора справочной таблицы (lakehouse_cross_ref_table) для связывания руководства в формате PDF с последующими таблицами инвентаризации.
Проверьте файл schemas.py
Во-первых, DarkDataExtractedMetadata использует ограничения Field Pydantic ( ge=0.0, le=1.0 , что означает больше/меньше или равно значению confidence_score ) для ограничения выходных данных JSON платформы Gemini Enterprise Agent Platform :
class DarkDataExtractedMetadata(BaseModel):
    document_title: str = Field(
        description="Official document title or product model name extracted from the PDF manual."
    )
    # ... domain_ontology, operational_hazard_level, author_provenance ...
    version_provenance: str = Field(
        description="Document version, revision code, or publication standard identifier."
    )
    # ... document_summary ...
    confidence_score: float = Field(
        ge=0.0,
        le=1.0,
        description="AI extraction confidence metric between 0.0 and 1.0.",
    )
Во-вторых, extracted_aspect_template точно отражает эти имена полей и сопоставляет типы str и float Python с типами string и double из Knowledge Catalog . Обратите внимание, что контракт protobuf AspectType.MetadataTemplate требует record_fields record_fields уникальный, строго положительный целочисленный index ( 1 до 7 ) — пропуск или дублирование index приводит к ошибке create_aspect_type с кодом 400 INVALID_ARGUMENT :
extracted_aspect_template = {
    "name": "DarkDataExtractedMetadata",
    "type": "record",
    "record_fields": [
        {
            "name": "document_title",
            "type": "string",
            "index": 1,
            "annotations": {"description": "Official document title or product model name."},
        },
        # ... fields 2 through 6 (string) ...
        {
            "name": "confidence_score",
            "type": "double",
            "index": 7,
            # ... annotations ...
        },
    ],
}
Проверьте модуль схемы.
Запустите schemas.py , чтобы проверить конфигурацию вашей среды и скомпилировать обе схемы:
python3 schemas.py
Configured Project ID         : your-project-id
Knowledge Catalog Region      : us-central1
Gemini Endpoint Location      : global
Governed Fileset Storage URI  :
  gs://your-project-id-dark-data-manuals/sop-pdfs/LUM-LIG-DES-8G8J_manual.pdf
Target Fileset Entry ID       : sop-manuals-fileset-lum8g8j
✓ Defined DarkDataExtractedMetadata and DocumentGovernanceMetadata
  Pydantic schemas.
✓ Prepared Knowledge Catalog AspectType metadata templates.
4. Создание пространств имен и пользовательских типов аспектов.
Перед регистрацией записей набора файлов или прикреплением метаданных скрипт step2_provision.py создает три ресурса плоскости управления в каталоге знаний :
-
EntryGroup:dark-data-fileset-group -
EntryType:unstructured-pdf-fileset - Шаблоны
AspectType:dark-data-extracted-metadataиdocument-governance-aspect
Идемпотентное выделение ресурсов в step2_provision.py
Каждый вызов метода создания в step2_provision.py оборачивает длительную операцию ( op.result() ) в блок try / except AlreadyExists чтобы скрипт можно было безопасно повторно запустить без сбоя при наличии существующих ресурсов:
# Provision AspectType 1: dark-data-extracted-metadata
try:
    at1_op = catalog_client.create_aspect_type(
        parent=parent_location,
        aspect_type_id=EXTRACTED_ASPECT_TYPE_ID,
        aspect_type=AspectType(
            name=extracted_aspect_type_name,
            display_name="Dark Data Multimodal Extracted Metadata",
            # ... description ...
            metadata_template=extracted_aspect_template,
        ),
    )
    if hasattr(at1_op, "result"):
        at1_op.result()
    print(f"Created AspectType: {extracted_aspect_type_name}")
except AlreadyExists:
    print(f"AspectType already exists; retrieving live resource: {extracted_aspect_type_name}")

live_extracted_aspect_type = catalog_client.get_aspect_type(name=extracted_aspect_type_name)
После регистрации metadata_template=extracted_aspect_template , Knowledge Catalog обеспечивает соблюдение схемы на уровне API — любой последующий вызов update_entry() , передающий строку в confidence_score ( double ), будет отклонен.
Запустите step2_provision.py
Выполните скрипт инициализации и убедитесь, что пользовательские типы аспектов зарегистрированы в вашем регионе:
python3 step2_provision.py
gcloud dataplex aspect-types list --location=$REGION
Created EntryGroup:
  projects/your-project-id/locations/us-central1/entryGroups/
  dark-data-fileset-group
Created EntryType :
  projects/your-project-id/locations/us-central1/entryTypes/
  unstructured-pdf-fileset
Created AspectType:
  projects/your-project-id/locations/us-central1/aspectTypes/
  dark-data-extracted-metadata
Created AspectType:
  projects/your-project-id/locations/us-central1/aspectTypes/
  document-governance-aspect
✓ All Knowledge Catalog namespaces and AspectType blueprints are active.
5. Зарегистрируйте записи неструктурированных наборов файлов.
Вместо того чтобы загромождать каталог миллионами отдельных указателей на файлы, Knowledge Catalog группирует связанные документы в облачном хранилище ( gs://YOUR_BUCKET/sop-pdfs/*.pdf ) в логические записи наборов файлов — либо посредством автоматического сканирования ( DataScanServiceClient ), либо путем прямой программной регистрации ( CatalogServiceClient.create_entry ).
Как скрипт step3_register_fileset.py сопоставляет хранилище с каталогом
step3_register_fileset.py загружает файл LUM-LIG-DES-8G8J_manual.pdf в gs://${BUCKET_NAME}/sop-pdfs/LUM-LIG-DES-8G8J_manual.pdf и регистрирует управляемую Entry :
fully_qualified_fileset_uri = f"gcs:{BUCKET_NAME}"
fileset_entry_spec = Entry(
    name=fileset_entry_name,
    entry_type=entry_type_resource_name,
    fully_qualified_name=fully_qualified_fileset_uri,
    entry_source=EntrySource(
        resource=VIRTUAL_STORAGE_URI,
        system="Cloud Storage",
        platform="Google Cloud",
        display_name="LUM-LIG-DES-8G8J Unstructured SOP & Technical Manual Fileset",
        # ... description ...
        location=REGION,
    ),
)

create_entry_op = catalog_client.create_entry(
    parent=entry_group_resource_name,
    entry_id=FILESET_ENTRY_ID,
    entry=fileset_entry_spec,
)
Обратите внимание на различные роли двух полей URI в Entry :
-
fully_qualified_name=fully_qualified_fileset_uri(f"gcs:{BUCKET_NAME}"): Использует каноническую схему полного квалифицированного имениgcs:{bucket_name}необходимую для каталога знаний , чтобы сопоставить логическую запись каталога с базовым сегментом облачного хранилища . -
entry_source.resource=VIRTUAL_STORAGE_URI: Сохраняет физический URI объектаgs://проверяемый нижестоящими обработчиками извлечения данных.
Запустите step3_register_fileset.py
python3 step3_register_fileset.py
Created Cloud Storage bucket:
  gs://your-project-id-dark-data-manuals in us-central1
Uploaded unstructured PDF manual to:
  gs://your-project-id-dark-data-manuals/sop-pdfs/LUM-LIG-DES-8G8J_manual.pdf
Registered governed Fileset Entry:
  projects/your-project-id/locations/us-central1/entryGroups/
  dark-data-fileset-group/entries/sop-manuals-fileset-lum8g8j
  -> Fully Qualified Name : gcs:your-project-id-dark-data-manuals
  -> Physical Resource URI:
  gs://your-project-id-dark-data-manuals/sop-pdfs/LUM-LIG-DES-8G8J_manual.pdf
  -> Source System        : Cloud Storage
6. Извлечение метаданных документа с помощью Gemini
step4_extract_metadata.py считывает необработанные байты PDF-файла и вызывает платформу Gemini Enterprise Agent Platform ( genai_client.models.generate_content ), используя два ключевых шаблона:
1. Динамический поиск флагманских моделей.
Вместо того чтобы жестко задавать нестабильные строки версий моделей, скрипт запрашивает genai_client.models.list() и сортирует активных кандидатов по (is_ga_channel, semantic_version_tuple) чтобы выбрать самую новую модель flash доступную в режиме General Availability (GA):
genai_client = genai.Client(
    vertexai=True,
    project=PROJECT_ID,
    location=GEMINI_LOCATION,
)

for model_obj in genai_client.models.list():
    raw_id = (model_obj.name or "").split("/")[-1]
    # Filter to flagship Gemini Flash models (version >= 3.0) and prioritize GA over preview
    ...
    discovered_candidates.append((is_ga_channel, ver_tuple, raw_id))

discovered_candidates.sort(key=lambda item: (item[0], item[1]), reverse=True)
2. Извлечение многомодальных данных с ограничениями схемы ( Part.from_bytes + response_schema )
Передача response_mime_type="application/json" и response_schema=DarkDataExtractedMetadata (с последующим параметром DocumentGovernanceMetadata ) ограничивает декодирование токенов непосредственно схемой JSON Pydantic:
with open(LOCAL_PDF_PATH, "rb") as pdf_file:
    raw_pdf_bytes = pdf_file.read()

extraction_response = genai_client.models.generate_content(
    model=candidate_model,
    contents=[
        types.Part.from_bytes(data=raw_pdf_bytes, mime_type="application/pdf"),
        extraction_prompt,
    ],
    config=types.GenerateContentConfig(
        response_mime_type="application/json",
        response_schema=DarkDataExtractedMetadata,
        temperature=0.1,
    ),
)

extracted_dark_data = json.loads(extraction_response.text)
validated_extraction = DarkDataExtractedMetadata(**extracted_dark_data)
Запустите step4_extract_metadata.py
python3 step4_extract_metadata.py
Dynamically discovered active GA model currency :
  gemini-3.8-flash (version (3, 8))
Loaded unstructured PDF manual at: LUM-LIG-DES-8G8J_manual.pdf
Read unstructured PDF document (1184 bytes).
  Executing multimodal extraction with gemini-3.8-flash...
✓ Multimodal extraction completed using model: gemini-3.8-flash
✓ Governance classification completed using model: gemini-3.8-flash

--- Extracted Multimodal Operational Metadata ---
Extracted Attribute    Multimodal Value
document_title    LUM-LIG-DES-8G8J Contemporary Linen Desk Lamp
domain_ontology    Electrical Hardware & Lighting Systems
operational_hazard_level    MEDIUM
author_provenance    Global Hardware Safety & Lighting Systems Engin
version_provenance    Rev 4.2
document_summary    This document outlines standard operating proce
confidence_score    0.99

--- Extracted Governance & Inventory Cross-Reference Metadata ---
Governance Attribute    Classification Value
compliance_classifications    UL-153 Portable Luminaires, FCC Part 15, CE-LVD
stewardship_owner    Global Hardware Safety & Lighting Systems Engin
retention_policy    10-Year Active Product Lifecycle Archival
lakehouse_cross_ref_table    lakehouse.your-project-id.retail_hardware
governance_status    VERIFIED_PRODUCTION
7. Прикрепите проверенные аспекты к записям каталога.
step5_attach_aspects.py привязывает проверенные JSON-данные ( extracted_metadata.json и governance_metadata.json ) к записи sop-manuals-fileset-lum8g8j с помощью catalog_client.update_entry() .
Изменение хирургического аспекта в файле step5_attach_aspects.py
extracted_aspect_key = f"{PROJECT_ID}.{REGION}.{EXTRACTED_ASPECT_TYPE_ID}"
governance_aspect_key = f"{PROJECT_ID}.{REGION}.{GOVERNANCE_ASPECT_TYPE_ID}"

updated_entry_payload = Entry(
    name=fileset_entry_name,
    entry_type=entry_type_resource_name,
    fully_qualified_name=fully_qualified_fileset_uri,
    aspects={
        extracted_aspect_key: Aspect(
            aspect_type=extracted_aspect_type_name,
            data=extracted_data,
        ),
        governance_aspect_key: Aspect(
            aspect_type=governance_aspect_type_name,
            data=governance_data,
        ),
    },
)

update_op = catalog_client.update_entry(
    request=dataplex_v1.UpdateEntryRequest(
        entry=updated_entry_payload,
        update_mask={"paths": ["aspects"]},
        aspect_keys=[extracted_aspect_key, governance_aspect_key],
    )
)
Передача параметров update_mask={"paths": ["aspects"]} и aspect_keys=[extracted_aspect_key, governance_aspect_key] ограничивает область действия изменения исключительно этими двумя ключами аспектов, оставляя entry_source и любые аспекты, принадлежащие другим командам, без изменений.
Запустите step5_attach_aspects.py
python3 step5_attach_aspects.py
Successfully bound 2 Aspect(s) to Entry:
  projects/your-project-id/locations/us-central1/entryGroups/
  dark-data-fileset-group/entries/sop-manuals-fileset-lum8g8j

=== Live Attached Aspect: document-governance-aspect ===
Catalog Field    Authoritative Stored Value
compliance_classifications    UL-153 Portable Luminaires, FCC Part 15, CE-LVD
stewardship_owner    Global Hardware Safety & Lighting Systems Engin
retention_policy    10-Year Active Product Lifecycle Archival
lakehouse_cross_ref_table    lakehouse.your-project-id.retail_hardware
governance_status    VERIFIED_PRODUCTION

=== Live Attached Aspect: dark-data-extracted-metadata ===
Catalog Field    Authoritative Stored Value
document_title    LUM-LIG-DES-8G8J Contemporary Linen Desk Lamp
domain_ontology    Electrical Hardware & Lighting Systems
operational_hazard_level    MEDIUM
author_provenance    Global Hardware Safety & Lighting Systems Engin
version_provenance    Rev 4.2
document_summary    This document outlines standard operating proce
confidence_score    0.99
Двухдорожечная проверка
- Дорожка 1 (проверка через CLI): Проверьте запись со всеми прикрепленными аспектами с помощью
gcloud:gcloud dataplex entries describe sop-manuals-fileset-lum8g8j \ --entry-group=dark-data-fileset-group \ --location=$REGION \ --view=ALL - Дорожка 2 (Проверка пользовательского интерфейса консоли):
- Откройте консоль поиска в каталоге знаний , найдите набор неструктурированных файлов стандартных операционных процедур и технических руководств LUM-LIG-DES-8G8J (
sop-manuals-fileset-lum8g8j) и выберите соответствующую запись из результатов. - В разделе «Дополнительные теги и аспекты» убедитесь, что как в параметре «Извлеченные метаданные Dark Data Multimodal» , так и в параметре «Перекрестные ссылки в управлении документами и инвентаризации» отображаются извлеченный уровень опасности (
MEDIUM), коды соответствия (UL-153, FCC Part 15, CE-LVD, RoHS) и строка таблицы перекрестных ссылок (lakehouse_cross_ref_table).
- Откройте консоль поиска в каталоге знаний , найдите набор неструктурированных файлов стандартных операционных процедур и технических руководств LUM-LIG-DES-8G8J (
8. Запрос к управляемым скрытым данным в каталоге.
После добавления пользовательских параметров неструктурированные PDF-руководства в облачном хранилище становятся доступными для поиска через каталог знаний ( catalog_client.search_entries() ).
Опрос search_entries() в файле step6_search_catalog.py
Файл step6_search_catalog.py опрашивает search_entries() с экспоненциальной задержкой и считывает канонизированные ключи аспектов с помощью .endswith() :
search_query = f"entrygroup={entry_group_resource_name} name:{FILESET_ENTRY_ID}"

while elapsed_seconds < max_wait_seconds:
    catalog_search_results = list(
        catalog_client.search_entries(
            request=dataplex_v1.SearchEntriesRequest(
                name=parent_location,
                query=search_query,
            )
        )
    )
    if catalog_search_results:
        break
    backoff_seconds = min(5 * (2 ** attempt), 30)
    time.sleep(backoff_seconds)
    ...

for k, asp in detailed_entry.aspects.items():
    if k.endswith(f".{REGION}.{EXTRACTED_ASPECT_TYPE_ID}"):
        print(f"    Domain Ontology     : {asp.data.get('domain_ontology')}")
        print(f"    Hazard Level        : {asp.data.get('operational_hazard_level')}")
    elif k.endswith(f".{REGION}.{GOVERNANCE_ASPECT_TYPE_ID}"):
        print(f"    Compliance Codes    : {asp.data.get('compliance_classifications')}")
        print(f"    Lakehouse Join Table: {asp.data.get('lakehouse_cross_ref_table')}")
Запустите step6_search_catalog.py
python3 step6_search_catalog.py
Executing Knowledge Catalog search query:
  'entrygroup=projects/your-project-id/locations/us-central1/entryGroups/
  dark-data-fileset-group name:sop-manuals-fileset-lum8g8j'...

✓ Discovered 1 governed asset(s) in Knowledge Catalog:

[1] Entry Resource Name :
    projects/your-project-id/locations/us-central1/entryGroups/
    dark-data-fileset-group/entries/sop-manuals-fileset-lum8g8j
    Fully Qualified Name: gcs:your-project-id-dark-data-manuals
    Entry Type :
    projects/your-project-id/locations/us-central1/entryTypes/
    unstructured-pdf-fileset
    Physical Storage URI:
    gs://your-project-id-dark-data-manuals/sop-pdfs/LUM-LIG-DES-8G8J_manual.pdf
    Domain Ontology     : Electrical Hardware & Lighting Systems
    Hazard Level        : MEDIUM
    Compliance Codes    : UL-153 Portable Luminaires, FCC Part 15, CE-LVD, RoHS
    Lakehouse Join Table:
    lakehouse.your-project-id.retail_hardware.luminaire_sku_inventory_iceberg
Двухдорожечная проверка
- Трек 1 (Поиск через командную строку): Прямой запрос к поисковому индексу с помощью
gcloud:gcloud dataplex entries search "name:sop-manuals-fileset-lum8g8j" --project=$PROJECT_ID - Трек 2 (Поиск на естественном языке в пользовательском интерфейсе консоли):
- Откройте консоль поиска по каталогу знаний и выполните поиск по запросу
LUM-LIG-DES-8G8JилиUL-153. - Обратите внимание, как в каталоге знаний отображается запись о наборе PDF-файлов, хранящихся в облачном хранилище , и связанные с ней метаданные.
- Откройте консоль поиска по каталогу знаний и выполните поиск по запросу
9. Проверка сквозных утверждений управления.
step7_verify_assertions.py выполняет детерминированные проверки утверждений на основе ответов управляющего уровня каталога знаний в реальном времени, чтобы убедиться в успешном выполнении EntryGroup , EntryType , обоих пользовательских шаблонов AspectType , связанных данных аспектов EntryView.ALL (границы confidence_score и строка lakehouse_cross_ref_table ) и обнаружении поискового индекса:
verify_eg = catalog_client.get_entry_group(name=entry_group_resource_name)
assert verify_eg.name == entry_group_resource_name, "EntryGroup resource name mismatch."

verify_entry = catalog_client.get_entry(
    request=dataplex_v1.GetEntryRequest(
        name=fileset_entry_name,
        view=dataplex_v1.EntryView.ALL,
    )
)
bound_extracted = next(
    (
        asp for k, asp in verify_entry.aspects.items()
        if k.endswith(f".{REGION}.{EXTRACTED_ASPECT_TYPE_ID}")
    ),
    None,
)
bound_governance = next(
    (
        asp for k, asp in verify_entry.aspects.items()
        if k.endswith(f".{REGION}.{GOVERNANCE_ASPECT_TYPE_ID}")
    ),
    None,
)

assert bound_extracted is not None, f"Aspect '{EXTRACTED_ASPECT_TYPE_ID}' not found on live Entry."
assert bound_governance is not None, (
    f"Aspect '{GOVERNANCE_ASPECT_TYPE_ID}' not found on live Entry."
)
assert (
    bound_extracted.data.get("document_title") == expected_extraction["document_title"]
), "Extracted title mismatch."
assert (
    0.0 <= float(bound_extracted.data.get("confidence_score", -1.0)) <= 1.0
), "Invalid confidence score in catalog."
assert (
    "lakehouse" in str(bound_governance.data.get("lakehouse_cross_ref_table", "")).lower()
), "Missing Lakehouse cross-reference."
...
assert len(search_results) >= 1, "Expected at least 1 search result in Knowledge Catalog."
Запустите step7_verify_assertions.py
python3 step7_verify_assertions.py && echo "Verification exit code: $?"
Running substantive end-to-end verification assertions...
✓ All 5 substantive verification assertions passed
  against live Google Cloud control plane state!
Verification exit code: 0
10. Разработайте конвейер обработки событий.
Хотя интерактивное выполнение скриптов Python в Cloud Shell идеально подходит для создания и тестирования договоров управления, в корпоративных средах ежедневно поступают тысячи новых или пересмотренных PDF-руководств по проектированию, сертификатов соответствия поставщиков и документов SOP из ERP-систем, систем управления жизненным циклом продукта (PLM) и порталов поставщиков. Ручное выполнение пакетных скриптов быстро создает «слепые зоны» в управлении между загрузкой документов и индексированием каталога.
В производственной среде команды платформы внедряют в эксплуатацию именно тот код, который вы запускали на шагах 4 и 5, в виде автоматизированного конвейера, управляемого событиями:
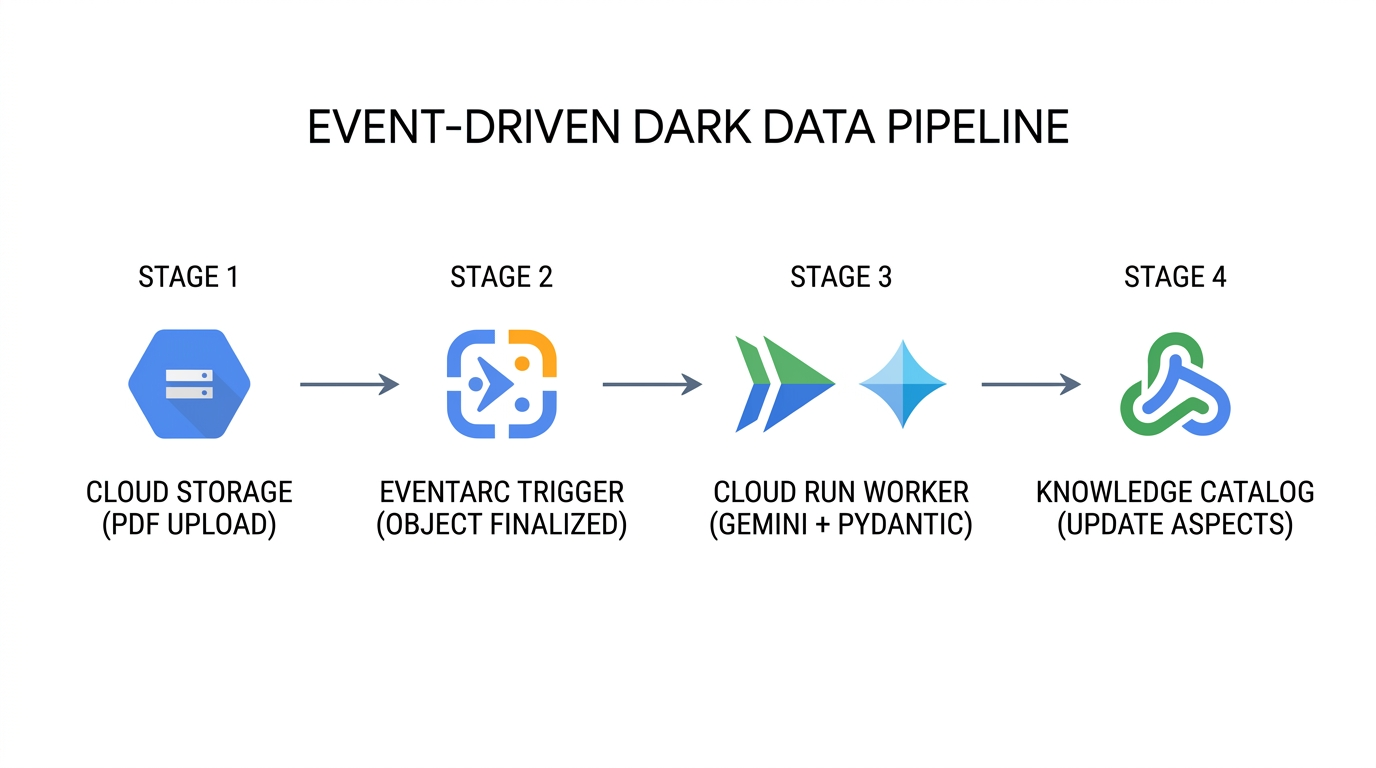
- Непрерывная загрузка документов (
Cloud Storage→Eventarc) : При каждой загрузке нового PDF-руководства или при перезаписывании существующего объекта в Cloud Storage новой версией, хранилище генерирует событие CloudEventgoogle.cloud.storage.object.v1.finalizedсодержащее идентификатор хранилища, путь к объекту и номер поколения объекта. - Извлечение многомодальных данных без сохранения состояния (
Eventarc→Cloud Run→Gemini Enterprise Agent Platform) : Eventarc направляет событие CloudEvent на бессерверный рабочий процесс Cloud Run, упаковывающий файлыschemas.py,step4_extract_metadata.pyиstep5_attach_aspects.py. Рабочий процесс передает байты PDF-файла на платформу Gemini Enterprise Agent Platform с принудительно включеннойresponse_schema, гарантируя, что каждый извлеченный атрибут соответствует метаданнымDarkDataExtractedMetadataиDocumentGovernanceMetadata. - Обновление плоскости управления хирургическим процессом (
Cloud Run→Knowledge Catalog) : Рабочий процесс определяет родительскуюEntryфайлов и выполняетcatalog_client.update_entry()сupdate_mask={"paths": ["aspects"]}и явно заданнымиaspect_keys. Даже если десятки документов обрабатываются одновременно, каждое изменение обновляет только указанные в нем ключи аспектов. - Карантин для ответственных за обработку данных с ограничением по уровню достоверности : если отсканированный PDF-файл имеет
confidence_scoreизвлечения ниже вашего операционного порога (например,< 0.85), обработчик устанавливает для прикрепленного аспектаgovernance_status = "PENDING_STEWARD_REVIEW", чтобы ответственные за обработку данных могли запрашивать у каталога знаний информацию о ресурсах с низким уровнем достоверности, требующих проверки человеком.
Как предприятия применяют эту модель в производстве
Пример использования в масштабах предприятия | Как работает концепция «метаданные как код» на практике | Влияние на бизнес и операционную деятельность |
Автоматизированные проверки соответствия нормативным требованиям и готовность к отзыву продукции | Системы обеспечения соответствия требованиям объединяют неструктурированные PDF-файлы, содержащие информацию о безопасности ( | При обновлении таких стандартов, как |
Наземные ИИ-агенты и предварительная фильтрация RAG | Прежде чем агент генерации с расширенными возможностями поиска (RAG) на платформе Gemini Enterprise Agent Platform ответит на вопрос инженера на месте, он фильтрует записи в Каталоге знаний по параметрам | Предотвращает появление у ИИ-помощников галлюцинаций или цитирование устаревших инженерных чертежей, просроченных стандартных операционных процедур или непроверенных руководств сторонних разработчиков. |
Многокомандное одновременное обогащение | Несколько независимых конвейеров обрабатывают одну и ту же | Поскольку |
Эволюция схемы CI/CD с помощью GitOps | Команды разработчиков платформы хранят | Устраняет расхождение в схеме между кодом извлечения данных из приложения и плоскостью управления каталога знаний в проектах |
11. Очистка окружающей среды
В Knowledge Catalog родительские контейнеры и шаблоны схем нельзя удалить, если дочерние записи по-прежнему ссылаются на них. cleanup.py удаляет ресурсы в строгом обратном порядке зависимостей ( Entry → EntryGroup → EntryType → AspectTypes → Объекты корзины Cloud Storage → временные JSON-файлы):
# 1. Delete Fileset Entry first
catalog_client.delete_entry(name=target_entry_path)

# 2. Delete EntryGroup container
del_eg_op = catalog_client.delete_entry_group(name=target_eg_path)
if hasattr(del_eg_op, "result"):
    del_eg_op.result()

# 3. Delete EntryType and Custom AspectTypes
del_et_op = catalog_client.delete_entry_type(name=target_et_path)
if hasattr(del_et_op, "result"):
    del_et_op.result()
for aspect_id_val in (EXTRACTED_ASPECT_TYPE_ID, GOVERNANCE_ASPECT_TYPE_ID):
    target_at_path = f"{active_parent}/aspectTypes/{aspect_id_val}"
    del_at_op = catalog_client.delete_aspect_type(name=target_at_path)
    if hasattr(del_at_op, "result"):
        del_at_op.result()
Запустите cleanup.py
python3 cleanup.py
Starting reverse-dependency resource cleanup in Knowledge Catalog...
Deleted Fileset Entry:
  projects/your-project-id/locations/us-central1/entryGroups/
  dark-data-fileset-group/entries/sop-manuals-fileset-lum8g8j
Deleted EntryGroup   :
  projects/your-project-id/locations/us-central1/entryGroups/
  dark-data-fileset-group
Deleted EntryType    :
  projects/your-project-id/locations/us-central1/entryTypes/
  unstructured-pdf-fileset
Deleted AspectType   :
  projects/your-project-id/locations/us-central1/aspectTypes/
  dark-data-extracted-metadata
Deleted AspectType   :
  projects/your-project-id/locations/us-central1/aspectTypes/
  document-governance-aspect
Deleted Cloud Storage object :
  gs://your-project-id-dark-data-manuals/sop-pdfs/LUM-LIG-DES-8G8J_manual.pdf
Deleted Cloud Storage bucket : gs://your-project-id-dark-data-manuals
Removed local temporary file : extracted_metadata.json
Removed local temporary file : governance_metadata.json
✓ Standalone teardown complete. Environment cleanly reset.
Удалите клонированную директорию репозитория.
После того, как cleanup.py завершит удаление облачных ресурсов, вернитесь в свою домашнюю директорию и удалите клонированную папку репозитория devrel-demos из Cloud Shell:
cd ~
rm -rf ~/devrel-demos
12. Поздравляем!
Вы разработали и проверили сквозной конвейер управления метаданными как кодом , который преобразует неструктурированные PDF-файлы в облачном хранилище в доступные для поиска и соответствующие схеме ресурсы каталога знаний с использованием платформы Gemini Enterprise Agent Platform .
Что дальше?
- Автоматизация с помощью Terraform : декларативное управление ресурсами
google_dataplex_aspect_typeиgoogle_dataplex_entry_groupв конвейерах CI/CD. - Развертывание Eventarc + Cloud Run Workers : контейнеризация
step4_extract_metadata.pyиstep5_attach_aspects.pyв управляемый событиями сервис Cloud Run . - Объединение данных о товарах в BigQuery : Экспорт извлеченных метаданных управления (
lakehouse_cross_ref_table) для объединения атрибутов соответствия неструктурированных документов со структурированными таблицами инвентаризации SKU.