

1. نظرة عامة
في هذا الدرس التطبيقي حول الترميز، ستنشئ وكيل علوم بيانات يستعلم عن بيانات حقيقية من مجموعات البيانات العامة في BigQuery ويتذكّر إعداداتك المفضّلة في جميع الجلسات. بعد ذلك، ستنشره على Agent Runtime، وهي خدمة مُدارة بالكامل من Google Cloud تتولّى البنية الأساسية وتوسيع النطاق وإدارة الجلسات.
يستخدم الوكيل ثلاث قدرات أساسية يتم تفعيلها تدريجيًا:
- مجموعة أدوات BigQuery: يستكشف الوكيل المخططات وينفّذ طلبات SQL على مجموعات بيانات BigQuery الحقيقية، ويعمل ذلك محليًا وعند النشر.
- مخزن الذاكرة: عند نشر الوكيل، يتذكّر الإعدادات المفضّلة للمستخدم والسياق في الجلسات غير المتصلة.
- إمكانية المراقبة: تسجّل Cloud Trace خطوات الاستدلال التي يتّخذها الوكيل، واستدعاءات الأدوات، وأوقات الاستجابة من خلال أداة OpenTelemetry.
أهداف الدورة التعليمية
- كيفية إنشاء وكيل ADK باستخدام
BigQueryToolsetللوصول إلى البيانات الحقيقية - كيفية ضبط "بنك الذاكرة" للاحتفاظ بالبيانات بين الجلسات
- كيفية نشر وكيلك في بيئة تشغيل الوكيل باستخدام
adk deploy - كيفية منح أذونات "إدارة الهوية وإمكانية الوصول" لحساب خدمة الوكيل الذي تم نشره
- كيفية اختبار استمرار الذاكرة وإمكانية مراقبتها
المتطلبات
- مشروع Google Cloud تم تفعيل الفوترة فيه
- متصفّح ويب، مثل Chrome
- إذا كنت ستشغّل الرمز البرمجي على جهازك الخاص بدلاً من Cloud Shell: حزمة تطوير البرامج (SDK) من Google Cloud (
gcloudCLI) وuv (مدير حِزم Python) وPython 3.12+ (يتم تثبيتها تلقائيًا بواسطةuvإذا لزم الأمر)
ADK (Agent Development Kit) هو إطار عمل من Google لإنشاء وكلاء الذكاء الاصطناعي. يستخدم هذا الدرس التطبيقي حول الترميز حزمة تطوير الوكلاء (ADK) لإنشاء وكيل وتفعيله في Agent Runtime.
هذا الدرس التطبيقي حول الترميز مخصّص للمطوّرين المتوسطي الخبرة الذين لديهم بعض المعرفة بلغة Python وGoogle Cloud.
يستغرق إكمال هذا الدرس التطبيقي حول الترميز حوالي 35 دقيقة (بما في ذلك 5 إلى 10 دقائق للتفعيل).
يجب أن تكون تكلفة الموارد التي تم إنشاؤها في هذا الدرس التطبيقي حول الترميز أقل من 5 دولارات أمريكية.
2. إعداد البيئة
إنشاء مشروع على Google Cloud
- في Google Cloud Console، في صفحة اختيار المشروع، اختَر مشروعًا على السحابة الإلكترونية أو أنشِئ مشروعًا على السحابة الإلكترونية.
- تأكَّد من تفعيل الفوترة لمشروعك على السحابة الإلكترونية. كيفية التحقّق مما إذا كانت الفوترة مفعَّلة في مشروع
ضبط مشروعك
افتح محرِّر Cloud Shell في مشروع GCP الذي أنشأته.
بعد ذلك، أنشئ "وحدة طرفية" > "وحدة طرفية جديدة"، ونفِّذ الأمر التالي لضبط مشروعك. تقرأ الأوامر اللاحقة رقم تعريف المشروع من هذا الإعداد.
gcloud config set project <INSERT_YOUR_GCP_PROJECT_HERE>
تفعيل واجهات برمجة التطبيقات
نفِّذ الأمر التالي في الوحدة الطرفية.
gcloud services enable \
  aiplatform.googleapis.com \
  bigquery.googleapis.com \
  telemetry.googleapis.com \
  --project=$(gcloud config get project)
-
aiplatform.googleapis.com: يستضيف وكيلك على Agent Runtime، بما في ذلك جلسات Gemini Enterprise و"بنك الذاكرة"، ويعرض نموذج Gemini - واجهة برمجة التطبيقات BigQuery API (
bigquery.googleapis.com): طلبات بحث SQL على مجموعات البيانات العامة والخاصة - Telemetry API (
telemetry.googleapis.com): عمليات تتبُّع OpenTelemetry لإمكانية تتبّع بيانات الوكيل
تثبيت "حزمة تطوير Android"
في الوحدة الطرفية، شغِّل الأوامر التالية لإنشاء مجلد لهذا الدرس التطبيقي حول الترميز وتثبيت ADK والبرامج التابعة له:
mkdir -p ~/adk-deploy-scale
cd ~/adk-deploy-scale
uv init --bare
uv add google-adk google-auth google-cloud-bigquery "google-cloud-aiplatform[agent_engines]"
تنشئ uv بيئة Python معزولة لهذا الدرس التطبيقي حول الترميز، لذا لن تحتاج إلى تفعيل أي شيء. ابدأ أوامر Python بالرمز uv run.
تتضمّن حزمة google-adk أداة سطر الأوامر adk التي ستستخدمها لاختبار الوكيل ونشره. تستخدم adk deploy google-cloud-aiplatform لإنشاء وكيلك على Agent Runtime، وgoogle-cloud-bigquery هي مكتبة العميل التي تستند إليها أدوات BigQuery في ADK.
3- إنشاء الوكيل
في المجلد ~/adk-deploy-scale، أنشئ دليل الوكيل. نفِّذ جميع الأوامر اللاحقة من ~/adk-deploy-scale (العنصر الأصل لـ data_science_agent/):
mkdir data_science_agent
بعد ذلك، نفِّذ الأمر التالي لإنشاء data_science_agent/.env مع مشروعك والمنطقة التي ستنشر فيها الوكيل وإعدادات الوكيل الذي تم نشره. يقرأ adk deploy هذا الملف، لذا تظل هذه الإعدادات تعمل إذا فتحت نافذة طرفية جديدة.
cat > ~/adk-deploy-scale/data_science_agent/.env <<EOF
GOOGLE_CLOUD_PROJECT=$(gcloud config get project)
GOOGLE_CLOUD_LOCATION=us-central1
GOOGLE_GENAI_USE_ENTERPRISE=True
OTEL_INSTRUMENTATION_GENAI_CAPTURE_MESSAGE_CONTENT=true
EOF
-
GOOGLE_CLOUD_PROJECTوGOOGLE_CLOUD_LOCATION: رقم تعريف مشروعك (يتم ملؤه منgcloud) والمنطقة التي يعمل فيها الوكيل -
GOOGLE_GENAI_USE_ENTERPRISE: أجرى مكالمة ADK مع Gemini من خلال مشروعك على Google Cloud -
OTEL_INSTRUMENTATION_GENAI_CAPTURE_MESSAGE_CONTENT: يسجّل هذا الخيار جميع مدخلات الطلبات وردود الوكيل، ما يجعله مفيدًا لتصحيح الأخطاء.
ستبدو بنية الدليل النهائية على النحو التالي:
adk-deploy-scale/
  data_science_agent/
    .env
    __init__.py
    agent.py
    requirements.txt    # created in the Deploy step
ستنشئ __init__.py وagent.py الآن، ثم ستضيف requirements.txt في خطوة "النشر".
أنشئ الملف data_science_agent/__init__.py — هذا الملف مطلوب حتى تتمكّن حزمة ADK من العثور على الوكيل وتحميله:
from . import agent # noqa: F401 — required by `adk eval` and `adk web`
إنشاء data_science_agent/agent.py:
يربط هذا الوكيل بـ BigQuery لاستخراج البيانات ويحتفظ بالجلسات في Memory Bank.
يتم تفعيل ميزة "الذاكرة" تلقائيًا عند نشرها. يضبط Agent Runtime متغيّر البيئة GOOGLE_CLOUD_AGENT_ENGINE_ID، الذي لا يكون متوفّرًا عند التشغيل على الجهاز.
from __future__ import annotations

import os

from google.adk.agents import LlmAgent
from google.adk.agents.callback_context import CallbackContext
from google.adk.apps import App
from google.adk.integrations.bigquery import BigQueryCredentialsConfig
from google.adk.integrations.bigquery import BigQueryToolset
from google.adk.models import Gemini
from google.adk.tools.preload_memory_tool import PreloadMemoryTool
from google.genai import types
import google.auth

PROJECT_ID = os.getenv("GOOGLE_CLOUD_PROJECT")
if not PROJECT_ID:
    raise ValueError(
        "GOOGLE_CLOUD_PROJECT environment variable is required. "
        "Add it to data_science_agent/.env: GOOGLE_CLOUD_PROJECT=<your-project-id>"
    )

credentials, _ = google.auth.default()
bq_toolset = BigQueryToolset(credentials_config=BigQueryCredentialsConfig(credentials=credentials))

# GOOGLE_CLOUD_AGENT_ENGINE_ID is set automatically by Agent Runtime.
agent_engine_id = os.getenv("GOOGLE_CLOUD_AGENT_ENGINE_ID")


async def _save_memory(callback_context: CallbackContext) -> None:
    """Persist the session to Memory Bank after each agent run.

    Only activates on Agent Runtime, where Memory Bank is available.
    """
    if agent_engine_id:
        await callback_context.add_session_to_memory()


root_agent = LlmAgent(
    name="data_science_agent",
    model=Gemini(
        model="gemini-3.8-flash",
        # gemini-3.8-flash is served from the global endpoint. The agent
        # itself runs in GOOGLE_CLOUD_LOCATION (us-central1).
        client_kwargs={"location": "global"},
        retry_options=types.HttpRetryOptions(attempts=5),
    ),
    instruction=(
        "You are an expert Data Science Agent. "
        "Your goal is to query enterprise BigQuery datasets, analyze the data, "
        "and summarize your findings. "
        f"When executing SQL queries, use project_id `{PROJECT_ID}` as the "
        "billing project unless the user specifies a different one. "
        "Present results clearly with formatted numbers. "
        "Remember user preferences like preferred regions, date ranges, "
        "or analysis formats across conversations."
    ),
    tools=[bq_toolset, PreloadMemoryTool()],
    after_agent_callback=_save_memory,
)

app = App(
    name="data_science_agent",
    root_agent=root_agent,
)
لنتعرّف على ما يفعله هذا الرمز:
- تمنح BigQueryToolset البوت أدوات مثل
execute_sqlوlist_table_idsوget_table_info، ويمكنها استكشاف المخططات والاستعلام عن أي مجموعة بيانات يمكن للمتصل الوصول إليها. - تسترجع أداة PreloadMemoryTool تلقائيًا الذكريات ذات الصلة قبل كل طلب من نموذج اللغة الكبير، وذلك من خلال البحث في "بنك الذكريات" عن المحتوى المرتبط برسالة المستخدم. تحتفظ دالة
_save_memoryبالجلَسة في "بنك الذاكرة" بعد كل عملية تنفيذ للوكيل، ما يتيح للوكيل استرجاع السياق في الجلسات المستقبلية. - التطبيق يغلّف الوكيل الأساسي في تطبيق قابل للنشر يمكن أن تقدّمه بيئة تشغيل الوكيل. يجب أن يتطابق
nameمع اسم الدليل (data_science_agent)، إذ يستخدمadk webهذا الاسم للعثور على الوكيل وتحميله. - تطلب التعليمات من الوكيل استخدام مشروع الفوترة لاستعلامات SQL وتذكُّر الإعدادات المفضّلة للمستخدم.
- يُرسِل Gemini مع
client_kwargs={"location": "global"}طلبات النموذج إلى نقطة النهاية العالمية حيث يتوفّرgemini-3.8-flash. يتم تشغيل الوكيل نفسه فيus-central1: يضبطadk deployقيمةGOOGLE_CLOUD_LOCATIONعلى الوكيل الذي تم نشره في المنطقة التي تنشر فيها، وبالتالي يتم ضبط الموقع الجغرافي للنموذج في الرمز بدلاً من ذلك.
4. النشر في بيئة تشغيل الوكيل
أنشئ ملف requirements.txt في الدليل data_science_agent:
google-adk
google-genai
google-auth
google-cloud-bigquery
python-dotenv
opentelemetry-instrumentation-google-genai
opentelemetry-instrumentation-httpx
opentelemetry-instrumentation-grpc
-
google-adkوgoogle-genai: حزمة تطوير التطبيقات (ADK) وبرنامج Gemini google-auth: مصادقة Google Cloudgoogle-cloud-bigquery: مكتبة برامج BigQuery التي تستخدمهاBigQueryToolsetلا يثبّت "حزمة تطوير التطبيقات" هذه الميزة تلقائيًا.python-dotenv: لتحميل الملف.envعند بدء التشغيل- تتيح حِزم
opentelemetry-instrumentation-*الثلاث ميزات إمكانية تتبّع البيانات التي ستستكشفها لاحقًا. تتضمّن هذه الأدوات عمليات استدعاء نموذج Gemini وعمليات التواصل الداخلية باستخدام gRPC/HTTP، وذلك لكي تظهر عمليات التتبُّع في علامة التبويب عمليات التتبُّع الخاصة بالوكيل.
يقرأ adk deploy أيضًا ملف data_science_agent/.env الذي أنشأته سابقًا ويضبط إعداداته على الوكيل الذي تم نشره.
نشر الوكيل الوسيطة الأخيرة data_science_agent هي الدليل الذي يحتوي على رمز البرنامج:
uv run adk deploy agent_engine \
  --project=$(gcloud config get project) \
  --region=us-central1 \
  --display_name="Data Science Agent" \
  --otel_to_cloud \
  data_science_agent
بالقرب من البداية، يعرض الناتج سطرَين أصفرَين، Ignoring GOOGLE_CLOUD_PROJECT in .env ... وIgnoring GOOGLE_CLOUD_LOCATION in .env .... وهي متوقّعة، لأنّ العلامتَين --project و--region لهما الأولوية على القيم نفسها في .env.
علم | الغرض |
| مشروع ومنطقة Google Cloud المستهدَفة |
| الاسم الذي يمكن قراءته والذي يظهر في Cloud Console |
| تصدير عمليات التتبُّع والسجلات في OpenTelemetry إلى Google Cloud وتفعيل القياس عن بُعد ( |
عند النشر في Agent Runtime، يتم تفعيل ميزتَين تلقائيًا:
- بنك الذاكرة: يربط
adk deployالوكيل بالجلسات وبنك الذاكرة في مثيل بيئة تشغيل الوكيل. يقرأPreloadMemoryToolمن "بنك الذاكرة" ويحفظ_save_memoryالجلسات تلقائيًا. - إمكانية المراقبة: تسجّل Cloud Trace خطوات الاستدلال التي يتّخذها الوكيل، واستدعاءات الأدوات، وأوقات الاستجابة.
5- منح أذونات BigQuery
عليك منح BigQuery إذن الوصول إلى وكيل خدمة Agent Runtime (وكيل خدمة "محرك الاستدلال في AI Platform"). عند نشر الوكيل، يتم تشغيله كحساب خدمة تديره Google (وليس بيانات الاعتماد الشخصية)، لذا يحتاج إلى أذونات صريحة لتنفيذ طلبات بحث SQL.
PROJECT_NUMBER=$(gcloud projects describe $(gcloud config get project) \
  --format='value(projectNumber)')

SA="service-${PROJECT_NUMBER}@gcp-sa-aiplatform-re.iam.gserviceaccount.com"

# Required to execute SQL queries
gcloud projects add-iam-policy-binding $(gcloud config get project) \
  --member="serviceAccount:${SA}" \
  --role="roles/bigquery.jobUser"

# Required to read table metadata and data
gcloud projects add-iam-policy-binding $(gcloud config get project) \
  --member="serviceAccount:${SA}" \
  --role="roles/bigquery.dataViewer"
يعرض كل أمر Updated IAM policy for project [...] عند تنفيذه بنجاح.
6. اختبار الوكيل الذي تم نشره
افتح صفحة عمليات النشر في Google Cloud Console. انقر على الوكيل الذي تم نشره، ثمّ انقر على علامة التبويب ساحة التجربة.
اختبِر إمكانات BigQuery:
- "أدرِج الجداول في bigquery-public-data.hacker_news"
- النتيجة المتوقّعة: يستدعي الوكيل
list_table_idsويعرض أسماء الجداول التي تتضمّنfull.
- النتيجة المتوقّعة: يستدعي الوكيل
- "العثور على عدد المشاركات في كل عام في bigquery-public-data.hacker_news.full"
- المتوقّع: يستدعي الوكيل الدالة
execute_sqlمع طلب SQL ويعرض جدولاً يتضمّن السنوات وعدد المشاركات.
- المتوقّع: يستدعي الوكيل الدالة
- "ما هي النسبة المئوية للتغيير في المشاركات مقارنةً بالعام السابق؟"
- المتوقّع: يستدعي الوكيل
execute_sqlباستخدام استعلام SQL يحسب النسبة المئوية للتغيير ويعرض النتائج.
- المتوقّع: يستدعي الوكيل
7. اختبار استمرار الذاكرة
في Playground، علِّم الوكيل إحدى الإعدادات المفضّلة:
- "تذكَّر أنّ مجموعة البيانات المفضّلة لديّ هي bigquery-public-data.hacker_news"
- "ما هي الجداول التي يتضمّنها؟"
انتظِر بضع ثوانٍ حتى يتم حفظ الذاكرة (يتم تنفيذ معاودة الاتصال _save_memory بعد أن يستجيب الوكيل).
الآن، ابدأ جلسة جديدة من خلال النقر على جلسة جديدة في Playground، ثم اطرح السؤال التالي:
- "ما هي مجموعة البيانات المفضّلة لديّ؟"
على الوكيل تذكُّر bigquery-public-data.hacker_news على الرغم من أنّ هذه جلسة جديدة تمامًا بدون سجلّ محادثات. تنجح هذه الطريقة للأسباب التالية:
- تحفظ
_save_memoryكل جلسة في "بنك الذاكرة" من خلالcallback_context.add_session_to_memory() - يسترجع
PreloadMemoryToolالذكريات ذات الصلة قبل كل طلب يتم إرساله إلى النموذج اللغوي الكبير - تطابق "مستودع الذكريات" المحتوى دلاليًا، وليس فقط من خلال الكلمات الرئيسية
8. استكشاف إمكانية تتبُّع البيانات
في Cloud Console، انتقِل إلى الوكيل الذي تم نشره وانقر على علامة التبويب عمليات التتبُّع.
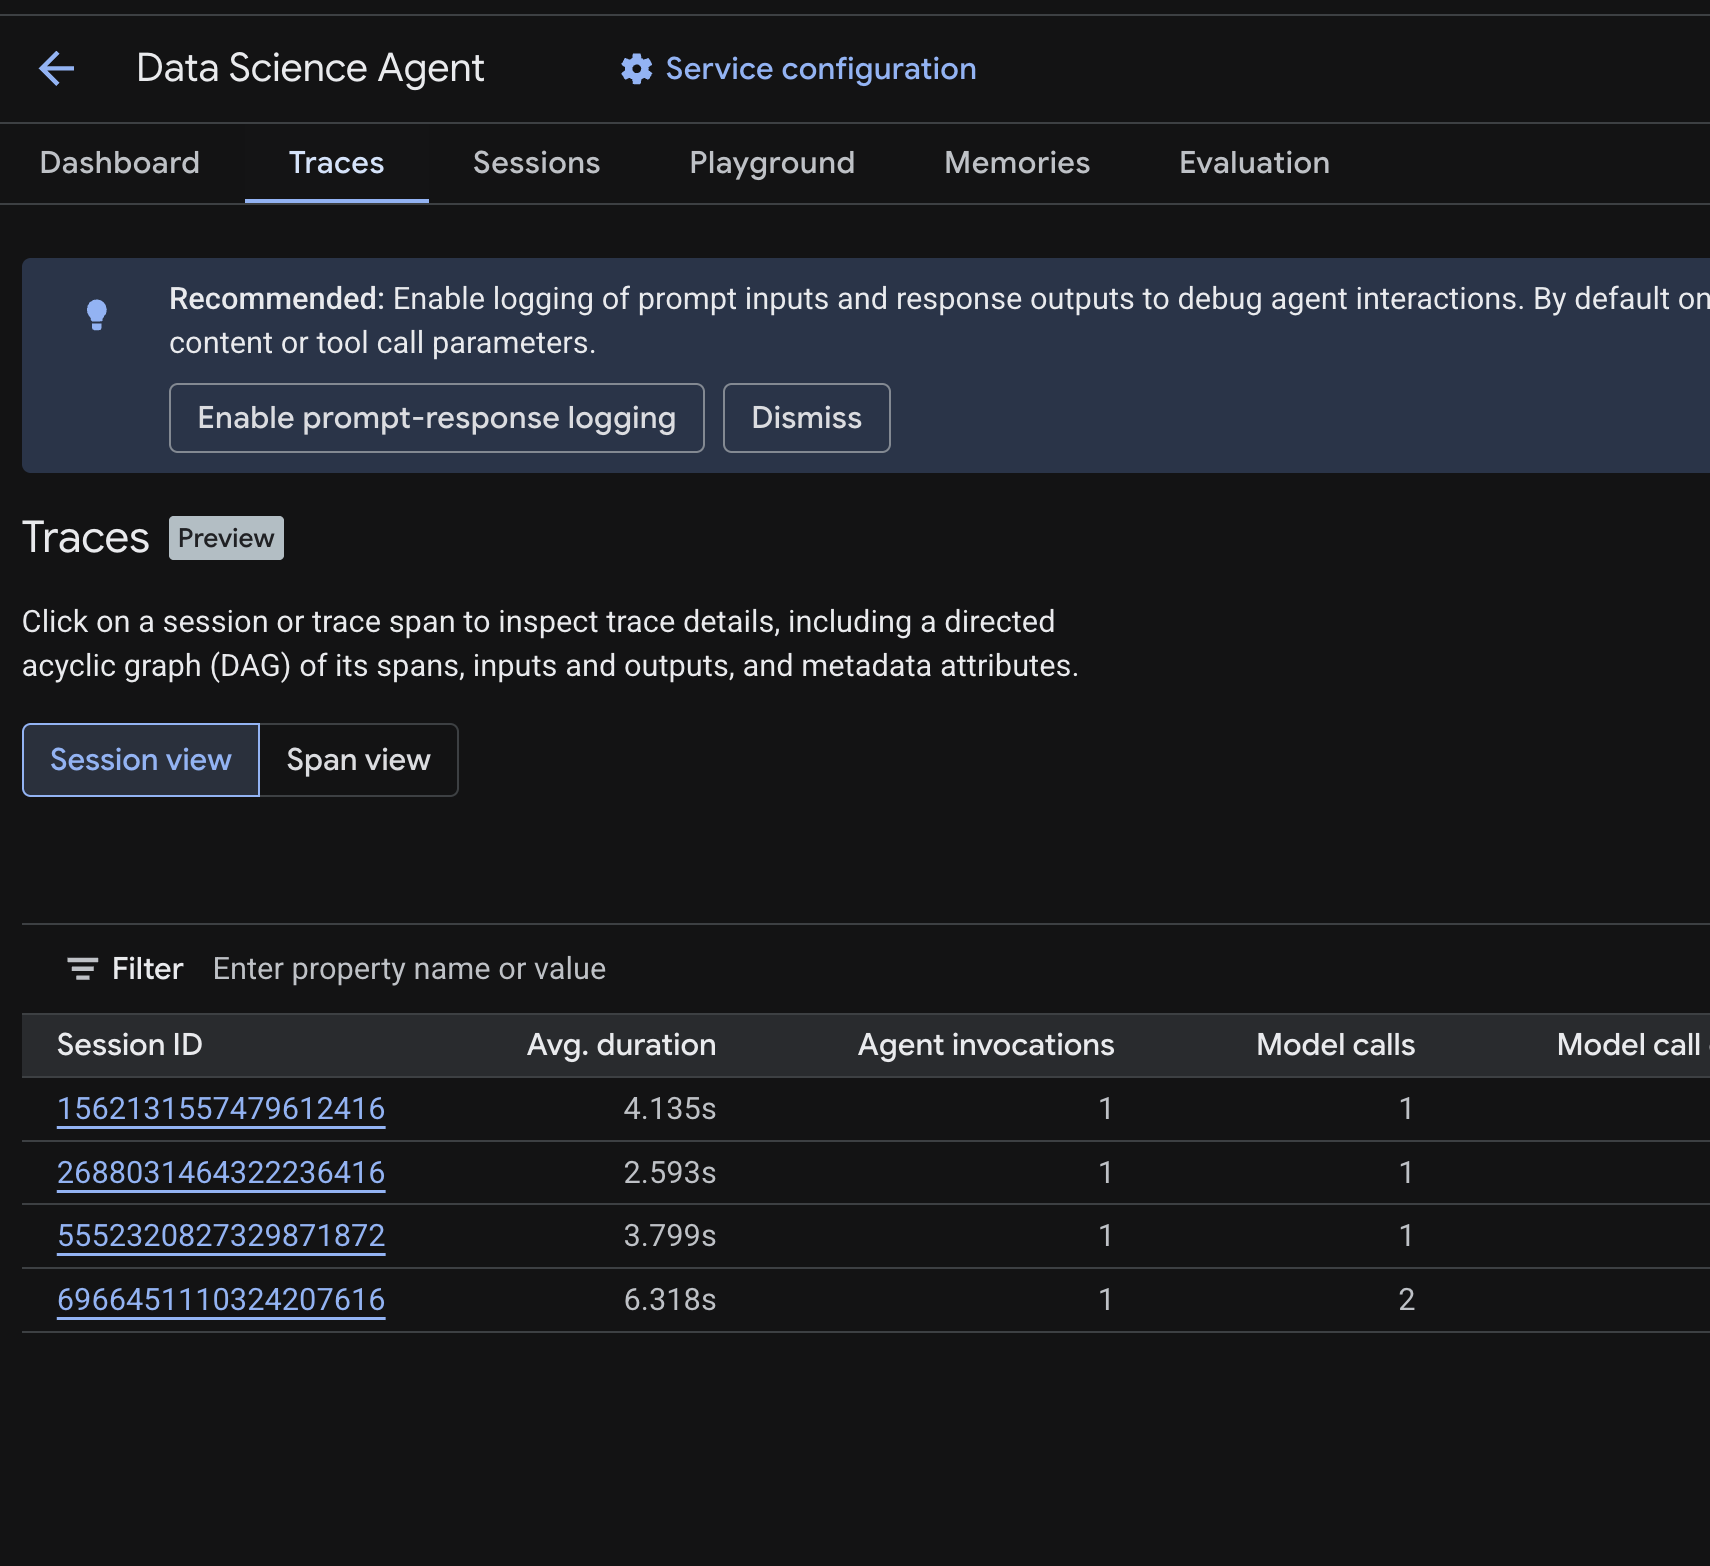
من المفترض أن يظهر جدول الجلسات الذي يسرد الجلسات من طلبات البحث الاختبارية التي نفّذتها في الخطوات السابقة. يعرض الجدول مقاييس ملخّصة لكل جلسة، مثل متوسّط المدة وطلبات النماذج وطلبات الأدوات واستخدام الرموز وأي أخطاء.
انقر على جلسة لفحص تفاصيل التتبُّع، بما في ذلك:
- رسم بياني موجّه غير دوري (DAG) لنطاقاته، يعرض تفصيلاً خطوة بخطوة لمنطق الوكيل وعمليات استدعاء الأدوات (طلبات بحث BigQuery) وأوقات الاستجابة
- المدخلات والمخرجات لكل فترة (يتم تفعيلها من خلال متغير البيئة
OTEL_INSTRUMENTATION_GENAI_CAPTURE_MESSAGE_CONTENTفي.env) - سمات البيانات الوصفية، مثل أرقام تعريف الامتداد وأرقام تعريف التتبُّع والتوقيت
يمكنك أيضًا التبديل إلى طريقة العرض الممتدة (التبديل في أعلى الصفحة) للاطّلاع على فترات فردية في جميع الجلسات.
طريقة عمل ميزة "تتبُّع الموقع الجغرافي"
عند النشر باستخدام --otel_to_cloud، تنشئ adk deploy حاوية تشغّل خادم ADK API مع تفعيل OpenTelemetry. في "بيئة تشغيل الوكيل"، يبدأ الخادم مسار OpenTelemetry الذي:
- إنشاء TracerProvider باستخدام أداة تصدير OTLP التي ترسل النطاقات إلى
telemetry.googleapis.com - تسجّل حزمة تطوير البرامج (SDK) الخاصة بـ ADK النطاقات الخاصة بعمليات تشغيل الوكيل واستدعاءات النماذج واستدعاءات الأدوات، وتستخدم حِزم الأدوات الثلاث من
requirements.txtلإضافة نطاقات من المكتبات الرئيسية (Gemini وhttpx وgRPC). - يتم إرسال مجموعات ونطاقات التصدير إلى Telemetry API، حيث تقرأها علامة التبويب "عمليات التتبُّع".
يحتوي الحاوية التي تم نشرها على حزمة تطوير التطبيقات (ADK) وحزمة تطوير البرامج (SDK) وبرنامج التصدير OpenTelemetry، ولكن لا يحتوي على حِزم الأدوات. لهذا السبب، تعرض قائمة requirements.txt جميع هذه الأذونات الثلاثة. وبدونها، يسجّل خادم واجهة برمجة التطبيقات ADK تحذيرًا ويتخطّى هذه الفترات.
تحديد المشاكل وحلّها
إذا لم تظهر أي آثار بعد بضع دقائق:
- التأكّد من تفعيل Telemetry API: تم تفعيلها في خطوة الإعداد. إجراء عملية التحقّق باستخدام:
gcloud services list --enabled --project=$(gcloud config get project) | grep telemetry - التحقّق من Cloud Logging بحثًا عن تحذيرات: انتقِل إلى Logging > مستكشف السجلّات وابحث عن
"proceeding without"أو"GoogleGenAiSdkInstrumentor". يعني التحذير الذي يذكر أداة قياس (الذكاء الاصطناعي التوليدي أو HTTPX أو gRPC) أنّ حزمةopentelemetry-instrumentation-*المطابقة غير متوفّرة فيrequirements.txt. - لا تُضِف
google-cloud-aiplatformإلىrequirements.txt. تضيفadk deployهذه السمة تلقائيًا، وقد يؤدي تعريفها بنفسك إلى حدوث تعارضات في حزمة OpenTelemetry وتعطيل عملية القياس بدون إشعار.
9. تنظيف
لتجنُّب تحصيل رسوم مستمرة، احذف الموارد التي تم إنشاؤها أثناء هذا الدرس التطبيقي حول الترميز.
احذف الوكيل الذي تم نشره من صفحة عمليات النشر في Cloud Console. اختَر الوكيل وانقر على حذف.
إذا أنشأت مشروعًا خصيصًا لهذا الدرس التطبيقي حول الترميز، يمكنك حذف المشروع بأكمله بدلاً من ذلك:
gcloud projects delete <YOUR_PROJECT_ID>
اختياريًا، يمكنك تنظيف بيئتك المحلية:
cd ~
rm -rf ~/adk-deploy-scale
10. تهانينا
لقد أنشأت وكيل علم بيانات مزوّدًا بحالة ونشرته في Agent Runtime.
ما تعلّمته
- كيفية إنشاء وكيل ADK باستخدام
BigQueryToolsetللوصول إلى البيانات الحقيقية - كيفية تفعيل الذاكرة الدائمة باستخدام Memory Bank من خلال
PreloadMemoryToolوafter_agent_callback - كيفية منح أذونات "إدارة الهوية وإمكانية الوصول" لحساب خدمة الوكيل الذي تم نشره
- كيفية النشر في Agent Runtime وتفعيل إمكانية المراقبة باستخدام Cloud Trace
الخطوات التالية
- طلب البحث في مجموعات بيانات BigQuery الخاصة بك من خلال منح وكيل خدمة Agent Runtime إذن الوصول إلى بياناتك
- إضافة تنفيذ الرمز لتشغيل تحليل Python في وضع حماية آمن
- إعداد لوحات بيانات إمكانية تتبّع بيانات Cloud Trace لمراقبة وكيلك في مرحلة الإنتاج
- نشر النتائج على Google Workspace باستخدام أدوات MCP