

1. סקירה כללית
בשיעור ה-Codelab הזה תיצרו סוכן מדעי נתונים שמריץ שאילתות על נתונים אמיתיים ממערכי נתונים ציבוריים של BigQuery וזוכר את ההעדפות שלכם בין סשנים. לאחר מכן פורסים אותו ב-Agent Runtime, שירות מנוהל לחלוטין של Google Cloud שמטפל בתשתית, בהתאמת קנה מידה ובניהול סשנים.
הסוכן משתמש בשלוש יכולות ליבה שמופעלות בהדרגה:
- ערכת הכלים של BigQuery: הסוכן בודק סכימות ומריץ שאילתות SQL על מערכי נתונים אמיתיים של BigQuery – הפעולה הזו מתבצעת באופן מקומי וגם כשהסוכן נפרס.
- מאגר זיכרון: כשהסוכן נפרס, הוא זוכר את העדפות המשתמש וההקשר בין סשנים לא רציפים.
- ניראות (observability): Cloud Trace מתעד את שלבי החשיבה הרציונלית של הסוכן, את הקריאות לכלים ואת זמני האחזור באמצעות OpenTelemetry.
מה תלמדו
- איך יוצרים סוכן ADK באמצעות
BigQueryToolsetלגישה לנתונים אמיתיים - איך מגדירים את Memory Bank כך שהנתונים יישמרו בין סשנים
- איך פורסים את הסוכן ל-Agent Runtime באמצעות
adk deploy - איך מעניקים הרשאות IAM לחשבון השירות של הסוכן שנפרס
- איך בודקים את עמידות הזיכרון ואת יכולת הצפייה
הדרישות
- פרויקט ב-Google Cloud שהחיוב בו מופעל
- דפדפן אינטרנט כמו Chrome
- אם מריצים את הקוד במחשב במקום ב-Cloud Shell: Google Cloud SDK (
gcloudCLI), uv (מנהל חבילות Python) ו-Python 3.12 ומעלה (מותקן אוטומטית על ידיuvאם צריך)
הערכה לפיתוח סוכנים (ADK) היא המסגרת של Google ליצירת סוכני AI. ב-Codelab הזה נשתמש ב-ADK כדי ליצור סוכן ולפרוס אותו ב-Agent Runtime.
שיעור ה-Codelab הזה מיועד למפתחים ברמת ביניים שיש להם היכרות מסוימת עם Python ו-Google Cloud.
השלמת ה-codelab הזה נמשכת כ-35 דקות (כולל 5-10 דקות לפריסה).
העלות של המשאבים שנוצרו ב-codelab הזה צריכה להיות פחות מ-5$.
2. הגדרת הסביבה
יצירת פרויקט ב-Google Cloud
- במסוף Google Cloud, בדף לבחירת הפרויקט, בוחרים פרויקט ב-Google Cloud או יוצרים פרויקט.
- הקפידו לוודא שהחיוב מופעל בפרויקט שלכם ב-Cloud. כך בודקים אם החיוב מופעל בפרויקט
הגדרת הפרויקט
פותחים את Cloud Shell Editor בפרויקט GCP שיצרתם.
אחר כך יוצרים טרמינל חדש (Terminal > New Terminal) ומריצים את הפקודה הבאה כדי להגדיר את הפרויקט. פקודות מאוחרות יותר קוראות את מזהה הפרויקט מההגדרה הזו.
gcloud config set project <INSERT_YOUR_GCP_PROJECT_HERE>
הפעלת ממשקי ה-API
במסוף, מריצים את הפקודה הבאה.
gcloud services enable \
  aiplatform.googleapis.com \
  bigquery.googleapis.com \
  telemetry.googleapis.com \
  --project=$(gcloud config get project)
-
aiplatform.googleapis.com: מארח את הסוכן ב-Agent Runtime, כולל סשנים של Gemini Enterprise ו-Memory Bank, ומשרת את מודל Gemini - BigQuery API (
bigquery.googleapis.com): שאילתות SQL במערכי נתונים ציבוריים ופרטיים - Telemetry API (
telemetry.googleapis.com): עקבות OpenTelemetry לצורך יכולת צפייה בסוכן
התקנה של ADK
בטרמינל, מריצים את הפקודות הבאות כדי ליצור תיקייה לשיעור ה-Codelab הזה ולהתקין את ADK ואת יחסי התלות שלו:
mkdir -p ~/adk-deploy-scale
cd ~/adk-deploy-scale
uv init --bare
uv add google-adk google-auth google-cloud-bigquery "google-cloud-aiplatform[agent_engines]"
uv יוצר סביבת Python מבודדת ל-Codelab הזה, כך שלא צריך להפעיל שום דבר. מוסיפים את הקידומת uv run לפקודות Python.
חבילת google-adk כוללת את כלי ה-CLI adk שבו תשתמשו כדי לבדוק ולפרוס את הסוכן. adk deploy משתמש ב-google-cloud-aiplatform כדי ליצור את הסוכן שלכם ב-Agent Runtime, ו-google-cloud-bigquery היא ספריית הלקוח שמאחורי כלי BigQuery של ADK.
3. יצירת הסוכן
בתיקייה ~/adk-deploy-scale, יוצרים את ספריית הסוכן. מריצים את כל הפקודות הבאות מ-~/adk-deploy-scale (הספרייה הראשית של data_science_agent/):
mkdir data_science_agent
לאחר מכן מריצים את הפקודה הבאה כדי ליצור את data_science_agent/.env עם הפרויקט, האזור שבו תפרסו את הסוכן וההגדרות של הסוכן שנפרס. adk deploy קורא את הקובץ הזה, כך שההגדרות האלה עדיין פועלות אם פותחים טרמינל חדש.
cat > ~/adk-deploy-scale/data_science_agent/.env <<EOF
GOOGLE_CLOUD_PROJECT=$(gcloud config get project)
GOOGLE_CLOUD_LOCATION=us-central1
GOOGLE_GENAI_USE_ENTERPRISE=True
OTEL_INSTRUMENTATION_GENAI_CAPTURE_MESSAGE_CONTENT=true
EOF
-
GOOGLE_CLOUD_PROJECTו-GOOGLE_CLOUD_LOCATION: מזהה הפרויקט (ממולא מ-gcloud) והאזור שבו הסוכן פועל -
GOOGLE_GENAI_USE_ENTERPRISE: קורא ל-Gemini דרך הפרויקט שלכם ב-Google Cloud -
OTEL_INSTRUMENTATION_GENAI_CAPTURE_MESSAGE_CONTENT: מתעד את כל הקלט של ההנחיות ואת התגובות של הסוכן, שימושי לניפוי באגים
מבנה הספריות הסופי ייראה כך:
adk-deploy-scale/
  data_science_agent/
    .env
    __init__.py
    agent.py
    requirements.txt    # created in the Deploy step
תצטרכו ליצור את __init__.py ואת agent.py עכשיו, ואז להוסיף את requirements.txt בשלב הפריסה.
יוצרים את הקובץ data_science_agent/__init__.py – הקובץ הזה נדרש כדי שה-ADK יוכל לגלות ולטעון את הסוכן:
from . import agent # noqa: F401 — required by `adk eval` and `adk web`
יצירת data_science_agent/agent.py:
הסוכן הזה מתחבר ל-BigQuery כדי לחלץ נתונים, ושומר את הסשנים ב-Memory Bank.
הזיכרון מופעל אוטומטית כשפורסים אותו. Agent Runtime מגדיר את משתנה הסביבה GOOGLE_CLOUD_AGENT_ENGINE_ID, שלא קיים כשמריצים באופן מקומי.
from __future__ import annotations

import os

from google.adk.agents import LlmAgent
from google.adk.agents.callback_context import CallbackContext
from google.adk.apps import App
from google.adk.integrations.bigquery import BigQueryCredentialsConfig
from google.adk.integrations.bigquery import BigQueryToolset
from google.adk.models import Gemini
from google.adk.tools.preload_memory_tool import PreloadMemoryTool
from google.genai import types
import google.auth

PROJECT_ID = os.getenv("GOOGLE_CLOUD_PROJECT")
if not PROJECT_ID:
    raise ValueError(
        "GOOGLE_CLOUD_PROJECT environment variable is required. "
        "Add it to data_science_agent/.env: GOOGLE_CLOUD_PROJECT=<your-project-id>"
    )

credentials, _ = google.auth.default()
bq_toolset = BigQueryToolset(credentials_config=BigQueryCredentialsConfig(credentials=credentials))

# GOOGLE_CLOUD_AGENT_ENGINE_ID is set automatically by Agent Runtime.
agent_engine_id = os.getenv("GOOGLE_CLOUD_AGENT_ENGINE_ID")


async def _save_memory(callback_context: CallbackContext) -> None:
    """Persist the session to Memory Bank after each agent run.

    Only activates on Agent Runtime, where Memory Bank is available.
    """
    if agent_engine_id:
        await callback_context.add_session_to_memory()


root_agent = LlmAgent(
    name="data_science_agent",
    model=Gemini(
        model="gemini-3.8-flash",
        # gemini-3.8-flash is served from the global endpoint. The agent
        # itself runs in GOOGLE_CLOUD_LOCATION (us-central1).
        client_kwargs={"location": "global"},
        retry_options=types.HttpRetryOptions(attempts=5),
    ),
    instruction=(
        "You are an expert Data Science Agent. "
        "Your goal is to query enterprise BigQuery datasets, analyze the data, "
        "and summarize your findings. "
        f"When executing SQL queries, use project_id `{PROJECT_ID}` as the "
        "billing project unless the user specifies a different one. "
        "Present results clearly with formatted numbers. "
        "Remember user preferences like preferred regions, date ranges, "
        "or analysis formats across conversations."
    ),
    tools=[bq_toolset, PreloadMemoryTool()],
    after_agent_callback=_save_memory,
)

app = App(
    name="data_science_agent",
    root_agent=root_agent,
)
בואו נסביר מה הקוד הזה עושה:
- BigQueryToolset מספק לסוכן כלים כמו
execute_sql,list_table_idsו-get_table_info– הוא יכול לבדוק סכימות ולהריץ שאילתות על כל מערך נתונים שלמתקשר יש גישה אליו. - PreloadMemoryTool מאחזר באופן אוטומטי זיכרונות רלוונטיים לפני כל קריאה ל-LLM, על ידי חיפוש ב-Memory Bank תוכן שקשור להודעה של המשתמש. התקשרות חזרה של
_save_memoryשומרת את הסשן ב-Memory Bank אחרי כל הפעלה של הסוכן, כדי שהסוכן יוכל לשחזר את ההקשר בסשנים עתידיים. - האפליקציה עוטפת את סוכן הבסיס באפליקציה שניתן לפרוס, ו-Agent Runtime יכולה להפעיל אותה. הערך של
nameצריך להיות זהה לשם הספרייה (data_science_agent) – מערכתadk webמשתמשת בערך הזה כדי לאתר ולטעון את הסוכן. - ההוראה אומרת לסוכן להשתמש בפרויקט החיוב לשאילתות SQL ולזכור את העדפות המשתמש.
- Gemini עם
client_kwargs={"location": "global"}שולח קריאות למודל לנקודת הקצה הגלובלית, שבהgemini-3.8-flashזמין. הסוכן עצמו פועל ב-us-central1:adk deployמגדיר אתGOOGLE_CLOUD_LOCATIONבסוכן שנפרס לאזור שבו אתם פורסים, כך שהמיקום של המודל מוגדר בקוד במקום זאת.
4. פריסה ל-Agent Runtime
יוצרים קובץ requirements.txt בספרייה data_science_agent:
google-adk
google-genai
google-auth
google-cloud-bigquery
python-dotenv
opentelemetry-instrumentation-google-genai
opentelemetry-instrumentation-httpx
opentelemetry-instrumentation-grpc
-
google-adkו-google-genai: ADK ולקוח Gemini -
google-auth: אימות ב-Google Cloud -
google-cloud-bigquery: ספריית הלקוח של BigQuery שבה נעשה שימוש ב-BigQueryToolset. ה-ADK לא מתקין אותו כברירת מחדל. -
python-dotenv: טוען את הקובץ.envבהפעלה - שלוש חבילות
opentelemetry-instrumentation-*מאפשרות את תכונות ה-Observability שנסקור בהמשך. הם מבצעים אינסטרומנטציה של קריאות למודל Gemini ותקשורת פנימית של gRPC/HTTP, כך שהעקבות מופיעים בכרטיסייה Traces של הסוכן.
adk deploy גם קורא את הקובץ data_science_agent/.env שיצרתם קודם ומגדיר את ההגדרות שלו בסוכן שנפרס.
פורסים את הסוכן. הארגומנט האחרון data_science_agent הוא הספרייה שמכילה את קוד הסוכן:
uv run adk deploy agent_engine \
  --project=$(gcloud config get project) \
  --region=us-central1 \
  --display_name="Data Science Agent" \
  --otel_to_cloud \
  data_science_agent
קרוב להתחלה, בפלט מופיעים שני קווים צהובים, Ignoring GOOGLE_CLOUD_PROJECT in .env ... ו-Ignoring GOOGLE_CLOUD_LOCATION in .env .... הן צפויות: הדגלים --project ו---region מקבלים עדיפות על פני אותם ערכים ב-.env.
דגל | מטרה |
| פרויקט ואזור יעד ב-Google Cloud |
| שם שקריא לאנשים ומוצג ב-Cloud Console |
| מייצא עקבות ויומנים של OpenTelemetry ל-Google Cloud ומפעיל טלמטריה ( |
כשפורסים את התוסף ל-Agent Runtime, שתי יכולות מופעלות באופן אוטומטי:
- Memory Bank:
adk deployמחבר את הסוכן לסשנים ול-Memory Bank במופע Agent Runtime שלו. PreloadMemoryToolקורא מ-Memory Bank ו_save_memoryשומר את ההפעלות באופן אוטומטי. - ניראות (observability): Cloud Trace מתעד את שלבי הנימוק של הסוכן, את הקריאות לכלים ואת זמני האחזור.
5. מתן הרשאות ב-BigQuery
צריך להעניק ל-BigQuery גישה לסוכן של שירות Agent Runtime (הסוכן של שירות מנוע ההסקה של AI Platform). בזמן הפריסה, הסוכן פועל כחשבון שירות בניהול Google (ולא באמצעות פרטי הכניסה האישיים שלכם), ולכן הוא צריך הרשאות מפורשות כדי להריץ שאילתות SQL.
PROJECT_NUMBER=$(gcloud projects describe $(gcloud config get project) \
  --format='value(projectNumber)')

SA="service-${PROJECT_NUMBER}@gcp-sa-aiplatform-re.iam.gserviceaccount.com"

# Required to execute SQL queries
gcloud projects add-iam-policy-binding $(gcloud config get project) \
  --member="serviceAccount:${SA}" \
  --role="roles/bigquery.jobUser"

# Required to read table metadata and data
gcloud projects add-iam-policy-binding $(gcloud config get project) \
  --member="serviceAccount:${SA}" \
  --role="roles/bigquery.dataViewer"
כל פקודה מדפיסה Updated IAM policy for project [...] אם היא מצליחה.
6. בדיקת הסוכן הפעיל
פותחים את הדף Deployments במסוף Google Cloud. לוחצים על הסוכן שהופעל ואז על הכרטיסייה Playground (סביבת ניסויים).
בודקים את היכולות של BigQuery:
- "List the tables in bigquery-public-data.hacker_news"
- מה שקורה בפועל: הסוכן מתקשר אל
list_table_idsומחזיר שמות של טבלאות, כוללfull.
- מה שקורה בפועל: הסוכן מתקשר אל
- "Find the number of posts per year in bigquery-public-data.hacker_news.full"
- מה שקורה בפועל: הסוכן מתקשר עם
execute_sqlבאמצעות שאילתת SQL ומחזיר טבלה עם השנים ומספר הפוסטים.
- מה שקורה בפועל: הסוכן מתקשר עם
- "מה היה אחוז השינוי במספר הפוסטים בהשוואה לשנה שעברה?"
- מה צפוי: הסוכן קורא לפונקציה
execute_sqlעם שאילתת SQL שמחשבת את השינוי באחוזים ומחזירה את התוצאות.
- מה צפוי: הסוכן קורא לפונקציה
7. בדיקת שימור הזיכרון
עדיין במגרש המשחקים, מלמדים את הנציג העדפה:
- "Remember that my favorite dataset is bigquery-public-data.hacker_news" (תזכור שמערך הנתונים המועדף עליי הוא bigquery-public-data.hacker_news)
- "What tables does it have?"
ממתינים כמה שניות עד שהזיכרון יישמר (הקריאה החוזרת _save_memory מופעלת אחרי שהסוכן מגיב).
עכשיו מתחילים סשן חדש על ידי לחיצה על סשן חדש ב-Playground, ואז שואלים:
- "What is my favorite dataset?"
הסוכן צריך לזכור את bigquery-public-data.hacker_news למרות שזה סשן חדש לגמרי ללא היסטוריית שיחות. השיטה הזו עובדת כי:
-
_save_memoryשומר כל סשן ב-Memory Bank באמצעותcallback_context.add_session_to_memory() -
PreloadMemoryToolמאחזר זיכרונות רלוונטיים לפני כל קריאה ל-LLM - Memory Bank מתאים תוכן סמנטית, לא רק לפי מילות מפתח
8. מידע נוסף על ניראות (observability)
ב-Cloud Console, עוברים לסוכן שפרסתם ולוחצים על הכרטיסייה Traces.
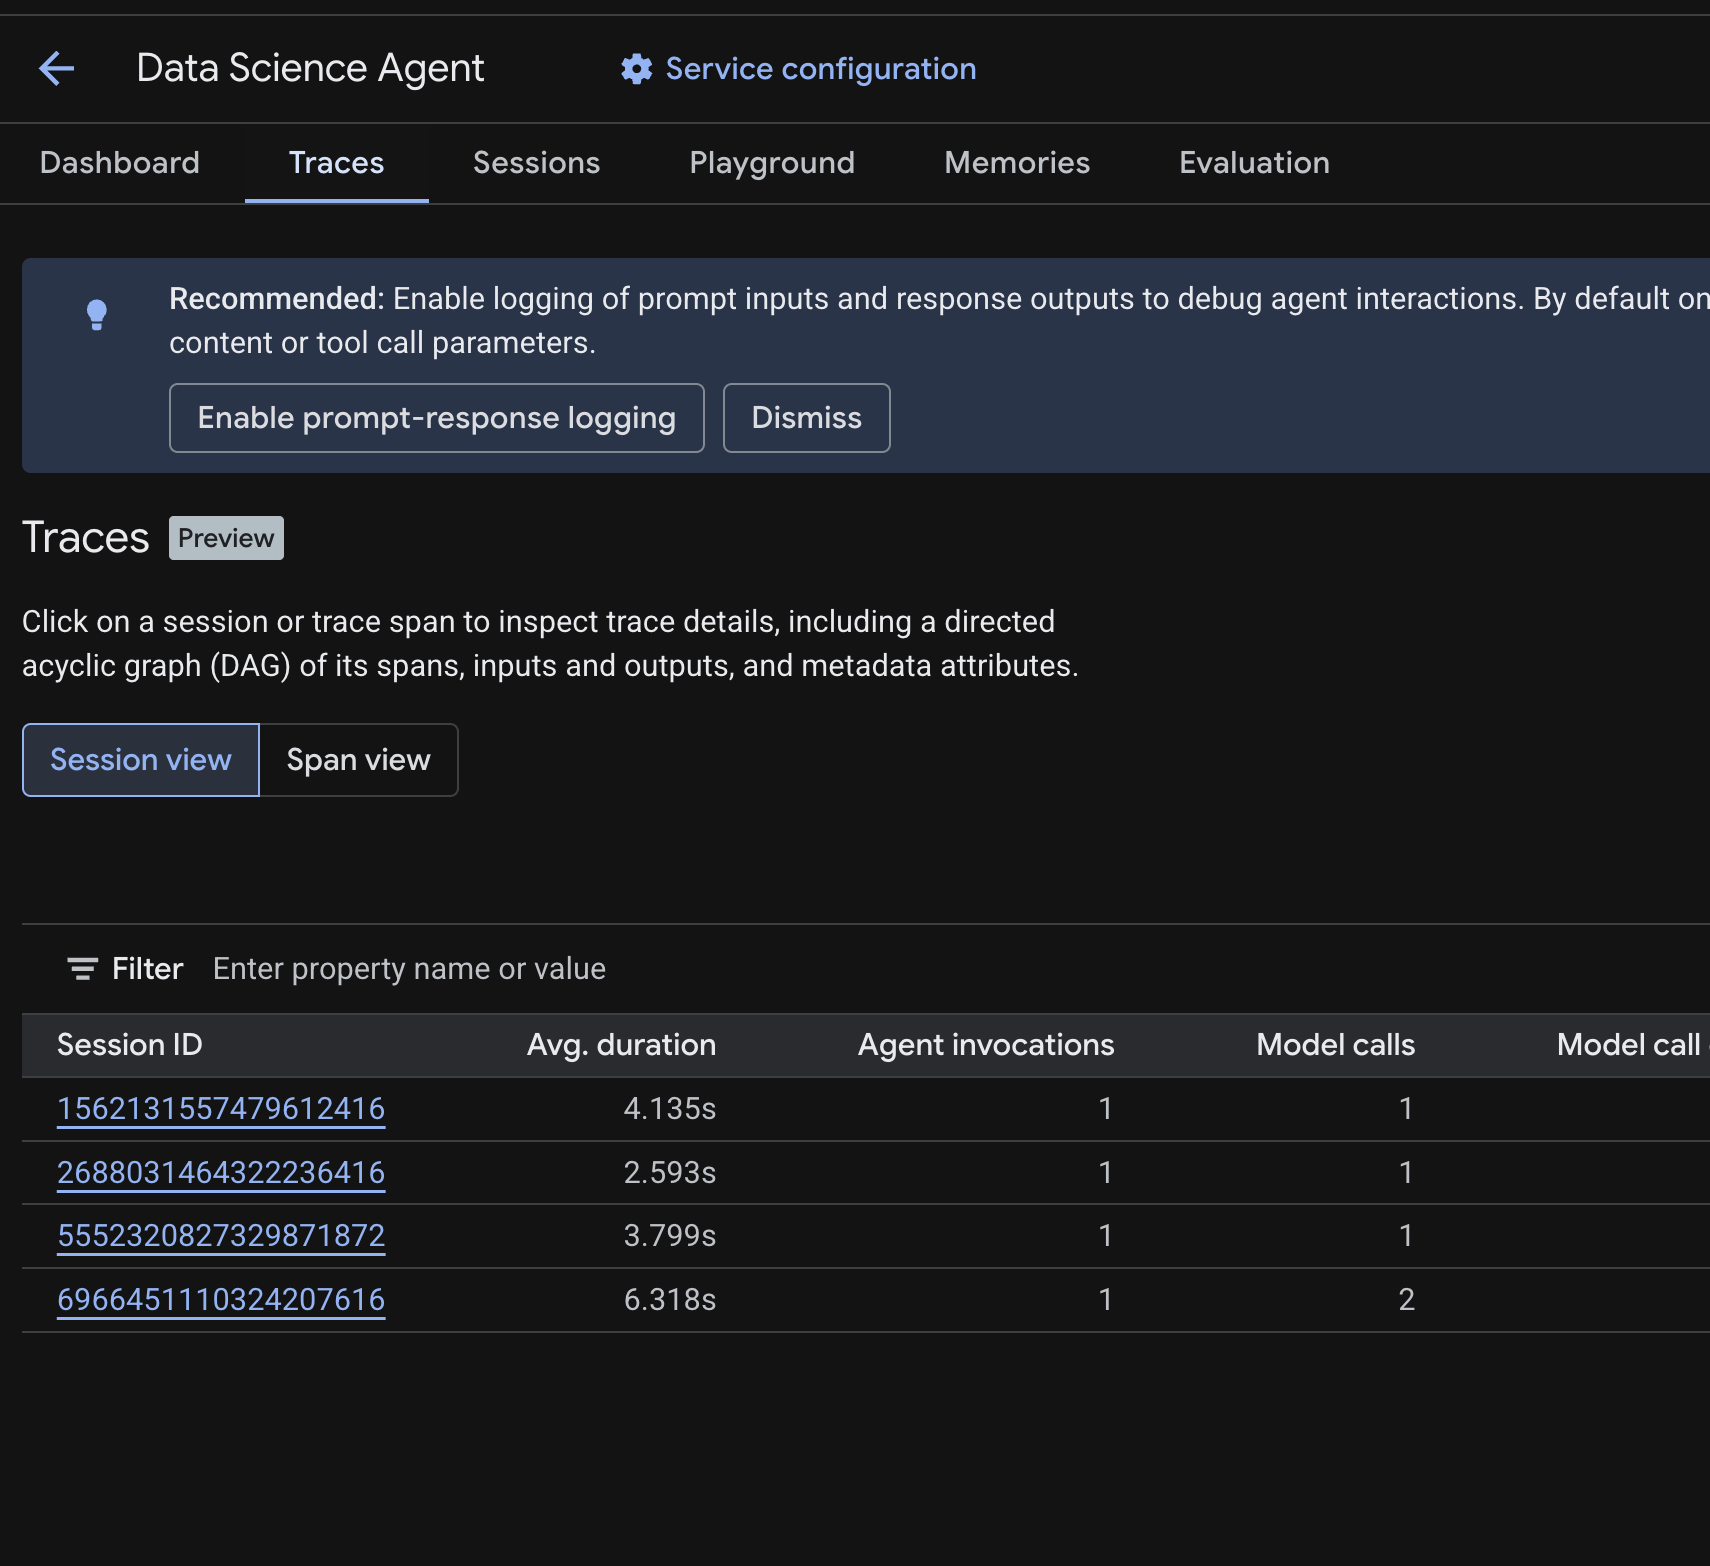
אמורה להופיע טבלת סשנים עם רשימה של הסשנים משאילתות הבדיקה שהרצתם בשלבים הקודמים. בטבלה מוצגים מדדי סיכום לכל סשן – משך ממוצע, קריאות למודל, קריאות לכלים, שימוש בטוקנים ושגיאות.
לוחצים על סשן כדי לבדוק את פרטי המעקב שלו, כולל:
- גרף אציקלי מכוון (DAG) של יחידות לוגיות למעקב – שבו מוצג פירוט של שלבי החשיבה הרציונלית של הסוכן, קריאות לכלים (שאילתות BigQuery) והשהיות
- קלט ופלט לכל טווח (מופעל באמצעות משתנה הסביבה
OTEL_INSTRUMENTATION_GENAI_CAPTURE_MESSAGE_CONTENTב-.env) - מאפייני מטא-נתונים כמו מזהי יחידה לוגית למעקב, מזהי מעקב ותזמון
אפשר גם לעבור לתצוגת טווח (המתג נמצא בחלק העליון) כדי לראות טווחי זמן נפרדים בכל הסשנים.
איך פועל מעקב
כשפורסים באמצעות --otel_to_cloud, adk deploy בונה קונטיינר שמריץ את שרת ה-API של ADK עם OpenTelemetry מופעל. ב-Agent Runtime, השרת מאתחל פייפליין של OpenTelemetry ש:
- יוצר TracerProvider עם OTLP exporter ששולח spans אל
telemetry.googleapis.com - מתעד טווחי זמן משלו של ADK עבור הפעלות של סוכנים, קריאות למודלים וקריאות לכלים, ומשתמש ב-3 חבילות של מכשירי מדידה מ-
requirements.txtכדי להוסיף טווחי זמן מספריות מפתח (Gemini, httpx, gRPC) - מקבצים ומייצאים טווחים אל Telemetry API, שבו הכרטיסייה Traces קוראת אותם
המאגר שנפרס כולל את ADK ואת OpenTelemetry SDK ואת כלי הייצוא, אבל לא כולל את חבילות המכשירים. לכן, ברשימה requirements.txt מוצגים שלושת המיקומים. בלי הנתונים האלה, שרת ה-API של ADK רושם אזהרה ביומן ומדלג על טווחי הזמן האלה.
פתרון בעיות
אם לא מופיעים עקבות אחרי כמה דקות:
- בודקים ש-Telemetry API מופעל: הפעלתם אותו בשלב ההגדרה. אימות באמצעות:
gcloud services list --enabled --project=$(gcloud config get project) | grep telemetry - בדיקה אם יש אזהרות ב-Cloud Logging: עוברים אל Logging > Logs Explorer ומחפשים את
"proceeding without"או"GoogleGenAiSdkInstrumentor". אזהרה שבה מצוין שם של כלי למדידת ביצועים (GenAI, HTTPX או gRPC) מעידה על כך שחבילתopentelemetry-instrumentation-*התואמת חסרה ב-requirements.txt. - אל תוסיפו את
google-cloud-aiplatformאלrequirements.txt. adk deployמוסיף אותו באופן אוטומטי. אם תצהירו עליו בעצמכם, עלולים להיווצר קונפליקטים בחבילת OpenTelemetry, והמדידה עלולה להיפסק בלי שתדעו.
9. ניקוי
כדי להימנע מחיובים שוטפים, מוחקים את המשאבים שנוצרו במהלך ה-codelab הזה.
מוחקים את הסוכן שנפרס מהדף Deployments במסוף Cloud. בוחרים את הסוכן ולוחצים על מחיקה.
אם יצרתם פרויקט במיוחד בשביל ה-Codelab הזה, אתם יכולים למחוק את הפרויקט כולו במקום זאת:
gcloud projects delete <YOUR_PROJECT_ID>
אפשר גם לנקות את הסביבה המקומית:
cd ~
rm -rf ~/adk-deploy-scale
10. מזל טוב
יצרתם סוכן מדעי נתונים עם שמירת מצב ופרסתם אותו ב-Agent Runtime.
מה למדתם
- איך יוצרים סוכן ADK באמצעות
BigQueryToolsetלגישה לנתונים אמיתיים - איך מפעילים זיכרון קבוע באמצעות Memory Bank באמצעות
PreloadMemoryToolו-after_agent_callback - איך מעניקים הרשאות IAM לחשבון השירות של הסוכן שנפרס
- איך פורסים ל-Agent Runtime ומפעילים ניראות (observability) באמצעות Cloud Trace
השלבים הבאים
- הרצת שאילתות במערכי נתונים פרטיים של BigQuery על ידי הענקת גישה לנתונים לסוכן השירות של Agent Runtime
- הוספת הרצת קוד כדי להריץ ניתוח Python בארגז חול מאובטח
- הגדרת לוחות בקרה של Cloud Trace observability כדי לעקוב אחרי הסוכן בסביבת הייצור
- פרסום תוצאות ב-Google Workspace באמצעות כלים של MCP