

1. 概要
この Codelab では、BigQuery 一般公開データセットから実際のデータをクエリし、セッション間で設定を記憶するデータ サイエンス エージェントを構築します。次に、インフラストラクチャ、スケーリング、セッション管理を処理するフルマネージドの Google Cloud サービスである Agent Runtime にデプロイします。
エージェントは、段階的に有効になる 3 つのコア機能を使用します。
- BigQuery ツールセット: エージェントはスキーマを探索し、実際の BigQuery データセットに対して SQL クエリを実行します。これはローカルでもデプロイ時でも機能します。
- メモリバンク: デプロイすると、エージェントは切断されたセッション間でユーザーの好みとコンテキストを記憶します。
- オブザーバビリティ: Cloud Trace は、OpenTelemetry 計測を介してエージェントの推論ステップ、ツール呼び出し、レイテンシをキャプチャします。
学習内容
- 実際のデータ アクセスに
BigQueryToolsetを使用して ADK エージェントを作成する方法 - セッション間の永続性を実現するようにメモリバンクを構成する方法
adk deployを使用してエージェントを Agent Runtime にデプロイする方法- デプロイされたエージェントのサービス アカウントに IAM 権限を付与する方法
- メモリの永続性とオブザーバビリティをテストする方法
必要なもの
- 課金を有効にした Google Cloud プロジェクト
- ウェブブラウザ(Chrome など)
- Cloud Shell ではなく、自分のマシンでコードを実行する場合: Google Cloud SDK(
gcloudCLI)、uv(Python パッケージ マネージャー)、Python 3.12 以降(必要に応じてuvによって自動的にインストールされます)
ADK(Agent Development Kit)は、AI エージェントを構築するための Google のフレームワークです。この Codelab では、ADK を使用してエージェントを作成し、Agent Runtime にデプロイします。
この Codelab は、Python と Google Cloud にある程度精通している中級レベルのデベロッパーを対象としています。
この Codelab を完了するには約 35 分かかります(デプロイに 5 ~ 10 分かかります)。
この Codelab で作成するリソースの費用は 5 ドル未満です。
2. 環境を設定する
Google Cloud プロジェクトの作成
- Google Cloud コンソールのプロジェクト セレクタ ページで、Google Cloud プロジェクトを選択または作成します。
- Cloud プロジェクトに対して課金が有効になっていることを確認します。プロジェクトで課金が有効になっているかどうかを確認する方法をご覧ください。
プロジェクトを設定する
作成した GCP プロジェクトで Cloud Shell エディタを開きます。
次に、[Terminal] > [New Terminal] を作成し、次のコマンドを実行してプロジェクトを設定します。以降のコマンドは、この設定からプロジェクト ID を読み取ります。
gcloud config set project <INSERT_YOUR_GCP_PROJECT_HERE>
API を有効にする
ターミナルで次のコマンドを実行します。
gcloud services enable \
  aiplatform.googleapis.com \
  bigquery.googleapis.com \
  telemetry.googleapis.com \
  --project=$(gcloud config get project)
aiplatform.googleapis.com: Gemini Enterprise のセッションとメモリバンクを含む Agent Runtime でエージェントをホストし、Gemini モデルを提供します。- BigQuery API(
bigquery.googleapis.com): 一般公開データセットと非公開データセットに対する SQL クエリ - Telemetry API(
telemetry.googleapis.com): エージェントのオブザーバビリティのための OpenTelemetry トレース
ADK をインストールする
ターミナルで次のコマンドを実行して、この Codelab のフォルダを作成し、ADK とその依存関係をインストールします。
mkdir -p ~/adk-deploy-scale
cd ~/adk-deploy-scale
uv init --bare
uv add google-adk google-auth google-cloud-bigquery "google-cloud-aiplatform[agent_engines]"
uv はこの Codelab 用の隔離された Python 環境を作成するため、何も有効にする必要はありません。Python コマンドの先頭に uv run を付けます。
google-adk パッケージには、エージェントのテストとデプロイに使用する adk CLI ツールが含まれています。adk deploy は google-cloud-aiplatform を使用して Agent Runtime にエージェントを作成します。google-cloud-bigquery は ADK の BigQuery ツールの背後にあるクライアント ライブラリです。
3. エージェントを作成する
~/adk-deploy-scale フォルダに、エージェント ディレクトリを作成します。以降のコマンドはすべて ~/adk-deploy-scale(data_science_agent/ の親)から実行します。
mkdir data_science_agent
次のコマンドを実行して、プロジェクト、エージェントをデプロイするリージョン、デプロイされたエージェントの設定を使用して data_science_agent/.env を作成します。adk deploy はこのファイルを読み取るため、新しいターミナルを開いてもこれらの設定は有効です。
cat > ~/adk-deploy-scale/data_science_agent/.env <<EOF
GOOGLE_CLOUD_PROJECT=$(gcloud config get project)
GOOGLE_CLOUD_LOCATION=us-central1
GOOGLE_GENAI_USE_ENTERPRISE=True
OTEL_INSTRUMENTATION_GENAI_CAPTURE_MESSAGE_CONTENT=true
EOF
GOOGLE_CLOUD_PROJECTとGOOGLE_CLOUD_LOCATION: プロジェクト ID(gcloudから入力)とエージェントが実行されるリージョンGOOGLE_GENAI_USE_ENTERPRISE: Google Cloud プロジェクトを介して Gemini を呼び出す ADK があるOTEL_INSTRUMENTATION_GENAI_CAPTURE_MESSAGE_CONTENT: プロンプト入力とエージェント レスポンス全体をログに記録します。デバッグに役立ちます。
最終的なディレクトリ構造は次のようになります。
adk-deploy-scale/
  data_science_agent/
    .env
    __init__.py
    agent.py
    requirements.txt    # created in the Deploy step
ここでは __init__.py と agent.py を作成し、デプロイ ステップで requirements.txt を追加します。
data_science_agent/__init__.py を作成します。このファイルは、ADK がエージェントを検出して読み込むために必要です。
from . import agent # noqa: F401 — required by `adk eval` and `adk web`
data_science_agent/agent.py を作成します。
このエージェントは、データ抽出のために BigQuery に接続し、セッションをメモリバンクに保持します。
メモリはデプロイ時に自動的に有効になります。Agent Runtime は GOOGLE_CLOUD_AGENT_ENGINE_ID 環境変数を設定します。この変数はローカルで実行する場合は存在しません。
from __future__ import annotations

import os

from google.adk.agents import LlmAgent
from google.adk.agents.callback_context import CallbackContext
from google.adk.apps import App
from google.adk.integrations.bigquery import BigQueryCredentialsConfig
from google.adk.integrations.bigquery import BigQueryToolset
from google.adk.models import Gemini
from google.adk.tools.preload_memory_tool import PreloadMemoryTool
from google.genai import types
import google.auth

PROJECT_ID = os.getenv("GOOGLE_CLOUD_PROJECT")
if not PROJECT_ID:
    raise ValueError(
        "GOOGLE_CLOUD_PROJECT environment variable is required. "
        "Add it to data_science_agent/.env: GOOGLE_CLOUD_PROJECT=<your-project-id>"
    )

credentials, _ = google.auth.default()
bq_toolset = BigQueryToolset(credentials_config=BigQueryCredentialsConfig(credentials=credentials))

# GOOGLE_CLOUD_AGENT_ENGINE_ID is set automatically by Agent Runtime.
agent_engine_id = os.getenv("GOOGLE_CLOUD_AGENT_ENGINE_ID")


async def _save_memory(callback_context: CallbackContext) -> None:
    """Persist the session to Memory Bank after each agent run.

    Only activates on Agent Runtime, where Memory Bank is available.
    """
    if agent_engine_id:
        await callback_context.add_session_to_memory()


root_agent = LlmAgent(
    name="data_science_agent",
    model=Gemini(
        model="gemini-3.8-flash",
        # gemini-3.8-flash is served from the global endpoint. The agent
        # itself runs in GOOGLE_CLOUD_LOCATION (us-central1).
        client_kwargs={"location": "global"},
        retry_options=types.HttpRetryOptions(attempts=5),
    ),
    instruction=(
        "You are an expert Data Science Agent. "
        "Your goal is to query enterprise BigQuery datasets, analyze the data, "
        "and summarize your findings. "
        f"When executing SQL queries, use project_id `{PROJECT_ID}` as the "
        "billing project unless the user specifies a different one. "
        "Present results clearly with formatted numbers. "
        "Remember user preferences like preferred regions, date ranges, "
        "or analysis formats across conversations."
    ),
    tools=[bq_toolset, PreloadMemoryTool()],
    after_agent_callback=_save_memory,
)

app = App(
    name="data_science_agent",
    root_agent=root_agent,
)
このコードの処理内容は次のとおりです。
- BigQueryToolset は、エージェントに
execute_sql、list_table_ids、get_table_infoなどのツールを提供します。これにより、スキーマを探索し、呼び出し元がアクセスできる任意のデータセットにクエリを実行できます。 - PreloadMemoryTool は、各 LLM 呼び出しの前に、メモリバンクでユーザーのメッセージに関連するコンテンツを検索して、関連するメモリを自動的に取得します。
_save_memoryコールバックは、各エージェントの実行後にセッションをメモリバンクに保持するため、エージェントは将来のセッションでコンテキストを呼び出すことができます。 - App は、ルート エージェントを Agent Runtime が提供できるデプロイ可能なアプリケーションにラップします。
nameはディレクトリ名(data_science_agent)と一致する必要があります。adk webはこれを使用してエージェントを特定して読み込みます。 - 指示は、SQL クエリに請求先プロジェクトを使用し、ユーザー設定を記憶するようにエージェントに指示します。
client_kwargs={"location": "global"}を使用する Gemini は、gemini-3.8-flashが使用可能なグローバル エンドポイントにモデル呼び出しを送信します。エージェント自体はus-central1で実行されます。adk deployは、デプロイされたエージェントのGOOGLE_CLOUD_LOCATIONをデプロイ先のリージョンに設定するため、モデルのロケーションはコードで設定されます。
4. Agent Runtime にデプロイする
data_science_agent ディレクトリに requirements.txt ファイルを作成します。
google-adk
google-genai
google-auth
google-cloud-bigquery
python-dotenv
opentelemetry-instrumentation-google-genai
opentelemetry-instrumentation-httpx
opentelemetry-instrumentation-grpc
google-adkとgoogle-genai: ADK と Gemini クライアントgoogle-auth: Google Cloud 認証google-cloud-bigquery:BigQueryToolsetが使用する BigQuery クライアント ライブラリ。ADK はデフォルトではインストールしません。python-dotenv: 起動時に.envファイルを読み込みます- 3 つの
opentelemetry-instrumentation-*パッケージにより、後で説明するオブザーバビリティ機能が有効になります。Gemini モデル呼び出しと内部 gRPC/HTTP 通信を計測して、エージェントの [トレース] タブにトレースが表示されるようにします。
また、adk deploy は、以前に作成した data_science_agent/.env ファイルを読み取り、デプロイされたエージェントに設定を適用します。
エージェントをデプロイします。最後の引数 data_science_agent は、エージェント コードを含むディレクトリです。
uv run adk deploy agent_engine \
  --project=$(gcloud config get project) \
  --region=us-central1 \
  --display_name="Data Science Agent" \
  --otel_to_cloud \
  data_science_agent
出力の先頭付近に、2 つの黄色の線 Ignoring GOOGLE_CLOUD_PROJECT in .env ... と Ignoring GOOGLE_CLOUD_LOCATION in .env ... が表示されます。これは想定どおりです。--project フラグと --region フラグは、.env の同じ値よりも優先されます。
フラグ | 目的 |
| ターゲットの Google Cloud プロジェクトとリージョン |
| Cloud コンソールに表示される人が判読できる名前 |
| OpenTelemetry のトレースとログを Google Cloud にエクスポートし、デプロイされたエージェントでテレメトリー( |
Agent Runtime にデプロイすると、次の 2 つの機能が自動的に有効になります。
- メモリバンク:
adk deployは、エージェントを Agent Runtime インスタンスの Sessions と メモリバンク に接続します。PreloadMemoryToolはメモリバンクから読み取り、_save_memoryはセッションを自動的に永続化します。 - オブザーバビリティ: Cloud Trace は、エージェントの推論ステップ、ツールの呼び出し、レイテンシをキャプチャします。
5. BigQuery の権限を付与する
BigQuery に Agent Runtime サービス エージェント(AI Platform Reasoning Engine サービス エージェント)へのアクセス権を付与する必要があります。デプロイされると、エージェントはこの Google 管理のサービス アカウント(個人の認証情報ではない)として実行されるため、SQL クエリを実行するための明示的な権限が必要です。
PROJECT_NUMBER=$(gcloud projects describe $(gcloud config get project) \
  --format='value(projectNumber)')

SA="service-${PROJECT_NUMBER}@gcp-sa-aiplatform-re.iam.gserviceaccount.com"

# Required to execute SQL queries
gcloud projects add-iam-policy-binding $(gcloud config get project) \
  --member="serviceAccount:${SA}" \
  --role="roles/bigquery.jobUser"

# Required to read table metadata and data
gcloud projects add-iam-policy-binding $(gcloud config get project) \
  --member="serviceAccount:${SA}" \
  --role="roles/bigquery.dataViewer"
各コマンドは、成功すると Updated IAM policy for project [...] を出力します。
6. デプロイしたエージェントをテストする
Google Cloud コンソールで [デプロイ] ページを開きます。デプロイしたエージェントをクリックし、[プレイグラウンド] タブをクリックします。
BigQuery の機能をテストします。
- 「bigquery-public-data.hacker_news のテーブルを一覧表示して」
- 想定される動作: エージェントが
list_table_idsを呼び出し、fullを含むテーブル名を返します。
- 想定される動作: エージェントが
- 「bigquery-public-data.hacker_news.full の投稿数を年ごとに取得して」
- 想定される動作: エージェントが SQL クエリで
execute_sqlを呼び出し、年と投稿数のテーブルを返します。
- 想定される動作: エージェントが SQL クエリで
- 「投稿数の前年比の増減率は?」
- 想定される動作: エージェントは、変化率を計算する SQL クエリを使用して
execute_sqlを呼び出し、結果を返します。
- 想定される動作: エージェントは、変化率を計算する SQL クエリを使用して
7. メモリの永続性をテストする
プレイグラウンドで、エージェントに優先順位を教えます。
- 「私のお気に入りのデータセットは bigquery-public-data.hacker_news であることを覚えておいて」
- 「どんなテーブルがある?」
数秒待ってメモリを永続化します(エージェントが応答した後に _save_memory コールバックが実行されます)。
Playground で [新しいセッション] をクリックして新しいセッションを開始し、次の質問をします。
- 「お気に入りのデータセットは何ですか?」
会話履歴のない新しいセッションであっても、エージェントは bigquery-public-data.hacker_news を呼び出す必要があります。この仕組みの説明:
_save_memoryは、callback_context.add_session_to_memory()を介して各セッションをメモリバンクに保持します。PreloadMemoryToolは、各 LLM 呼び出しの前に、関連するメモリを取得します。- メモリバンク は、キーワードだけでなく、意味に基づいてコンテンツを照合します
8. オブザーバビリティの詳細
Cloud コンソールで、デプロイされたエージェントに移動し、[トレース] タブをクリックします。
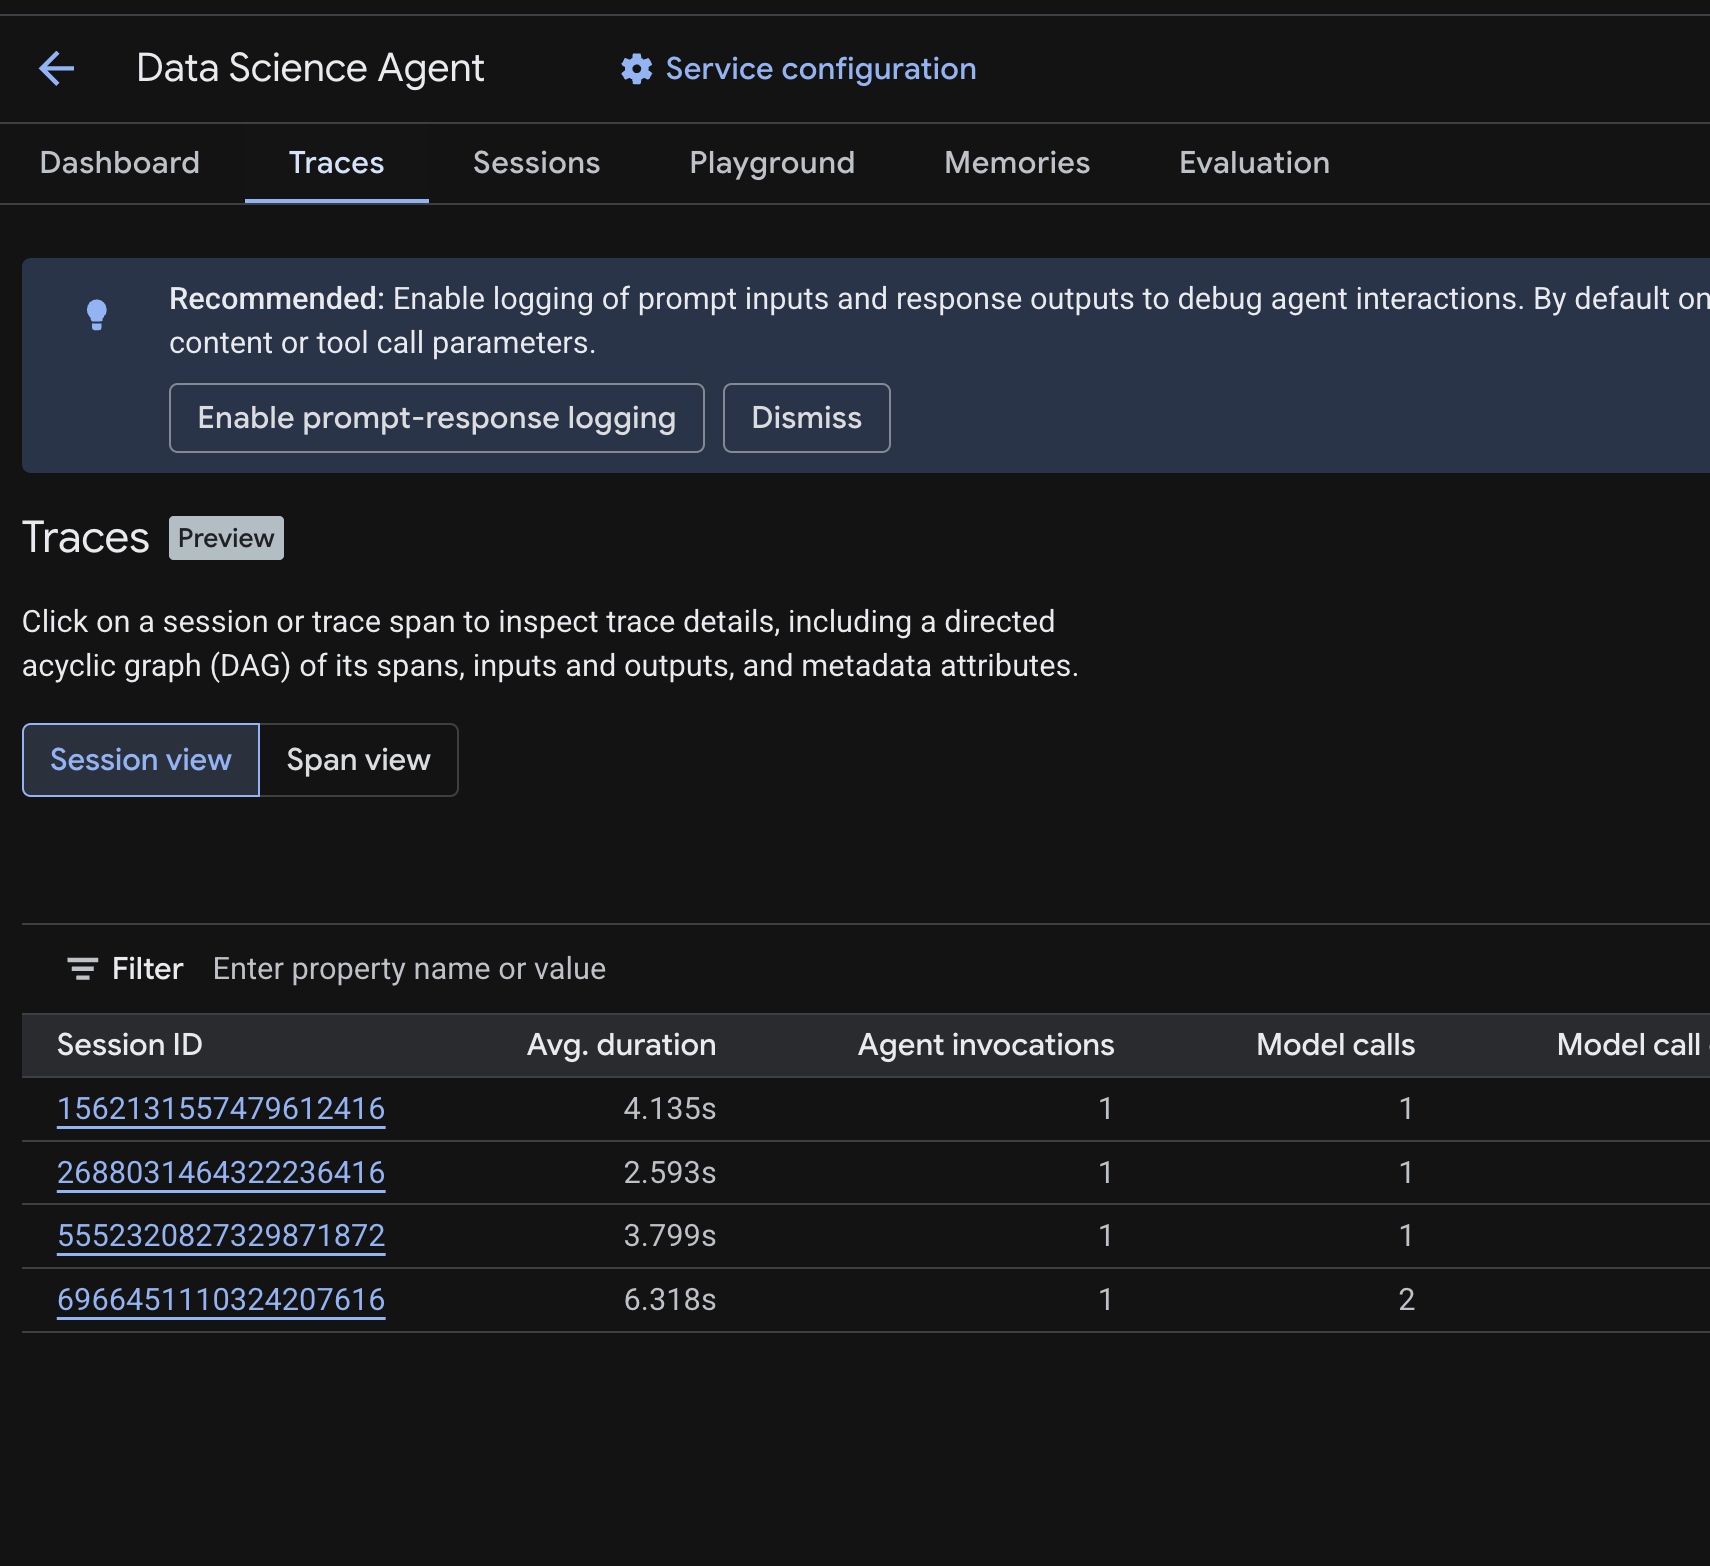
前の手順で実行したテストクエリのセッションが一覧表示されたセッション テーブルが表示されます。この表には、各セッションの概要指標(平均継続時間、モデル呼び出し、ツール呼び出し、トークン使用量、エラーなど)が表示されます。
セッションをクリックすると、次のトレースの詳細を確認できます。
- スパンの有向非巡回グラフ(DAG)。エージェントの推論、ツール呼び出し(BigQuery クエリ)、レイテンシのステップごとの内訳が表示されます。
- 各スパンの入力と出力(
.envのOTEL_INSTRUMENTATION_GENAI_CAPTURE_MESSAGE_CONTENT環境変数で有効) - スパン ID、トレース ID、タイミングなどのメタデータ属性
スパンビュー(上部の切り替え)に切り替えて、すべてのセッションの個々のスパンを確認することもできます。
トレースの仕組み
--otel_to_cloud を使用してデプロイすると、adk deploy は OpenTelemetry が有効になっている ADK API サーバーを実行するコンテナをビルドします。Agent Runtime で、サーバーは次の OpenTelemetry パイプラインを初期化します。
- スパンを
telemetry.googleapis.comに送信する OTLP エクスポータを使用して TracerProvider を作成します。 - エージェントの実行、モデル呼び出し、ツール呼び出しの ADK 独自のスパンを記録し、
requirements.txtの 3 つのインストルメンテーション パッケージを使用して、キー ライブラリ(Gemini、httpx、gRPC)のスパンを追加します。 - スパンを Telemetry API にバッチ処理してエクスポートします。ここで、[トレース] タブがスパンを読み取ります
デプロイされたコンテナには ADK と OpenTelemetry SDK およびエクスポータが含まれますが、計測パッケージは含まれません。そのため、requirements.txt には 3 つすべてがリストされます。これらのスパンがない場合、ADK API サーバーは警告をログに記録し、これらのスパンをスキップします。
トラブルシューティング
数分経ってもトレースが表示されない場合:
- Telemetry API が有効になっていることを確認する: 設定手順で有効にしました。
gcloud services list --enabled --project=$(gcloud config get project) | grep telemetryで確認する - Cloud Logging で警告を確認する: [ロギング] > [ログ エクスプローラ] に移動し、
"proceeding without"または"GoogleGenAiSdkInstrumentor"を検索します。計測(GenAI、HTTPX、gRPC)の名前を示す警告は、一致するopentelemetry-instrumentation-*パッケージがrequirements.txtにないことを意味します。 requirements.txtにgoogle-cloud-aiplatformを追加しないでください。adk deployは自動的に追加します。自分で宣言すると、OpenTelemetry パッケージの競合が発生し、計測がサイレントに中断される可能性があります。
9. クリーンアップ
継続的な課金が発生しないようにするには、この Codelab で作成したリソースを削除します。
Cloud コンソールのデプロイメント ページから、デプロイされたエージェントを削除します。エージェントを選択して [削除] をクリックします。
この Codelab 専用のプロジェクトを作成した場合は、プロジェクト全体を削除できます。
gcloud projects delete <YOUR_PROJECT_ID>
必要に応じて、ローカル環境をクリーンアップします。
cd ~
rm -rf ~/adk-deploy-scale
10. 完了
ステートフル データ サイエンス エージェントを構築し、Agent Runtime にデプロイしました。
学習した内容
- 実際のデータ アクセスに
BigQueryToolsetを使用して ADK エージェントを作成する方法 PreloadMemoryToolとafter_agent_callbackを使用してメモリバンクで永続メモリを有効にする方法- デプロイされたエージェントのサービス アカウントに IAM 権限を付与する方法
- Agent Runtime にデプロイして Cloud Trace でオブザーバビリティを有効にする方法
次のステップ
- Agent Runtime サービス エージェントにデータへのアクセス権を付与して、独自の非公開 BigQuery データセットをクエリする
- 安全なサンドボックスで Python 分析を実行するためにコード実行を追加する
- Cloud Trace のオブザーバビリティ ダッシュボードを設定して、本番環境でエージェントをモニタリングする
- MCP ツールを使用して、結果を Google Workspace に公開する