

1. 개요
이 Codelab에서는 BigQuery 공개 데이터 세트에서 실제 데이터를 쿼리하고 세션 간에 환경설정을 기억하는 데이터 과학 에이전트를 빌드합니다. 그런 다음 인프라, 확장, 세션 관리를 처리하는 완전 관리형 Google Cloud 서비스인 Agent Runtime에 배포합니다.
에이전트는 점진적으로 활성화되는 세 가지 핵심 기능을 사용합니다.
- BigQuery 도구 모음: 에이전트가 스키마를 탐색하고 실제 BigQuery 데이터 세트에 대해 SQL 쿼리를 실행합니다. 이는 로컬 및 배포된 경우 모두 작동합니다.
- 메모리 뱅크: 배포되면 에이전트가 연결이 끊긴 세션 전반에서 사용자 환경설정과 컨텍스트를 기억합니다.
- 모니터링 가능성: Cloud Trace는 OpenTelemetry 계측을 통해 에이전트의 추론 단계, 도구 호출, 지연 시간을 캡처합니다.
학습할 내용
- 실제 데이터 액세스를 위해
BigQueryToolset로 ADK 에이전트를 만드는 방법 - 세션 간 지속성을 위해 메모리 뱅크를 구성하는 방법
adk deploy를 사용하여 에이전트를 Agent Runtime에 배포하는 방법- 배포된 에이전트의 서비스 계정에 IAM 권한을 부여하는 방법
- 메모리 지속성 및 관측 가능성을 테스트하는 방법
필요한 항목
- 결제가 사용 설정된 Google Cloud 프로젝트
- 웹브라우저(예: Chrome)
- Cloud Shell 대신 자체 머신에서 코드를 실행하는 경우: Google Cloud SDK (
gcloudCLI), uv (Python 패키지 관리자), Python 3.12 이상 (필요한 경우uv에 의해 자동으로 설치됨)
ADK (에이전트 개발 키트)는 AI 에이전트를 빌드하기 위한 Google의 프레임워크입니다. 이 Codelab에서는 ADK를 사용하여 에이전트를 만들고 Agent Runtime에 배포합니다.
이 Codelab은 Python 및 Google Cloud에 어느 정도 익숙한 중급 개발자를 대상으로 합니다.
이 Codelab을 완료하는 데 약 35분이 소요됩니다 (배포에 5~10분 포함).
이 Codelab에서 만든 리소스의 비용은 5달러 미만이어야 합니다.
2. 환경 설정
Google Cloud 프로젝트 만들기
- Google Cloud 콘솔의 프로젝트 선택기 페이지에서 Google Cloud 프로젝트를 선택하거나 만듭니다.
- Cloud 프로젝트에 결제가 사용 설정되어 있는지 확인합니다. 프로젝트에 결제가 사용 설정되어 있는지 확인하는 방법을 알아보세요.
프로젝트 설정
생성한 GCP 프로젝트에서 Cloud Shell 편집기를 엽니다.
그런 다음 터미널 > 새 터미널을 만들고 다음 명령어를 실행하여 프로젝트를 설정합니다. 이후 명령어는 이 설정에서 프로젝트 ID를 읽어옵니다.
gcloud config set project <INSERT_YOUR_GCP_PROJECT_HERE>
API 사용 설정
터미널에서 다음 명령어를 실행합니다.
gcloud services enable \
  aiplatform.googleapis.com \
  bigquery.googleapis.com \
  telemetry.googleapis.com \
  --project=$(gcloud config get project)
aiplatform.googleapis.com: Gemini Enterprise 세션 및 메모리 뱅크를 포함하여 Agent Runtime에서 에이전트를 호스팅하고 Gemini 모델을 제공합니다.- BigQuery API (
bigquery.googleapis.com): 공개 및 비공개 데이터 세트에 대한 SQL 쿼리 - Telemetry API (
telemetry.googleapis.com): 에이전트 모니터링 가능성을 위한 OpenTelemetry 트레이스
ADK 설치
터미널에서 다음 명령어를 실행하여 이 Codelab의 폴더를 만들고 ADK와 종속 항목을 설치합니다.
mkdir -p ~/adk-deploy-scale
cd ~/adk-deploy-scale
uv init --bare
uv add google-adk google-auth google-cloud-bigquery "google-cloud-aiplatform[agent_engines]"
uv는 이 Codelab을 위해 격리된 Python 환경을 생성하므로 아무것도 활성화할 필요가 없습니다. Python 명령어 앞에 uv run를 붙입니다.
google-adk 패키지에는 에이전트를 테스트하고 배포하는 데 사용할 adk CLI 도구가 포함되어 있습니다. adk deploy는 google-cloud-aiplatform를 사용하여 Agent Runtime에서 에이전트를 만들고 google-cloud-bigquery는 ADK의 BigQuery 도구 뒤에 있는 클라이언트 라이브러리입니다.
3. 에이전트 만들기
~/adk-deploy-scale 폴더에서 에이전트 디렉터리를 만듭니다. ~/adk-deploy-scale (data_science_agent/의 상위)에서 이후의 모든 명령어를 실행합니다.
mkdir data_science_agent
그런 다음 다음 명령어를 실행하여 프로젝트, 에이전트를 배포할 리전, 배포된 에이전트의 설정으로 data_science_agent/.env를 만듭니다. adk deploy가 이 파일을 읽으므로 새 터미널을 열어도 이러한 설정은 계속 작동합니다.
cat > ~/adk-deploy-scale/data_science_agent/.env <<EOF
GOOGLE_CLOUD_PROJECT=$(gcloud config get project)
GOOGLE_CLOUD_LOCATION=us-central1
GOOGLE_GENAI_USE_ENTERPRISE=True
OTEL_INSTRUMENTATION_GENAI_CAPTURE_MESSAGE_CONTENT=true
EOF
GOOGLE_CLOUD_PROJECT및GOOGLE_CLOUD_LOCATION: 프로젝트 ID (gcloud에서 입력됨) 및 에이전트가 실행되는 리전GOOGLE_GENAI_USE_ENTERPRISE: Google Cloud 프로젝트를 통해 ADK가 Gemini를 호출함OTEL_INSTRUMENTATION_GENAI_CAPTURE_MESSAGE_CONTENT: 디버깅에 유용한 전체 프롬프트 입력과 에이전트 응답을 기록합니다.
최종 디렉터리 구조는 다음과 같습니다.
adk-deploy-scale/
  data_science_agent/
    .env
    __init__.py
    agent.py
    requirements.txt    # created in the Deploy step
지금 __init__.py와 agent.py를 만들고 배포 단계에서 requirements.txt를 추가합니다.
data_science_agent/__init__.py 만들기 - ADK가 에이전트를 검색하고 로드할 수 있도록 이 파일이 필요합니다.
from . import agent # noqa: F401 — required by `adk eval` and `adk web`
data_science_agent/agent.py 만들기:
이 에이전트는 데이터 추출을 위해 BigQuery에 연결하고 세션을 메모리 뱅크에 유지합니다.
메모리는 배포 시 자동으로 활성화됩니다. Agent Runtime은 로컬에서 실행할 때 없는 GOOGLE_CLOUD_AGENT_ENGINE_ID 환경 변수를 설정합니다.
from __future__ import annotations

import os

from google.adk.agents import LlmAgent
from google.adk.agents.callback_context import CallbackContext
from google.adk.apps import App
from google.adk.integrations.bigquery import BigQueryCredentialsConfig
from google.adk.integrations.bigquery import BigQueryToolset
from google.adk.models import Gemini
from google.adk.tools.preload_memory_tool import PreloadMemoryTool
from google.genai import types
import google.auth

PROJECT_ID = os.getenv("GOOGLE_CLOUD_PROJECT")
if not PROJECT_ID:
    raise ValueError(
        "GOOGLE_CLOUD_PROJECT environment variable is required. "
        "Add it to data_science_agent/.env: GOOGLE_CLOUD_PROJECT=<your-project-id>"
    )

credentials, _ = google.auth.default()
bq_toolset = BigQueryToolset(credentials_config=BigQueryCredentialsConfig(credentials=credentials))

# GOOGLE_CLOUD_AGENT_ENGINE_ID is set automatically by Agent Runtime.
agent_engine_id = os.getenv("GOOGLE_CLOUD_AGENT_ENGINE_ID")


async def _save_memory(callback_context: CallbackContext) -> None:
    """Persist the session to Memory Bank after each agent run.

    Only activates on Agent Runtime, where Memory Bank is available.
    """
    if agent_engine_id:
        await callback_context.add_session_to_memory()


root_agent = LlmAgent(
    name="data_science_agent",
    model=Gemini(
        model="gemini-3.8-flash",
        # gemini-3.8-flash is served from the global endpoint. The agent
        # itself runs in GOOGLE_CLOUD_LOCATION (us-central1).
        client_kwargs={"location": "global"},
        retry_options=types.HttpRetryOptions(attempts=5),
    ),
    instruction=(
        "You are an expert Data Science Agent. "
        "Your goal is to query enterprise BigQuery datasets, analyze the data, "
        "and summarize your findings. "
        f"When executing SQL queries, use project_id `{PROJECT_ID}` as the "
        "billing project unless the user specifies a different one. "
        "Present results clearly with formatted numbers. "
        "Remember user preferences like preferred regions, date ranges, "
        "or analysis formats across conversations."
    ),
    tools=[bq_toolset, PreloadMemoryTool()],
    after_agent_callback=_save_memory,
)

app = App(
    name="data_science_agent",
    root_agent=root_agent,
)
이 코드가 하는 작업을 살펴보겠습니다.
- BigQueryToolset은 에이전트에게
execute_sql,list_table_ids,get_table_info과 같은 도구를 제공합니다. 스키마를 탐색하고 호출자가 액세스할 수 있는 데이터 세트를 쿼리할 수 있습니다. - PreloadMemoryTool은 각 LLM 호출 전에 메모리 뱅크에서 사용자의 메시지와 관련된 콘텐츠를 검색하여 관련 메모리를 자동으로 검색합니다.
_save_memory콜백은 각 에이전트 실행 후 세션을 메모리 뱅크에 유지하므로 에이전트가 향후 세션에서 컨텍스트를 기억할 수 있습니다. - App은 루트 에이전트를 Agent Runtime에서 제공할 수 있는 배포 가능한 애플리케이션으로 래핑합니다.
name는 디렉터리 이름 (data_science_agent)과 일치해야 합니다.adk web는 이를 사용하여 에이전트를 찾아 로드합니다. - instruction은 에이전트에게 SQL 쿼리에 결제 프로젝트를 사용하고 사용자 환경설정을 기억하도록 지시합니다.
client_kwargs={"location": "global"}가 포함된 Gemini는gemini-3.8-flash를 사용할 수 있는 전역 엔드포인트로 모델 호출을 전송합니다. 에이전트 자체는us-central1에서 실행됩니다.adk deploy은 배포된 에이전트의GOOGLE_CLOUD_LOCATION을 배포된 리전으로 설정하므로 모델의 위치는 코드에서 대신 설정됩니다.
4. Agent Runtime에 배포
data_science_agent 디렉터리에 requirements.txt 파일을 만듭니다.
google-adk
google-genai
google-auth
google-cloud-bigquery
python-dotenv
opentelemetry-instrumentation-google-genai
opentelemetry-instrumentation-httpx
opentelemetry-instrumentation-grpc
google-adk및google-genai: ADK 및 Gemini 클라이언트google-auth: Google Cloud 인증google-cloud-bigquery:BigQueryToolset에서 사용하는 BigQuery 클라이언트 라이브러리입니다. ADK는 기본적으로 이를 설치하지 않습니다.python-dotenv: 시작 시.env파일을 로드합니다.- 세 개의
opentelemetry-instrumentation-*패키지는 나중에 살펴볼 모니터링 가능성 기능을 지원합니다. Gemini 모델 호출과 내부 gRPC/HTTP 통신을 계측하여 에이전트의 트레이스 탭에 트레이스가 표시되도록 합니다.
또한 adk deploy은 이전에 만든 data_science_agent/.env 파일을 읽고 배포된 에이전트에 설정을 지정합니다.
에이전트를 배포합니다. 마지막 인수 data_science_agent는 에이전트 코드가 포함된 디렉터리입니다.
uv run adk deploy agent_engine \
  --project=$(gcloud config get project) \
  --region=us-central1 \
  --display_name="Data Science Agent" \
  --otel_to_cloud \
  data_science_agent
출력 시작 부분에 Ignoring GOOGLE_CLOUD_PROJECT in .env ... 및 Ignoring GOOGLE_CLOUD_LOCATION in .env ...이라는 두 개의 노란색 선이 표시됩니다. --project 및 --region 플래그가 .env의 동일한 값보다 우선합니다.
플래그 | 목적 |
| 타겟 Google Cloud 프로젝트 및 리전 |
| Cloud 콘솔에 표시되는 사람이 읽을 수 있는 이름 |
| OpenTelemetry trace 및 로그를 Google Cloud로 내보내고 배포된 에이전트에서 원격 분석 ( |
Agent Runtime에 배포하면 다음 두 가지 기능이 자동으로 활성화됩니다.
- 메모리 뱅크:
adk deploy는 에이전트를 Agent Runtime 인스턴스의 세션 및 메모리 뱅크에 연결합니다.PreloadMemoryTool는 메모리 뱅크에서 읽고_save_memory는 세션을 자동으로 유지합니다. - 모니터링 가능성: Cloud Trace는 에이전트의 추론 단계, 도구 호출, 지연 시간을 캡처합니다.
5. BigQuery 권한 부여
BigQuery에 에이전트 런타임 서비스 에이전트 (AI Platform Reasoning Engine 서비스 에이전트)에 대한 액세스 권한을 부여해야 합니다. 배포되면 에이전트가 개인 사용자 인증 정보가 아닌 이 Google 관리 서비스 계정으로 실행되므로 SQL 쿼리를 실행하려면 명시적 권한이 필요합니다.
PROJECT_NUMBER=$(gcloud projects describe $(gcloud config get project) \
  --format='value(projectNumber)')

SA="service-${PROJECT_NUMBER}@gcp-sa-aiplatform-re.iam.gserviceaccount.com"

# Required to execute SQL queries
gcloud projects add-iam-policy-binding $(gcloud config get project) \
  --member="serviceAccount:${SA}" \
  --role="roles/bigquery.jobUser"

# Required to read table metadata and data
gcloud projects add-iam-policy-binding $(gcloud config get project) \
  --member="serviceAccount:${SA}" \
  --role="roles/bigquery.dataViewer"
각 명령어는 성공하면 Updated IAM policy for project [...]를 출력합니다.
6. 배포된 에이전트 테스트
Google Cloud 콘솔에서 배포 페이지를 엽니다. 배포된 에이전트를 클릭한 다음 플레이그라운드 탭을 클릭합니다.
BigQuery 기능 테스트:
- 'bigquery-public-data.hacker_news의 테이블을 나열해 줘'
- 예상: 에이전트가
list_table_ids를 호출하고full이 포함된 테이블 이름을 반환합니다.
- 예상: 에이전트가
- 'bigquery-public-data.hacker_news.full에서 연도별 게시물 수 찾기'
- 예상: 에이전트가 SQL 쿼리를 사용하여
execute_sql를 호출하고 연도와 게시물 수 테이블을 반환합니다.
- 예상: 에이전트가 SQL 쿼리를 사용하여
- '게시물의 전년 대비 비율 변화는 얼마였어?'
- 예상: 상담사가 백분율 변화를 계산하고 결과를 반환하는 SQL 쿼리를 사용하여
execute_sql를 호출합니다.
- 예상: 상담사가 백분율 변화를 계산하고 결과를 반환하는 SQL 쿼리를 사용하여
7. 메모리 지속성 테스트
Playground에서 계속해서 에이전트에게 선호도를 가르칩니다.
- '내가 가장 좋아하는 데이터 세트는 bigquery-public-data.hacker_news야'
- '어떤 테이블이 있어?'
메모리가 유지될 때까지 몇 초간 기다립니다 (_save_memory 콜백은 에이전트가 응답한 후에 실행됨).
이제 Playground에서 새 세션을 클릭하여 새 세션을 시작한 다음 다음과 같이 질문합니다.
- '내가 가장 좋아하는 데이터 세트는 뭐야?'
대화 기록이 없는 완전히 새로운 세션이라도 에이전트는 bigquery-public-data.hacker_news를 기억해야 합니다. 이 방법이 효과적인 이유는 다음과 같습니다.
_save_memory는callback_context.add_session_to_memory()을 통해 각 세션을 메모리 뱅크에 유지합니다.PreloadMemoryTool는 각 LLM 호출 전에 관련 메모리를 가져옵니다.- 메모리 뱅크는 키워드뿐만 아니라 시맨틱으로 콘텐츠를 일치시킵니다.
8. 모니터링 가능성 살펴보기
Cloud 콘솔에서 배포된 에이전트로 이동하여 트레이스 탭을 클릭합니다.
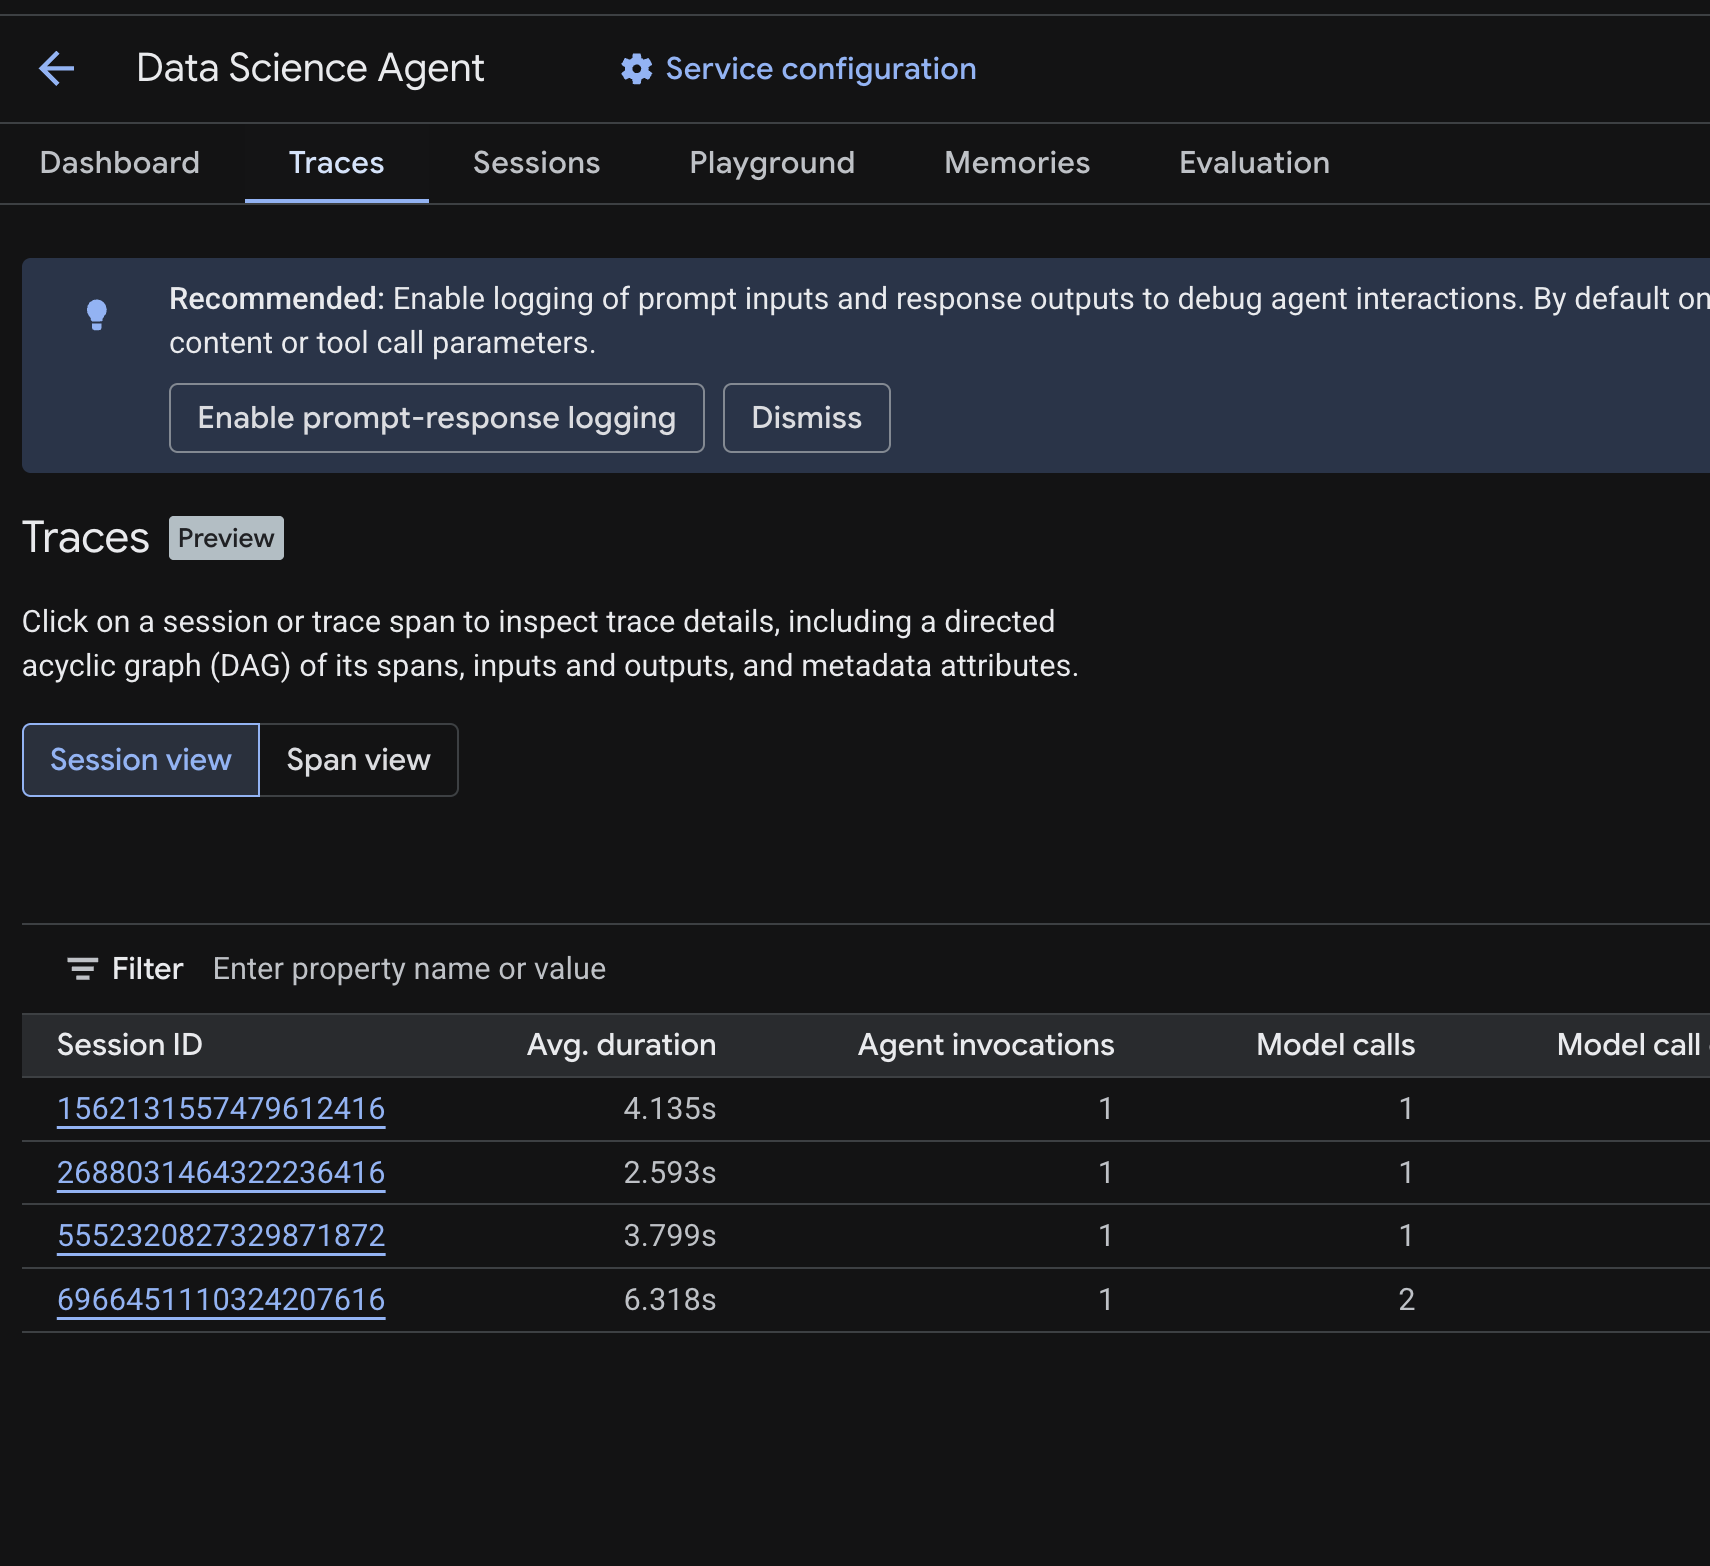
이전 단계에서 실행한 테스트 쿼리의 세션이 나열된 세션 테이블이 표시됩니다. 표에는 각 세션의 요약 측정항목(평균 시간, 모델 호출, 도구 호출, 토큰 사용량, 오류)이 표시됩니다.
세션을 클릭하여 다음을 포함한 trace 세부정보를 검사합니다.
- 스팬의 방향성 비순환 그래프 (DAG): 에이전트 추론, 도구 호출 (BigQuery 쿼리), 지연 시간의 단계별 분석을 보여줍니다.
- 각 스팬의 입력 및 출력 (
.env의OTEL_INSTRUMENTATION_GENAI_CAPTURE_MESSAGE_CONTENT환경 변수를 통해 사용 설정됨) - 스팬 ID, 트레이스 ID, 타이밍과 같은 메타데이터 속성
범위 보기 (상단에서 전환)로 전환하여 모든 세션의 개별 범위를 확인할 수도 있습니다.
추적 작동 방식
--otel_to_cloud로 배포하면 adk deploy에서 OpenTelemetry가 사용 설정된 ADK API 서버를 실행하는 컨테이너를 빌드합니다. Agent Runtime에서 서버는 다음을 수행하는 OpenTelemetry 파이프라인을 초기화합니다.
- 스팬을
telemetry.googleapis.com로 전송하는 OTLP 내보내기 도구를 사용하여 TracerProvider를 만듭니다. - 에이전트 실행, 모델 호출, 도구 호출을 위해 ADK 자체 스팬을 기록하고
requirements.txt의 세 가지 계측 패키지를 사용하여 주요 라이브러리 (Gemini, httpx, gRPC)에서 스팬을 추가합니다. - 스팬을 일괄 처리하여 Telemetry API로 내보냅니다. 여기서 트레이스 탭이 스팬을 읽습니다.
배포된 컨테이너에는 ADK와 OpenTelemetry SDK 및 내보내기 도구가 포함되지만 계측 패키지는 포함되지 않습니다. 따라서 requirements.txt에는 세 가지가 모두 표시됩니다. 이러한 스팬이 없으면 ADK API 서버에서 경고를 기록하고 해당 스팬을 건너뜁니다.
문제 해결
몇 분 후에도 트레이스가 표시되지 않으면 다음 단계를 따르세요.
- 원격 분석 API가 사용 설정되어 있는지 확인: 설정 단계에서 사용 설정했습니다. 다음으로 확인하세요.
gcloud services list --enabled --project=$(gcloud config get project) | grep telemetry - Cloud Logging에서 경고 확인: Logging > 로그 탐색기로 이동하여
"proceeding without"또는"GoogleGenAiSdkInstrumentor"를 검색합니다. 계측 (GenAI, HTTPX 또는 gRPC)을 명명하는 경고는 일치하는opentelemetry-instrumentation-*패키지가requirements.txt에서 누락되었음을 의미합니다. requirements.txt에google-cloud-aiplatform을 추가하지 마세요.adk deploy가 자동으로 추가하므로 직접 선언하면 OpenTelemetry 패키지 충돌이 발생하고 계측이 자동으로 중단될 수 있습니다.
9. 삭제
지속적인 요금이 청구되지 않도록 하려면 이 Codelab에서 만든 리소스를 삭제하세요.
Cloud 콘솔의 배포 페이지에서 배포된 에이전트를 삭제합니다. 에이전트를 선택하고 삭제를 클릭합니다.
이 Codelab을 위해 특별히 프로젝트를 만든 경우 전체 프로젝트를 삭제할 수 있습니다.
gcloud projects delete <YOUR_PROJECT_ID>
선택적으로 로컬 환경을 정리합니다.
cd ~
rm -rf ~/adk-deploy-scale
10. 축하합니다
상태 저장 데이터 과학 에이전트를 빌드하고 Agent Runtime에 배포했습니다.
학습한 내용
- 실제 데이터 액세스를 위해
BigQueryToolset로 ADK 에이전트를 만드는 방법 PreloadMemoryTool및after_agent_callback을 사용하여 메모리 뱅크로 영구 메모리를 사용 설정하는 방법- 배포된 에이전트의 서비스 계정에 IAM 권한을 부여하는 방법
- Agent Runtime에 배포하고 Cloud Trace로 모니터링 가능성을 사용 설정하는 방법
다음 단계
- Agent Runtime 서비스 에이전트에게 데이터 액세스 권한을 부여하여 자체 비공개 BigQuery 데이터 세트 쿼리
- 안전한 샌드박스에서 Python 분석을 실행할 수 있는 코드 실행 추가
- Cloud Trace 관측 가능성 대시보드를 설정하여 프로덕션에서 에이전트 모니터링
- MCP 도구를 사용하여 결과를 Google Workspace에 게시