

1. Genel Bakış
Bu codelab'de, BigQuery herkese açık veri kümelerindeki gerçek verileri sorgulayan ve oturumlar arasında tercihlerinizi hatırlayan bir veri bilimi aracısı oluşturacaksınız. Ardından, altyapı, ölçeklendirme ve oturum yönetimini ele alan, tamamen yönetilen bir Google Cloud hizmeti olan Agent Runtime'a dağıtırsınız.
Aracı, kademeli olarak etkinleşen üç temel özellik kullanır:
- BigQuery Araç Seti: Aracı, şemaları keşfeder ve gerçek BigQuery veri kümelerine karşı SQL sorguları çalıştırır. Bu işlem hem yerel olarak hem de dağıtıldığında çalışır.
- Bellek Bankası: Ajan, kullanıma sunulduğunda bağlantısı kesilmiş oturumlarda kullanıcı tercihlerini ve bağlamı hatırlar.
- Gözlemlenebilirlik: Cloud Trace, OpenTelemetry enstrümantasyonu aracılığıyla aracının muhakeme adımlarını, araç çağrılarını ve gecikmelerini yakalar.
Neler öğreneceksiniz?
- Gerçek veri erişimi için
BigQueryToolsetile ADK ajanı oluşturma - Oturumlar arası kalıcılık için Memory Bank'ı yapılandırma
adk deployile temsilcinizi Agent Runtime'a dağıtma- Dağıtılan aracının hizmet hesabı için IAM izinleri verme
- Bellek kalıcılığını ve gözlemlenebilirliği test etme
İhtiyacınız olanlar
- Faturalandırmanın etkin olduğu bir Google Cloud projesi
- Chrome gibi bir web tarayıcısı
- Kodu Cloud Shell yerine kendi makinenizde çalıştırıyorsanız: Google Cloud SDK (
gcloudCLI), uv (Python paket yöneticisi) ve Python 3.12+ (gerekirseuvtarafından otomatik olarak yüklenir)
ADK (Agent Development Kit), Google'ın yapay zeka ajanları oluşturmaya yönelik çerçevesidir. Bu codelab'de, ADK kullanılarak bir temsilci oluşturulup Agent Runtime'a dağıtılır.
Bu codelab, Python ve Google Cloud hakkında bilgi sahibi olan orta düzey geliştiriciler içindir.
Bu codelab'in tamamlanması yaklaşık 35 dakika sürer (5-10 dakika dağıtım süresi dahil).
Bu codelab'de oluşturulan kaynakların maliyeti 5 ABD dolarından az olmalıdır.
2. Ortamınızı ayarlama
Google Cloud projesi oluşturma
- Google Cloud Console'daki proje seçici sayfasında bir Google Cloud projesi seçin veya oluşturun.
- Cloud projeniz için faturalandırmanın etkinleştirildiğinden emin olun. Bir projede faturalandırmanın etkin olup olmadığını nasıl kontrol edeceğinizi öğrenin.
Projenizi ayarlama
Oluşturduğunuz GCP projesinde Cloud Shell Düzenleyici'yi açın.
Ardından Terminal > New Terminal'ı (Yeni Terminal) oluşturun ve projenizi ayarlamak için aşağıdaki komutu çalıştırın. Sonraki komutlar, proje kimliğini bu ayardan okur.
gcloud config set project <INSERT_YOUR_GCP_PROJECT_HERE>
API'leri etkinleştir
Terminalde aşağıdaki komutu çalıştırın.
gcloud services enable \
  aiplatform.googleapis.com \
  bigquery.googleapis.com \
  telemetry.googleapis.com \
  --project=$(gcloud config get project)
aiplatform.googleapis.com: Gemini Enterprise oturumları ve Memory Bank dahil olmak üzere, ajanınızı Agent Runtime'da barındırır ve Gemini modeline hizmet verir.- BigQuery API (
bigquery.googleapis.com): Genel ve özel veri kümelerine karşı SQL sorguları - Telemetry API (
telemetry.googleapis.com): Aracının gözlemlenebilirliği için OpenTelemetry izleri
ADK'yı yükleme
Terminalde, bu codelab için bir klasör oluşturmak ve ADK ile bağımlılıklarını yüklemek üzere aşağıdaki komutları çalıştırın:
mkdir -p ~/adk-deploy-scale
cd ~/adk-deploy-scale
uv init --bare
uv add google-adk google-auth google-cloud-bigquery "google-cloud-aiplatform[agent_engines]"
uv, bu codelab için izole bir Python ortamı oluşturur. Bu nedenle herhangi bir şeyi etkinleştirmeniz gerekmez. Python komutlarının önüne uv run ekleyin.
google-adk paketi, aracıyı test etmek ve dağıtmak için kullanacağınız adk CLI aracını içerir. adk deploy, Agent Runtime'da aracınızı oluşturmak için google-cloud-aiplatform'yi kullanır. google-cloud-bigquery ise ADK'nın BigQuery araçlarının temelini oluşturan istemci kitaplığıdır.
3. Ajanı oluşturma
~/adk-deploy-scale klasöründe aracı dizinini oluşturun. Daha sonraki tüm komutları ~/adk-deploy-scale (data_science_agent/ öğesinin üst öğesi) dizininden çalıştırın:
mkdir data_science_agent
Ardından, projeniz, aracıyı dağıtacağınız bölge ve dağıtılan aracı için ayarları içeren data_science_agent/.env oluşturmak üzere aşağıdaki komutu çalıştırın. adk deploy bu dosyayı okur. Bu nedenle, yeni bir terminal açtığınızda bu ayarlar çalışmaya devam eder.
cat > ~/adk-deploy-scale/data_science_agent/.env <<EOF
GOOGLE_CLOUD_PROJECT=$(gcloud config get project)
GOOGLE_CLOUD_LOCATION=us-central1
GOOGLE_GENAI_USE_ENTERPRISE=True
OTEL_INSTRUMENTATION_GENAI_CAPTURE_MESSAGE_CONTENT=true
EOF
GOOGLE_CLOUD_PROJECTveGOOGLE_CLOUD_LOCATION: Proje kimliğiniz (gcloudalanından doldurulur) ve aracının çalıştığı bölgeGOOGLE_GENAI_USE_ENTERPRISE: Google Cloud projeniz üzerinden Gemini'ı ADK ile çağırabilir.OTEL_INSTRUMENTATION_GENAI_CAPTURE_MESSAGE_CONTENT: Hata ayıklama için yararlı olan tam istem girişlerini ve aracı yanıtlarını günlüğe kaydeder.
Son dizin yapınız aşağıdaki gibi görünür:
adk-deploy-scale/
  data_science_agent/
    .env
    __init__.py
    agent.py
    requirements.txt    # created in the Deploy step
Şimdi __init__.py ve agent.py öğelerini oluşturacak, ardından dağıtım adımında requirements.txt öğesini ekleyeceksiniz.
data_science_agent/__init__.py oluşturun. ADK'nın temsilcinizi bulup yükleyebilmesi için bu dosya gereklidir:
from . import agent # noqa: F401 — required by `adk eval` and `adk web`
data_science_agent/agent.py oluşturma:
Bu aracı, veri ayıklama için BigQuery'ye bağlanır ve oturumları Memory Bank'te kalıcı hale getirir.
Hafıza, dağıtıldığında otomatik olarak etkinleştirilir. Agent Runtime, yerel olarak çalıştırılırken bulunmayan GOOGLE_CLOUD_AGENT_ENGINE_ID ortam değişkenini ayarlar.
from __future__ import annotations

import os

from google.adk.agents import LlmAgent
from google.adk.agents.callback_context import CallbackContext
from google.adk.apps import App
from google.adk.integrations.bigquery import BigQueryCredentialsConfig
from google.adk.integrations.bigquery import BigQueryToolset
from google.adk.models import Gemini
from google.adk.tools.preload_memory_tool import PreloadMemoryTool
from google.genai import types
import google.auth

PROJECT_ID = os.getenv("GOOGLE_CLOUD_PROJECT")
if not PROJECT_ID:
    raise ValueError(
        "GOOGLE_CLOUD_PROJECT environment variable is required. "
        "Add it to data_science_agent/.env: GOOGLE_CLOUD_PROJECT=<your-project-id>"
    )

credentials, _ = google.auth.default()
bq_toolset = BigQueryToolset(credentials_config=BigQueryCredentialsConfig(credentials=credentials))

# GOOGLE_CLOUD_AGENT_ENGINE_ID is set automatically by Agent Runtime.
agent_engine_id = os.getenv("GOOGLE_CLOUD_AGENT_ENGINE_ID")


async def _save_memory(callback_context: CallbackContext) -> None:
    """Persist the session to Memory Bank after each agent run.

    Only activates on Agent Runtime, where Memory Bank is available.
    """
    if agent_engine_id:
        await callback_context.add_session_to_memory()


root_agent = LlmAgent(
    name="data_science_agent",
    model=Gemini(
        model="gemini-3.8-flash",
        # gemini-3.8-flash is served from the global endpoint. The agent
        # itself runs in GOOGLE_CLOUD_LOCATION (us-central1).
        client_kwargs={"location": "global"},
        retry_options=types.HttpRetryOptions(attempts=5),
    ),
    instruction=(
        "You are an expert Data Science Agent. "
        "Your goal is to query enterprise BigQuery datasets, analyze the data, "
        "and summarize your findings. "
        f"When executing SQL queries, use project_id `{PROJECT_ID}` as the "
        "billing project unless the user specifies a different one. "
        "Present results clearly with formatted numbers. "
        "Remember user preferences like preferred regions, date ranges, "
        "or analysis formats across conversations."
    ),
    tools=[bq_toolset, PreloadMemoryTool()],
    after_agent_callback=_save_memory,
)

app = App(
    name="data_science_agent",
    root_agent=root_agent,
)
Bu kodun ne yaptığını adım adım inceleyelim:
- BigQueryToolset, aracıya
execute_sql,list_table_idsveget_table_infogibi araçlar sunar. Bu araçlar, şemaları keşfedebilir ve arayanın erişebildiği tüm veri kümelerini sorgulayabilir. - PreloadMemoryTool, kullanıcının mesajıyla ilgili içerik için Memory Bank'te arama yaparak her LLM çağrısından önce ilgili anıları otomatik olarak alır.
_save_memorygeri arama işlevi, her temsilci çalıştırmasından sonra oturumu Memory Bank'te kalıcı hale getirir. Böylece temsilci, gelecekteki oturumlarda bağlamı hatırlayabilir. - Uygulama, kök aracıyı Agent Runtime'ın sunabileceği dağıtılabilir bir uygulamaya sarmalar.
name, dizin adıyla (data_science_agent) eşleşmelidir.adk web, temsilciyi bulup yüklemek için bunu kullanır. - Talimat, ajana SQL sorguları için faturalandırma projesini kullanmasını ve kullanıcı tercihlerini hatırlamasını söylüyor.
client_kwargs={"location": "global"}ile Gemini, model çağrılarınıgemini-3.8-flash'ün kullanılabildiği küresel uç noktaya gönderir. Ajanın kendisius-central1içinde çalışır:adk deploy, dağıtılan ajandaGOOGLE_CLOUD_LOCATION'ı dağıtım yaptığınız bölgeye ayarlar. Bu nedenle, modelin konumu kodda ayarlanır.
4. Agent Runtime'a dağıtma
data_science_agent dizininde requirements.txt dosyası oluşturun:
google-adk
google-genai
google-auth
google-cloud-bigquery
python-dotenv
opentelemetry-instrumentation-google-genai
opentelemetry-instrumentation-httpx
opentelemetry-instrumentation-grpc
google-adkvegoogle-genai: ADK ve Gemini istemcisigoogle-auth: Google Cloud kimlik doğrulamasıgoogle-cloud-bigquery:BigQueryToolsettarafından kullanılan BigQuery istemci kitaplığı. ADK, bu özelliği varsayılan olarak yüklemez.python-dotenv: Başlangıçta.envdosyasını yükler.- Üç
opentelemetry-instrumentation-*paket, daha sonra keşfedeceğiniz gözlemlenebilirlik özelliklerini etkinleştirir. İzlerin aracınızın İzler sekmesinde görünmesi için Gemini modeli çağrılarını ve dahili gRPC/HTTP iletişimini izlerler.
adk deploy, daha önce oluşturduğunuz data_science_agent/.env dosyasını da okur ve ayarlarını dağıtılan aracıya uygular.
Ajanı dağıtın. Son bağımsız değişken data_science_agent, aracı kodunuzu içeren dizindir:
uv run adk deploy agent_engine \
  --project=$(gcloud config get project) \
  --region=us-central1 \
  --display_name="Data Science Agent" \
  --otel_to_cloud \
  data_science_agent
Çıkışın başında, Ignoring GOOGLE_CLOUD_PROJECT in .env ... ve Ignoring GOOGLE_CLOUD_LOCATION in .env ... olmak üzere iki sarı çizgi gösteriliyor. Beklenen durum: --project ve --region işaretleri, .env içindeki aynı değerlere göre öncelikli olur.
İşaret | Amaç |
| Hedef Google Cloud projesi ve bölgesi |
| Cloud Console'da gösterilen, kullanıcı tarafından okunabilir ad |
| OpenTelemetry izlerini ve günlüklerini Google Cloud'a aktarır ve dağıtılan aracıda telemetriyi ( |
Agent Runtime'a dağıtıldığında iki özellik otomatik olarak etkinleştirilir:
- Memory Bank:
adk deploy, aracıyı Agent Runtime örneğindeki Oturumlar ve Memory Bank'a bağlar.PreloadMemoryTool, Bellek Bankası'ndan okur ve_save_memoryoturumları otomatik olarak kalıcı hale getirir. - Gözlemlenebilirlik: Cloud Trace, aracının akıl yürütme adımlarını, araç çağrılarını ve gecikmelerini yakalar.
5. BigQuery izinleri verme
BigQuery'ye Agent Runtime hizmet aracısına (AI Platform Reasoning Engine Service Agent) erişim izni vermeniz gerekir. Dağıtıldığında aracı, bu Google tarafından yönetilen hizmet hesabı olarak (kişisel kimlik bilgileriniz değil) çalışır. Bu nedenle, SQL sorgularını yürütmek için açık izinlere ihtiyacı vardır.
PROJECT_NUMBER=$(gcloud projects describe $(gcloud config get project) \
  --format='value(projectNumber)')

SA="service-${PROJECT_NUMBER}@gcp-sa-aiplatform-re.iam.gserviceaccount.com"

# Required to execute SQL queries
gcloud projects add-iam-policy-binding $(gcloud config get project) \
  --member="serviceAccount:${SA}" \
  --role="roles/bigquery.jobUser"

# Required to read table metadata and data
gcloud projects add-iam-policy-binding $(gcloud config get project) \
  --member="serviceAccount:${SA}" \
  --role="roles/bigquery.dataViewer"
Her komut başarılı olduğunda Updated IAM policy for project [...] yazdırır.
6. Dağıtılan Ajanı Test Etme
Google Cloud Console'da Dağıtımlar sayfasını açın. Dağıtılan temsilcinizi ve ardından Playground sekmesini tıklayın.
BigQuery özelliklerini test edin:
- "bigquery-public-data.hacker_news içindeki tabloları listele"
- Beklenen: Ajan,
list_table_idsişlevini çağırır vefulldahil olmak üzere tablo adlarını döndürür.
- Beklenen: Ajan,
- "bigquery-public-data.hacker_news.full içinde yıllık gönderi sayısını bul"
- Beklenen: Ajan,
execute_sql'ı bir SQL sorgusuyla çağırır ve yılların ve gönderi sayılarının yer aldığı bir tablo döndürür.
- Beklenen: Ajan,
- "Yayınlardaki yıldan yıla yüzde değişim nedir?"
- Beklenen: Ajan, yüzde değişimi hesaplayan ve sonuçları döndüren bir SQL sorgusuyla
execute_sqlişlevini çağırır.
- Beklenen: Ajan, yüzde değişimi hesaplayan ve sonuçları döndüren bir SQL sorgusuyla
7. Bellek Kalıcılığını Test Etme
Hâlâ Playground'dayken aracıya bir tercih öğretin:
- "Favori veri kümemin bigquery-public-data.hacker_news olduğunu unutma"
- "Hangi tabloları içeriyor?"
Belleğin kalıcı olması için birkaç saniye bekleyin (_save_memory geri çağırma işlevi, temsilci yanıt verdikten sonra çalışır).
Şimdi Playground'da Yeni Oturum'u tıklayarak yeni bir oturum başlatın ve şu soruyu sorun:
- "En sevdiğim veri kümesi hangisi?"
Ajan, görüşme geçmişi olmayan yeni bir oturum olmasına rağmen bigquery-public-data.hacker_news bilgisini hatırlamalıdır. Bu çözümün işe yaramasının nedeni:
_save_memory, her oturumdacallback_context.add_session_to_memory()aracılığıyla Bellek Bankası'nda kalıcı hale getirilir.PreloadMemoryToolHer LLM çağrısından önce ilgili anıları alır.- Hafıza Bankası, içeriği yalnızca anahtar kelimeye göre değil, semantik olarak da eşleştirir.
8. Gözlemlenebilirliği keşfedin
Cloud Console'da dağıtılan aracınıza gidin ve İzlemeler sekmesini tıklayın.
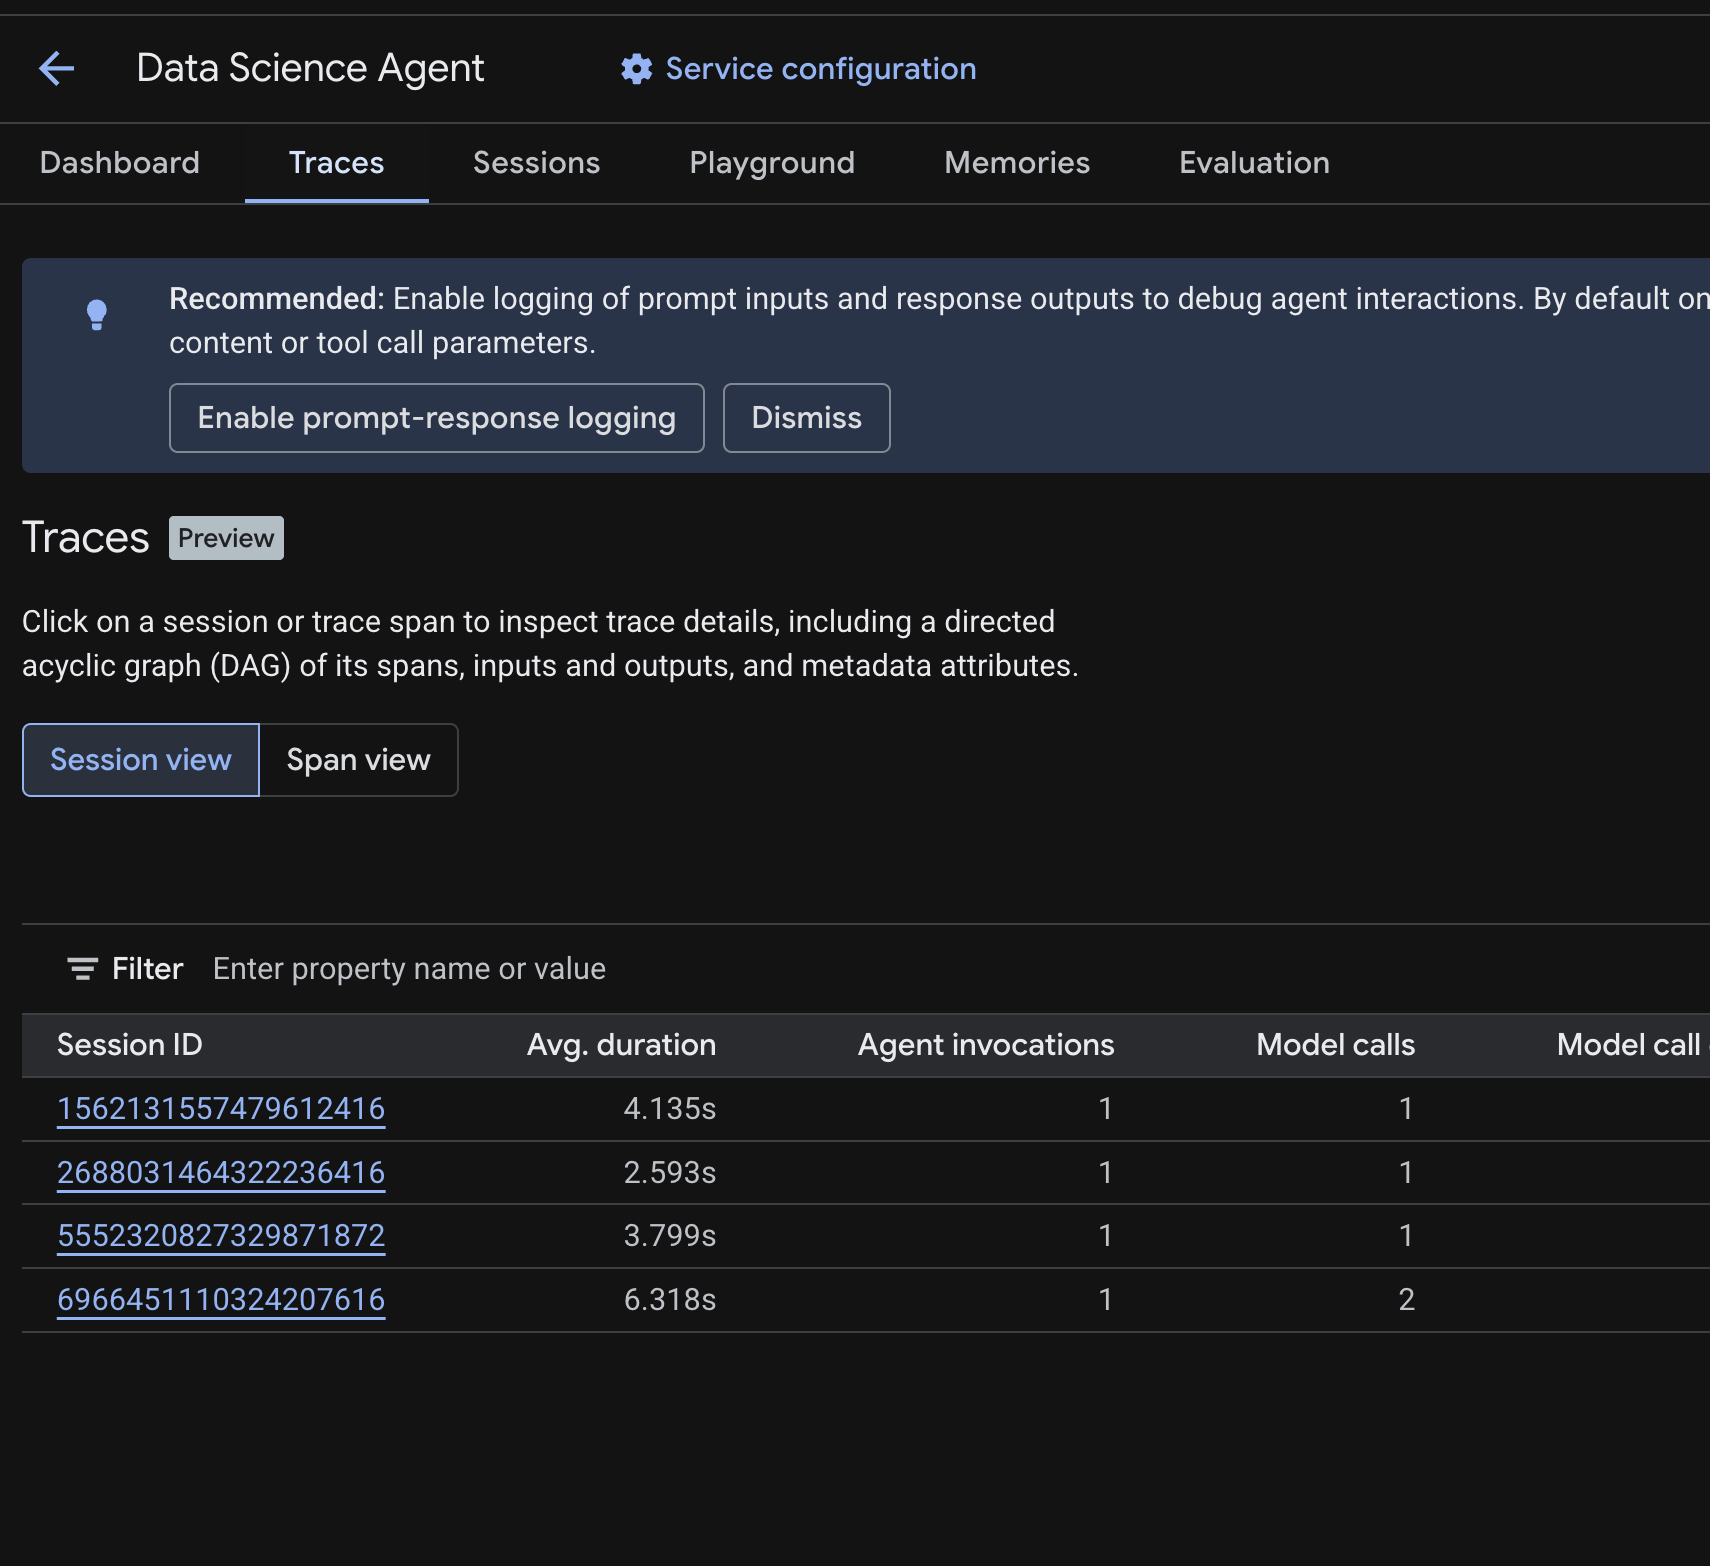
Önceki adımlarda çalıştırdığınız test sorgularından elde edilen oturumların listelendiği bir oturum tablosu görmeniz gerekir. Tabloda her oturumla ilgili özet metrikler (ortalama süre, model çağrıları, araç çağrıları, jeton kullanımı ve hatalar) gösterilir.
Aşağıdakiler de dahil olmak üzere izleme ayrıntılarını incelemek için bir oturumu tıklayın:
- Kapsamlarının yönlendirilmiş döngüsüz grafiği (DAG): Ajanın muhakemesinin, araç çağrılarının (BigQuery sorguları) ve gecikmelerin adım adım dökümünü gösterir.
- Her aralık için girişler ve çıkışlar (
.enviçindeOTEL_INSTRUMENTATION_GENAI_CAPTURE_MESSAGE_CONTENTortam değişkeni aracılığıyla etkinleştirilir) - Kapsam kimlikleri, izleme kimlikleri ve zamanlama gibi meta veri özellikleri
Tüm oturumlardaki tek tek aralıkları görmek için Aralık görünümüne de geçebilirsiniz (en üstteki açma/kapatma düğmesi).
İzleme özelliğinin işleyiş şekli
--otel_to_cloud ile dağıtım yaptığınızda adk deploy, OpenTelemetry'nin etkin olduğu ADK API sunucusunu çalıştıran bir kapsayıcı oluşturur. Agent Çalışma Zamanı'nda sunucu, aşağıdakileri yapan bir OpenTelemetry ardışık düzeni başlatır:
- Kapsamları
telemetry.googleapis.comkonumuna gönderen bir OTLP dışa aktarıcısıyla TracerProvider oluşturur. - Ajan çalıştırmaları, model çağrıları ve araç çağrıları için ADK'nın kendi kapsamlarını kaydeder ve
requirements.txt'ınızdaki üç enstrümantasyon paketini kullanarak önemli kitaplıklardan (Gemini, httpx, gRPC) kapsamlar ekler. - Kapsamları Telemetry API'ye toplu olarak gönderir ve dışa aktarır. İzler sekmesi bu kapsamları okur.
Dağıtılan kapsayıcıda ADK, OpenTelemetry SDK'sı ve dışa aktarıcı bulunur ancak enstrümantasyon paketleri bulunmaz. Bu nedenle requirements.txt listesinde üçü de gösterilir. Bu bilgiler olmadan ADK API sunucusu bir uyarı kaydeder ve bu aralıkları atlar.
Sorun giderme
Birkaç dakika sonra iz görünmüyorsa:
- Telemetry API'nin etkinleştirildiğini kontrol edin: Kurulum adımında etkinleştirmiş olmanız gerekir. Şununla doğrulayın:
gcloud services list --enabled --project=$(gcloud config get project) | grep telemetry - Uyarılar için Cloud Logging'i kontrol edin: Logging > Logs Explorer'a (Günlük Kaydı > Günlük Gezgini) gidin ve
"proceeding without"veya"GoogleGenAiSdkInstrumentor"simgesini arayın. Bir enstrümantasyonun (üretken yapay zeka, HTTPX veya gRPC) adının verildiği uyarı, eşleşenopentelemetry-instrumentation-*paketininrequirements.txt'nizde eksik olduğu anlamına gelir. requirements.txtgoogle-cloud-aiplatformeklemeyin.adk deploybunu otomatik olarak ekler. Kendiniz bildirmeniz OpenTelemetry paketi çakışmalarına neden olabilir ve enstrümantasyonu sessizce bozabilir.
9. Temizleme
Devam eden ücretleri önlemek için bu codelab sırasında oluşturulan kaynakları silin.
Cloud Console'daki Dağıtımlar sayfasından dağıtılan aracı silin. Temsilcinizi seçip Sil'i tıklayın.
Bu codelab için özel olarak bir proje oluşturduysanız bunun yerine projenin tamamını silebilirsiniz:
gcloud projects delete <YOUR_PROJECT_ID>
İsteğe bağlı olarak yerel ortamınızı temizleyin:
cd ~
rm -rf ~/adk-deploy-scale
10. Tebrikler
Durumlu bir veri bilimi aracısı oluşturup Agent Runtime'a dağıttınız.
Öğrendikleriniz
- Gerçek verilere erişmek için
BigQueryToolsetile ADK ajanı oluşturma PreloadMemoryToolveafter_agent_callbackkullanarak Memory Bank ile kalıcı belleği etkinleştirme- Dağıtılan aracının hizmet hesabı için IAM izinleri verme
- Agent Runtime'a dağıtma ve Cloud Trace ile gözlemlenebilirliği etkinleştirme
Sonraki adımlar
- Agent Runtime hizmet aracısına verilerinize erişim izni vererek kendi özel BigQuery veri kümelerinizi sorgulama
- Güvenli bir korumalı alanda Python analizi çalıştırmak için Kod Yürütme'yi ekleyin.
- Üretimdeki aracınızı izlemek için Cloud Trace gözlemlenebilirlik kontrol panellerini ayarlayın.
- MCP araçlarını kullanarak sonuçları Google Workspace'te yayınlama
Referans belgeleri
- ADK Dokümanları
- Agent Runtime Documentation (Ajan Çalışma Zamanı Belgeleri)
- Memory Bank Belgeleri
- Agent Runtime Dağıtım Kılavuzu