

1. 概览
在此 Codelab 中,您将构建一个数据科学代理,该代理可以查询 BigQuery 公共数据集中的真实数据,并记住您在不同会话中的偏好设置。然后,您将该代理部署到 Agent Runtime,这是一项全托管式 Google Cloud 服务,可处理基础设施、扩缩和会话管理。
智能体使用三种核心功能,这些功能会逐步激活:
- BigQuery 工具集:代理探索架构并针对真实的 BigQuery 数据集运行 SQL 查询,无论是在本地还是部署后,都可以正常运行。
- 记忆库:部署后,智能体可以记住用户在不连续会话中的偏好设置和上下文。
- 可观测性:Cloud Trace 通过 OpenTelemetry 插桩捕获智能体的推理步骤、工具调用和延迟时间。
学习内容
- 如何使用
BigQueryToolset创建 ADK 智能体以实现真实数据访问权限 - 如何配置记忆库以实现跨会话持久性
- 如何使用
adk deploy将智能体部署到 Agent Runtime - 如何为已部署的代理的服务账号授予 IAM 权限
- 如何测试内存持久性和可观测性
所需条件
- 启用了结算功能的 Google Cloud 项目
- 网络浏览器,例如 Chrome
- 如果您在自己的机器上运行代码,而不是在 Cloud Shell 中运行,则需要安装:Google Cloud SDK (
gcloudCLI)、uv(Python 软件包管理器)和 Python 3.12+(如果需要,uv会自动安装)
ADK(智能体开发套件)是 Google 用于构建 AI 智能体的框架。此 Codelab 使用 ADK 创建智能体并将其部署到 Agent Runtime。
本 Codelab 适用于对 Python 和 Google Cloud 有一定了解的中级开发者。
完成此 Codelab 大约需要 35 分钟(包括 5-10 分钟的部署时间)。
本 Codelab 中创建的资源费用应低于 5 美元。
2. 设置您的环境
创建 Google Cloud 项目
- 在 Google Cloud 控制台的项目选择器页面上,选择或创建一个 Google Cloud 项目。
- 确保您的 Cloud 项目已启用结算功能。了解如何检查项目是否已启用结算功能。
设置项目
在您创建的 GCP 项目中打开 Cloud Shell 编辑器。
然后,依次选择“终端”>“新建终端”,并运行以下命令来设置项目。后续命令会从此设置中读取项目 ID。
gcloud config set project <INSERT_YOUR_GCP_PROJECT_HERE>
启用 API
在终端中,运行以下命令。
gcloud services enable \
  aiplatform.googleapis.com \
  bigquery.googleapis.com \
  telemetry.googleapis.com \
  --project=$(gcloud config get project)
aiplatform.googleapis.com:在 Agent Runtime 上托管您的代理,包括 Gemini Enterprise 会话和记忆库,并为 Gemini 模型提供服务- BigQuery API (
bigquery.googleapis.com):针对公共数据集和私有数据集的 SQL 查询 - Telemetry API (
telemetry.googleapis.com):用于代理可观测性的 OpenTelemetry 轨迹
安装 ADK
在终端中,运行以下命令,为本 Codelab 创建一个文件夹,并安装 ADK 及其依赖项:
mkdir -p ~/adk-deploy-scale
cd ~/adk-deploy-scale
uv init --bare
uv add google-adk google-auth google-cloud-bigquery "google-cloud-aiplatform[agent_engines]"
uv 会为此 Codelab 创建一个隔离的 Python 环境,因此您无需激活任何内容。为 Python 命令添加 uv run 前缀。
google-adk 软件包包含 adk CLI 工具,您将使用该工具来测试和部署代理。adk deploy 使用 google-cloud-aiplatform 在 Agent Runtime 上创建智能体,而 google-cloud-bigquery 是 ADK 的 BigQuery 工具背后的客户端库。
3. 创建代理
在 ~/adk-deploy-scale 文件夹中,创建代理目录。从 ~/adk-deploy-scale(data_science_agent/ 的父级)运行所有后续命令:
mkdir data_science_agent
然后,运行以下命令以创建 data_science_agent/.env,其中包含您的项目、部署代理的区域以及已部署代理的设置。adk deploy 会读取此文件,因此即使您打开新终端,这些设置仍然有效。
cat > ~/adk-deploy-scale/data_science_agent/.env <<EOF
GOOGLE_CLOUD_PROJECT=$(gcloud config get project)
GOOGLE_CLOUD_LOCATION=us-central1
GOOGLE_GENAI_USE_ENTERPRISE=True
OTEL_INSTRUMENTATION_GENAI_CAPTURE_MESSAGE_CONTENT=true
EOF
GOOGLE_CLOUD_PROJECT和GOOGLE_CLOUD_LOCATION:您的项目 ID(从gcloud中填充)以及代理运行的区域GOOGLE_GENAI_USE_ENTERPRISE:通过您的 Google Cloud 项目调用 Gemini 的 ADKOTEL_INSTRUMENTATION_GENAI_CAPTURE_MESSAGE_CONTENT:记录完整的提示输入和代理响应,有助于进行调试
最终的目录结构将如下所示:
adk-deploy-scale/
  data_science_agent/
    .env
    __init__.py
    agent.py
    requirements.txt    # created in the Deploy step
您现在将创建 __init__.py 和 agent.py,然后在“部署”步骤中添加 requirements.txt。
创建 data_science_agent/__init__.py - 只有在拥有此文件时,ADK 才能发现并加载您的智能体:
from . import agent # noqa: F401 — required by `adk eval` and `adk web`
创建 data_science_agent/agent.py:
此代理会连接到 BigQuery 以提取数据,并将会话保留到 Memory Bank。
部署后,内存会自动激活。Agent Runtime 会设置 GOOGLE_CLOUD_AGENT_ENGINE_ID 环境变量,该变量在本地运行时不存在。
from __future__ import annotations

import os

from google.adk.agents import LlmAgent
from google.adk.agents.callback_context import CallbackContext
from google.adk.apps import App
from google.adk.integrations.bigquery import BigQueryCredentialsConfig
from google.adk.integrations.bigquery import BigQueryToolset
from google.adk.models import Gemini
from google.adk.tools.preload_memory_tool import PreloadMemoryTool
from google.genai import types
import google.auth

PROJECT_ID = os.getenv("GOOGLE_CLOUD_PROJECT")
if not PROJECT_ID:
    raise ValueError(
        "GOOGLE_CLOUD_PROJECT environment variable is required. "
        "Add it to data_science_agent/.env: GOOGLE_CLOUD_PROJECT=<your-project-id>"
    )

credentials, _ = google.auth.default()
bq_toolset = BigQueryToolset(credentials_config=BigQueryCredentialsConfig(credentials=credentials))

# GOOGLE_CLOUD_AGENT_ENGINE_ID is set automatically by Agent Runtime.
agent_engine_id = os.getenv("GOOGLE_CLOUD_AGENT_ENGINE_ID")


async def _save_memory(callback_context: CallbackContext) -> None:
    """Persist the session to Memory Bank after each agent run.

    Only activates on Agent Runtime, where Memory Bank is available.
    """
    if agent_engine_id:
        await callback_context.add_session_to_memory()


root_agent = LlmAgent(
    name="data_science_agent",
    model=Gemini(
        model="gemini-3.8-flash",
        # gemini-3.8-flash is served from the global endpoint. The agent
        # itself runs in GOOGLE_CLOUD_LOCATION (us-central1).
        client_kwargs={"location": "global"},
        retry_options=types.HttpRetryOptions(attempts=5),
    ),
    instruction=(
        "You are an expert Data Science Agent. "
        "Your goal is to query enterprise BigQuery datasets, analyze the data, "
        "and summarize your findings. "
        f"When executing SQL queries, use project_id `{PROJECT_ID}` as the "
        "billing project unless the user specifies a different one. "
        "Present results clearly with formatted numbers. "
        "Remember user preferences like preferred regions, date ranges, "
        "or analysis formats across conversations."
    ),
    tools=[bq_toolset, PreloadMemoryTool()],
    after_agent_callback=_save_memory,
)

app = App(
    name="data_science_agent",
    root_agent=root_agent,
)
我们来了解一下这段代码的作用:
- BigQueryToolset 为代理提供
execute_sql、list_table_ids和get_table_info等工具,使其能够探索架构并查询调用者有权访问的任何数据集。 - PreloadMemoryTool 会在每次调用 LLM 之前,通过在记忆库中搜索与用户消息相关的内容,自动检索相关记忆。
_save_memory回调会在每次智能体运行后将对话会话持久保存到记忆库,以便智能体在未来的对话会话中回忆起上下文。 - 应用将根代理封装到可供 Agent Runtime 服务的可部署应用中。
name必须与目录名称 (data_science_agent) 一致,adk web会使用此名称来查找和加载代理。 - 指令会告知代理使用结算项目来执行 SQL 查询,并记住用户偏好设置。
- 使用
client_kwargs={"location": "global"}的 Gemini 会将模型调用发送到gemini-3.8-flash可用的全球端点。代理本身在us-central1中运行:adk deploy会将已部署代理上的GOOGLE_CLOUD_LOCATION设置为您部署到的区域,因此模型的位置是在代码中设置的。
4. 部署到 Agent Runtime
在 data_science_agent 目录中创建一个 requirements.txt 文件:
google-adk
google-genai
google-auth
google-cloud-bigquery
python-dotenv
opentelemetry-instrumentation-google-genai
opentelemetry-instrumentation-httpx
opentelemetry-instrumentation-grpc
google-adk和google-genai:ADK 和 Gemini 客户端google-auth:Google Cloud 身份验证google-cloud-bigquery:BigQueryToolset使用的 BigQuery 客户端库。ADK 默认不会安装它。python-dotenv:在启动时加载.env文件- 这三个
opentelemetry-instrumentation-*软件包可实现您将在后续课程中探索的可观测性功能。它们会检测 Gemini 模型调用和内部 gRPC/HTTP 通信,以便轨迹显示在智能体的轨迹标签页上。
adk deploy 还会读取您之前创建的 data_science_agent/.env 文件,并将其设置应用于已部署的代理。
部署代理。最后一个实参 data_science_agent 是包含智能体代码的目录:
uv run adk deploy agent_engine \
  --project=$(gcloud config get project) \
  --region=us-central1 \
  --display_name="Data Science Agent" \
  --otel_to_cloud \
  data_science_agent
在输出的开头附近,您会看到两行黄色文字,即 Ignoring GOOGLE_CLOUD_PROJECT in .env ... 和 Ignoring GOOGLE_CLOUD_LOCATION in .env ...。这是预期行为:--project 和 --region 标志优先于 .env 中的相同值。
标志 | 用途 |
| 目标 Google Cloud 项目和区域 |
| 在 Cloud 控制台中显示的人类可读名称 |
| 将 OpenTelemetry 跟踪记录和日志导出到 Google Cloud,并在已部署的代理上开启遥测 ( |
部署到 Agent Runtime 时,系统会自动启用两项功能:
- 记忆库:
adk deploy将代理连接到其 Agent Runtime 实例上的会话和记忆库。PreloadMemoryTool从记忆库读取数据,_save_memory自动保留会话。 - 可观测性:Cloud Trace 可捕获智能体的推理步骤、工具调用和延迟时间。
5. 授予 BigQuery 权限
您需要向 Agent Runtime 服务代理(AI Platform 推理引擎服务代理)授予 BigQuery 访问权限。部署后,代理会以这个由 Google 管理的服务账号(而不是您的个人凭据)运行,因此需要明确的权限才能执行 SQL 查询。
PROJECT_NUMBER=$(gcloud projects describe $(gcloud config get project) \
  --format='value(projectNumber)')

SA="service-${PROJECT_NUMBER}@gcp-sa-aiplatform-re.iam.gserviceaccount.com"

# Required to execute SQL queries
gcloud projects add-iam-policy-binding $(gcloud config get project) \
  --member="serviceAccount:${SA}" \
  --role="roles/bigquery.jobUser"

# Required to read table metadata and data
gcloud projects add-iam-policy-binding $(gcloud config get project) \
  --member="serviceAccount:${SA}" \
  --role="roles/bigquery.dataViewer"
每个命令在成功执行后都会输出 Updated IAM policy for project [...]。
6. 测试已部署的智能体
在 Google Cloud 控制台中打开“部署”页面。点击已部署的代理,然后点击测试场标签页。
测试 BigQuery 功能:
- “列出 bigquery-public-data.hacker_news 中的表”
- 预期:智能体调用
list_table_ids并返回包含full的表名称。
- 预期:智能体调用
- “在 bigquery-public-data.hacker_news.full 中查找每年发布的帖子数量”
- 预期:智能体使用 SQL 查询调用
execute_sql,并返回包含年份和帖子数量的表格。
- 预期:智能体使用 SQL 查询调用
- “帖子数量的年同比百分比变化是多少?”
- 预期:智能体使用计算百分比变化的 SQL 查询调用
execute_sql并返回结果。
- 预期:智能体使用计算百分比变化的 SQL 查询调用
7. 测试内存持久性
仍在 Playground 中,向智能体传达偏好:
- “记住,我最喜欢的数据集是 bigquery-public-data.hacker_news”
- “它包含哪些表?”
等待几秒钟,让记忆持久保存(智能体做出回答后,系统会运行 _save_memory 回调)。
现在,点击 Playground 中的新会话开始新会话,然后提出以下问题:
- “我最喜欢的数据集是什么?”
即使这是没有对话历史记录的全新会话,智能体也应回忆起 bigquery-public-data.hacker_news。此方法有效的原因如下:
_save_memory通过callback_context.add_session_to_memory()将每个会话持久保存到记忆库PreloadMemoryTool在每次 LLM 调用之前检索相关记忆- 记忆库会根据语义(而不仅仅是关键字)匹配内容
8. 探索可观测性
在 Cloud 控制台中,前往已部署的代理,然后点击轨迹标签页。
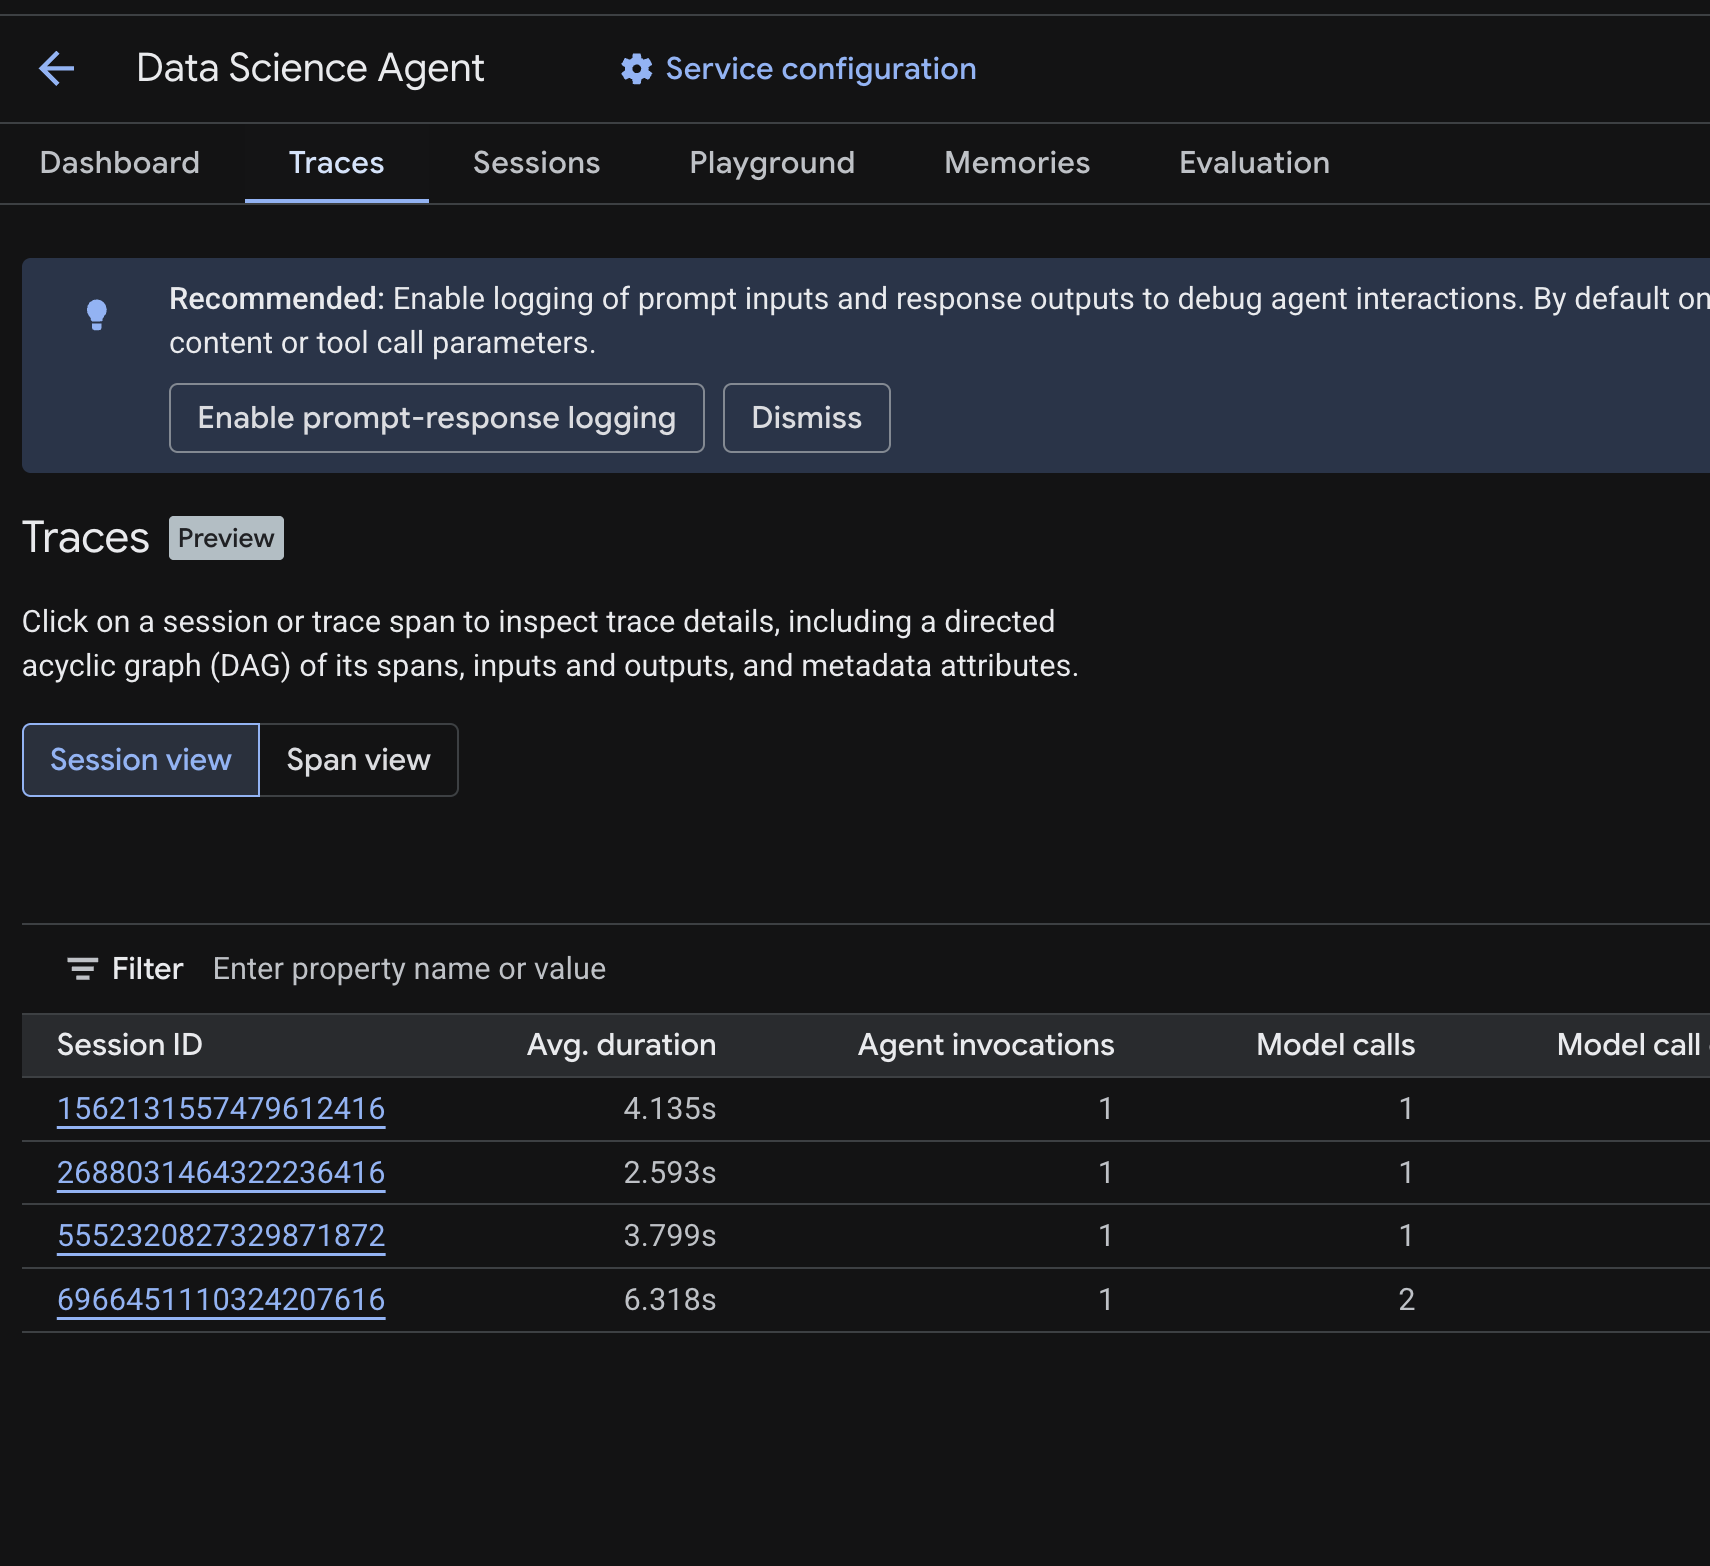
您应该会看到一个会话表,其中列出了您在之前步骤中运行的测试查询中的会话。该表格显示了每个会话的汇总指标,包括平均时长、模型调用次数、工具调用次数、token 使用情况和所有错误。
点击会话可检查其跟踪记录详情,包括:
- 其 span 的有向无环图 (DAG) - 显示了智能体推理、工具调用 (BigQuery 查询) 和延迟时间的逐步细分
- 每个 span 的输入和输出(通过
.env中的OTEL_INSTRUMENTATION_GENAI_CAPTURE_MESSAGE_CONTENT环境变量启用) - span ID、trace ID 和时间等元数据属性
您还可以切换到跨度视图(顶部切换开关),查看所有会话中的各个跨度。
追踪功能的运作方式
当您使用 --otel_to_cloud 进行部署时,adk deploy 会构建一个容器,该容器运行已开启 OpenTelemetry 的 ADK API 服务器。在 Agent Runtime 上,服务器会初始化一个 OpenTelemetry 流水线,该流水线:
- 创建具有 OTLP 导出器的 TracerProvider,该导出器会将 span 发送到
telemetry.googleapis.com - 记录 ADK 自身的 span,用于智能体运行、模型调用和工具调用,并使用
requirements.txt中的三个插桩软件包来添加来自关键库(Gemini、httpx、gRPC)的 span - 将批次和 span 导出到 Telemetry API,然后“轨迹”标签页会读取这些数据
部署的容器包含 ADK 以及 OpenTelemetry SDK 和导出器,但不包含插桩软件包。因此,requirements.txt 会列出所有这三项。如果没有这些信息,ADK API 服务器会记录一条警告并跳过这些 span。
问题排查
如果几分钟后未显示任何轨迹:
- 检查 Telemetry API 是否已启用:您在设置步骤中已启用该 API。通过以下方式验证:
gcloud services list --enabled --project=$(gcloud config get project) | grep telemetry - 检查 Cloud Logging 中是否有警告:前往 Logging > 日志浏览器,然后搜索
"proceeding without"或"GoogleGenAiSdkInstrumentor"。如果警告中提及某项插桩(GenAI、HTTPX 或 gRPC),则表示您的requirements.txt中缺少匹配的opentelemetry-instrumentation-*软件包。 - 请勿向
requirements.txt添加google-cloud-aiplatform。adk deploy会自动添加它;自行声明可能会导致 OpenTelemetry 软件包冲突,并悄然中断插桩。
9. 清理
为避免持续产生费用,请删除在本 Codelab 中创建的资源。
在 Cloud 控制台的“部署”页面中删除已部署的代理。选择您的代理,然后点击删除。
如果您专门为此 Codelab 创建了一个项目,可以改为删除整个项目:
gcloud projects delete <YOUR_PROJECT_ID>
(可选)清理本地环境:
cd ~
rm -rf ~/adk-deploy-scale
10. 恭喜
您已构建了一个有状态的数据科学智能体,并将其部署到 Agent Runtime!
您学到的内容
- 如何使用
BigQueryToolset创建 ADK 智能体以实现真实数据访问权限 - 如何使用
PreloadMemoryTool和after_agent_callback通过记忆库启用持久性内存 - 如何为已部署的代理的服务账号授予 IAM 权限
- 如何部署到 Agent Runtime 并使用 Cloud Trace 启用可观测性
后续步骤
- 通过向 Agent Runtime 服务代理授予数据访问权限,查询您自己的私有 BigQuery 数据集
- 添加代码执行功能,以便在安全的沙盒中运行 Python 分析
- 设置 Cloud Trace 可观测性信息中心,以监控生产环境中的代理
- 使用 MCP 工具将结果发布到 Google Workspace