

1. 總覽
在本程式碼研究室中,您將建構資料科學代理程式,從 BigQuery 公開資料集查詢實際資料,並在不同工作階段中記住您的偏好設定。接著,您會將其部署至 Agent Runtime,這項全代管的 Google Cloud 服務可處理基礎架構、資源調度和工作階段管理。
代理會逐步啟用三項核心功能:
- BigQuery 工具集:代理程式會探索結構定義,並針對實際的 BigQuery 資料集執行 SQL 查詢,無論是本機或部署作業都適用。
- Memory Bank:部署後,代理程式會記住使用者偏好設定和脈絡,即使工作階段中斷也不例外。
- 可觀測性:Cloud Trace 會透過 OpenTelemetry 檢測,擷取代理的推論步驟、工具呼叫和延遲時間。
課程內容
- 如何使用
BigQueryToolset建立 ADK 代理,存取真實資料 - 如何設定 Memory Bank,啟用跨工作階段持續性
- 如何使用
adk deploy將代理部署至 Agent Runtime - 如何為已部署代理程式的服務帳戶授予 IAM 權限
- 如何測試記憶體持久性和可觀測性
軟硬體需求
- 已啟用計費功能的 Google Cloud 雲端專案
- 網路瀏覽器,例如 Chrome
- 如果您是在自己的電腦上執行程式碼,而不是在 Cloud Shell 中執行:Google Cloud SDK (
gcloudCLI)、uv (Python 套件管理工具) 和 Python 3.12 以上版本 (如果需要,uv會自動安裝)
ADK (Agent Development Kit) 是 Google 用於建構 AI 代理的架構。本程式碼實驗室會使用 ADK 建立代理,並將其部署至 Agent Runtime。
本程式碼實驗室適合對 Python 和 Google Cloud 有基本認識的中級開發人員。
完成這項程式碼研究室大約需要 35 分鐘 (包括部署作業的 5 到 10 分鐘)。
本程式碼研究室建立的資源費用應低於 $5 美元。
2. 設定環境
建立 Google Cloud 專案
- 在 Google Cloud 控制台的專案選擇器頁面中,選取或建立 Google Cloud 專案。
- 確認 Cloud 專案已啟用計費功能。瞭解如何檢查專案是否已啟用計費功能。
設定專案
在您建立的 GCP 專案中開啟 Cloud Shell 編輯器。
然後建立「Terminal」>「New Terminal」,並執行下列指令來設定專案。後續指令會從這項設定讀取專案 ID。
gcloud config set project <INSERT_YOUR_GCP_PROJECT_HERE>
啟用 API
在終端機執行下列指令。
gcloud services enable \
  aiplatform.googleapis.com \
  bigquery.googleapis.com \
  telemetry.googleapis.com \
  --project=$(gcloud config get project)
aiplatform.googleapis.com:在 Agent Runtime 上代管代理,包括 Gemini Enterprise 工作階段和 Memory Bank,並提供 Gemini 模型- BigQuery API (
bigquery.googleapis.com):針對公開和私人資料集執行 SQL 查詢 - Telemetry API (
telemetry.googleapis.com):用於代理觀測的 OpenTelemetry 追蹤記錄
安裝 ADK
在終端機執行下列指令,為本程式碼研究室建立資料夾,並安裝 ADK 和其依附元件:
mkdir -p ~/adk-deploy-scale
cd ~/adk-deploy-scale
uv init --bare
uv add google-adk google-auth google-cloud-bigquery "google-cloud-aiplatform[agent_engines]"
uv 會為這個程式碼研究室建立獨立的 Python 環境,因此您不需要啟用任何項目。在 Python 指令前加上 uv run。
google-adk 套件包含 adk CLI 工具,可用於測試及部署代理程式。adk deploy 會使用 google-cloud-aiplatform 在 Agent Runtime 上建立代理,而 google-cloud-bigquery 是 ADK BigQuery 工具背後的用戶端程式庫。
3. 建立代理程式
在 ~/adk-deploy-scale 資料夾中,建立代理程式目錄。從 ~/adk-deploy-scale (data_science_agent/ 的父項) 執行所有後續指令:
mkdir data_science_agent
然後執行下列指令,使用專案、要部署代理的區域,以及已部署代理的設定,建立 data_science_agent/.env。adk deploy 會讀取這個檔案,因此開啟新的終端機時,這些設定仍會生效。
cat > ~/adk-deploy-scale/data_science_agent/.env <<EOF
GOOGLE_CLOUD_PROJECT=$(gcloud config get project)
GOOGLE_CLOUD_LOCATION=us-central1
GOOGLE_GENAI_USE_ENTERPRISE=True
OTEL_INSTRUMENTATION_GENAI_CAPTURE_MESSAGE_CONTENT=true
EOF
GOOGLE_CLOUD_PROJECT和GOOGLE_CLOUD_LOCATION:您的專案 ID (從gcloud填入) 和代理程式執行的區域GOOGLE_GENAI_USE_ENTERPRISE:透過 Google Cloud 專案呼叫 Gemini 的 ADKOTEL_INSTRUMENTATION_GENAI_CAPTURE_MESSAGE_CONTENT:記錄完整的提示詞輸入內容和代理程式回覆,有助於偵錯
最終的目錄結構如下所示:
adk-deploy-scale/
  data_science_agent/
    .env
    __init__.py
    agent.py
    requirements.txt    # created in the Deploy step
您現在要建立 __init__.py 和 agent.py,然後在「部署」步驟中新增 requirements.txt。
建立 data_science_agent/__init__.py:ADK 需要這個檔案才能偵測及載入代理:
from . import agent # noqa: F401 — required by `adk eval` and `adk web`
建立 data_science_agent/agent.py:
這個代理程式會連線至 BigQuery 擷取資料,並將工作階段保留在記憶體庫中。
記憶體會在部署時自動啟用。Agent Runtime 會設定 GOOGLE_CLOUD_AGENT_ENGINE_ID 環境變數,在本機執行時則不會。
from __future__ import annotations

import os

from google.adk.agents import LlmAgent
from google.adk.agents.callback_context import CallbackContext
from google.adk.apps import App
from google.adk.integrations.bigquery import BigQueryCredentialsConfig
from google.adk.integrations.bigquery import BigQueryToolset
from google.adk.models import Gemini
from google.adk.tools.preload_memory_tool import PreloadMemoryTool
from google.genai import types
import google.auth

PROJECT_ID = os.getenv("GOOGLE_CLOUD_PROJECT")
if not PROJECT_ID:
    raise ValueError(
        "GOOGLE_CLOUD_PROJECT environment variable is required. "
        "Add it to data_science_agent/.env: GOOGLE_CLOUD_PROJECT=<your-project-id>"
    )

credentials, _ = google.auth.default()
bq_toolset = BigQueryToolset(credentials_config=BigQueryCredentialsConfig(credentials=credentials))

# GOOGLE_CLOUD_AGENT_ENGINE_ID is set automatically by Agent Runtime.
agent_engine_id = os.getenv("GOOGLE_CLOUD_AGENT_ENGINE_ID")


async def _save_memory(callback_context: CallbackContext) -> None:
    """Persist the session to Memory Bank after each agent run.

    Only activates on Agent Runtime, where Memory Bank is available.
    """
    if agent_engine_id:
        await callback_context.add_session_to_memory()


root_agent = LlmAgent(
    name="data_science_agent",
    model=Gemini(
        model="gemini-3.8-flash",
        # gemini-3.8-flash is served from the global endpoint. The agent
        # itself runs in GOOGLE_CLOUD_LOCATION (us-central1).
        client_kwargs={"location": "global"},
        retry_options=types.HttpRetryOptions(attempts=5),
    ),
    instruction=(
        "You are an expert Data Science Agent. "
        "Your goal is to query enterprise BigQuery datasets, analyze the data, "
        "and summarize your findings. "
        f"When executing SQL queries, use project_id `{PROJECT_ID}` as the "
        "billing project unless the user specifies a different one. "
        "Present results clearly with formatted numbers. "
        "Remember user preferences like preferred regions, date ranges, "
        "or analysis formats across conversations."
    ),
    tools=[bq_toolset, PreloadMemoryTool()],
    after_agent_callback=_save_memory,
)

app = App(
    name="data_science_agent",
    root_agent=root_agent,
)
讓我們逐步瞭解這段程式碼的作用:
- BigQueryToolset 會提供
execute_sql、list_table_ids和get_table_info等工具給代理程式,方便探索架構及查詢呼叫端可存取的任何資料集。 - PreloadMemoryTool 會在每次 LLM 呼叫前,搜尋 Memory Bank 中與使用者訊息相關的內容,自動檢索相關記憶。每次執行代理後,
_save_memory回呼都會將工作階段保留在 Memory Bank 中,因此代理可以在日後的工作階段中回顧脈絡。 - App 會將根代理程式包裝成可部署的應用程式,供 Agent Runtime 提供服務。
name必須與目錄名稱 (data_science_agent) 相符,adk web會使用這個名稱尋找並載入代理程式。 - 指令會告知代理程式使用帳單專案進行 SQL 查詢,並記住使用者偏好設定。
- Gemini with
client_kwargs={"location": "global"}會將模型呼叫傳送至全球端點,也就是gemini-3.8-flash適用的地方。代理本身會在us-central1中執行:adk deploy會在部署的代理上將GOOGLE_CLOUD_LOCATION設為您部署的區域,因此模型的所在位置會在程式碼中設定。
4. 部署至 Agent Runtime
在 data_science_agent 目錄中建立 requirements.txt 檔案:
google-adk
google-genai
google-auth
google-cloud-bigquery
python-dotenv
opentelemetry-instrumentation-google-genai
opentelemetry-instrumentation-httpx
opentelemetry-instrumentation-grpc
google-adk和google-genai:ADK 和 Gemini 用戶端google-auth:Google Cloud 驗證google-cloud-bigquery:BigQueryToolset使用的 BigQuery 用戶端程式庫。ADK 不會預設安裝這項工具。python-dotenv:在啟動時載入.env檔案- 這三個
opentelemetry-instrumentation-*套件可啟用稍後會介紹的可觀測性功能。這些攔截器會檢測 Gemini 模型呼叫和內部 gRPC/HTTP 通訊,以便在代理程式的「追蹤」分頁中顯示追蹤記錄。
adk deploy 也會讀取您先前建立的 data_science_agent/.env 檔案,並在部署的代理程式上設定。
部署代理。最後一個引數 data_science_agent 是包含代理程式碼的目錄:
uv run adk deploy agent_engine \
  --project=$(gcloud config get project) \
  --region=us-central1 \
  --display_name="Data Science Agent" \
  --otel_to_cloud \
  data_science_agent
在輸出內容的開頭附近,會顯示兩條黃線 Ignoring GOOGLE_CLOUD_PROJECT in .env ... 和 Ignoring GOOGLE_CLOUD_LOCATION in .env ...。預期行為:--project 和 --region 旗標會優先於 .env 中的相同值。
檢舉 | 目的 |
| 目標 Google Cloud 雲端專案和區域 |
| 顯示在 Cloud 控制台中的人類可讀名稱 |
| 將 OpenTelemetry 追蹤記錄和記錄匯出至 Google Cloud,並在部署的代理程式上開啟遙測功能 ( |
部署至 Agent Runtime 後,系統會自動啟用兩項功能:
- 記憶庫:
adk deploy將代理連結至 Agent Runtime 執行個體上的工作階段和記憶庫。PreloadMemoryTool會從 Memory Bank 讀取資料,並自動保留工作階段。_save_memory - 觀測能力:Cloud Trace 會擷取代理的推論步驟、工具呼叫和延遲時間。
5. 授予 BigQuery 權限
您必須授予 BigQuery 存取權給 Agent Runtime 服務代理程式 (AI Platform Reasoning Engine 服務代理程式)。部署後,代理程式會以這個 Google 代管的服務帳戶 (而非您的個人憑證) 執行,因此需要明確的權限才能執行 SQL 查詢。
PROJECT_NUMBER=$(gcloud projects describe $(gcloud config get project) \
  --format='value(projectNumber)')

SA="service-${PROJECT_NUMBER}@gcp-sa-aiplatform-re.iam.gserviceaccount.com"

# Required to execute SQL queries
gcloud projects add-iam-policy-binding $(gcloud config get project) \
  --member="serviceAccount:${SA}" \
  --role="roles/bigquery.jobUser"

# Required to read table metadata and data
gcloud projects add-iam-policy-binding $(gcloud config get project) \
  --member="serviceAccount:${SA}" \
  --role="roles/bigquery.dataViewer"
每個指令成功執行時,都會列印 Updated IAM policy for project [...]。
6. 測試已部署的代理
在 Google Cloud 控制台中開啟「Deployments」(部署) 頁面。點選已部署的代理,然後按一下「Playground」分頁標籤。
測試 BigQuery 功能:
- 「List the tables in bigquery-public-data.hacker_news」(列出 bigquery-public-data.hacker_news 中的資料表)
- 預期行為:代理程式會呼叫
list_table_ids,並傳回包含full的資料表名稱。
- 預期行為:代理程式會呼叫
- 「Find the number of posts per year in bigquery-public-data.hacker_news.full」(在 bigquery-public-data.hacker_news.full 中找出每年發布的貼文數量)
- 預期行為:代理會使用 SQL 查詢呼叫
execute_sql,並傳回年份和貼文計數的表格。
- 預期行為:代理會使用 SQL 查詢呼叫
- 「貼文的年增率百分比變化是多少?」
- 預期:代理會使用計算百分比變化的 SQL 查詢呼叫
execute_sql,並傳回結果。
- 預期:代理會使用計算百分比變化的 SQL 查詢呼叫
7. 測試記憶體持續性
在 Playground 中,教導代理偏好設定:
- 「Remember that my favorite dataset is bigquery-public-data.hacker_news」(請記住我最愛的資料集是 bigquery-public-data.hacker_news)
- 「這個資料集有哪些表格?」
等待幾秒鐘,讓記憶體持續存在 (代理程式回覆後,系統會執行 _save_memory 回呼)。
現在請在 Playground 中按一下「New Session」,開始新的工作階段,然後提出以下問題:
- 「我最喜歡的資料集是什麼?」
即使這是沒有對話記錄的全新工作階段,代理程式也應回想 bigquery-public-data.hacker_news。運作原理:
_save_memory會在每個工作階段透過callback_context.add_session_to_memory()持續儲存至 Memory BankPreloadMemoryTool在每次呼叫 LLM 前,檢索相關記憶- Memory Bank 會比對內容的語意,而不只是關鍵字
8. 探索 Observability
在 Cloud 控制台中,前往已部署的代理程式,然後按一下「追蹤」分頁。
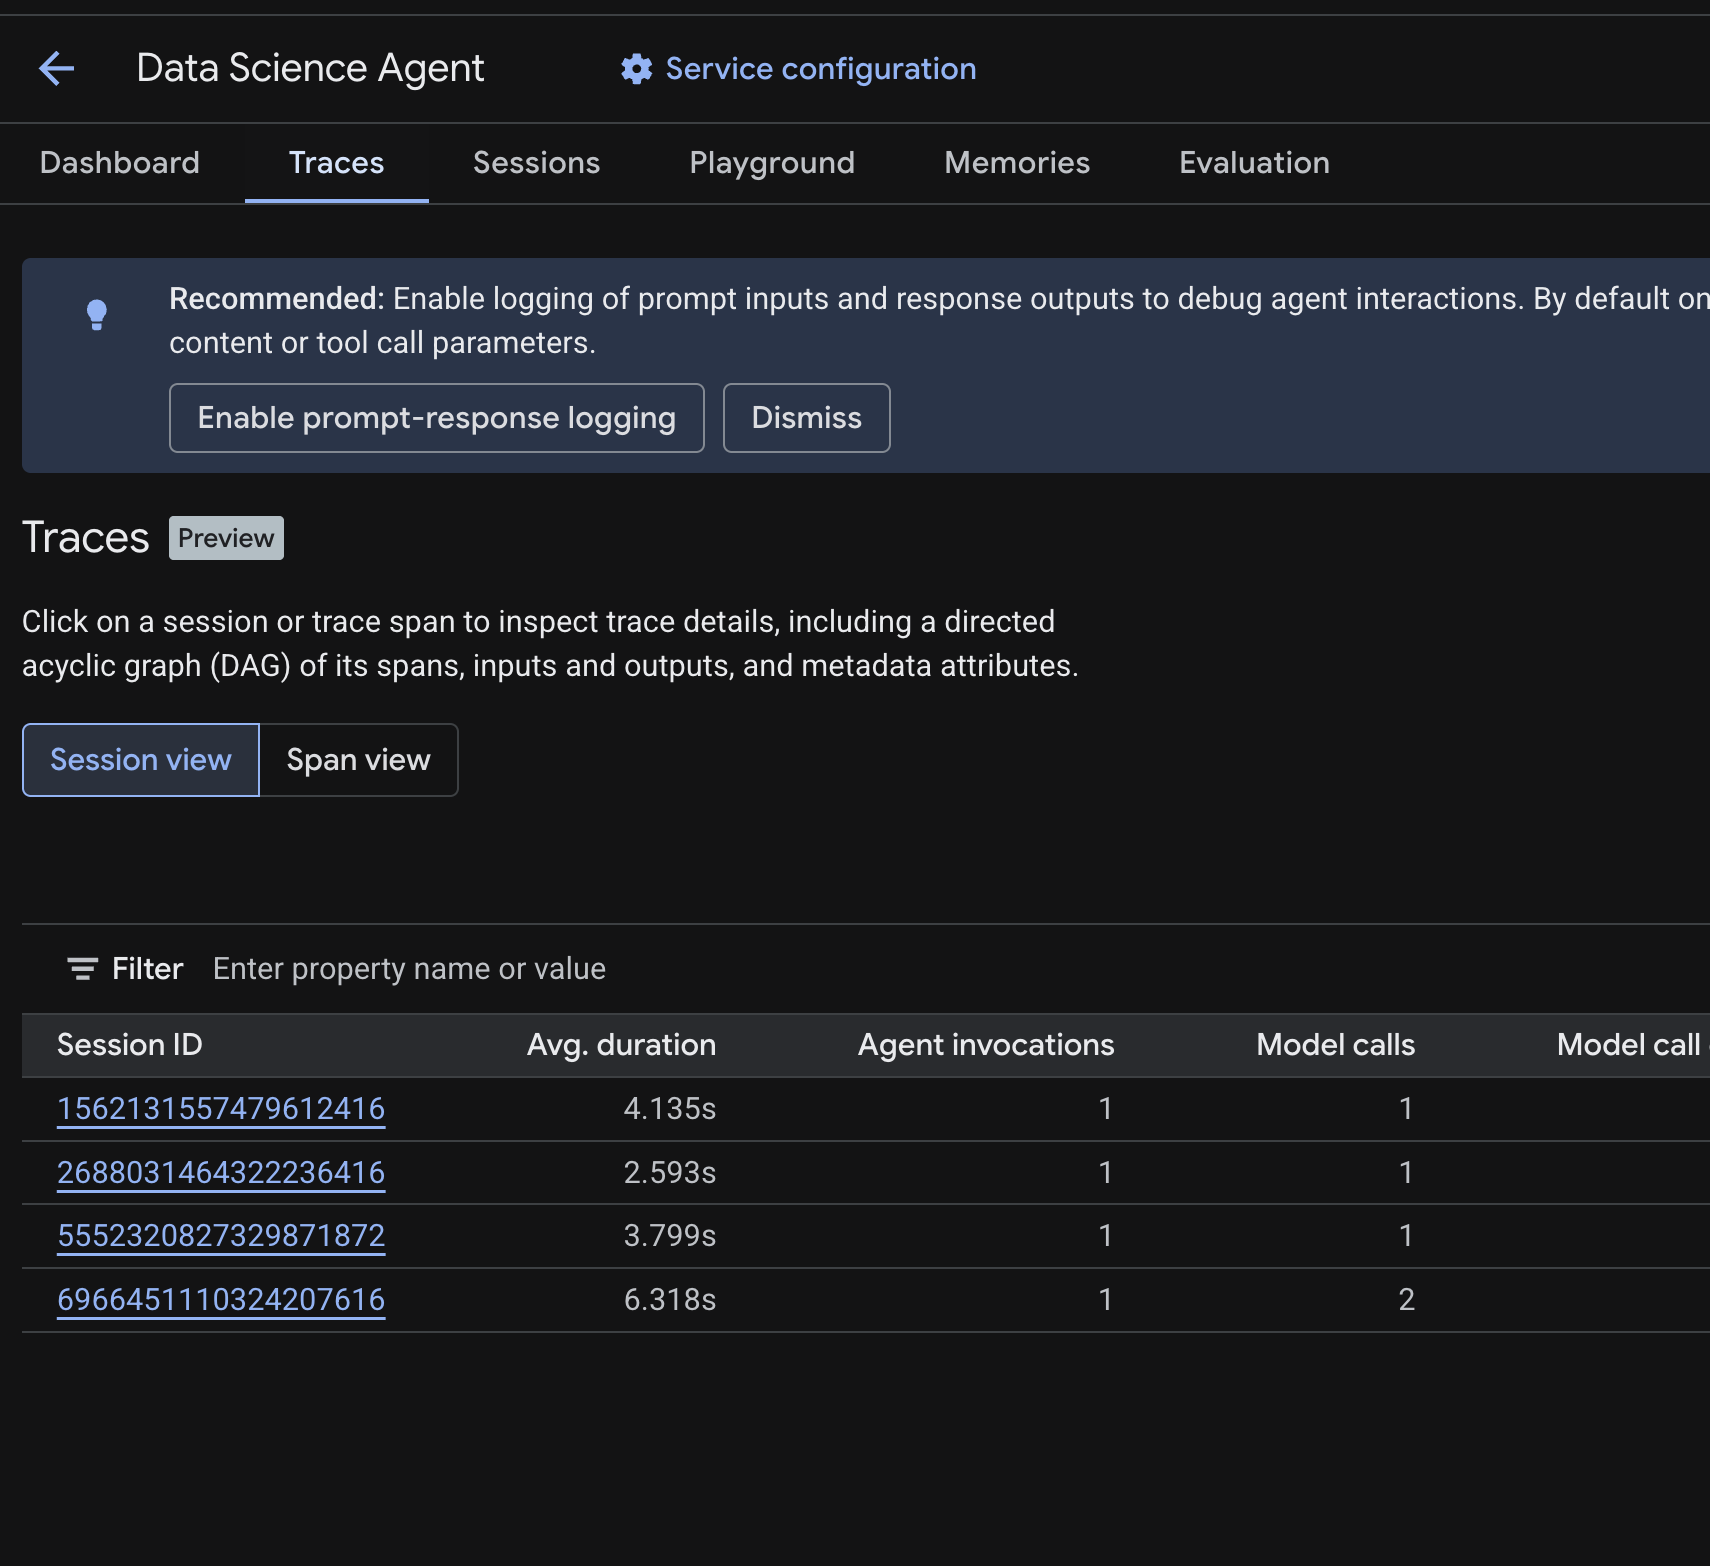
您應該會看到「工作階段資料表」,列出您在先前步驟中執行的測試查詢工作階段。表格會顯示每個工作階段的摘要指標,包括平均時間、模型呼叫、工具呼叫、權杖用量和任何錯誤。
點選工作階段即可查看追蹤記錄詳細資料,包括:
- 代理程式跨度的有向無環圖 (DAG),顯示代理程式推論、工具呼叫 (BigQuery 查詢) 和延遲時間的逐步細目
- 每個範圍的輸入和輸出 (透過
.env中的OTEL_INSTRUMENTATION_GENAI_CAPTURE_MESSAGE_CONTENT環境變數啟用) - 中繼資料屬性,例如時距 ID、追蹤 ID 和時間
你也可以切換至「範圍檢視」 (頂端的切換按鈕),查看所有工作階段的個別範圍。
追蹤功能的運作方式
使用 --otel_to_cloud 部署時,adk deploy 會建構容器,並執行已啟用 OpenTelemetry 的 ADK API 伺服器。在 Agent Runtime 中,伺服器會初始化 OpenTelemetry 管道,該管道會執行下列操作:
- 建立 TracerProvider,其中包含將範圍傳送至
telemetry.googleapis.com的 OTLP 匯出器 - 記錄 ADK 自己的代理執行、模型呼叫和工具呼叫跨度,並使用
requirements.txt中的三個檢測套件,從重要程式庫 (Gemini、httpx、gRPC) 新增跨度 - 將批次和匯出範圍傳送至 Telemetry API,然後「追蹤」分頁會讀取這些範圍
部署的容器包含 ADK、OpenTelemetry SDK 和匯出工具,但不包含檢測套件。因此 requirements.txt 會列出所有三項。如果沒有這些標記,ADK API 伺服器會記錄警告並略過這些範圍。
疑難排解
如果幾分鐘後仍未顯示任何追蹤記錄:
- 確認已啟用 Telemetry API:您在設定步驟中啟用此 API。驗證方式:
gcloud services list --enabled --project=$(gcloud config get project) | grep telemetry - 檢查 Cloud Logging 是否有警告:依序前往「Logging」>「Logs Explorer」,然後搜尋
"proceeding without"或"GoogleGenAiSdkInstrumentor"。如果警告提及某項檢測 (GenAI、HTTPX 或 gRPC),表示requirements.txt中缺少相符的opentelemetry-instrumentation-*套件。 - 請勿在
requirements.txt中加入google-cloud-aiplatform。adk deploy會自動新增,自行宣告可能會導致 OpenTelemetry 套件衝突,並在無聲無息中中斷檢測。
9. 清除
如要避免產生持續性費用,請刪除本程式碼研究室建立的資源。
從 Cloud 控制台的「Deployments」(部署) 頁面刪除已部署的代理程式。選取代理程式,然後按一下「刪除」。
如果您是特地為了這個程式碼研究室建立專案,可以改為刪除整個專案:
gcloud projects delete <YOUR_PROJECT_ID>
(選用) 清理本機環境:
cd ~
rm -rf ~/adk-deploy-scale
10. 恭喜
您已建構有狀態的資料科學代理,並將其部署至 Agent Runtime!
目前所學內容
- 如何使用
BigQueryToolset建立 ADK 代理,存取真實資料 - 如何使用
PreloadMemoryTool和after_agent_callback,透過 Memory Bank 啟用長期記憶功能 - 如何為已部署代理程式的服務帳戶授予 IAM 權限
- 如何部署至 Agent Runtime,並透過 Cloud Trace 啟用可觀測性
後續步驟
- 授予 Agent Runtime 服務代理程式資料存取權,即可查詢自己的私人 BigQuery 資料集
- 新增「執行程式碼」,在安全沙箱中執行 Python 分析
- 設定 Cloud Trace 觀測能力資訊主頁,監控正式環境中的代理程式
- 使用 MCP 工具將結果發布至 Google Workspace