

1. 简介
在本 Codelab 中,您将学习如何使用 Google Cloud TPU 在 Google Kubernetes Engine (GKE) 上部署高性能、分离式推理服务。您将使用 llm-d(一个用于分布式 LLM 服务的开源框架)将预填充和解码阶段分离到多个 TPU 主机上,设置共享 KV 缓存和 GKE 推理网关。
此设置模拟了用于以高吞吐量和低延迟部署 Qwen3-32B 等大型模型的生产环境。
您将执行的操作
- 创建具有针对加速器流量优化的 MTU 的自定义 VPC 网络。
- 预配具有 GCS Fuse CSI 驱动程序和 Ray Operator 插件的 GKE 集群。
- 为 TPU v6e 切片(总共 32 个芯片)创建 8 个专用节点池。
- 为 GCS 访问配置 Workload Identity 和权限。
- 部署
llm-d以管理 Qwen3-32B 模型的分离式服务。 - 通过基准测试验证部署。
架构
![llm-d disaggregated serving architecture showing model split into 4 2x2 replicas of prefill and the same for decode]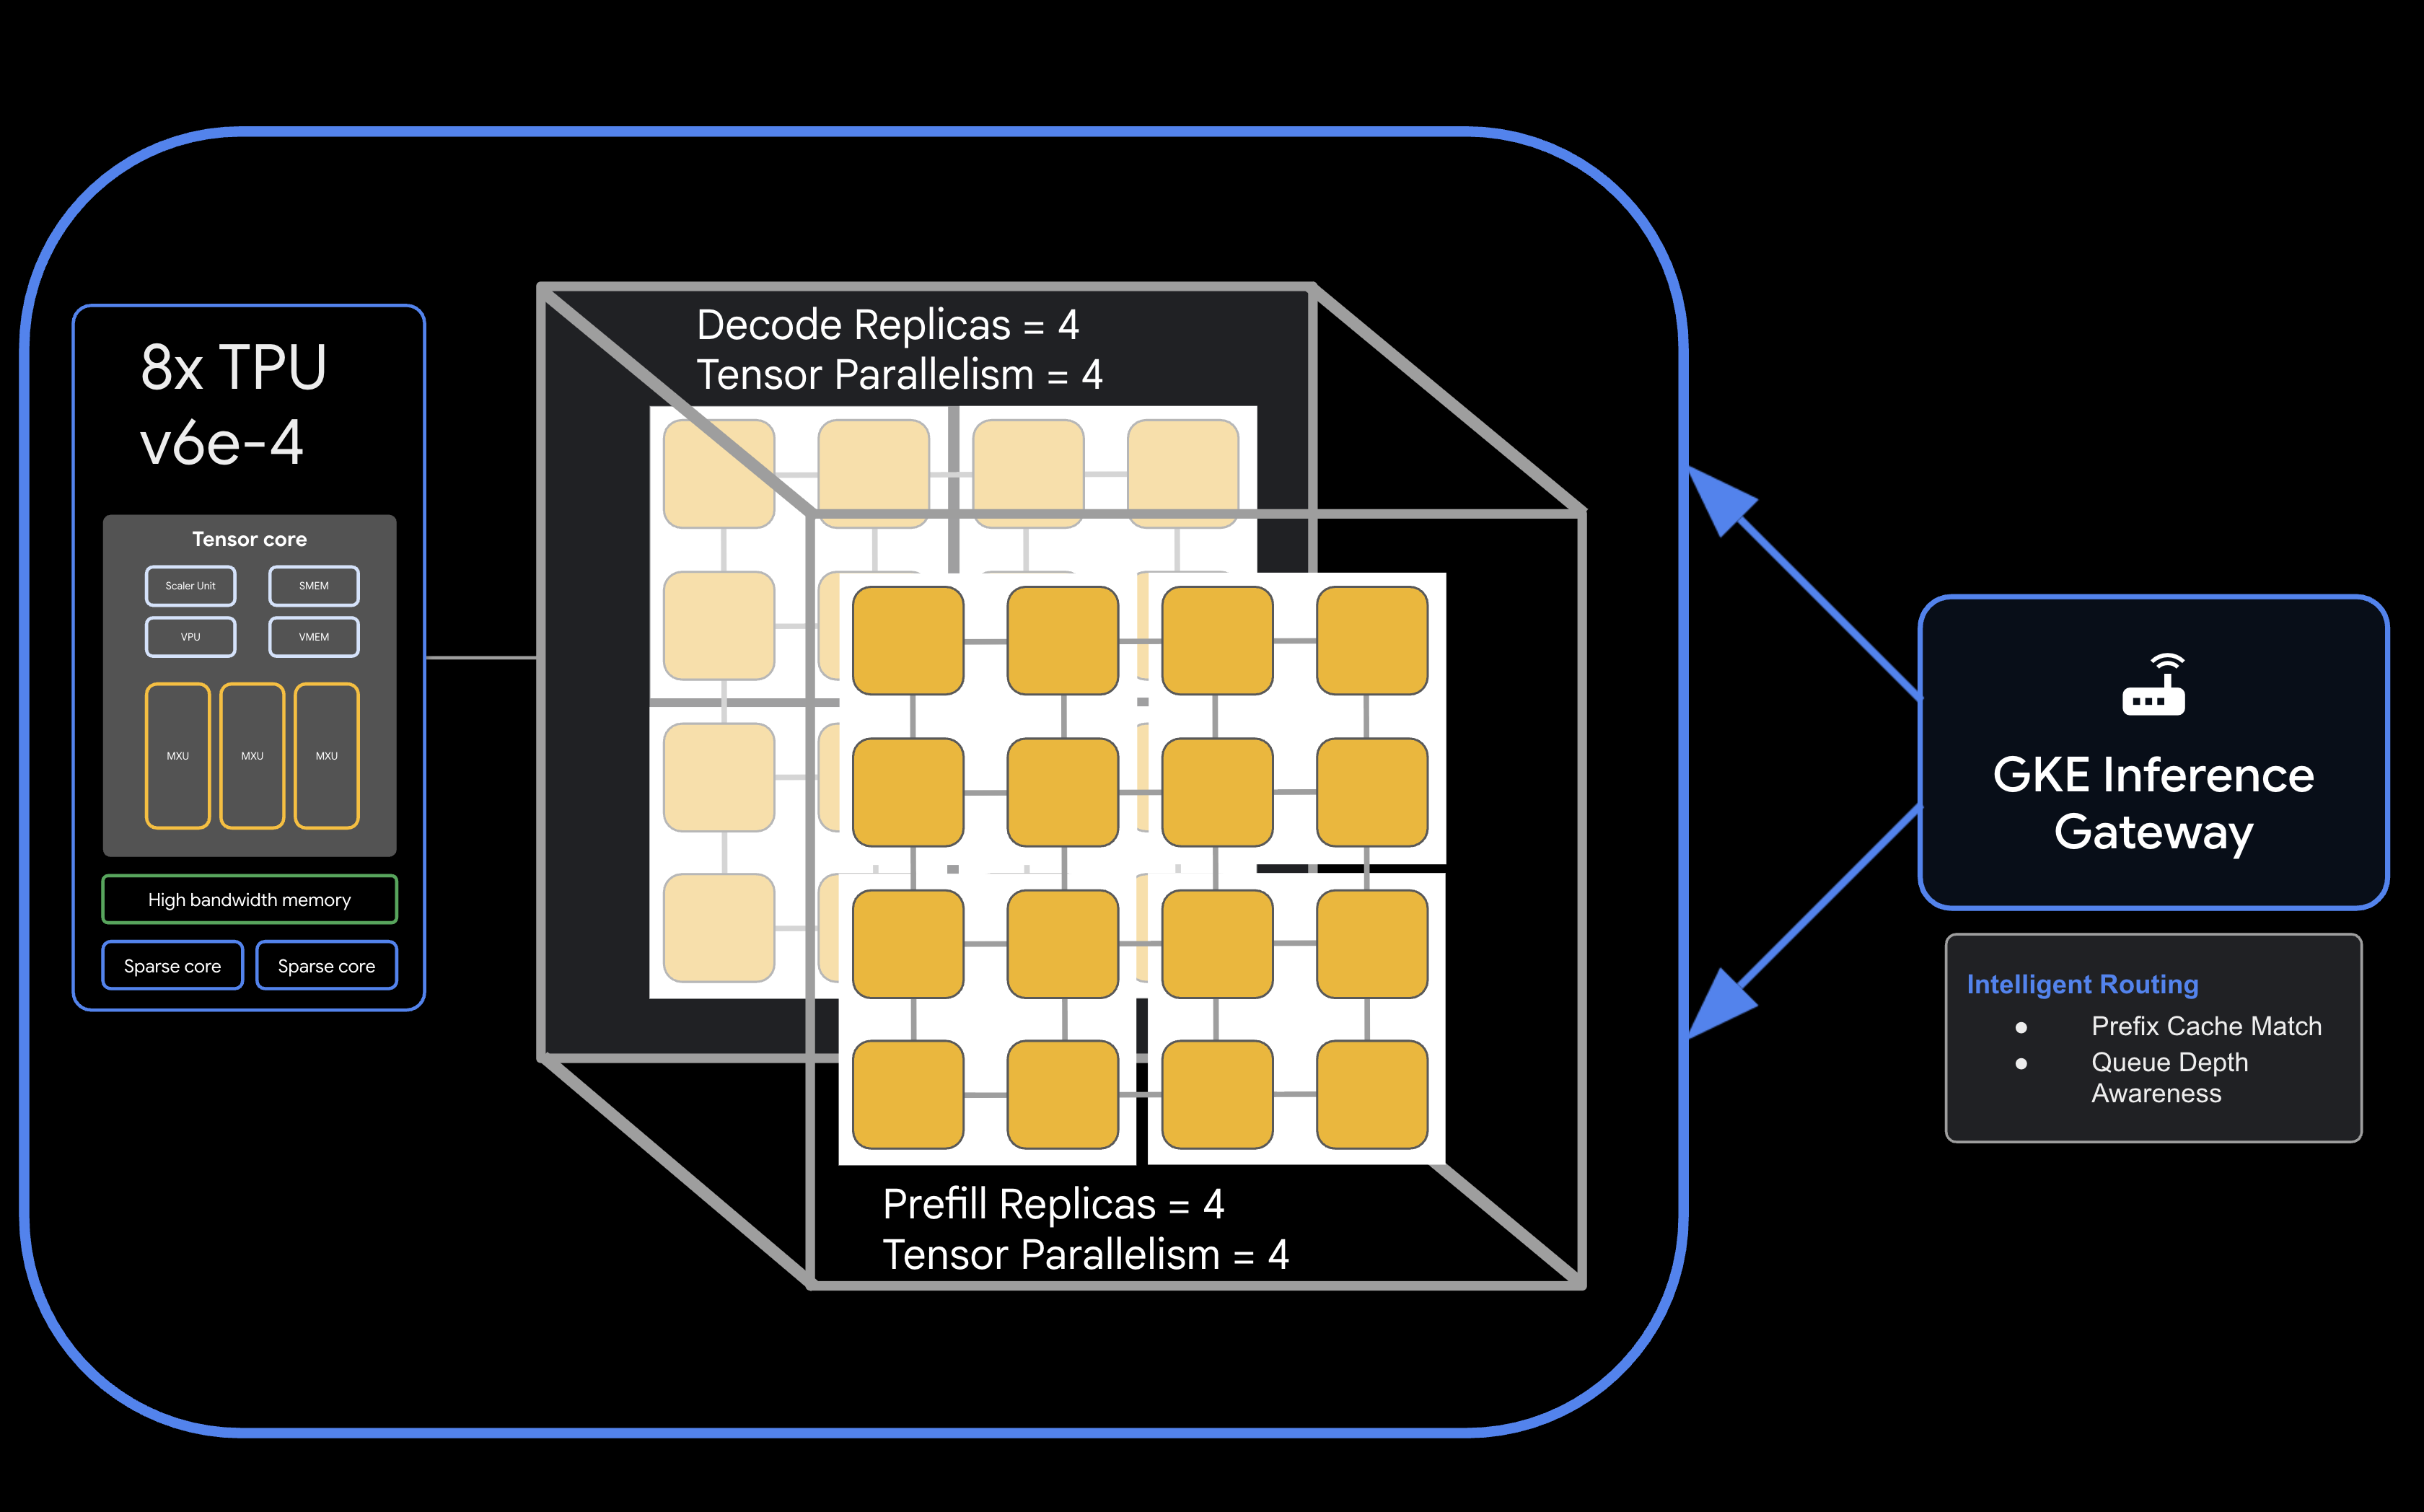
所需条件
- 启用了结算功能的 Google Cloud 项目。
- 用于 TPU v6e 资源(32 个芯片,
ct6e-standard-4t)的 Google Cloud 预留 。 - 用于下载模型权重的 Hugging Face 用户访问令牌。
- Cloud Shell 或安装了
gcloud、kubectl和helm的本地终端。
- 预计时长: 60 分钟
- 预计费用: 此实验涉及大量 TPU 资源,完成该项目的最低费用为 60 美元。请确保在完成练习后立即按照清理步骤操作。
2. 准备工作
创建或选择 Google Cloud 项目
- 在 Google Cloud 控制台 中,选择或创建 Google Cloud 项目。
- 确保您的云项目已启用结算功能。
启动 Cloud Shell
- 点击 Google Cloud 控制台顶部的激活 Cloud Shell 。
- 核实身份验证:
gcloud auth list
- 确认您的项目:
gcloud config get project
- 如有必要,请进行设置:
export PROJECT_ID=<YOUR_PROJECT_ID>
gcloud config set project $PROJECT_ID
启用 API
启用所需的 Google Cloud 服务:
gcloud services enable \
    container.googleapis.com \
    compute.googleapis.com \
    iam.googleapis.com \
    cloudresourcemanager.googleapis.com
设置环境变量
在 shell 中定义以下变量。将 <YOUR_ZONE> 替换为您分配的 TPU 地区,将 <YOUR_RESERVATION_NAME> 替换为您的预留 ID,并将 <YOUR_HUGGING_FACE_TOKEN> 替换为您的令牌。
export PROJECT_ID=$(gcloud config get-value project)
export ZONE="<YOUR_ZONE>" # e.g., us-east5-a
export REGION=${ZONE%-*}
export NAMESPACE=default
export CLUSTER_NAME="qwen-serving-cluster"
export GVNIC_NETWORK_PREFIX="qwen-serving"
export RESERVATION_NAME="<YOUR_RESERVATION_NAME>"
export HF_TOKEN="<YOUR_HUGGING_FACE_TOKEN>"
3. 创建自定义网络
分离式服务需要特定的网络配置,以处理预填充节点和解码节点之间的高带宽流量。
- 创建 VPC 网络 ,并使用较大的 MTU (8896) 以实现高效的加速器通信:
gcloud compute --project=${PROJECT_ID} \ networks create ${GVNIC_NETWORK_PREFIX}-main \ --subnet-mode=auto \ --bgp-routing-mode=regional \ --mtu=8896 - 为集群创建子网 :
gcloud compute --project=${PROJECT_ID} \ networks subnets create ${GVNIC_NETWORK_PREFIX}-tpu \ --network=${GVNIC_NETWORK_PREFIX}-main \ --region=${REGION} \ --range=10.10.0.0/18 - 创建 GKE Gateway API 所需的代理专用子网 :
gcloud compute networks subnets create ${GVNIC_NETWORK_PREFIX}-proxy \ --purpose=REGIONAL_MANAGED_PROXY \ --role=ACTIVE \ --region=${REGION} \ --network=${GVNIC_NETWORK_PREFIX}-main \ --range=172.16.0.0/26 - 创建防火墙规则 以允许内部通信:
gcloud compute --project=${PROJECT_ID} firewall-rules create ${GVNIC_NETWORK_PREFIX}-allow-internal \
    --network=${GVNIC_NETWORK_PREFIX}-main \
    --allow=all \
    --source-ranges=172.16.0.0/12,10.0.0.0/8 \
    --description="Allow all internal traffic within the network."
4. 预配 GKE 集群
创建一个配置为支持 GCS Fuse 装载和 Ray Operator 工作负载的 Standard GKE 集群。
- 创建集群:
gcloud container clusters create ${CLUSTER_NAME} \ --project=${PROJECT_ID} \ --location=${REGION} \ --release-channel=rapid \ --machine-type=e2-standard-4 \ --network=${GVNIC_NETWORK_PREFIX}-main \ --subnetwork=${GVNIC_NETWORK_PREFIX}-tpu \ --num-nodes=1 \ --gateway-api=standard \ --enable-managed-prometheus \ --enable-dataplane-v2 \ --enable-dataplane-v2-metrics \ --workload-pool=${PROJECT_ID}.svc.id.goog \ --addons=HttpLoadBalancing,GcsFuseCsiDriver,RayOperator,HorizontalPodAutoscaling,NodeLocalDNS \ --enable-ip-alias - 检索集群凭据:
gcloud container clusters get-credentials ${CLUSTER_NAME} --region=${REGION} - 创建 Hugging Face Secret:
kubectl create secret generic llm-d-hf-token \
    --from-literal=hf_api_token=${HF_TOKEN} \
    --dry-run=client -o yaml | kubectl apply -f -
5. 创建预留的 TPU 节点池
使用预留为 TPU v6e 切片预配 8 个专用节点池。
运行以下循环以创建 8 个节点池:
for i in {1..8}
do
  gcloud beta container node-pools create "tpu-v6e-single-$i" \
    --project=${PROJECT_ID} \
    --cluster=${CLUSTER_NAME} \
    --region=${REGION} \
    --node-locations=${ZONE} \
    --machine-type=ct6e-standard-4t \
    --tpu-topology=2x2 \
    --num-nodes=1 \
    --reservation-affinity=specific \
    --reservation=${RESERVATION_NAME} \
    --workload-metadata=GKE_METADATA &
done
等待所有节点创建完毕并加入集群。您可以使用 kubectl get nodes 检查状态。
6. 部署 llm-d 服务
现在,您将部署 llm-d 框架来管理分离式服务。
- 安装 Helm 以部署 llm-d 图表:
curl -fsSL -o get_helm.sh https://raw.githubusercontent.com/helm/helm/main/scripts/get-helm-4 chmod 700 get_helm.sh ./get_helm.sh - 克隆 llm-d 并安装所需的依赖项:
git clone https://github.com/llm-d/llm-d.git # When using yq alongside Helm, you almost always want the version by Mike Farah (mikefarah/yq). We remove the most common yq installation before reinstalling sudo rm -rf /usr/local/bin/yq cd llm-d ./helpers/client-setup/install-deps.sh - 准备自定义 values_tpu.yaml 以配置集群的分离式服务:
cat <<EOF > llm-d/guides/pd-disaggregation/ms-pd/values_tpu.yaml multinode: false # Configure accelerator type for Google TPU accelerator: type: google modelArtifacts: uri: "hf://Qwen/Qwen3-32B" size: 200Gi authSecretName: "llm-d-hf-token" name: "Qwen/Qwen3-32B" labels: llm-d.ai/inference-serving: "true" llm-d.ai/guide: "pd-disaggregation" llm-d.ai/hardware-variant: "tpu" llm-d.ai/hardware-vendor: "google" llm-d.ai/model: "Qwen3-32B" tracing: enabled: true otlpEndpoint: "localhost:4317" serviceNames: routingProxy: "routing-proxy" sampling: sampler: "always_off" samplerArg: "0" routing: servicePort: 8000 proxy: image: ghcr.io/llm-d/llm-d-routing-sidecar:v0.5.0 connector: nixlv2 secure: false decode: parallelism: tensor: 4 create: true replicas: 4 modelCommand: custom extraConfig: nodeSelector: cloud.google.com/gke-tpu-accelerator: "tpu-v6e-slice" cloud.google.com/gke-tpu-topology: "2x2" monitoring: podmonitor: enabled: true portName: "vllm" path: "/metrics" interval: "30s" containers: - name: "vllm" image: "vllm/vllm-tpu:nightly" command: - "/bin/bash" - "-c" - | # ROLE: kv_consumer (Receives KV cache from prefill) KV_CONFIG="{\"kv_connector\":\"TPUConnector\", \"kv_connector_module_path\" : \"tpu_inference.distributed.tpu_connector\", \"kv_role\":\"kv_consumer\", \"kv_ip\" : \"$POD_IP\"}" echo "KV_CONFIG=$KV_CONFIG" python3 -m vllm.entrypoints.openai.api_server \ --model "Qwen/Qwen3-32B" \ --port 8200 \ --tensor-parallel-size 4 \ --kv-transfer-config "${KV_CONFIG}" \ --disable-uvicorn-access-log \ --max-num-seqs 256 \ --block-size 128 \ --gpu-memory-utilization 0.90 \ --max-model-len 8192 env: - name: POD_IP valueFrom: fieldRef: fieldPath: status.podIP - name: TPU_SIDE_CHANNEL_PORT value: "9600" - name: TPU_KV_TRANSFER_PORT value: "9100" ports: - containerPort: 8200 name: vllm protocol: TCP - containerPort: 9100 name: tpu-kv-transfer protocol: TCP - containerPort: 9600 name: tpu-coord protocol: TCP resources: limits: memory: 64Gi cpu: "16" google.com/tpu: 4 requests: memory: 64Gi cpu: "16" google.com/tpu: 4 mountModelVolume: true volumeMounts: - name: metrics-volume mountPath: /.config - name: shm mountPath: /dev/shm - name: torch-compile-cache mountPath: /.cache startupProbe: httpGet: path: /health port: vllm initialDelaySeconds: 15 periodSeconds: 30 timeoutSeconds: 5 failureThreshold: 120 livenessProbe: httpGet: path: /health port: vllm periodSeconds: 10 timeoutSeconds: 5 failureThreshold: 3 readinessProbe: httpGet: path: /v1/models port: vllm periodSeconds: 5 timeoutSeconds: 2 failureThreshold: 3 volumes: - name: metrics-volume emptyDir: {} - name: shm emptyDir: medium: Memory sizeLimit: "16Gi" - name: torch-compile-cache emptyDir: {} prefill: parallelism: tensor: 4 create: true replicas: 4 modelCommand: custom extraConfig: nodeSelector: cloud.google.com/gke-tpu-accelerator: "tpu-v6e-slice" cloud.google.com/gke-tpu-topology: "2x2" monitoring: podmonitor: enabled: true portName: "vllm" path: "/metrics" interval: "30s" containers: - name: "vllm" image: "vllm/vllm-tpu:nightly" command: - "/bin/bash" - "-c" - | # ROLE: kv_producer (Sends KV cache to decode) KV_CONFIG="{\"kv_connector\":\"TPUConnector\", \"kv_connector_module_path\" : \"tpu_inference.distributed.tpu_connector\", \"kv_role\":\"kv_producer\", \"kv_ip\" : \"$POD_IP\"}" echo "KV_CONFIG=$KV_CONFIG" python3 -m vllm.entrypoints.openai.api_server \ --model "Qwen/Qwen3-32B" \ --port 8200 \ --tensor-parallel-size 4 \ --kv-transfer-config "${KV_CONFIG}" \ --disable-uvicorn-access-log \ --enable-chunked-prefill \ --block-size 128 \ --gpu-memory-utilization 0.90 \ --max-model-len 8192 env: - name: POD_IP valueFrom: fieldRef: fieldPath: status.podIP - name: TPU_SIDE_CHANNEL_PORT value: "9600" - name: TPU_KV_TRANSFER_PORT value: "9100" ports: - containerPort: 8200 name: vllm protocol: TCP - containerPort: 9100 name: tpu-kv-transfer protocol: TCP - containerPort: 9600 name: tpu-coord protocol: TCP resources: limits: memory: 64Gi cpu: "16" google.com/tpu: 4 requests: memory: 64Gi cpu: "16" google.com/tpu: 4 mountModelVolume: true volumeMounts: - name: metrics-volume mountPath: /.config - name: shm mountPath: /dev/shm - name: torch-compile-cache mountPath: /.cache startupProbe: httpGet: path: /health port: vllm initialDelaySeconds: 15 periodSeconds: 30 timeoutSeconds: 5 failureThreshold: 120 livenessProbe: httpGet: path: /health port: vllm periodSeconds: 10 timeoutSeconds: 5 failureThreshold: 3 readinessProbe: httpGet: path: /v1/models port: vllm periodSeconds: 5 timeoutSeconds: 2 failureThreshold: 3 volumes: - name: metrics-volume emptyDir: {} - name: shm emptyDir: medium: Memory sizeLimit: "16Gi" - name: torch-compile-cache emptyDir: {} EOF - 使用 llm-d 的 Helm 图表部署 Service 和网关 :
cd llm-d/guides/pd-disaggregation/ helmfile apply -e gke_tpu -n $NAMESPACE kubectl apply -f ./httproute.gke.yaml - 等待 vLLM 服务启动观看解码和预填充 POD 日志,直到看到 “INFO: Application startup complete.”
DECODE_POD=$(kubectl get pods -l llm-d.ai/modelservice-role=decode -o jsonpath='{.items[0].metadata.name}')

# Get the first Prefill pod name
PREFILL_POD=$(kubectl get pods -l llm-d.ai/modelservice-role=prefill -o jsonpath='{.items[0].metadata.name}')

echo "Run each of these until vLLM starts successfully and then ctrl-C out"
echo "kubectl logs -f $DECODE_POD -c vllm"
echo "kubectl logs -f $PREFILL_POD -c vllm"
7. 测试部署响应
以下脚本将测试通过 GKE 推理网关与服务集群的连接,然后运行基准测试。
- 测试连接并运行基准测试:
cat <<EOBF > ./run_benchmark.sh
#!/bin/bash

# Configuration
NAMESPACE="default"
JOB_NAME="qwen3-pd-benchmark"
MODEL_NAME="Qwen/Qwen3-32B"

echo "🔍 Discovering Gateway IP..."
GATEWAY_IP=$(kubectl get gateway -n ${NAMESPACE} -o jsonpath='{.items[0].status.addresses[0].value}')

if [ -z "$GATEWAY_IP" ]; then
    echo "❌ Error: Could not find Gateway IP. Check 'kubectl get gateway'."
    exit 1
fi

TARGET_URL="http://${GATEWAY_IP}"
echo "✅ Found Gateway at: $TARGET_URL"

echo "🗑️  Cleaning up old benchmark jobs..."
kubectl delete job $JOB_NAME --ignore-not-found=true

echo "🚀 Generating and applying Benchmark Job..."
cat <<EOF | kubectl apply -f -
apiVersion: batch/v1
kind: Job
metadata:
name: $JOB_NAME
namespace: $NAMESPACE
spec:
template:
    spec:
    containers:
    - name: llm-benchmark
        image: vllm/vllm-openai:latest
        command: ["/bin/bash", "-c"]
        args:
        - |
            # 1. Download dataset
            if [ ! -f /data/sharegpt.json ]; then
            echo "Downloading ShareGPT dataset..."
            curl -L "https://huggingface.co/datasets/anon8231489123/ShareGPT_Vicuna_unfiltered/resolve/main/ShareGPT_V3_unfiltered_cleaned_split.json" -o /data/sharegpt.json
            fi

            # 2. Wait for Gateway readiness
            echo "Checking connectivity to $MODEL_NAME..."
            until curl -s "$TARGET_URL/v1/models" | grep -q "$MODEL_NAME"; do
            echo "Waiting for Gateway backends to sync..."
            sleep 10
            done

            # 3. Run Benchmark
            vllm bench serve \\
            --base-url "$TARGET_URL" \\
            --model "$MODEL_NAME" \\
            --dataset-name "sharegpt" \\
            --dataset-path "/data/sharegpt.json" \\
            --request-rate 80.0 \\
            --num-prompts 2000 \\
            --tokenizer "$MODEL_NAME"
        volumeMounts:
        - name: dataset-volume
        mountPath: /data
    restartPolicy: Never
    volumes:
    - name: dataset-volume
        emptyDir: {}
EOF

echo "⏳ Job submitted. Follow logs with:"
echo "kubectl logs -f job/$JOB_NAME"
EOBF

chmod a+x ./run_benchmark.sh

./run_benchmark.sh
8. 清理
为避免系统持续向您的 Google Cloud 账号收取费用,请删除在本 Codelab 中创建的资源。
请按照以下步骤清理您的资产:
# 1. Delete LeaderWorkerSet and Helm release
kubectl delete leaderworkerset qwen-simple-anywhere-cache --ignore-not-found
helm uninstall lws --namespace lws-system 2>/dev/null
kubectl delete namespace lws-system --ignore-not-found

# 2. Delete GKE Node Pools
# Note: Usually deleting the cluster deletes the node pools,
# but explicit deletion ensures it's gone before the cluster teardown begins.
for i in {1..8}
do
	gcloud container node-pools delete "tpu-v6e-single-$i" \
	    --cluster="${CLUSTER_NAME}" \
	    --region="${REGION}" \
	    --project="${PROJECT_ID}" --quiet

done

# 3. Delete GKE Cluster
gcloud container clusters delete "${CLUSTER_NAME}" \
    --region="${REGION}" \
    --project="${PROJECT_ID}" --quiet

echo "--- Starting IAM and Service Account Cleanup ---"

# 1. Define the full Service Account email for clarity
SA_EMAIL="tpu-reader-sa@${PROJECT_ID}.iam.gserviceaccount.com"

# 2. Remove Storage Bucket IAM Binding
# This removes the 'objectViewer' role from the specific bucket
gcloud storage buckets remove-iam-policy-binding gs://inf-demo-model-storage \
    --member="serviceAccount:${SA_EMAIL}" \
    --role="roles/storage.objectViewer" --quiet

# 3. Remove Workload Identity Binding
# This severs the link between the GKE KSA and the GCP SA
gcloud iam service-accounts remove-iam-policy-binding "${SA_EMAIL}" \
    --role="roles/iam.workloadIdentityUser" \
    --member="serviceAccount:${PROJECT_ID}.svc.id.goog[default/default]" --quiet

# 4. Delete the Service Account
gcloud iam service-accounts delete "${SA_EMAIL}" --project="${PROJECT_ID}" --quiet

echo "IAM cleanup complete!"

echo "--- Starting Network and Firewall Cleanup ---"

# 4. Delete Firewall Rules (Must go before the Network)
gcloud compute firewall-rules delete \
    "${GVNIC_NETWORK_PREFIX}-allow-ssh" \
    "${GVNIC_NETWORK_PREFIX}-allow-icmp" \
    "${GVNIC_NETWORK_PREFIX}-allow-internal" \
    "ray-allow-internal" \
    --project="${PROJECT_ID}" --quiet

# 5. Delete Subnets (Must go before the Network)
gcloud compute networks subnets delete "${GVNIC_NETWORK_PREFIX}-tpu" \
    --region="${REGION}" \
    --project="${PROJECT_ID}" --quiet

gcloud compute networks subnets delete "${GVNIC_NETWORK_PREFIX}-proxy-sub" \
    --region="${REGION}" \
    --project="${PROJECT_ID}" --quiet

gcloud compute networks subnets delete "proxy-only-subnet" \
    --region="${REGION}" \
    --project="${PROJECT_ID}" --quiet

# 6. Finally, delete the VPC Network
gcloud compute networks delete "${GVNIC_NETWORK_PREFIX}-main" \
    --project="${PROJECT_ID}" --quiet

echo "Cleanup complete!"
9. 恭喜
恭喜!您已使用 llm-d 和 GKE 在分离式 v6e TPU 上成功部署了 Qwen3-32B。
您学到的内容
- 如何为高速 TPU 流量配置自定义网络。
- 如何在 GKE 上预配预留的 TPU 节点池。
- 如何部署
llm-d以分离预填充和解码工作负载。