

1. Einführung
In diesem Codelab sichern Sie einen Hochverfügbarkeitscluster (HA) in einem S3-kompatiblen Objektspeicher für AlloyDB Omni mit dem RPM-Orchestrator.
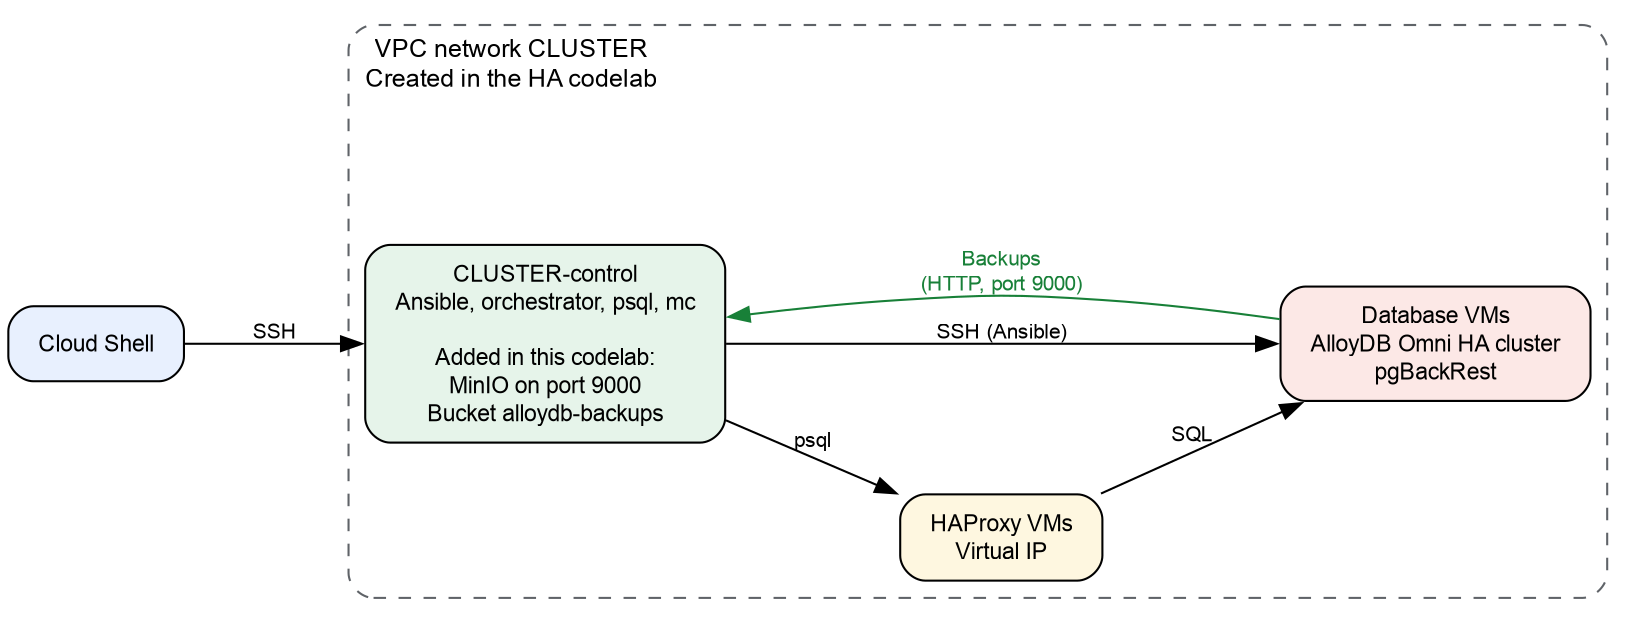
In diesem Codelab wird der Cluster aus dem Codelab AlloyDB Omni-Cluster mit hoher Verfügbarkeit auf GCE-VMs mit dem RPM-Orchestrator bereitstellen verwendet, um einen HA-Cluster auf Compute Engine-VMs zu erstellen. In diesem Codelab fügen Sie einer der VMs einen S3-kompatiblen Objektspeicherserver hinzu. Sie verwenden den Objektspeicherserver für den HA-Cluster, um die Daten zu sichern und den Cluster vom Server wiederherzustellen.
Voraussetzungen
- Google Cloud-Projekt mit aktivierter Abrechnungsfunktion.
- Die IAM-Rollen, die im HA-Codelab aufgeführt sind.
- Grundkenntnisse zu Linux-Befehlen und SQL.
Lerninhalte
- So installieren und führen Sie einen S3-kompatiblen Objektspeicherserver für Sicherungen aus.
- So erstellen Sie einen Sicherungsplan, mit dem Sicherungen in einem S3-kompatiblen Speicher geschrieben werden.
- So erstellen Sie eine On‑Demand-Sicherung.
- So stellen Sie einen Cluster aus einer Sicherung und zu einem bestimmten Zeitpunkt wieder her.
Voraussetzungen
- Die URLs der AlloyDB Omni-Software-Repositories und der Ansible-Sammlung des Orchestrators. Füllen Sie das AlloyDB Omni-Registrierungsformular aus, um die URLs zu erhalten. Weitere Informationen finden Sie in der Übersicht zu AlloyDB Omni mit RPM. Sie verwenden die URLs im HA-Codelab.
- Ein AlloyDB Omni-HA-Cluster aus dem Codelab AlloyDB Omni-Hochverfügbarkeitscluster auf GCE-VMs mit dem RPM-Orchestrator bereitstellen.
- Ein Terminal mit Zugriff auf Google Cloud und eine Cloud Shell.
2. Einrichtung und Anforderungen
- In diesem Schritt erstellen Sie einen HA-Cluster mit dem Codelab Deploy AlloyDB Omni high availability cluster on GCE VMs using RPM Orchestrator (AlloyDB Omni-Hochverfügbarkeitscluster auf GCE-VMs mit dem RPM-Orchestrator bereitstellen). Gehen Sie folgendermaßen vor: Wenn Sie bereits einen Cluster aus dem Codelab haben, fahren Sie mit dem nächsten Schritt fort.
- Hinweis: Führen Sie den Schritt Ressourcen bereinigen zu diesem Zeitpunkt nicht aus. Diesen Schritt führen Sie am Ende dieses Codelabs aus.
- Zu diesem Codelab zurückkehren
3. Mit dem Cluster verbinden und Beispieldaten hinzufügen
In diesem Schritt laden Sie die Clustereinstellungen auf die Steuerungs-VM. Anschließend stellen Sie eine Verbindung zum Cluster her und fügen eine Tabelle mit Beispieldaten hinzu.
- Wenn Sie nicht mit der Kontroll-VM verbunden sind, stellen Sie über Cloud Shell eine Verbindung her:
gcloud compute ssh "$CLUSTER-control" --zone="$ZONE" --project="$PROJECT"CLUSTER,ZONEundPROJECTstammen aus dem Schritt VMs für die Bereitstellung vorbereiten im Codelab AlloyDB Omni-Hochverfügbarkeitscluster auf GCE-VMs mit dem RPM-Orchestrator bereitstellen. Wenn diese Variablen in Cloud Shell nicht vorhanden sind, legen Sie sie noch einmal fest. - Wechseln Sie auf der Steuerungs-VM zu Ihrem Basisverzeichnis und laden Sie die Umgebungsvariablen. Fügen Sie dann den Clusternamen und den SSH-Nutzer der Umgebungsdatei hinzu:
cd ~ source /tmp/cluster.conf cat >> ~/.codelab.env <<EOF export CLUSTER="$cluster" export SSH_USER="$service_account" EOF source ~/.codelab.env env | grep -E '^(CLUSTER|SSH_USER|VIRTUAL_IP)='CLUSTER,SSH_USERundVIRTUAL_IPangezeigt werden. Hinweis:Wenn Sie später noch einmal eine Verbindung zur Kontroll-VM herstellen, führen Siecd ~undsource ~/.codelab.envaus, bevor Sie fortfahren. - Fügen Sie der Umgebungsdatei die Verbindungseinstellungen hinzu. Wenn Sie beim Ausführen des Befehls
readnach dem Passwort gefragt werden, geben Sie das Passwort des Nutzerspostgresein. Sie legen dieses Passwort im Schritt AlloyDB Omni-Cluster booten im Codelab AlloyDB Omni-Hochverfügbarkeitscluster auf GCE-VMs mit dem RPM-Orchestrator bereitstellen fest.cat >> ~/.codelab.env <<'EOF' export PATH="/usr/pgsql-18/bin:$PATH" export PGHOST="$VIRTUAL_IP" export PGUSER="postgres" EOF read -rsp "Password of the postgres user: " PGPASSWORD; echo printf 'export PGPASSWORD=%q\n' "$PGPASSWORD" >> ~/.codelab.env source ~/.codelab.env env | grep -E '^(PGHOST|PGUSER|PGPASSWORD)=' - Tabelle erstellen und 1.000 Zeilen hinzufügen:
psql <<'SQL' CREATE TABLE public.orders ( id integer PRIMARY KEY, item text NOT NULL, created_at timestamptz NOT NULL DEFAULT pg_catalog.now() ); INSERT INTO public.orders (id, item) SELECT g, 'item-' || g FROM pg_catalog.generate_series(1, 1000) AS g; SQL - Zeilen zählen:
psql -c "SELECT pg_catalog.count(*) FROM public.orders;"1000zurückgibt.
4. S3-kompatiblen Objektspeicher installieren und ausführen
In diesem Schritt schreiben Sie ein Ansible-Playbook, mit dem ein MinIO-Server auf der Steuerungs-VM installiert wird. Im Playbook werden auch der Bucket und der Nutzer für die Back-ups erstellt und es wird dafür gesorgt, dass die Datenbank-VMs eine Verbindung zu MinIO herstellen können. Führen Sie alle Befehle in diesem Schritt auf der Kontroll-VM aus.
- Fügen Sie der Umgebungsdatei auf der Steuerungs-VM die Speichereinstellungen hinzu. Mit den
openssl-Befehlen werden zufällige Passwörter erstellt.MD=http://metadata.google.internal/computeMetadata/v1/instance S3_IP=$(curl -s -H "Metadata-Flavor: Google" "$MD/network-interfaces/0/ip") cat >> ~/.codelab.env <<EOF export S3_IP="$S3_IP" export S3_HOST="$CLUSTER-control" export S3_BUCKET="alloydb-backups" export S3_REGION="us-east-1" export MINIO_ROOT_USER="s3admin" export MINIO_ROOT_PASSWORD="$(openssl rand -hex 16)" export S3_ACCESS_KEY_ID="alloydb-backup" export S3_SECRET_ACCESS_KEY="$(openssl rand -hex 16)" export MINIO_URL="https://github.com/minio/minio/releases/download/RELEASE.2024-05-10T01-41-38Z/minio.linux-amd64.RELEASE.2024-05-10T01-41-38Z" export MC_URL="https://github.com/minio/mc/releases/download/RELEASE.2024-05-09T17-04-24Z/mc.linux-amd64.RELEASE.2024-05-09T17-04-24Z" EOF source ~/.codelab.env echo "$S3_HOST $S3_IP"my-cluster-control 10.1.0.2. Die Datenbank-VMs verwenden diesen Hostnamen und diese IP-Adresse, um eine Verbindung zu MinIO herzustellen. Die IP-Adresse wird vom Metadatenserver der VM angegeben. Weitere Informationen finden Sie in der Dokumentation zu VM-Metadaten.Die WerteMINIO_URLundMC_URLsind die Download-URLs des MinIO-Servers und des MinIO-Clients (mc). - Installieren Sie die erforderliche
community.crypto-Ansible-Sammlung auf der Steuerungs-VM:ansible-galaxy collection install community.crypto - Erstellen Sie das Playbook
s3_server.yaml:cat > s3_server.yaml <<EOF - name: Install and run MinIO on the control VM hosts: localhost connection: local become: true gather_facts: false tasks: - name: Create MinIO directories ansible.builtin.file: path: "{{ item }}" state: directory mode: "0755" loop: - /var/lib/minio/data - /var/lib/minio/certs - name: Download MinIO server and client ansible.builtin.get_url: url: "{{ item.url }}" dest: "{{ item.dest }}" mode: "0755" loop: - url: "$MINIO_URL" dest: /usr/local/bin/minio - url: "$MC_URL" dest: /usr/local/bin/mc - name: Generate MinIO TLS private key community.crypto.openssl_privatekey: path: /var/lib/minio/certs/private.key size: 2048 mode: "0600" - name: Generate MinIO certificate signing request community.crypto.openssl_csr_pipe: privatekey_path: /var/lib/minio/certs/private.key common_name: "$S3_HOST" subject_alt_name: - "DNS:$S3_HOST" - "DNS:$S3_BUCKET.$S3_HOST" - "DNS:localhost" - "IP:127.0.0.1" - "IP:$S3_IP" register: minio_csr - name: Generate self-signed MinIO TLS certificate community.crypto.x509_certificate: path: /var/lib/minio/certs/public.crt csr_content: "{{ minio_csr.csr }}" privatekey_path: /var/lib/minio/certs/private.key provider: selfsigned selfsigned_not_after: "+365d" mode: "0644" - name: Create MinIO systemd service unit ansible.builtin.copy: dest: /etc/systemd/system/minio.service mode: "0600" content: | [Unit] Description=MinIO Object Storage After=network.target [Service] Environment="MINIO_ROOT_USER=$MINIO_ROOT_USER" Environment="MINIO_ROOT_PASSWORD=$MINIO_ROOT_PASSWORD" Environment="MINIO_DOMAIN=$S3_HOST" ExecStart=/usr/local/bin/minio server /var/lib/minio/data --certs-dir /var/lib/minio/certs Restart=on-failure [Install] WantedBy=multi-user.target - name: Start and enable MinIO service ansible.builtin.systemd_service: name: minio daemon_reload: true state: started enabled: true - name: Add storage host names to /etc/hosts on the control VM ansible.builtin.lineinfile: path: /etc/hosts line: "$S3_IP $S3_HOST $S3_BUCKET.$S3_HOST" state: present - name: Wait for MinIO health endpoint ansible.builtin.uri: url: "https://$S3_HOST:9000/minio/health/live" ca_path: /var/lib/minio/certs/public.crt status_code: 200 register: minio_health until: minio_health.status == 200 retries: 6 delay: 5 - name: Create backup bucket and user in MinIO ansible.builtin.command: argv: "{{ item }}" loop: - - /usr/local/bin/mc - --insecure - alias - set - s3repo - "https://$S3_HOST:9000" - "$MINIO_ROOT_USER" - "$MINIO_ROOT_PASSWORD" - - /usr/local/bin/mc - --insecure - mb - --ignore-existing - "s3repo/$S3_BUCKET" - - /usr/local/bin/mc - --insecure - admin - user - add - s3repo - "$S3_ACCESS_KEY_ID" - "$S3_SECRET_ACCESS_KEY" - - /usr/local/bin/mc - --insecure - admin - policy - attach - s3repo - readwrite - --user - "$S3_ACCESS_KEY_ID" become: false no_log: true - name: Configure database VMs for MinIO hosts: primary_instance_nodes become: true gather_facts: false vars: ansible_user: $SSH_USER ansible_ssh_private_key_file: $HOME/ssh-key-cluster-sa tasks: - name: Set SELinux to permissive mode ansible.builtin.command: cmd: setenforce 0 - name: Add storage host names to /etc/hosts ansible.builtin.lineinfile: path: /etc/hosts line: "$S3_IP $S3_HOST $S3_BUCKET.$S3_HOST" state: present - name: Verify storage host resolution ansible.builtin.getent: database: hosts key: "$S3_BUCKET.$S3_HOST" - name: Verify connection to MinIO ansible.builtin.uri: url: "https://$S3_HOST:9000/minio/health/live" validate_certs: false status_code: 200 EOFMINIO_DOMAINkann MinIO Anfragen im Virtual-Host-Stil akzeptieren. Der RPM-Orchestrator verwendet den Nutzeralloydb-backup, um die Sicherungen zu schreiben. Die Richtliniereadwriteist eine integrierte MinIO-Richtlinie. - Führen Sie das Playbook aus:
ansible-playbook s3_server.yaml -i deployment_spec.yamlPLAY RECAP-Ausgabefailed=0fürlocalhostund für jede Datenbank-VM angezeigt wird. - Prüfen Sie, ob der Bucket vorhanden ist:
mc --insecure ls s3repoalloydb-backups/angezeigt wird.
5. Sicherungsplan erstellen
Ein Sicherungsplan enthält den Speicherort, den Zeitplan und den Aufbewahrungszeitraum für die Sicherungen eines Clusters. In diesem Schritt erstellen Sie einen Sicherungsplan für den MinIO-Bucket.
- Erstellen Sie auf der Kontroll-VM das Sicherungs-Playbook und das Status-Playbook. Sie verwenden das Sicherungs-Playbook für die Ressourcen
Secret,BackupPlanundBackup. Sie verwenden das Status-Playbook, um den Status einer Ressource anzuzeigen.cat > backup.yaml <<EOF - name: Manage AlloyDB Omni backups hosts: localhost roles: - role: google.alloydbomni_orchestrator.backup EOF cat > status.yaml <<EOF - name: Get resource status hosts: localhost roles: - role: google.alloydbomni_orchestrator.status EOF - Erstellen Sie eine
Secret-Ressource für die S3-Anmeldedaten. Wenden Sie dann die Ressource an:S3_KEY_ID_B64=$(printf '%s' "$S3_ACCESS_KEY_ID" | base64 -w 0) S3_KEY_B64=$(printf '%s' "$S3_SECRET_ACCESS_KEY" | base64 -w 0) cat > s3_secret.yaml <<EOF Secret: metadata: name: s3-backup-secret spec: type: Opaque data: access-key-id: "$S3_KEY_ID_B64" access-key: "$S3_KEY_B64" EOF ansible-playbook backup.yaml -i deployment_spec.yaml \ -e resource_spec=s3_secret.yamldatamüssenaccess-key-idundaccess-keysein. Sie müssen dieSecret-Ressource anwenden, bevor Sie dieBackupPlan-Ressource anwenden. - Erstellen Sie die
BackupPlan-Ressource und wenden Sie sie dann an:cat > backup_plan.yaml <<EOF BackupPlan: metadata: name: s3-backup-plan spec: dbclusterRef: $CLUSTER backupLocation: type: S3 s3Options: bucket: $S3_BUCKET key: /backups endpoint: https://$S3_HOST:9000 region: $S3_REGION secretRef: name: s3-backup-secret caBundle: - | $(sed 's/^/ /' /var/lib/minio/certs/public.crt) EOF ansible-playbook backup.yaml -i deployment_spec.yaml \ -e resource_spec=backup_plan.yamlkeyist der Pfad für die Sicherungen im Bucket. Dieser Pfad muss mit einem Schrägstrich (/) beginnen. Das FeldcaBundleenthält das PEM-codierte CA-Zertifikat, mit dem das Zertifikat des S3-Speicherservers validiert wird. - Prüfen Sie, ob der Sicherungsplan bereit ist:
ansible-playbook status.yaml -i deployment_spec.yaml \ -e resource_type=BackupPlan -e resource_name=s3-backup-planphaseReadyangezeigt wird. Wenn die Phase nichtReadyist, warten Sie eine Minute und führen Sie den Befehl noch einmal aus. - Wenn ein Sicherungsplan erstellt wird, startet der RPM-Orchestrator automatisch eine erste Vollsicherung. Prüfen Sie, ob diese erste Sicherung abgeschlossen ist, bevor Sie eine On-Demand-Sicherung erstellen:
ansible-playbook status.yaml -i deployment_spec.yaml \
    -e resource_type=Backup
6. On-Demand-Sicherung erstellen
In diesem Schritt erstellen Sie eine On-Demand-Sicherung des Clusters.
- Erstellen Sie auf der Steuerungs-VM die
Backup-Ressource. Wenden Sie dann die Ressource an:cat > create_backup.yaml <<EOF Backup: metadata: name: s3-backup-1 spec: backupPlanRef: s3-backup-plan dbclusterRef: $CLUSTER EOF ansible-playbook backup.yaml -i deployment_spec.yaml \ -e resource_spec=create_backup.yamlbackupPlanRefist der Name des Sicherungsplans. Das FelddbclusterRefist der Name des Clusters. - Prüfen Sie, ob die Sicherung abgeschlossen ist:
ansible-playbook status.yaml -i deployment_spec.yaml \ -e resource_type=Backup -e resource_name=s3-backup-1phaseSucceededangezeigt wird. Wenn die Phase nichtSucceededist, warten Sie eine Minute und führen Sie den Befehl noch einmal aus. - Prüfen Sie, ob sich die Sicherungsdateien im Bucket befinden:
mc --insecure tree "s3repo/$S3_BUCKET"backupangezeigt wird, der einen Ordnerdbenthält.
7. Cluster aus einer Sicherung wiederherstellen
Der RPM-Orchestrator stellt einen Cluster an seinem ursprünglichen Speicherort wieder her. In diesem Schritt löschen Sie eine Tabelle und stellen sie aus der Sicherung wieder her. Optional können Sie den Cluster dann zu einem bestimmten Zeitpunkt wiederherstellen.
Achtung:Bei einem Wiederherstellungsvorgang werden alle Daten im Datenbankcluster überschrieben.
Wiederherstellung aus einem Back-up
- Löschen Sie auf der Kontroll-VM die Tabelle
orders. Zählen Sie dann die Zeilen:psql -c "DROP TABLE public.orders;" psql -c "SELECT pg_catalog.count(*) FROM public.orders;" - Wiederherstellungs-Playbook erstellen:
cat > restore.yaml <<EOF - name: Restore AlloyDB Omni cluster hosts: localhost roles: - role: google.alloydbomni_orchestrator.restore EOF - Erstellen Sie eine
Restore-Ressource für dies3-backup-1-Sicherung. Wenden Sie dann die Ressource an:cat > restore_backup.yaml <<EOF Restore: metadata: name: s3-restore-1 spec: sourceDBCluster: $CLUSTER backup: s3-backup-1 EOF ansible-playbook restore.yaml -i deployment_spec.yaml \ -e resource_spec=restore_backup.yaml - Prüfen Sie, ob der Wiederherstellungsvorgang abgeschlossen ist:
ansible-playbook status.yaml -i deployment_spec.yaml \ -e resource_type=Restore -e resource_name=s3-restore-1phaseProvisionSucceededangezeigt wird. Wenn die Phase nichtProvisionSucceededist, warten Sie eine Minute und führen Sie den Befehl noch einmal aus. - Zählen Sie die Zeilen in der wiederhergestellten Tabelle:
psql -c "SELECT pg_catalog.count(*) FROM public.orders;"1000angezeigt wird.
Optional: Zu einem bestimmten Zeitpunkt wiederherstellen
Bei der Wiederherstellung zu einem bestimmten Zeitpunkt werden eine Sicherung und das archivierte Write-Ahead-Log (WAL) verwendet. Sie können den Cluster zu einem beliebigen Zeitpunkt im Wiederherstellungszeitraum des Sicherungsplans wiederherstellen.
Regeln für die Zielzeit
Sie müssen alle Regeln einhalten, um den Wert und das Format für die Zielzeit auszuwählen:
- Verwenden Sie das RFC 3339-Format in UTC:
YYYY-MM-DDThh:mm:ssZ.2026-06-19T14:30:00Zist beispielsweise der 19. Juni 2026 um 14:30:00 Uhr UTC. Der BuchstabeTtrennt das Datum und die Uhrzeit. Der BuchstabeZsteht für UTC. - Verwenden Sie eine Zeit in der Vergangenheit.
- Verwenden Sie eine Zeit nach dem
begin-Wert des FeldsrecoveryWindowder CRDBackupPlan.
Führen Sie den folgenden Befehl aus, um die aktuelle Zeit im RFC 3339-Format anzuzeigen:
date -u +%Y-%m-%dT%H:%M:%SZ
Wenn Sie eine Ortszeit in dieses Format ändern möchten, fügen Sie dem date-Befehl den UTC-Offset der Ortszeit hinzu. Mit dem folgenden Befehl wird beispielsweise 16:30:00 auf 19 June 2026 unter UTC+02:00 geändert:
date -u -d "2026-06-19 16:30:00 +0200" +%Y-%m-%dT%H:%M:%SZ
Der Befehl gibt 2026-06-19T14:30:00Z zurück.
Zu einem aufgezeichneten Zeitpunkt wiederherstellen
In dieser Prozedur fügen Sie der Tabelle Zeilen hinzu und erfassen eine Zeit. Wenn Sie einen Zeitpunkt aufzeichnen, setzen Sie ein Lesezeichen für den genauen Moment,in dem die Datenbank vollständig intakt ist (mit genau 1.500 Zeilen). Anschließend löschen Sie Zeilen und stellen den Cluster auf den aufgezeichneten Zeitpunkt zurück.
- Fügen Sie der Tabelle 500 Zeilen hinzu:
psql <<'SQL' INSERT INTO public.orders (id, item) SELECT g, 'item-' || g FROM pg_catalog.generate_series(1001, 1500) AS g; SQL - Zeit aufzeichnen Die Tabelle hat derzeit 1.500 Zeilen.
sleep 5 PITR_TIME=$(date -u +%Y-%m-%dT%H:%M:%SZ) echo "export PITR_TIME=$PITR_TIME" >> ~/.codelab.env echo "$PITR_TIME" sleep 5YYYY-MM-DDThh:mm:ssZangezeigt wird, z. B.2026-10-05T11:16:02Z. - Löschen Sie Zeilen aus der Tabelle, um ein versehentliches Löschen von Daten zu simulieren. Starten Sie dann eine neue WAL-Datei:
psql -c "DELETE FROM public.orders WHERE id > 1000;" psql -c "SELECT pg_catalog.count(*) FROM public.orders;" psql -c "SELECT pg_catalog.pg_switch_wal();"count-Abfrage1000angezeigt wird. Diepg_switch_wal-Funktion bewirkt, dass der Server eine neue WAL-Datei startet. Anschließend kann der Server die WAL-Datei archivieren, die Ihre Änderungen enthält. - Prüfen Sie, ob das Wiederherstellungszeitfenster des Sicherungsplans die aufgezeichnete Zeit enthält:
test -n "$PITR_TIME" || { echo "PITR_TIME is not set. Run step 2 again."; exit 1; } echo "$PITR_TIME" ansible-playbook status.yaml -i deployment_spec.yaml \ -e resource_type=BackupPlan -e resource_name=s3-backup-planPITR_TIME-Wert nach dembegin-Wert des FeldsrecoveryWindowliegt. - Erstellen Sie eine
Restore-Ressource für die aufgezeichnete Zeit. Wenden Sie dann die Ressource an:cat > restore_pitr.yaml <<EOF Restore: metadata: name: s3-restore-pitr spec: sourceDBCluster: $CLUSTER pointInTime: "$PITR_TIME" EOF ansible-playbook restore.yaml -i deployment_spec.yaml \ -e resource_spec=restore_pitr.yaml - Prüfen Sie, ob der Wiederherstellungsvorgang abgeschlossen ist:
ansible-playbook status.yaml -i deployment_spec.yaml \ -e resource_type=Restore -e resource_name=s3-restore-pitrphaseProvisionSucceededangezeigt wird. Wenn die Phase nichtProvisionSucceededist, warten Sie eine Minute und führen Sie den Befehl noch einmal aus. - Zeilen zählen:
psql -c "SELECT pg_catalog.count(*) FROM public.orders;"1500angezeigt wird.
8. Bereinigen
Damit Ihrem Google Cloud-Konto keine Gebühren in Rechnung gestellt werden, löschen Sie die Ressourcen dieses Codelabs und des Codelabs AlloyDB Omni-Hochverfügbarkeitscluster auf GCE-VMs mit RPM Orchestrator bereitstellen. Löschen Sie zuerst die Sicherungsressourcen, dann den Cluster und die Rechenumgebung.
- Erstellen Sie auf der Kontroll-VM das Playbook zum Löschen:
cat > delete.yaml <<EOF - name: Delete AlloyDB Omni resources hosts: localhost roles: - role: google.alloydbomni_orchestrator.delete EOF - Sicherungen auflisten:
ansible-playbook status.yaml -i deployment_spec.yaml -e resource_type=Backups3-backup-1angezeigt wird. s3-backup-1-Sicherung löschen:ansible-playbook delete.yaml -i deployment_spec.yaml \ -e resource_type=Backup -e resource_name=s3-backup-1- Sicherungsplan löschen:
ansible-playbook delete.yaml -i deployment_spec.yaml \ -e resource_type=BackupPlan -e resource_name=s3-backup-plan - Löschen Sie den Cluster und die Rechenumgebung mit dem Schritt Ressourcen bereinigen aus dem Codelab AlloyDB Omni-Hochverfügbarkeitscluster auf GCE-VMs mit dem RPM-Orchestrator bereitstellen. Der MinIO-Server und die Sicherungen darauf befinden sich auf der Kontroll-VM. Wenn Sie die Rechenumgebung löschen, werden sowohl der Server als auch die Sicherungen gelöscht.
9. Glückwunsch
Glückwunsch! Sie haben ein Backup eines hochverfügbaren (HA) Clusters in einem S3-kompatiblen Objektspeicher für AlloyDB Omni mit dem RPM-Orchestrator erstellt. Anschließend haben Sie den Cluster aus den Sicherungen wiederhergestellt.
Behandelte Themen
- So installieren und führen Sie MinIO als S3-kompatiblen Objektspeicher aus.
- So erstellen Sie einen Sicherungsplan und eine On-Demand-Sicherung.
- So stellen Sie einen Cluster aus einer Sicherung und zu einem bestimmten Zeitpunkt wieder her.
Weitere Informationen finden Sie auf den folgenden Seiten: