

1. Introduzione
In questo codelab, esegui il backup di un cluster ad alta affidabilità (HA) in un archivio di oggetti compatibile con S3 per AlloyDB Omni utilizzando l'orchestratore RPM.
Questo codelab utilizza il cluster del codelab Esegui il deployment del cluster ad alta affidabilità di AlloyDB Omni su VM GCE utilizzando l'orchestratore RPM per creare un cluster HA su macchine virtuali (VM) Compute Engine. In questo codelab, aggiungi un server di archiviazione di oggetti compatibile con S3 a una delle VM. Utilizzi il server di archiviazione degli oggetti per il cluster HA per eseguire il backup dei dati e ripristinare il cluster dal server.
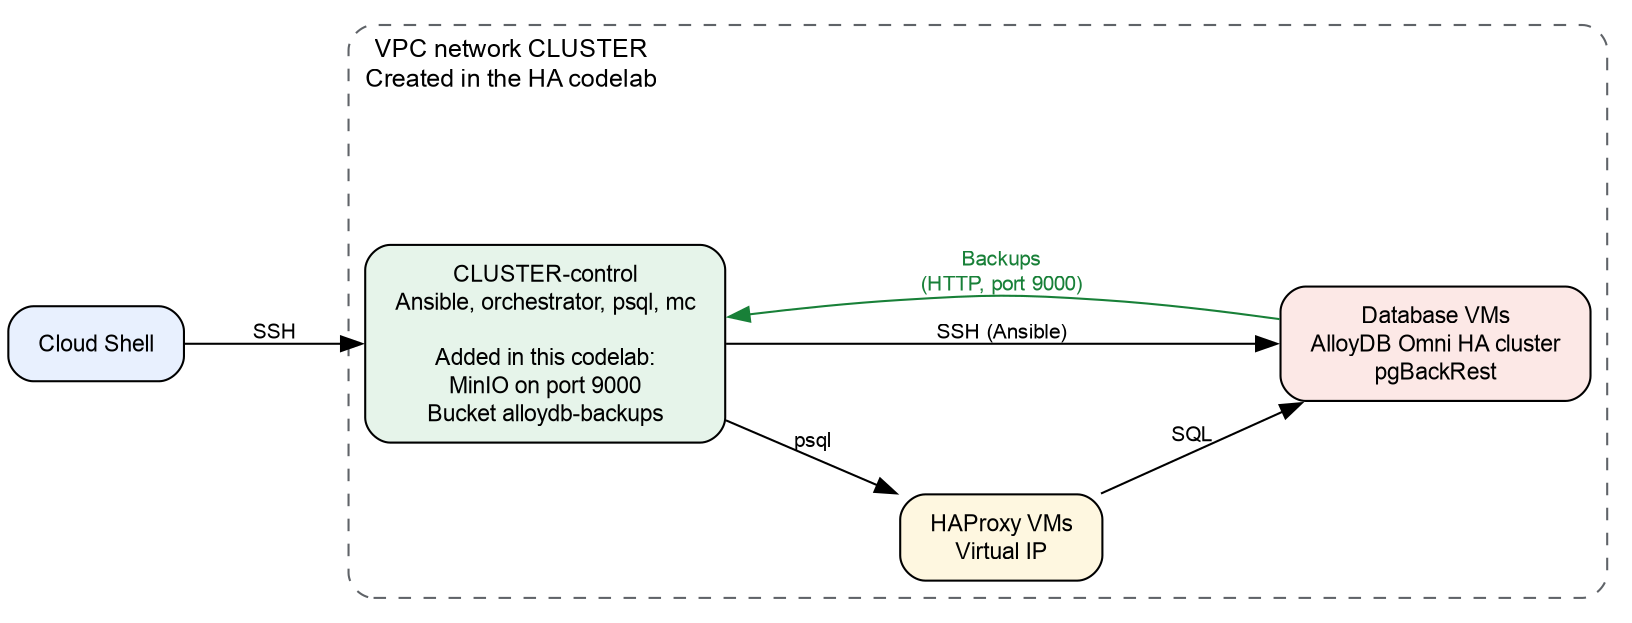
Prerequisiti
- Un progetto Google Cloud con la fatturazione abilitata.
- I ruoli IAM elencati nel codelab HA.
- Conoscenza di base dei comandi Linux e di SQL.
Cosa imparerai a fare
- Come installare ed eseguire un server di archiviazione di oggetti compatibile con S3 per i backup.
- Come creare un piano di backup che scrive i backup in uno spazio di archiviazione compatibile con S3.
- Come creare un backup on demand.
- Come ripristinare un cluster da un backup e a un momento specifico.
Che cosa ti serve
- Gli URL dei repository software di AlloyDB Omni e della raccolta Ansible dell'orchestratore. Per ricevere gli URL, compila il modulo di registrazione ad AlloyDB Omni. Per saperne di più, consulta la panoramica di AlloyDB Omni che utilizza RPM. Utilizzi gli URL nel codelab HA.
- Un cluster HA AlloyDB Omni dal codelab Esegui il deployment del cluster ad alta affidabilità AlloyDB Omni sulle VM GCE utilizzando l'orchestratore RPM.
- Un terminale con accesso a Google Cloud e a Cloud Shell.
2. Configurazione e requisiti
- In questo passaggio, crei un cluster ad alta affidabilità utilizzando il codelab Esegui il deployment del cluster ad alta affidabilità AlloyDB Omni sulle VM GCE utilizzando l'orchestratore RPM. Completa i seguenti passaggi: Se hai già un cluster dal codelab, continua con il passaggio successivo.
- Nota: non eseguire il passaggio "Pulisci risorse" in questa fase. Eseguirai questo passaggio alla fine di questo codelab.
- Torna a questo codelab
3. Connettiti al cluster e aggiungi dati di esempio
In questo passaggio, carichi le impostazioni del cluster sulla VM di controllo. Poi ti connetti al cluster e aggiungi una tabella con dati campionati.
- Se non sei connesso alla VM di controllo, connettiti da Cloud Shell:
gcloud compute ssh "$CLUSTER-control" --zone="$ZONE" --project="$PROJECT"CLUSTER,ZONEePROJECTprovengono dal passaggio Prepara le VM per il deployment del codelab Esegui il deployment del cluster ad alta affidabilità AlloyDB Omni sulle VM GCE utilizzando l'orchestratore RPM. Se Cloud Shell non dispone di queste variabili, impostale di nuovo. - Nella VM di controllo, passa alla tua home directory e carica le variabili di ambiente. Poi aggiungi il nome del cluster e l'utente SSH al file di ambiente:
cd ~ source /tmp/cluster.conf cat >> ~/.codelab.env <<EOF export CLUSTER="$cluster" export SSH_USER="$service_account" EOF source ~/.codelab.env env | grep -E '^(CLUSTER|SSH_USER|VIRTUAL_IP)='CLUSTER,SSH_USEReVIRTUAL_IP. Nota:se in un secondo momento ti connetti di nuovo alla VM di controllo, eseguicd ~esource ~/.codelab.envprima di continuare. - Aggiungi le impostazioni di connessione al file dell'ambiente. Quando il comando
readchiede la password, inserisci quella dell'utentepostgres. Hai impostato questa password nel passaggio Bootstrap AlloyDB Omni Cluster del codelab Deploy AlloyDB Omni high availability cluster on GCE VMs using RPM Orchestratorcat >> ~/.codelab.env <<'EOF' export PATH="/usr/pgsql-18/bin:$PATH" export PGHOST="$VIRTUAL_IP" export PGUSER="postgres" EOF read -rsp "Password of the postgres user: " PGPASSWORD; echo printf 'export PGPASSWORD=%q\n' "$PGPASSWORD" >> ~/.codelab.env source ~/.codelab.env env | grep -E '^(PGHOST|PGUSER|PGPASSWORD)=' - Crea una tabella e aggiungi 1000 righe:
psql <<'SQL' CREATE TABLE public.orders ( id integer PRIMARY KEY, item text NOT NULL, created_at timestamptz NOT NULL DEFAULT pg_catalog.now() ); INSERT INTO public.orders (id, item) SELECT g, 'item-' || g FROM pg_catalog.generate_series(1, 1000) AS g; SQL - Conta le righe:
psql -c "SELECT pg_catalog.count(*) FROM public.orders;"1000.
4. Installa ed esegui l'archiviazione di oggetti compatibile con S3
In questo passaggio, scrivi un playbook Ansible che installa un server MinIO sulla VM di controllo. Il playbook crea anche il bucket e l'utente per i backup e garantisce che le VM del database possano connettersi a MinIO. Esegui tutti i comandi di questo passaggio sulla VM di controllo.
- Nella VM di controllo, aggiungi le impostazioni di archiviazione al file di ambiente. I comandi
opensslcreano password casuali.MD=http://metadata.google.internal/computeMetadata/v1/instance S3_IP=$(curl -s -H "Metadata-Flavor: Google" "$MD/network-interfaces/0/ip") cat >> ~/.codelab.env <<EOF export S3_IP="$S3_IP" export S3_HOST="$CLUSTER-control" export S3_BUCKET="alloydb-backups" export S3_REGION="us-east-1" export MINIO_ROOT_USER="s3admin" export MINIO_ROOT_PASSWORD="$(openssl rand -hex 16)" export S3_ACCESS_KEY_ID="alloydb-backup" export S3_SECRET_ACCESS_KEY="$(openssl rand -hex 16)" export MINIO_URL="https://github.com/minio/minio/releases/download/RELEASE.2024-05-10T01-41-38Z/minio.linux-amd64.RELEASE.2024-05-10T01-41-38Z" export MC_URL="https://github.com/minio/mc/releases/download/RELEASE.2024-05-09T17-04-24Z/mc.linux-amd64.RELEASE.2024-05-09T17-04-24Z" EOF source ~/.codelab.env echo "$S3_HOST $S3_IP"my-cluster-control 10.1.0.2. Le VM del database utilizzano questo nome host e indirizzo IP per connettersi a MinIO. Il server di metadati della VM fornisce l'indirizzo IP. Per ulteriori informazioni, consulta la documentazione sui metadati delle VM.I valoriMINIO_URLeMC_URLsono gli URL di download del server MinIO e del client MinIO (mc). - Installa la raccolta Ansible
community.cryptorichiesta sulla VM di controllo:ansible-galaxy collection install community.crypto - Crea il playbook
s3_server.yaml:cat > s3_server.yaml <<EOF - name: Install and run MinIO on the control VM hosts: localhost connection: local become: true gather_facts: false tasks: - name: Create MinIO directories ansible.builtin.file: path: "{{ item }}" state: directory mode: "0755" loop: - /var/lib/minio/data - /var/lib/minio/certs - name: Download MinIO server and client ansible.builtin.get_url: url: "{{ item.url }}" dest: "{{ item.dest }}" mode: "0755" loop: - url: "$MINIO_URL" dest: /usr/local/bin/minio - url: "$MC_URL" dest: /usr/local/bin/mc - name: Generate MinIO TLS private key community.crypto.openssl_privatekey: path: /var/lib/minio/certs/private.key size: 2048 mode: "0600" - name: Generate MinIO certificate signing request community.crypto.openssl_csr_pipe: privatekey_path: /var/lib/minio/certs/private.key common_name: "$S3_HOST" subject_alt_name: - "DNS:$S3_HOST" - "DNS:$S3_BUCKET.$S3_HOST" - "DNS:localhost" - "IP:127.0.0.1" - "IP:$S3_IP" register: minio_csr - name: Generate self-signed MinIO TLS certificate community.crypto.x509_certificate: path: /var/lib/minio/certs/public.crt csr_content: "{{ minio_csr.csr }}" privatekey_path: /var/lib/minio/certs/private.key provider: selfsigned selfsigned_not_after: "+365d" mode: "0644" - name: Create MinIO systemd service unit ansible.builtin.copy: dest: /etc/systemd/system/minio.service mode: "0600" content: | [Unit] Description=MinIO Object Storage After=network.target [Service] Environment="MINIO_ROOT_USER=$MINIO_ROOT_USER" Environment="MINIO_ROOT_PASSWORD=$MINIO_ROOT_PASSWORD" Environment="MINIO_DOMAIN=$S3_HOST" ExecStart=/usr/local/bin/minio server /var/lib/minio/data --certs-dir /var/lib/minio/certs Restart=on-failure [Install] WantedBy=multi-user.target - name: Start and enable MinIO service ansible.builtin.systemd_service: name: minio daemon_reload: true state: started enabled: true - name: Add storage host names to /etc/hosts on the control VM ansible.builtin.lineinfile: path: /etc/hosts line: "$S3_IP $S3_HOST $S3_BUCKET.$S3_HOST" state: present - name: Wait for MinIO health endpoint ansible.builtin.uri: url: "https://$S3_HOST:9000/minio/health/live" ca_path: /var/lib/minio/certs/public.crt status_code: 200 register: minio_health until: minio_health.status == 200 retries: 6 delay: 5 - name: Create backup bucket and user in MinIO ansible.builtin.command: argv: "{{ item }}" loop: - - /usr/local/bin/mc - --insecure - alias - set - s3repo - "https://$S3_HOST:9000" - "$MINIO_ROOT_USER" - "$MINIO_ROOT_PASSWORD" - - /usr/local/bin/mc - --insecure - mb - --ignore-existing - "s3repo/$S3_BUCKET" - - /usr/local/bin/mc - --insecure - admin - user - add - s3repo - "$S3_ACCESS_KEY_ID" - "$S3_SECRET_ACCESS_KEY" - - /usr/local/bin/mc - --insecure - admin - policy - attach - s3repo - readwrite - --user - "$S3_ACCESS_KEY_ID" become: false no_log: true - name: Configure database VMs for MinIO hosts: primary_instance_nodes become: true gather_facts: false vars: ansible_user: $SSH_USER ansible_ssh_private_key_file: $HOME/ssh-key-cluster-sa tasks: - name: Set SELinux to permissive mode ansible.builtin.command: cmd: setenforce 0 - name: Add storage host names to /etc/hosts ansible.builtin.lineinfile: path: /etc/hosts line: "$S3_IP $S3_HOST $S3_BUCKET.$S3_HOST" state: present - name: Verify storage host resolution ansible.builtin.getent: database: hosts key: "$S3_BUCKET.$S3_HOST" - name: Verify connection to MinIO ansible.builtin.uri: url: "https://$S3_HOST:9000/minio/health/live" validate_certs: false status_code: 200 EOFMINIO_DOMAINconsente a MinIO di accettare richieste di stile con hosting virtuale. L'orchestratore RPM utilizza l'utentealloydb-backupper scrivere i backup. Il criterioreadwriteè un criterio integrato di MinIO. - Esegui il playbook:
ansible-playbook s3_server.yaml -i deployment_spec.yamlPLAY RECAPmostrifailed=0perlocalhoste per ogni VM di database. - Verifica che il bucket esista:
mc --insecure ls s3repoalloydb-backups/.
5. Crea un piano di backup
Un piano di backup contiene la posizione di archiviazione, la pianificazione e il periodo di conservazione dei backup di un cluster. In questo passaggio, crei un piano di backup per il bucket MinIO.
- Nella VM di controllo, crea il playbook di backup e il playbook di stato. Utilizzi la guida pratica al backup per le risorse
Secret,BackupPlaneBackup. Utilizzi il playbook dello stato per mostrare lo stato di una risorsa.cat > backup.yaml <<EOF - name: Manage AlloyDB Omni backups hosts: localhost roles: - role: google.alloydbomni_orchestrator.backup EOF cat > status.yaml <<EOF - name: Get resource status hosts: localhost roles: - role: google.alloydbomni_orchestrator.status EOF - Crea una risorsa
Secretper le credenziali S3. Quindi applica la risorsa:S3_KEY_ID_B64=$(printf '%s' "$S3_ACCESS_KEY_ID" | base64 -w 0) S3_KEY_B64=$(printf '%s' "$S3_SECRET_ACCESS_KEY" | base64 -w 0) cat > s3_secret.yaml <<EOF Secret: metadata: name: s3-backup-secret spec: type: Opaque data: access-key-id: "$S3_KEY_ID_B64" access-key: "$S3_KEY_B64" EOF ansible-playbook backup.yaml -i deployment_spec.yaml \ -e resource_spec=s3_secret.yamldatadevono essereaccess-key-ideaccess-key. Devi applicare la risorsaSecretprima di applicare la risorsaBackupPlan. - Crea la risorsa
BackupPlane poi applicala:cat > backup_plan.yaml <<EOF BackupPlan: metadata: name: s3-backup-plan spec: dbclusterRef: $CLUSTER backupLocation: type: S3 s3Options: bucket: $S3_BUCKET key: /backups endpoint: https://$S3_HOST:9000 region: $S3_REGION secretRef: name: s3-backup-secret caBundle: - | $(sed 's/^/ /' /var/lib/minio/certs/public.crt) EOF ansible-playbook backup.yaml -i deployment_spec.yaml \ -e resource_spec=backup_plan.yamlkeyè il percorso dei backup nel bucket. Questo percorso deve iniziare con una barra (/). Il campocaBundlecontiene il certificato CA con codifica PEM che convalida il certificato del server di archiviazione S3. - Verifica che il piano di backup sia pronto:
ansible-playbook status.yaml -i deployment_spec.yaml \ -e resource_type=BackupPlan -e resource_name=s3-backup-planphasemostriReady. Se la fase non èReady, attendi un minuto ed esegui di nuovo il comando. - Quando viene creato un piano di backup, l'orchestratore RPM avvia automaticamente un backup completo iniziale. Verifica che il backup iniziale venga completato prima di creare un backup on demand:
ansible-playbook status.yaml -i deployment_spec.yaml \
    -e resource_type=Backup
6. Crea un backup on demand
In questo passaggio, crei un backup on demand del cluster.
- Nella VM di controllo, crea la risorsa
Backup. Quindi applica la risorsa:cat > create_backup.yaml <<EOF Backup: metadata: name: s3-backup-1 spec: backupPlanRef: s3-backup-plan dbclusterRef: $CLUSTER EOF ansible-playbook backup.yaml -i deployment_spec.yaml \ -e resource_spec=create_backup.yamlbackupPlanRefè il nome del piano di backup. Il campodbclusterRefè il nome del cluster. - Verifica che il backup sia stato completato:
ansible-playbook status.yaml -i deployment_spec.yaml \ -e resource_type=Backup -e resource_name=s3-backup-1phasemostriSucceeded. Se la fase non èSucceeded, attendi un minuto ed esegui di nuovo il comando. - Verifica che i file di backup si trovino nel bucket:
mc --insecure tree "s3repo/$S3_BUCKET"backupcontenente una cartelladb.
7. Ripristina il cluster da un backup
L'orchestratore RPM ripristina un cluster sul posto. In questo passaggio, elimini una tabella e la ripristini dal backup. Poi, se vuoi, puoi ripristinare il cluster a un momento specifico.
Attenzione:un'operazione di ripristino sovrascrive tutti i dati nel cluster di database.
Ripristino da un backup
- Nella VM di controllo, elimina la tabella
orders. Poi conta le righe:psql -c "DROP TABLE public.orders;" psql -c "SELECT pg_catalog.count(*) FROM public.orders;" - Crea il playbook di ripristino:
cat > restore.yaml <<EOF - name: Restore AlloyDB Omni cluster hosts: localhost roles: - role: google.alloydbomni_orchestrator.restore EOF - Crea una risorsa
Restoreper il backups3-backup-1. Quindi applica la risorsa:cat > restore_backup.yaml <<EOF Restore: metadata: name: s3-restore-1 spec: sourceDBCluster: $CLUSTER backup: s3-backup-1 EOF ansible-playbook restore.yaml -i deployment_spec.yaml \ -e resource_spec=restore_backup.yaml - Verifica che l'operazione di ripristino sia completata:
ansible-playbook status.yaml -i deployment_spec.yaml \ -e resource_type=Restore -e resource_name=s3-restore-1phasemostriProvisionSucceeded. Se la fase non èProvisionSucceeded, attendi un minuto ed esegui di nuovo il comando. - Conta le righe nella tabella ripristinata:
psql -c "SELECT pg_catalog.count(*) FROM public.orders;"1000.
(Facoltativo) Esegui recupero point-in-time
Un ripristino point-in-time utilizza un backup e il log write-ahead (WAL) archiviato. Puoi ripristinare il cluster in qualsiasi momento nella finestra di recupero del piano di backup.
Regole per il tempo target
Devi rispettare tutte le regole per scegliere il valore e il formato dell'ora target:
- Utilizza il formato RFC 3339 in UTC:
YYYY-MM-DDThh:mm:ssZ. Ad esempio,2026-06-19T14:30:00Zcorrisponde alle 14:30:00 UTC del 19 giugno 2026. La letteraTsepara la data e l'ora. La letteraZindica il fuso orario UTC. - Utilizza un'ora nel passato.
- Utilizza un orario successivo al valore
begindel camporecoveryWindowdel CRDBackupPlan.
Per visualizzare l'ora attuale nel formato RFC 3339, esegui questo comando:
date -u +%Y-%m-%dT%H:%M:%SZ
Per convertire un'ora locale in questo formato, aggiungi l'offset UTC dell'ora locale al comando date. Ad esempio, il seguente comando modifica 16:30:00 su 19 June 2026 alle ore UTC+02:00:
date -u -d "2026-06-19 16:30:00 +0200" +%Y-%m-%dT%H:%M:%SZ
Il comando restituisce 2026-06-19T14:30:00Z.
Ripristinare un orario registrato
In questa procedura, aggiungi righe alla tabella e registra un orario. Quando registri un orario, salvi un segnalibro del momento esatto in cui il database è completamente intatto (con esattamente 1500 righe).Poi elimini le righe e ripristini il cluster all'ora registrata.
- Aggiungi 500 righe alla tabella:
psql <<'SQL' INSERT INTO public.orders (id, item) SELECT g, 'item-' || g FROM pg_catalog.generate_series(1001, 1500) AS g; SQL - Registra il tempo. La tabella contiene 1500 righe.
sleep 5 PITR_TIME=$(date -u +%Y-%m-%dT%H:%M:%SZ) echo "export PITR_TIME=$PITR_TIME" >> ~/.codelab.env echo "$PITR_TIME" sleep 5YYYY-MM-DDThh:mm:ssZ, ad esempio2026-10-05T11:16:02Z. - Elimina righe dalla tabella per simulare un'eliminazione accidentale dei dati. Quindi, avvia un nuovo file WAL:
psql -c "DELETE FROM public.orders WHERE id > 1000;" psql -c "SELECT pg_catalog.count(*) FROM public.orders;" psql -c "SELECT pg_catalog.pg_switch_wal();"countmostri1000. La funzionepg_switch_walfa sì che il server avvii un nuovo file WAL. A questo punto, il server può archiviare il file WAL contenente le modifiche. - Verifica che la finestra di ripristino del piano di backup contenga l'ora registrata:
test -n "$PITR_TIME" || { echo "PITR_TIME is not set. Run step 2 again."; exit 1; } echo "$PITR_TIME" ansible-playbook status.yaml -i deployment_spec.yaml \ -e resource_type=BackupPlan -e resource_name=s3-backup-planPITR_TIMEsia successivo al valore dibegindel camporecoveryWindow. - Crea una risorsa
Restoreper il tempo registrato. Quindi applica la risorsa:cat > restore_pitr.yaml <<EOF Restore: metadata: name: s3-restore-pitr spec: sourceDBCluster: $CLUSTER pointInTime: "$PITR_TIME" EOF ansible-playbook restore.yaml -i deployment_spec.yaml \ -e resource_spec=restore_pitr.yaml - Verifica che l'operazione di ripristino sia completata:
ansible-playbook status.yaml -i deployment_spec.yaml \ -e resource_type=Restore -e resource_name=s3-restore-pitrphasemostriProvisionSucceeded. Se la fase non èProvisionSucceeded, attendi un minuto ed esegui di nuovo il comando. - Conta le righe:
psql -c "SELECT pg_catalog.count(*) FROM public.orders;"1500.
8. Esegui la pulizia
Per evitare addebiti al tuo account Google Cloud, elimina le risorse di questo codelab e del codelab Deploy AlloyDB Omni high availability cluster on GCE VMs using RPM Orchestrator. Innanzitutto, elimina le risorse di backup, poi elimina il cluster e l'ambiente di calcolo.
- Nella VM di controllo, crea il playbook di eliminazione:
cat > delete.yaml <<EOF - name: Delete AlloyDB Omni resources hosts: localhost roles: - role: google.alloydbomni_orchestrator.delete EOF - Elenca i backup:
ansible-playbook status.yaml -i deployment_spec.yaml -e resource_type=Backups3-backup-1. - Elimina il backup di
s3-backup-1:ansible-playbook delete.yaml -i deployment_spec.yaml \ -e resource_type=Backup -e resource_name=s3-backup-1 - Elimina il piano di backup:
ansible-playbook delete.yaml -i deployment_spec.yaml \ -e resource_type=BackupPlan -e resource_name=s3-backup-plan - Elimina il cluster e l'ambiente di calcolo utilizzando il passaggio Pulisci le risorse del codelab Esegui il deployment del cluster ad alta affidabilità AlloyDB Omni sulle VM GCE utilizzando l'orchestratore RPM. Il server MinIO e i backup al suo interno si trovano nella VM di controllo. Quando elimini l'ambiente di calcolo, elimini sia il server che i backup.
9. Complimenti
Complimenti. Hai eseguito il backup di un cluster ad alta affidabilità (HA) nell'archiviazione di oggetti compatibile con S3 per AlloyDB Omni utilizzando l'orchestratore RPM. Poi hai ripristinato il cluster dai backup.
Argomenti trattati
- Come installare ed eseguire MinIO come spazio di archiviazione di oggetti compatibile con S3.
- Come creare un piano di backup e un backup on demand.
- Come ripristinare un cluster da un backup e a un momento specifico.
Per saperne di più, consulta le pagine seguenti: