

1. Wprowadzenie
W tym ćwiczeniu utworzysz kopię zapasową klastra o wysokiej dostępności w magazynie obiektów zgodnym z S3 dla AlloyDB Omni za pomocą aranżera RPM.
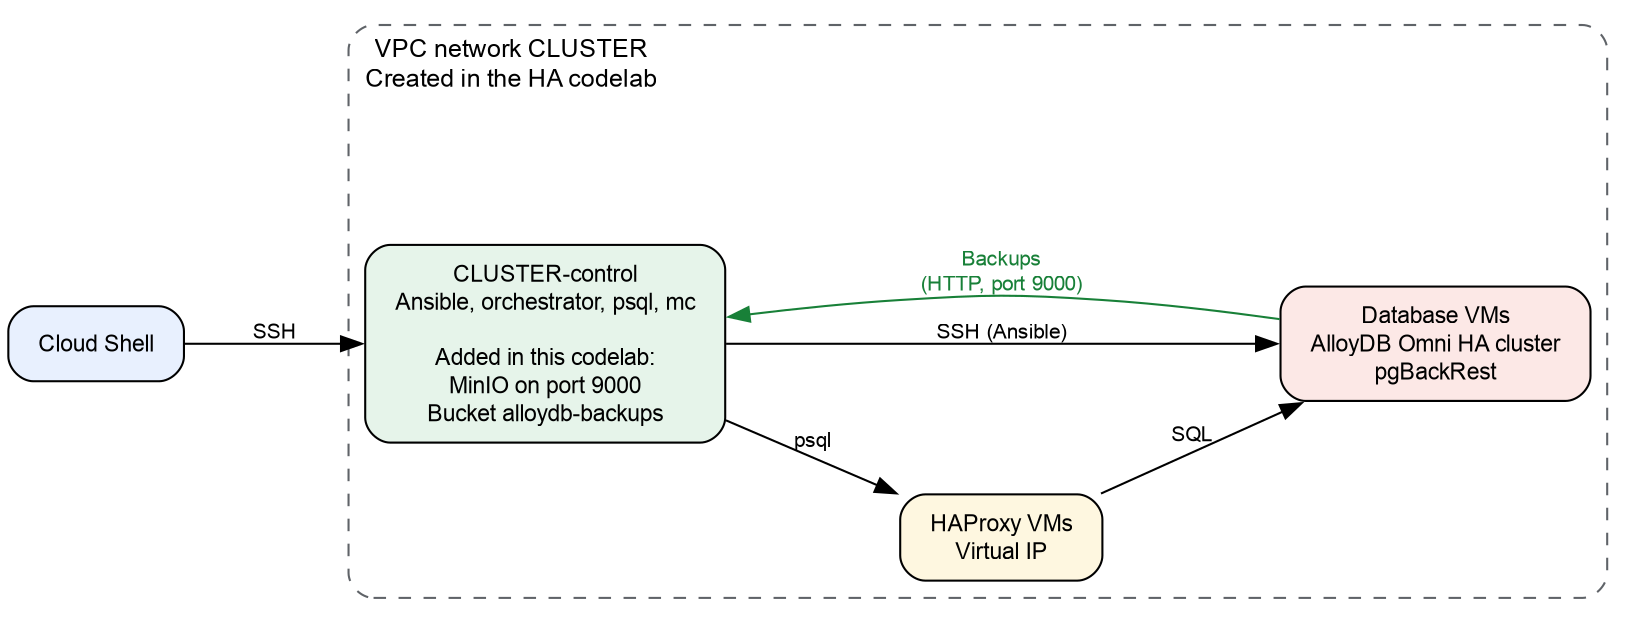
W tym ćwiczeniu używamy klastra z ćwiczenia Wdrażanie klastra o wysokiej dostępności AlloyDB Omni na maszynach wirtualnych GCE przy użyciu aranżera RPM do utworzenia klastra o wysokiej dostępności na maszynach wirtualnych Compute Engine. W tym ćwiczeniu dodasz serwer magazynu obiektów zgodny z S3 na jednej z maszyn wirtualnych. Serwer magazynu obiektów klastra HA służy do tworzenia kopii zapasowych danych i przywracania klastra z serwera.
Wymagania wstępne
- projekt Google Cloud z włączonymi płatnościami;
- Role uprawnień wymienione w instrukcji HA.
- Podstawowa znajomość poleceń Linuksa i SQL.
Czego się nauczysz
- Jak zainstalować i uruchomić serwer magazynu obiektów zgodnego z S3 na potrzeby kopii zapasowych.
- Jak utworzyć plan tworzenia kopii zapasowych, który zapisuje kopie zapasowe w pamięci zgodnej z S3.
- Jak utworzyć kopię zapasową na żądanie.
- Jak przywrócić klaster z kopii zapasowej i do określonego momentu.
Czego potrzebujesz
- Adresy URL repozytoriów oprogramowania AlloyDB Omni i kolekcji Ansible aranżera. Aby otrzymać adresy URL, wypełnij formularz rejestracji w usłudze AlloyDB Omni. Więcej informacji znajdziesz w omówieniu AlloyDB Omni z użyciem RPM. Adresów URL używasz w ćwiczeniu w Codelabs dotyczącym HA.
- Klaster AlloyDB Omni HA z ćwiczenia Wdrażanie klastra AlloyDB Omni o wysokiej dostępności w maszynach wirtualnych GCE za pomocą aranżera RPM.
- terminal z dostępem do Google Cloud i Cloud Shell;
2. Konfiguracja i wymagania
- W tym kroku utworzysz klaster HA, korzystając z ćwiczenia Wdrażanie klastra AlloyDB Omni o wysokiej dostępności w maszynach wirtualnych GCE za pomocą aranżera RPM. Wykonaj następujące czynności. Jeśli masz już klaster z ćwiczenia w Codelabs, przejdź do następnego kroku.
- Uwaga: na tym etapie nie wykonuj kroku „Oczyść zasoby”. Ten krok wykonasz na końcu tego ćwiczenia.
- Wróć do tego ćwiczenia
3. Łączenie z klastrem i dodawanie przykładowych danych
W tym kroku wczytasz ustawienia klastra na maszynie wirtualnej sterowania. Następnie połącz się z klastrem i dodaj tabelę z danymi próbkowanymi.
- Jeśli nie masz połączenia z maszyną wirtualną sterowania, połącz się z nią z Cloud Shell:
gcloud compute ssh "$CLUSTER-control" --zone="$ZONE" --project="$PROJECT"CLUSTER,ZONEiPROJECTpochodzą z kroku Przygotuj maszyny wirtualne do wdrożenia w ćwiczeniu Wdrażanie klastra AlloyDB Omni o wysokiej dostępności na maszynach wirtualnych GCE za pomocą aranżera RPM. Jeśli Cloud Shell nie ma tych zmiennych, ustaw je ponownie. - Na maszynie wirtualnej sterowania przejdź do katalogu głównego i wczytaj zmienne środowiskowe. Następnie dodaj nazwę klastra i użytkownika SSH do pliku środowiska:
cd ~ source /tmp/cluster.conf cat >> ~/.codelab.env <<EOF export CLUSTER="$cluster" export SSH_USER="$service_account" EOF source ~/.codelab.env env | grep -E '^(CLUSTER|SSH_USER|VIRTUAL_IP)='CLUSTER,SSH_USERiVIRTUAL_IP. Uwaga: jeśli później ponownie połączysz się z maszyną wirtualną sterowania, przed kontynuowaniem uruchom poleceniacd ~isource ~/.codelab.env. - Dodaj ustawienia połączenia do pliku środowiska. Gdy polecenie
readpoprosi o hasło, wpisz hasło użytkownikapostgres. To hasło ustawiasz w kroku Bootstrap AlloyDB Omni Cluster (Uruchom klaster AlloyDB Omni) w ćwiczeniu Deploy AlloyDB Omni high availability cluster on GCE VMs using RPM Orchestrator (Wdrażanie klastra AlloyDB Omni o wysokiej dostępności w maszynach wirtualnych GCE za pomocą aranżera RPM).cat >> ~/.codelab.env <<'EOF' export PATH="/usr/pgsql-18/bin:$PATH" export PGHOST="$VIRTUAL_IP" export PGUSER="postgres" EOF read -rsp "Password of the postgres user: " PGPASSWORD; echo printf 'export PGPASSWORD=%q\n' "$PGPASSWORD" >> ~/.codelab.env source ~/.codelab.env env | grep -E '^(PGHOST|PGUSER|PGPASSWORD)=' - Utwórz tabelę i dodaj 1000 wierszy:
psql <<'SQL' CREATE TABLE public.orders ( id integer PRIMARY KEY, item text NOT NULL, created_at timestamptz NOT NULL DEFAULT pg_catalog.now() ); INSERT INTO public.orders (id, item) SELECT g, 'item-' || g FROM pg_catalog.generate_series(1, 1000) AS g; SQL - Policz wiersze:
psql -c "SELECT pg_catalog.count(*) FROM public.orders;"1000.
4. Instalowanie i uruchamianie obiektowej pamięci masowej zgodnej z S3
W tym kroku napiszesz plik playbook Ansible, który zainstaluje serwer MinIO na maszynie wirtualnej sterowania. Skrypt tworzy też zasobnik i użytkownika na potrzeby kopii zapasowych oraz dba o to, aby maszyny wirtualne bazy danych mogły łączyć się z MinIO. Wszystkie polecenia z tego kroku uruchom na maszynie wirtualnej sterowania.
- Na maszynie wirtualnej sterowania dodaj ustawienia pamięci masowej do pliku środowiska. Polecenia
openssltworzą losowe hasła.MD=http://metadata.google.internal/computeMetadata/v1/instance S3_IP=$(curl -s -H "Metadata-Flavor: Google" "$MD/network-interfaces/0/ip") cat >> ~/.codelab.env <<EOF export S3_IP="$S3_IP" export S3_HOST="$CLUSTER-control" export S3_BUCKET="alloydb-backups" export S3_REGION="us-east-1" export MINIO_ROOT_USER="s3admin" export MINIO_ROOT_PASSWORD="$(openssl rand -hex 16)" export S3_ACCESS_KEY_ID="alloydb-backup" export S3_SECRET_ACCESS_KEY="$(openssl rand -hex 16)" export MINIO_URL="https://github.com/minio/minio/releases/download/RELEASE.2024-05-10T01-41-38Z/minio.linux-amd64.RELEASE.2024-05-10T01-41-38Z" export MC_URL="https://github.com/minio/mc/releases/download/RELEASE.2024-05-09T17-04-24Z/mc.linux-amd64.RELEASE.2024-05-09T17-04-24Z" EOF source ~/.codelab.env echo "$S3_HOST $S3_IP"my-cluster-control 10.1.0.2. Maszyny wirtualne bazy danych używają tej nazwy hosta i adresu IP do łączenia się z MinIO. Adres IP jest podawany przez serwer metadanych maszyny wirtualnej. Więcej informacji znajdziesz w dokumentacji metadanych maszyny wirtualnej.WartościMINIO_URLiMC_URLto adresy URL pobierania serwera MinIO i klienta MinIO (mc). - Zainstaluj wymaganą kolekcję
community.cryptoAnsible na maszynie wirtualnej sterowania:ansible-galaxy collection install community.crypto - Utwórz scenariusz
s3_server.yaml:cat > s3_server.yaml <<EOF - name: Install and run MinIO on the control VM hosts: localhost connection: local become: true gather_facts: false tasks: - name: Create MinIO directories ansible.builtin.file: path: "{{ item }}" state: directory mode: "0755" loop: - /var/lib/minio/data - /var/lib/minio/certs - name: Download MinIO server and client ansible.builtin.get_url: url: "{{ item.url }}" dest: "{{ item.dest }}" mode: "0755" loop: - url: "$MINIO_URL" dest: /usr/local/bin/minio - url: "$MC_URL" dest: /usr/local/bin/mc - name: Generate MinIO TLS private key community.crypto.openssl_privatekey: path: /var/lib/minio/certs/private.key size: 2048 mode: "0600" - name: Generate MinIO certificate signing request community.crypto.openssl_csr_pipe: privatekey_path: /var/lib/minio/certs/private.key common_name: "$S3_HOST" subject_alt_name: - "DNS:$S3_HOST" - "DNS:$S3_BUCKET.$S3_HOST" - "DNS:localhost" - "IP:127.0.0.1" - "IP:$S3_IP" register: minio_csr - name: Generate self-signed MinIO TLS certificate community.crypto.x509_certificate: path: /var/lib/minio/certs/public.crt csr_content: "{{ minio_csr.csr }}" privatekey_path: /var/lib/minio/certs/private.key provider: selfsigned selfsigned_not_after: "+365d" mode: "0644" - name: Create MinIO systemd service unit ansible.builtin.copy: dest: /etc/systemd/system/minio.service mode: "0600" content: | [Unit] Description=MinIO Object Storage After=network.target [Service] Environment="MINIO_ROOT_USER=$MINIO_ROOT_USER" Environment="MINIO_ROOT_PASSWORD=$MINIO_ROOT_PASSWORD" Environment="MINIO_DOMAIN=$S3_HOST" ExecStart=/usr/local/bin/minio server /var/lib/minio/data --certs-dir /var/lib/minio/certs Restart=on-failure [Install] WantedBy=multi-user.target - name: Start and enable MinIO service ansible.builtin.systemd_service: name: minio daemon_reload: true state: started enabled: true - name: Add storage host names to /etc/hosts on the control VM ansible.builtin.lineinfile: path: /etc/hosts line: "$S3_IP $S3_HOST $S3_BUCKET.$S3_HOST" state: present - name: Wait for MinIO health endpoint ansible.builtin.uri: url: "https://$S3_HOST:9000/minio/health/live" ca_path: /var/lib/minio/certs/public.crt status_code: 200 register: minio_health until: minio_health.status == 200 retries: 6 delay: 5 - name: Create backup bucket and user in MinIO ansible.builtin.command: argv: "{{ item }}" loop: - - /usr/local/bin/mc - --insecure - alias - set - s3repo - "https://$S3_HOST:9000" - "$MINIO_ROOT_USER" - "$MINIO_ROOT_PASSWORD" - - /usr/local/bin/mc - --insecure - mb - --ignore-existing - "s3repo/$S3_BUCKET" - - /usr/local/bin/mc - --insecure - admin - user - add - s3repo - "$S3_ACCESS_KEY_ID" - "$S3_SECRET_ACCESS_KEY" - - /usr/local/bin/mc - --insecure - admin - policy - attach - s3repo - readwrite - --user - "$S3_ACCESS_KEY_ID" become: false no_log: true - name: Configure database VMs for MinIO hosts: primary_instance_nodes become: true gather_facts: false vars: ansible_user: $SSH_USER ansible_ssh_private_key_file: $HOME/ssh-key-cluster-sa tasks: - name: Set SELinux to permissive mode ansible.builtin.command: cmd: setenforce 0 - name: Add storage host names to /etc/hosts ansible.builtin.lineinfile: path: /etc/hosts line: "$S3_IP $S3_HOST $S3_BUCKET.$S3_HOST" state: present - name: Verify storage host resolution ansible.builtin.getent: database: hosts key: "$S3_BUCKET.$S3_HOST" - name: Verify connection to MinIO ansible.builtin.uri: url: "https://$S3_HOST:9000/minio/health/live" validate_certs: false status_code: 200 EOFMINIO_DOMAINumożliwia MinIO akceptowanie żądań w stylu hostowania wirtualnego. Aranżer RPM używa użytkownikaalloydb-backupdo zapisywania kopii zapasowych. Zasadareadwriteto wbudowana zasada MinIO. - Uruchom scenariusz:
ansible-playbook s3_server.yaml -i deployment_spec.yamlPLAY RECAPw przypadkulocalhosti każdej maszyny wirtualnej bazy danych wyświetla się wartośćfailed=0. - Sprawdź, czy zasobnik istnieje:
mc --insecure ls s3repoalloydb-backups/.
5. Utwórz plan wykonywania kopii zapasowych
Plan tworzenia kopii zapasowych zawiera lokalizację pamięci, harmonogram i okres przechowywania kopii zapasowych klastra. W tym kroku utworzysz plan tworzenia kopii zapasowych zasobnika MinIO.
- Na maszynie wirtualnej sterowania utwórz plik playbook kopii zapasowej i plik playbook stanu. Korzystasz z poradnika dotyczącego tworzenia kopii zapasowych zasobów
Secret,BackupPlaniBackup. Za pomocą przewodnika po stanie możesz wyświetlić stan zasobu.cat > backup.yaml <<EOF - name: Manage AlloyDB Omni backups hosts: localhost roles: - role: google.alloydbomni_orchestrator.backup EOF cat > status.yaml <<EOF - name: Get resource status hosts: localhost roles: - role: google.alloydbomni_orchestrator.status EOF - Utwórz zasób
Secretdla danych logowania S3. Następnie zastosuj zasób:S3_KEY_ID_B64=$(printf '%s' "$S3_ACCESS_KEY_ID" | base64 -w 0) S3_KEY_B64=$(printf '%s' "$S3_SECRET_ACCESS_KEY" | base64 -w 0) cat > s3_secret.yaml <<EOF Secret: metadata: name: s3-backup-secret spec: type: Opaque data: access-key-id: "$S3_KEY_ID_B64" access-key: "$S3_KEY_B64" EOF ansible-playbook backup.yaml -i deployment_spec.yaml \ -e resource_spec=s3_secret.yamldatamuszą mieć postaćaccess-key-idiaccess-key. Zanim zastosujesz zasóbBackupPlan, musisz zastosować zasóbSecret. - Utwórz zasób
BackupPlan, a potem go zastosuj:cat > backup_plan.yaml <<EOF BackupPlan: metadata: name: s3-backup-plan spec: dbclusterRef: $CLUSTER backupLocation: type: S3 s3Options: bucket: $S3_BUCKET key: /backups endpoint: https://$S3_HOST:9000 region: $S3_REGION secretRef: name: s3-backup-secret caBundle: - | $(sed 's/^/ /' /var/lib/minio/certs/public.crt) EOF ansible-playbook backup.yaml -i deployment_spec.yaml \ -e resource_spec=backup_plan.yamlkeyto ścieżka do kopii zapasowych w zasobniku. Ścieżka musi zaczynać się od ukośnika (/). PolecaBundlezawiera certyfikat CA zakodowany w formacie PEM, który weryfikuje certyfikat serwera pamięci S3. - Sprawdź, czy plan tworzenia kopii zapasowych jest gotowy:
ansible-playbook status.yaml -i deployment_spec.yaml \ -e resource_type=BackupPlan -e resource_name=s3-backup-planphasewyświetla się wartośćReady. Jeśli faza nie jestReady, poczekaj minutę i ponownie uruchom polecenie. - Po utworzeniu planu kopii zapasowej koordynator RPM automatycznie rozpoczyna początkową pełną kopię zapasową. Zanim utworzysz kopię zapasową na żądanie, sprawdź, czy pierwsza kopia zapasowa została utworzona:
ansible-playbook status.yaml -i deployment_spec.yaml \
    -e resource_type=Backup
6. Utwórz kopię zapasową na żądanie
W tym kroku utworzysz kopię zapasową klastra na żądanie.
- Na maszynie wirtualnej sterowania utwórz zasób
Backup. Następnie zastosuj zasób:cat > create_backup.yaml <<EOF Backup: metadata: name: s3-backup-1 spec: backupPlanRef: s3-backup-plan dbclusterRef: $CLUSTER EOF ansible-playbook backup.yaml -i deployment_spec.yaml \ -e resource_spec=create_backup.yamlbackupPlanRefto nazwa planu tworzenia kopii zapasowych. PoledbclusterRefto nazwa klastra. - Sprawdź, czy kopia zapasowa została utworzona:
ansible-playbook status.yaml -i deployment_spec.yaml \ -e resource_type=Backup -e resource_name=s3-backup-1phasewyświetla się wartośćSucceeded. Jeśli faza nie jestSucceeded, poczekaj minutę i ponownie uruchom polecenie. - Sprawdź, czy pliki kopii zapasowej znajdują się w zasobniku:
mc --insecure tree "s3repo/$S3_BUCKET"backup, który zawiera folderdb.
7. Przywracanie klastra z kopii zapasowej
Aranżer RPM przywraca klaster w miejscu. W tym kroku usuniesz tabelę i przywrócisz ją z kopii zapasowej. Następnie możesz opcjonalnie przywrócić klaster do określonego momentu.
Ostrzeżenie: operacja przywracania zastępuje wszystkie dane w klastrze bazy danych.
Przywróć z kopii zapasowej
- Na maszynie wirtualnej kontrolera usuń tabelę
orders. Następnie policz wiersze:psql -c "DROP TABLE public.orders;" psql -c "SELECT pg_catalog.count(*) FROM public.orders;" - Utwórz scenariusz przywracania:
cat > restore.yaml <<EOF - name: Restore AlloyDB Omni cluster hosts: localhost roles: - role: google.alloydbomni_orchestrator.restore EOF - Utwórz zasób
Restoredla kopii zapasowejs3-backup-1. Następnie zastosuj zasób:cat > restore_backup.yaml <<EOF Restore: metadata: name: s3-restore-1 spec: sourceDBCluster: $CLUSTER backup: s3-backup-1 EOF ansible-playbook restore.yaml -i deployment_spec.yaml \ -e resource_spec=restore_backup.yaml - Sprawdź, czy operacja przywracania została zakończona:
ansible-playbook status.yaml -i deployment_spec.yaml \ -e resource_type=Restore -e resource_name=s3-restore-1phasewyświetla się wartośćProvisionSucceeded. Jeśli faza nie jestProvisionSucceeded, poczekaj minutę i ponownie uruchom polecenie. - Policz wiersze w przywróconej tabeli:
psql -c "SELECT pg_catalog.count(*) FROM public.orders;"1000.
(Opcjonalnie) Przywracanie do określonego momentu
Przywracanie do określonego momentu wykorzystuje kopię zapasową i zarchiwizowany log zapisywany z wyprzedzeniem (WAL). Klaster możesz przywrócić do dowolnego momentu w okresie przywracania planu tworzenia kopii zapasowych.
Reguły dotyczące czasu docelowego
Aby wybrać wartość i format czasu docelowego, musisz przestrzegać wszystkich tych reguł:
- Użyj formatu RFC 3339 w strefie czasowej UTC:
YYYY-MM-DDThh:mm:ssZ. Na przykład2026-06-19T14:30:00Zto 19 czerwca 2026 r. o godz. 14:30:00 czasu UTC. LiteraToddziela datę od godziny. LiteraZoznacza czas UTC. - Użyj czasu z przeszłości.
- Użyj czasu po wartości
beginw polurecoveryWindowobiektu CRDBackupPlan.
Aby wyświetlić bieżący czas w formacie RFC 3339, uruchom to polecenie:
date -u +%Y-%m-%dT%H:%M:%SZ
Aby zmienić czas lokalny na ten format, dodaj przesunięcie UTC czasu lokalnego do polecenia date. Na przykład to polecenie zmienia 16:30:00 na 19 June 2026 o godzinie UTC+02:00:
date -u -d "2026-06-19 16:30:00 +0200" +%Y-%m-%dT%H:%M:%SZ
Polecenie zwraca wartość 2026-06-19T14:30:00Z.
Przywracanie do zarejestrowanego czasu
W tej procedurze dodasz wiersze do tabeli i zarejestrujesz czas. Podczas rejestrowania czasu zapisujesz dokładny moment, w którym baza danych jest w pełni nienaruszona (zawiera dokładnie 1500 wierszy).Następnie usuwasz wiersze i przywracasz klaster do zarejestrowanego czasu.
- Dodaj do tabeli 500 wierszy:
psql <<'SQL' INSERT INTO public.orders (id, item) SELECT g, 'item-' || g FROM pg_catalog.generate_series(1001, 1500) AS g; SQL - Zapisz czas. Tabela ma obecnie 1500 wierszy.
sleep 5 PITR_TIME=$(date -u +%Y-%m-%dT%H:%M:%SZ) echo "export PITR_TIME=$PITR_TIME" >> ~/.codelab.env echo "$PITR_TIME" sleep 5YYYY-MM-DDThh:mm:ssZ, np.2026-10-05T11:16:02Z. - Usuń wiersze z tabeli, aby zasymulować przypadkowe usunięcie danych. Następnie rozpocznij nowy plik WAL:
psql -c "DELETE FROM public.orders WHERE id > 1000;" psql -c "SELECT pg_catalog.count(*) FROM public.orders;" psql -c "SELECT pg_catalog.pg_switch_wal();"countzwraca wartość1000. Funkcjapg_switch_walpowoduje, że serwer rozpoczyna nowy plik WAL. Następnie serwer może zarchiwizować plik WAL zawierający Twoje zmiany. - Sprawdź, czy okno przywracania planu tworzenia kopii zapasowych zawiera zarejestrowany czas:
test -n "$PITR_TIME" || { echo "PITR_TIME is not set. Run step 2 again."; exit 1; } echo "$PITR_TIME" ansible-playbook status.yaml -i deployment_spec.yaml \ -e resource_type=BackupPlan -e resource_name=s3-backup-planPITR_TIMEwystępuje po wartościbeginw polurecoveryWindow. - Utwórz zasób
Restoredla zarejestrowanego czasu. Następnie zastosuj zasób:cat > restore_pitr.yaml <<EOF Restore: metadata: name: s3-restore-pitr spec: sourceDBCluster: $CLUSTER pointInTime: "$PITR_TIME" EOF ansible-playbook restore.yaml -i deployment_spec.yaml \ -e resource_spec=restore_pitr.yaml - Sprawdź, czy operacja przywracania została zakończona:
ansible-playbook status.yaml -i deployment_spec.yaml \ -e resource_type=Restore -e resource_name=s3-restore-pitrphasewyświetla się wartośćProvisionSucceeded. Jeśli faza nie jestProvisionSucceeded, poczekaj minutę i ponownie uruchom polecenie. - Policz wiersze:
psql -c "SELECT pg_catalog.count(*) FROM public.orders;"1500.
8. Czyszczenie
Aby uniknąć obciążenia konta Google Cloud opłatami, usuń zasoby z tego ćwiczenia w Codelabs i z ćwiczenia w Codelabs Wdrażanie klastra AlloyDB Omni o wysokiej dostępności na maszynach wirtualnych GCE za pomocą narzędzia RPM Orchestrator. Najpierw usuń zasoby kopii zapasowej, a potem klaster i środowisko obliczeniowe.
- Na maszynie wirtualnej sterującej utwórz plik playbook usuwania:
cat > delete.yaml <<EOF - name: Delete AlloyDB Omni resources hosts: localhost roles: - role: google.alloydbomni_orchestrator.delete EOF - Wyświetl listę kopii zapasowych:
ansible-playbook status.yaml -i deployment_spec.yaml -e resource_type=Backups3-backup-1. - Usuń kopię zapasową
s3-backup-1:ansible-playbook delete.yaml -i deployment_spec.yaml \ -e resource_type=Backup -e resource_name=s3-backup-1 - Usuń plan tworzenia kopii zapasowych:
ansible-playbook delete.yaml -i deployment_spec.yaml \ -e resource_type=BackupPlan -e resource_name=s3-backup-plan - Usuń klaster i środowisko obliczeniowe, wykonując krok Clean up Resources (Czyszczenie zasobów) z ćwiczenia Deploy AlloyDB Omni high availability cluster on GCE VMs using RPM Orchestrator (Wdrażanie klastra AlloyDB Omni o wysokiej dostępności na maszynach wirtualnych GCE za pomocą aranżera RPM). Serwer MinIO i kopie zapasowe znajdują się na maszynie wirtualnej sterowania. Usunięcie środowiska obliczeniowego powoduje usunięcie zarówno serwera, jak i kopii zapasowych.
9. Gratulacje
Gratulacje. Utworzono kopię zapasową klastra o wysokiej dostępności w magazynie obiektów zgodnym z S3 w przypadku AlloyDB Omni z użyciem aranżera RPM. Następnie przywrócono klaster z kopii zapasowych.
Omówione zagadnienia
- Jak zainstalować i uruchomić MinIO jako magazyn obiektów zgodny z S3.
- Jak utworzyć plan tworzenia kopii zapasowych i kopię zapasową na żądanie.
- Jak przywrócić klaster z kopii zapasowej i do określonego momentu.
Więcej informacji znajdziesz na tych stronach: