

1. 簡介
在本程式碼實驗室中,您將使用 RPM 自動調度管理工具,將高可用性 (HA) 叢集備份至與 S3 相容的 AlloyDB Omni 物件儲存庫。
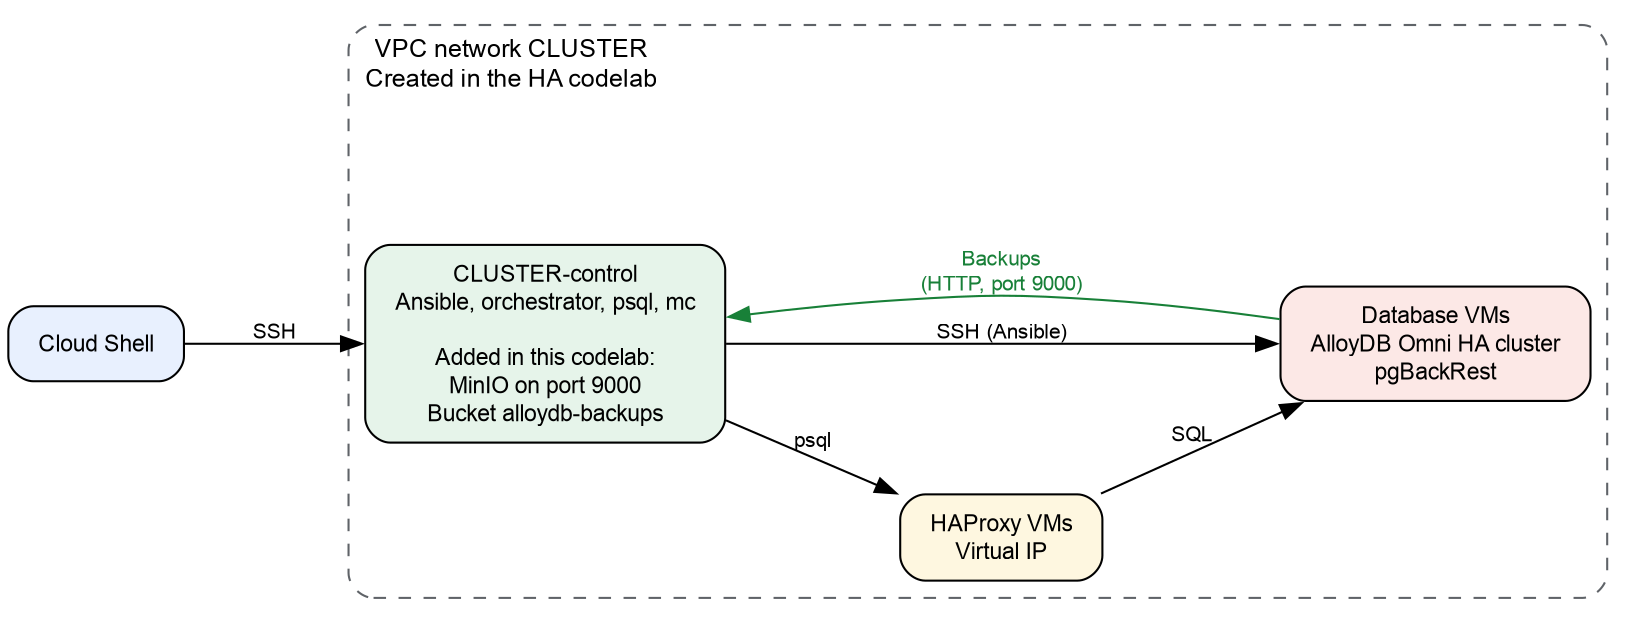
本程式碼實驗室會使用「使用 RPM 自動調度管理工具在 GCE VM 上部署 AlloyDB Omni 高可用性叢集」程式碼實驗室中的叢集,在 Compute Engine 虛擬機器 (VM) 上建立高可用性叢集。在本程式碼研究室中,您會在其中一個 VM 上新增與 S3 相容的物件儲存伺服器。您可以使用高可用性叢集的物件儲存庫伺服器備份資料,並從伺服器還原叢集。
必要條件
- 已啟用計費功能的 Google Cloud 專案。
- 高可用性程式碼研究室列出的 IAM 角色。
- 具備 Linux 指令和 SQL 的基本知識。
課程內容
- 如何安裝及執行與 S3 相容的物件儲存庫伺服器,以進行備份。
- 如何建立備份方案,將備份寫入與 S3 相容的儲存空間。
- 如何建立隨選備份。
- 如何從備份還原叢集,以及如何還原至特定時間點。
軟硬體需求
- AlloyDB Omni 軟體存放區和自動調度管理工具 Ansible 集合的網址。如要取得網址,請填寫 AlloyDB Omni 註冊表單。詳情請參閱「AlloyDB Omni 使用 RPM 簡介」。您會在 HA 程式碼研究室中使用這些網址。
- 來自「使用 RPM 自動調度管理工具在 GCE VM 上部署 AlloyDB Omni 高可用性叢集」程式碼研究室的 AlloyDB Omni HA 叢集。
- 可存取 Google Cloud 和 Cloud Shell 的終端機。
2. 設定和需求條件
- 在本步驟中,您將使用程式碼實驗室「使用 RPM 自動調度管理工具在 GCE VM 上部署 AlloyDB Omni 高可用性叢集」,建立高可用性叢集。請完成下列步驟。如果您已在程式碼研究室中建立叢集,請繼續下一個步驟。
- 注意:此時請勿執行「清除資源」步驟。您將在本程式碼研究室的結尾執行該步驟。
- 返回這個程式碼實驗室
3. 連線至叢集並新增範例資料
在這個步驟中,您會在控制 VM 上載入叢集設定。接著連線至叢集,並新增含有範例資料的資料表。
- 如果尚未連線至控制項 VM,請從 Cloud Shell 連線:
gcloud compute ssh "$CLUSTER-control" --zone="$ZONE" --project="$PROJECT"CLUSTER、ZONE和PROJECT變數來自「使用 RPM 自動調度管理工具在 GCE VM 上部署 AlloyDB Omni 高可用性叢集」程式碼研究室的「準備要部署的 VM」步驟。如果 Cloud Shell 沒有這些變數,請重新設定。 - 在控制項 VM 上,切換至主目錄並載入環境變數。然後將叢集名稱和 SSH 使用者新增至環境檔案:
cd ~ source /tmp/cluster.conf cat >> ~/.codelab.env <<EOF export CLUSTER="$cluster" export SSH_USER="$service_account" EOF source ~/.codelab.env env | grep -E '^(CLUSTER|SSH_USER|VIRTUAL_IP)='CLUSTER、SSH_USER和VIRTUAL_IP。注意:如果之後再次連線至控制 VM,請先執行cd ~和source ~/.codelab.env,再繼續操作。 - 將連線設定新增至環境檔案。
read指令要求輸入密碼時,請輸入postgres使用者的密碼。您會在「使用 RPM 自動調度管理工具在 GCE VM 上部署 AlloyDB Omni 高可用性叢集」程式碼研究室的「啟動 AlloyDB Omni 叢集」步驟中設定這個密碼cat >> ~/.codelab.env <<'EOF' export PATH="/usr/pgsql-18/bin:$PATH" export PGHOST="$VIRTUAL_IP" export PGUSER="postgres" EOF read -rsp "Password of the postgres user: " PGPASSWORD; echo printf 'export PGPASSWORD=%q\n' "$PGPASSWORD" >> ~/.codelab.env source ~/.codelab.env env | grep -E '^(PGHOST|PGUSER|PGPASSWORD)=' - 建立資料表並新增 1,000 列:
psql <<'SQL' CREATE TABLE public.orders ( id integer PRIMARY KEY, item text NOT NULL, created_at timestamptz NOT NULL DEFAULT pg_catalog.now() ); INSERT INTO public.orders (id, item) SELECT g, 'item-' || g FROM pg_catalog.generate_series(1, 1000) AS g; SQL - 計算資料列數:
psql -c "SELECT pg_catalog.count(*) FROM public.orders;"1000。
4. 安裝並執行與 S3 相容的物件儲存庫
在這個步驟中,您會編寫 Ansible 劇本,在控制 VM 上安裝 MinIO 伺服器。劇本也會建立備份用的 bucket 和使用者,並確保資料庫 VM 可以連線至 MinIO。請在控制項 VM 上執行這個步驟中的所有指令。
- 在控制 VM 上,將儲存空間設定新增至環境檔案。
openssl指令會產生隨機密碼。MD=http://metadata.google.internal/computeMetadata/v1/instance S3_IP=$(curl -s -H "Metadata-Flavor: Google" "$MD/network-interfaces/0/ip") cat >> ~/.codelab.env <<EOF export S3_IP="$S3_IP" export S3_HOST="$CLUSTER-control" export S3_BUCKET="alloydb-backups" export S3_REGION="us-east-1" export MINIO_ROOT_USER="s3admin" export MINIO_ROOT_PASSWORD="$(openssl rand -hex 16)" export S3_ACCESS_KEY_ID="alloydb-backup" export S3_SECRET_ACCESS_KEY="$(openssl rand -hex 16)" export MINIO_URL="https://github.com/minio/minio/releases/download/RELEASE.2024-05-10T01-41-38Z/minio.linux-amd64.RELEASE.2024-05-10T01-41-38Z" export MC_URL="https://github.com/minio/mc/releases/download/RELEASE.2024-05-09T17-04-24Z/mc.linux-amd64.RELEASE.2024-05-09T17-04-24Z" EOF source ~/.codelab.env echo "$S3_HOST $S3_IP"my-cluster-control 10.1.0.2。資料庫 VM 會使用這個主機名稱和 IP 位址連線至 MinIO。VM 的中繼資料伺服器會提供 IP 位址。詳情請參閱 VM 中繼資料說明文件。MINIO_URL和MC_URL值分別是 MinIO 伺服器和 MinIO 用戶端 (mc) 的下載網址。 - 在控制 VM 上安裝必要的
community.cryptoAnsible 集合:ansible-galaxy collection install community.crypto - 建立
s3_server.yaml應對手冊:cat > s3_server.yaml <<EOF - name: Install and run MinIO on the control VM hosts: localhost connection: local become: true gather_facts: false tasks: - name: Create MinIO directories ansible.builtin.file: path: "{{ item }}" state: directory mode: "0755" loop: - /var/lib/minio/data - /var/lib/minio/certs - name: Download MinIO server and client ansible.builtin.get_url: url: "{{ item.url }}" dest: "{{ item.dest }}" mode: "0755" loop: - url: "$MINIO_URL" dest: /usr/local/bin/minio - url: "$MC_URL" dest: /usr/local/bin/mc - name: Generate MinIO TLS private key community.crypto.openssl_privatekey: path: /var/lib/minio/certs/private.key size: 2048 mode: "0600" - name: Generate MinIO certificate signing request community.crypto.openssl_csr_pipe: privatekey_path: /var/lib/minio/certs/private.key common_name: "$S3_HOST" subject_alt_name: - "DNS:$S3_HOST" - "DNS:$S3_BUCKET.$S3_HOST" - "DNS:localhost" - "IP:127.0.0.1" - "IP:$S3_IP" register: minio_csr - name: Generate self-signed MinIO TLS certificate community.crypto.x509_certificate: path: /var/lib/minio/certs/public.crt csr_content: "{{ minio_csr.csr }}" privatekey_path: /var/lib/minio/certs/private.key provider: selfsigned selfsigned_not_after: "+365d" mode: "0644" - name: Create MinIO systemd service unit ansible.builtin.copy: dest: /etc/systemd/system/minio.service mode: "0600" content: | [Unit] Description=MinIO Object Storage After=network.target [Service] Environment="MINIO_ROOT_USER=$MINIO_ROOT_USER" Environment="MINIO_ROOT_PASSWORD=$MINIO_ROOT_PASSWORD" Environment="MINIO_DOMAIN=$S3_HOST" ExecStart=/usr/local/bin/minio server /var/lib/minio/data --certs-dir /var/lib/minio/certs Restart=on-failure [Install] WantedBy=multi-user.target - name: Start and enable MinIO service ansible.builtin.systemd_service: name: minio daemon_reload: true state: started enabled: true - name: Add storage host names to /etc/hosts on the control VM ansible.builtin.lineinfile: path: /etc/hosts line: "$S3_IP $S3_HOST $S3_BUCKET.$S3_HOST" state: present - name: Wait for MinIO health endpoint ansible.builtin.uri: url: "https://$S3_HOST:9000/minio/health/live" ca_path: /var/lib/minio/certs/public.crt status_code: 200 register: minio_health until: minio_health.status == 200 retries: 6 delay: 5 - name: Create backup bucket and user in MinIO ansible.builtin.command: argv: "{{ item }}" loop: - - /usr/local/bin/mc - --insecure - alias - set - s3repo - "https://$S3_HOST:9000" - "$MINIO_ROOT_USER" - "$MINIO_ROOT_PASSWORD" - - /usr/local/bin/mc - --insecure - mb - --ignore-existing - "s3repo/$S3_BUCKET" - - /usr/local/bin/mc - --insecure - admin - user - add - s3repo - "$S3_ACCESS_KEY_ID" - "$S3_SECRET_ACCESS_KEY" - - /usr/local/bin/mc - --insecure - admin - policy - attach - s3repo - readwrite - --user - "$S3_ACCESS_KEY_ID" become: false no_log: true - name: Configure database VMs for MinIO hosts: primary_instance_nodes become: true gather_facts: false vars: ansible_user: $SSH_USER ansible_ssh_private_key_file: $HOME/ssh-key-cluster-sa tasks: - name: Set SELinux to permissive mode ansible.builtin.command: cmd: setenforce 0 - name: Add storage host names to /etc/hosts ansible.builtin.lineinfile: path: /etc/hosts line: "$S3_IP $S3_HOST $S3_BUCKET.$S3_HOST" state: present - name: Verify storage host resolution ansible.builtin.getent: database: hosts key: "$S3_BUCKET.$S3_HOST" - name: Verify connection to MinIO ansible.builtin.uri: url: "https://$S3_HOST:9000/minio/health/live" validate_certs: false status_code: 200 EOFMINIO_DOMAIN變數可讓 MinIO 接受虛擬主機型要求。RPM 自動調度管理工具會使用alloydb-backup使用者寫入備份。readwrite政策是 MinIO 內建政策。 - 執行應對手冊:
ansible-playbook s3_server.yaml -i deployment_spec.yamlPLAY RECAP輸出內容顯示localhost和每個資料庫 VM 的failed=0。 - 確認 bucket 是否存在:
mc --insecure ls s3repoalloydb-backups/bucket。
5. 建立備份方案
備份方案包含叢集備份的儲存位置、排程和保留期限。在這個步驟中,您將為 MinIO bucket 建立備份計畫。
- 在控制 VM 上,建立備份應對手冊和狀態應對手冊。您可以使用
Secret、BackupPlan和Backup資源的備份教戰手冊。您可以使用狀態劇本顯示資源的狀態。cat > backup.yaml <<EOF - name: Manage AlloyDB Omni backups hosts: localhost roles: - role: google.alloydbomni_orchestrator.backup EOF cat > status.yaml <<EOF - name: Get resource status hosts: localhost roles: - role: google.alloydbomni_orchestrator.status EOF - 為 S3 憑證建立
Secret資源。然後套用資源:S3_KEY_ID_B64=$(printf '%s' "$S3_ACCESS_KEY_ID" | base64 -w 0) S3_KEY_B64=$(printf '%s' "$S3_SECRET_ACCESS_KEY" | base64 -w 0) cat > s3_secret.yaml <<EOF Secret: metadata: name: s3-backup-secret spec: type: Opaque data: access-key-id: "$S3_KEY_ID_B64" access-key: "$S3_KEY_B64" EOF ansible-playbook backup.yaml -i deployment_spec.yaml \ -e resource_spec=s3_secret.yamldata區段中的索引鍵名稱必須為access-key-id和access-key。您必須先套用Secret資源,才能套用BackupPlan資源。 - 建立
BackupPlan資源,然後套用該資源:cat > backup_plan.yaml <<EOF BackupPlan: metadata: name: s3-backup-plan spec: dbclusterRef: $CLUSTER backupLocation: type: S3 s3Options: bucket: $S3_BUCKET key: /backups endpoint: https://$S3_HOST:9000 region: $S3_REGION secretRef: name: s3-backup-secret caBundle: - | $(sed 's/^/ /' /var/lib/minio/certs/public.crt) EOF ansible-playbook backup.yaml -i deployment_spec.yaml \ -e resource_spec=backup_plan.yamlkey值是 bucket 中備份的路徑。這個路徑必須以斜線 (/) 開頭。caBundle欄位包含 PEM 編碼的 CA 憑證,用於驗證 S3 儲存伺服器的憑證。 - 確認備份方案已準備就緒:
ansible-playbook status.yaml -i deployment_spec.yaml \ -e resource_type=BackupPlan -e resource_name=s3-backup-planphase欄位顯示Ready。如果階段不是Ready,請稍候一分鐘,然後再次執行指令。 - 建立備份計畫後,RPM 協調器會自動啟動初始完整備份。請先確認初始備份完成,再建立隨選備份:
ansible-playbook status.yaml -i deployment_spec.yaml \
    -e resource_type=Backup
6. 建立隨選備份
在這個步驟中,您會建立叢集的隨選備份。
- 在控制 VM 上建立
Backup資源。然後套用資源:cat > create_backup.yaml <<EOF Backup: metadata: name: s3-backup-1 spec: backupPlanRef: s3-backup-plan dbclusterRef: $CLUSTER EOF ansible-playbook backup.yaml -i deployment_spec.yaml \ -e resource_spec=create_backup.yamlbackupPlanRef欄位是備份方案的名稱。dbclusterRef欄位是叢集名稱。 - 確認備份作業是否已完成:
ansible-playbook status.yaml -i deployment_spec.yaml \ -e resource_type=Backup -e resource_name=s3-backup-1phase欄位顯示Succeeded。如果階段不是Succeeded,請稍候一分鐘,然後再次執行指令。 - 確認備份檔案位於 bucket 中:
mc --insecure tree "s3repo/$S3_BUCKET"backup資料夾,其中包含db資料夾。
7. 從備份還原叢集
RPM 編排器會就地還原叢集。在這個步驟中,您將刪除資料表,然後從備份還原。然後,您可以選擇將叢集還原至特定時間點。
注意:還原作業會覆寫資料庫叢集中的所有資料。
從備份還原
- 在控制 VM 上,刪除
orders資料表。然後計算資料列數:psql -c "DROP TABLE public.orders;" psql -c "SELECT pg_catalog.count(*) FROM public.orders;" - 建立還原應對手冊:
cat > restore.yaml <<EOF - name: Restore AlloyDB Omni cluster hosts: localhost roles: - role: google.alloydbomni_orchestrator.restore EOF - 為
s3-backup-1備份建立Restore資源。然後套用資源:cat > restore_backup.yaml <<EOF Restore: metadata: name: s3-restore-1 spec: sourceDBCluster: $CLUSTER backup: s3-backup-1 EOF ansible-playbook restore.yaml -i deployment_spec.yaml \ -e resource_spec=restore_backup.yaml - 確認還原作業已完成:
ansible-playbook status.yaml -i deployment_spec.yaml \ -e resource_type=Restore -e resource_name=s3-restore-1phase欄位顯示ProvisionSucceeded。如果階段不是ProvisionSucceeded,請稍候一分鐘,然後再次執行指令。 - 計算復原資料表中的資料列數:
psql -c "SELECT pg_catalog.count(*) FROM public.orders;"1000。
(選用) 還原至某個時間點
時間點還原作業會使用備份和封存的預寫記錄檔 (WAL)。您可以將叢集還原至備份方案復原期間內的任何時間點。
目標時間的規則
您必須遵守所有規則,才能選擇目標時間的值和格式:
- 請使用 RFC 3339 格式 (世界標準時間):
YYYY-MM-DDThh:mm:ssZ。舉例來說,2026-06-19T14:30:00Z是 2026 年 6 月 19 日下午 2:30 (世界標準時間)。字母T可分隔日期和時間。字母Z代表世界標準時間。 - 使用過去的時間。
- 請使用
BackupPlanCRD 的recoveryWindow欄位begin值之後的時間。
如要以 RFC 3339 格式顯示目前時間,請執行下列指令:
date -u +%Y-%m-%dT%H:%M:%SZ
如要將當地時間轉換為這種格式,請在 date 指令中加入當地時間的 UTC 偏移量。舉例來說,下列指令會變更 UTC+02:00 的 16:30:00 19 June 2026:
date -u -d "2026-06-19 16:30:00 +0200" +%Y-%m-%dT%H:%M:%SZ
指令會傳回 2026-06-19T14:30:00Z。
還原至錄製時間
在本程序中,您會在表格中新增資料列並記錄時間。記錄時間時,您會為資料庫完全完好無損的確切時刻 (正好有 1,500 個資料列) 加上書籤。接著,您會刪除資料列,並將叢集還原至記錄的時間。
- 在表格中新增 500 列:
psql <<'SQL' INSERT INTO public.orders (id, item) SELECT g, 'item-' || g FROM pg_catalog.generate_series(1001, 1500) AS g; SQL - 記錄時間。目前表格有 1,500 列。
sleep 5 PITR_TIME=$(date -u +%Y-%m-%dT%H:%M:%SZ) echo "export PITR_TIME=$PITR_TIME" >> ~/.codelab.env echo "$PITR_TIME" sleep 5YYYY-MM-DDThh:mm:ssZ格式,例如2026-10-05T11:16:02Z。 - 從資料表中刪除資料列,模擬資料遭意外刪除的情況。然後啟動新的 WAL 檔案:
psql -c "DELETE FROM public.orders WHERE id > 1000;" psql -c "SELECT pg_catalog.count(*) FROM public.orders;" psql -c "SELECT pg_catalog.pg_switch_wal();"count查詢顯示1000。pg_switch_wal函式會讓伺服器啟動新的 WAL 檔案。接著,伺服器可以封存包含變更的 WAL 檔案。 - 確認備份計畫的復原時間範圍包含錄製時間:
test -n "$PITR_TIME" || { echo "PITR_TIME is not set. Run step 2 again."; exit 1; } echo "$PITR_TIME" ansible-playbook status.yaml -i deployment_spec.yaml \ -e resource_type=BackupPlan -e resource_name=s3-backup-planPITR_TIME值晚於recoveryWindow欄位的begin值。 - 為記錄的時間建立
Restore資源。然後套用資源:cat > restore_pitr.yaml <<EOF Restore: metadata: name: s3-restore-pitr spec: sourceDBCluster: $CLUSTER pointInTime: "$PITR_TIME" EOF ansible-playbook restore.yaml -i deployment_spec.yaml \ -e resource_spec=restore_pitr.yaml - 確認還原作業已完成:
ansible-playbook status.yaml -i deployment_spec.yaml \ -e resource_type=Restore -e resource_name=s3-restore-pitrphase欄位顯示ProvisionSucceeded。如果階段不是ProvisionSucceeded,請稍候一分鐘,然後再次執行指令。 - 計算資料列數:
psql -c "SELECT pg_catalog.count(*) FROM public.orders;"1500。
8. 清除
如要避免系統向您的 Google Cloud 帳戶收費,請刪除本程式碼研究室和「使用 RPM Orchestrator 在 GCE VM 上部署 AlloyDB Omni 高可用性叢集」程式碼研究室的資源。請先刪除備份資源,再刪除叢集和運算環境。
- 在控制 VM 上,建立刪除劇本:
cat > delete.yaml <<EOF - name: Delete AlloyDB Omni resources hosts: localhost roles: - role: google.alloydbomni_orchestrator.delete EOF - 列出備份:
ansible-playbook status.yaml -i deployment_spec.yaml -e resource_type=Backups3-backup-1備份。 - 刪除
s3-backup-1備份:ansible-playbook delete.yaml -i deployment_spec.yaml \ -e resource_type=Backup -e resource_name=s3-backup-1 - 刪除備份方案:
ansible-playbook delete.yaml -i deployment_spec.yaml \ -e resource_type=BackupPlan -e resource_name=s3-backup-plan - 使用「使用 RPM 自動調度管理工具在 GCE VM 上部署 AlloyDB Omni 高可用性叢集」程式碼實驗室中的「清除資源」步驟,刪除叢集和運算環境。MinIO 伺服器和其中的備份位於控制項 VM。刪除運算環境時,伺服器和備份都會一併刪除。
9. 恭喜
恭喜!您使用 RPM 自動調度管理工具,將高可用性 (HA) 叢集備份至與 S3 相容的 AlloyDB Omni 物件儲存庫。然後從備份還原叢集。
涵蓋內容
- 如何安裝及執行 MinIO 做為與 S3 相容的物件儲存庫。
- 如何建立備份方案和隨選備份。
- 如何從備份還原叢集,以及如何還原至特定時間點。
如需詳細資訊,請參閱以下頁面: