

1. परिचय
इस लैब में, क्लाइंट एजेंट सेवा को लागू करने और डिप्लॉय करने पर फ़ोकस किया गया है. Agent Development Kit (ADK) का इस्तेमाल करके, एक ऐसा एआई एजेंट बनाया जाएगा जो रिमोट टूल का इस्तेमाल करता है. जैसे, लैब 1 में बनाया गया एमसीपी सर्वर. इसमें आर्किटेक्चर के मुख्य सिद्धांत के बारे में बताया गया है. यह सिद्धांत, चिंताओं को अलग करने का सिद्धांत है. इसमें एक अलग रीज़निंग लेयर (एजेंट), एक अलग टूलिंग लेयर (एमसीपी सर्वर) के साथ सुरक्षित एपीआई के ज़रिए कम्यूनिकेट करती है.
पहली लैब में, आपने एक एमसीपी सर्वर बनाया था. यह सर्वर, एलएलएम को किसी काल्पनिक चिड़ियाघर में मौजूद जानवरों के बारे में डेटा उपलब्ध कराता है. उदाहरण के लिए, Antigravity CLI (agy) का इस्तेमाल करते समय. इस लैब में, हम काल्पनिक चिड़ियाघर के लिए एक टूर गाइड एजेंट बना रहे हैं. यह एजेंट, चिड़ियाघर के जानवरों के बारे में जानकारी पाने के लिए, लैब 1 के एमसीपी सर्वर का इस्तेमाल करेगा. साथ ही, Wikipedia का इस्तेमाल करके टूर गाइड का सबसे अच्छा अनुभव देगा.
आखिर में, हम टूर गाइड एजेंट को Google Cloud Run पर डिप्लॉय करेंगे, ताकि इसे सिर्फ़ स्थानीय तौर पर चलाने के बजाय, चिड़ियाघर में आने वाले सभी लोग ऐक्सेस कर सकें.
ज़रूरी शर्तें
- Cloud Run पर चल रहा एमसीपी सर्वर या उससे जुड़ा सेवा का यूआरएल.
- बिलिंग की सुविधा वाला Google क्लाउड प्रोजेक्ट.
- इंस्टॉल किए गए सीएलआई टूल:
gcloud,uv,agy.
आपको क्या सीखने को मिलेगा
- एडीके डिप्लॉयमेंट के लिए, Python प्रोजेक्ट को स्ट्रक्चर करने का तरीका.
- google-adk की मदद से, टूल का इस्तेमाल करने वाले एजेंट को लागू करने का तरीका.
- किसी एजेंट को उसके टूलसेट के लिए, रिमोट एमसीपी सर्वर से कैसे कनेक्ट करें.
- Python ऐप्लिकेशन को Cloud Run पर सर्वरलेस कंटेनर के तौर पर डिप्लॉय करने का तरीका.
- आईएएम भूमिकाओं का इस्तेमाल करके, सेवा से सेवा के बीच सुरक्षित तरीके से पुष्टि करने की सुविधा को कॉन्फ़िगर करने का तरीका.
- आने वाले समय में लगने वाले शुल्क से बचने के लिए, Cloud संसाधनों को मिटाने का तरीका.
आपको इन चीज़ों की ज़रूरत होगी
- Google Cloud खाता और Google Cloud प्रोजेक्ट
- कोई वेब ब्राउज़र, जैसे कि Chrome
2. Cloud Run पर डिप्लॉय क्यों करें?
ADK एजेंट को होस्ट करने के लिए, Cloud Run एक बेहतरीन विकल्प है. ऐसा इसलिए, क्योंकि यह एक सर्वरलेस प्लैटफ़ॉर्म है. इसका मतलब है कि आपको अपने कोड पर ध्यान देना होगा, न कि बुनियादी ढांचे को मैनेज करने पर. हम आपके लिए ऑपरेशनल काम करते हैं.
इसे एक पॉप-अप शॉप की तरह समझें: यह सिर्फ़ तब खुलती है और संसाधनों का इस्तेमाल करती है, जब ग्राहक (अनुरोध) आते हैं. जब कोई खरीदार नहीं होता है, तो यह पूरी तरह से बंद हो जाता है. साथ ही, आपको खाली स्टोर के लिए कोई शुल्क नहीं देना पड़ता.
मुख्य सुविधाएं
'कंटेनर को किसी भी जगह पर चलाने की सुविधा' का इस्तेमाल करता है:
- आपको एक कंटेनर (Docker इमेज) लाना होगा, जिसमें आपका ऐप्लिकेशन मौजूद हो.
- Cloud Run, इसे Google के इंफ़्रास्ट्रक्चर पर चलाता है.
- ओएस पैचिंग, वीएम सेटअप या स्केलिंग से जुड़ी कोई समस्या नहीं होती.
अपने-आप स्केल होने की सुविधा:
- अगर कोई भी व्यक्ति आपके ऐप्लिकेशन का इस्तेमाल नहीं कर रहा है, तो 0 इंस्टेंस चलेंगे. इससे इंस्टेंस की संख्या कम होकर शून्य हो जाएगी, जिससे लागत कम हो जाएगी.
- अगर इस पर 1,000 अनुरोध आते हैं, तो यह ज़रूरत के हिसाब से उतनी कॉपी बना लेता है.
डिफ़ॉल्ट रूप से स्टेटलेस:
- हर अनुरोध अलग-अलग इंस्टेंस पर जा सकता है.
- अगर आपको स्थिति को सेव करना है, तो Cloud SQL, Firestore या Memorystore जैसी किसी बाहरी सेवा का इस्तेमाल करें.
किसी भी भाषा या फ़्रेमवर्क के साथ काम करता है:
- Cloud Run को इससे कोई फ़र्क़ नहीं पड़ता कि वह Python, Go, Node.js, Java या .Net है. हालांकि, यह ज़रूरी है कि वह Linux कंटेनर में चलता हो.
इस्तेमाल के हिसाब से पेमेंट करें:
- अनुरोध के आधार पर बिलिंग: हर अनुरोध के हिसाब से बिलिंग की जाती है. साथ ही, कंप्यूटिंग में लगने वाले समय (100 मि॰से॰ तक) के हिसाब से भी बिलिंग की जाती है.
- इंस्टेंस के आधार पर बिलिंग: पूरे इंस्टेंस के लिए बिल किया जाता है (हर अनुरोध के लिए कोई शुल्क नहीं).
3. शुरू करने से पहले
अपने हिसाब से एनवायरमेंट सेट अप करना
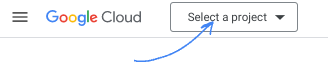
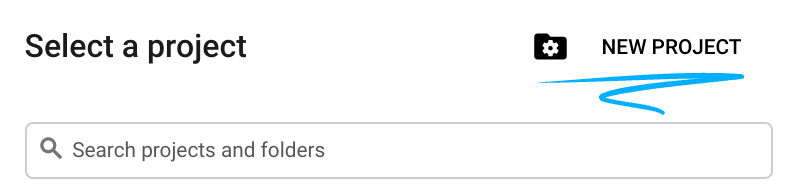
- Google Cloud Console में साइन इन करें और नया प्रोजेक्ट बनाएं या किसी मौजूदा प्रोजेक्ट का फिर से इस्तेमाल करें. अगर आपके पास पहले से कोई Gmail या Google Workspace खाता नहीं है, तो आपको एक खाता बनाना होगा.
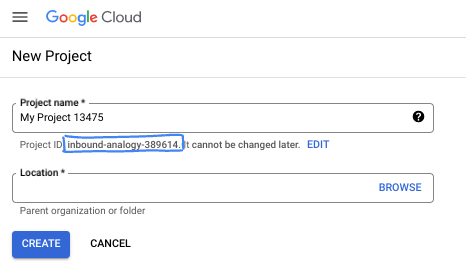
- प्रोजेक्ट का नाम, इस प्रोजेक्ट में हिस्सा लेने वाले लोगों के लिए डिसप्ले नेम होता है. यह एक वर्ण स्ट्रिंग है, जिसका इस्तेमाल Google API नहीं करते. इसे कभी भी अपडेट किया जा सकता है.
- प्रोजेक्ट आईडी, सभी Google Cloud प्रोजेक्ट के लिए यूनीक होता है. साथ ही, इसे बदला नहीं जा सकता. Cloud Console, अपने-आप एक यूनीक स्ट्रिंग जनरेट करता है. आम तौर पर, आपको इससे कोई फ़र्क़ नहीं पड़ता कि यह क्या है. ज़्यादातर कोडलैब में, आपको अपने प्रोजेक्ट आईडी (आम तौर पर
PROJECT_IDके तौर पर पहचाना जाता है) का रेफ़रंस देना होगा. अगर आपको जनरेट किया गया आईडी पसंद नहीं है, तो कोई दूसरा रैंडम आईडी जनरेट किया जा सकता है. इसके अलावा, आपके पास अपना नाम आज़माने का विकल्प भी है. इससे आपको पता चलेगा कि वह नाम उपलब्ध है या नहीं. इस चरण के बाद, इसे बदला नहीं जा सकता. यह प्रोजेक्ट की अवधि तक बना रहता है. - आपकी जानकारी के लिए बता दें कि एक तीसरी वैल्यू, प्रोजेक्ट नंबर भी होती है. इसका इस्तेमाल कुछ एपीआई करते हैं. इन तीनों वैल्यू के बारे में ज़्यादा जानने के लिए, दस्तावेज़ पढ़ें.
- इसके बाद, आपको Cloud Console में बिलिंग की सुविधा चालू करनी होगी, ताकि Cloud संसाधनों/एपीआई का इस्तेमाल किया जा सके. इस कोडलैब को पूरा करने में ज़्यादा समय नहीं लगेगा. इस ट्यूटोरियल के बाद बिलिंग से बचने के लिए, संसाधनों को शट डाउन करें. इसके लिए, बनाए गए संसाधनों को मिटाएं या प्रोजेक्ट को मिटाएं. Google Cloud के नए उपयोगकर्ताओं को, मुफ़्त में आज़माने के लिए 300 डॉलर का क्रेडिट मिलेगा.
Cloud Shell शुरू करें
- Cloud Shell Editor पर जाएं
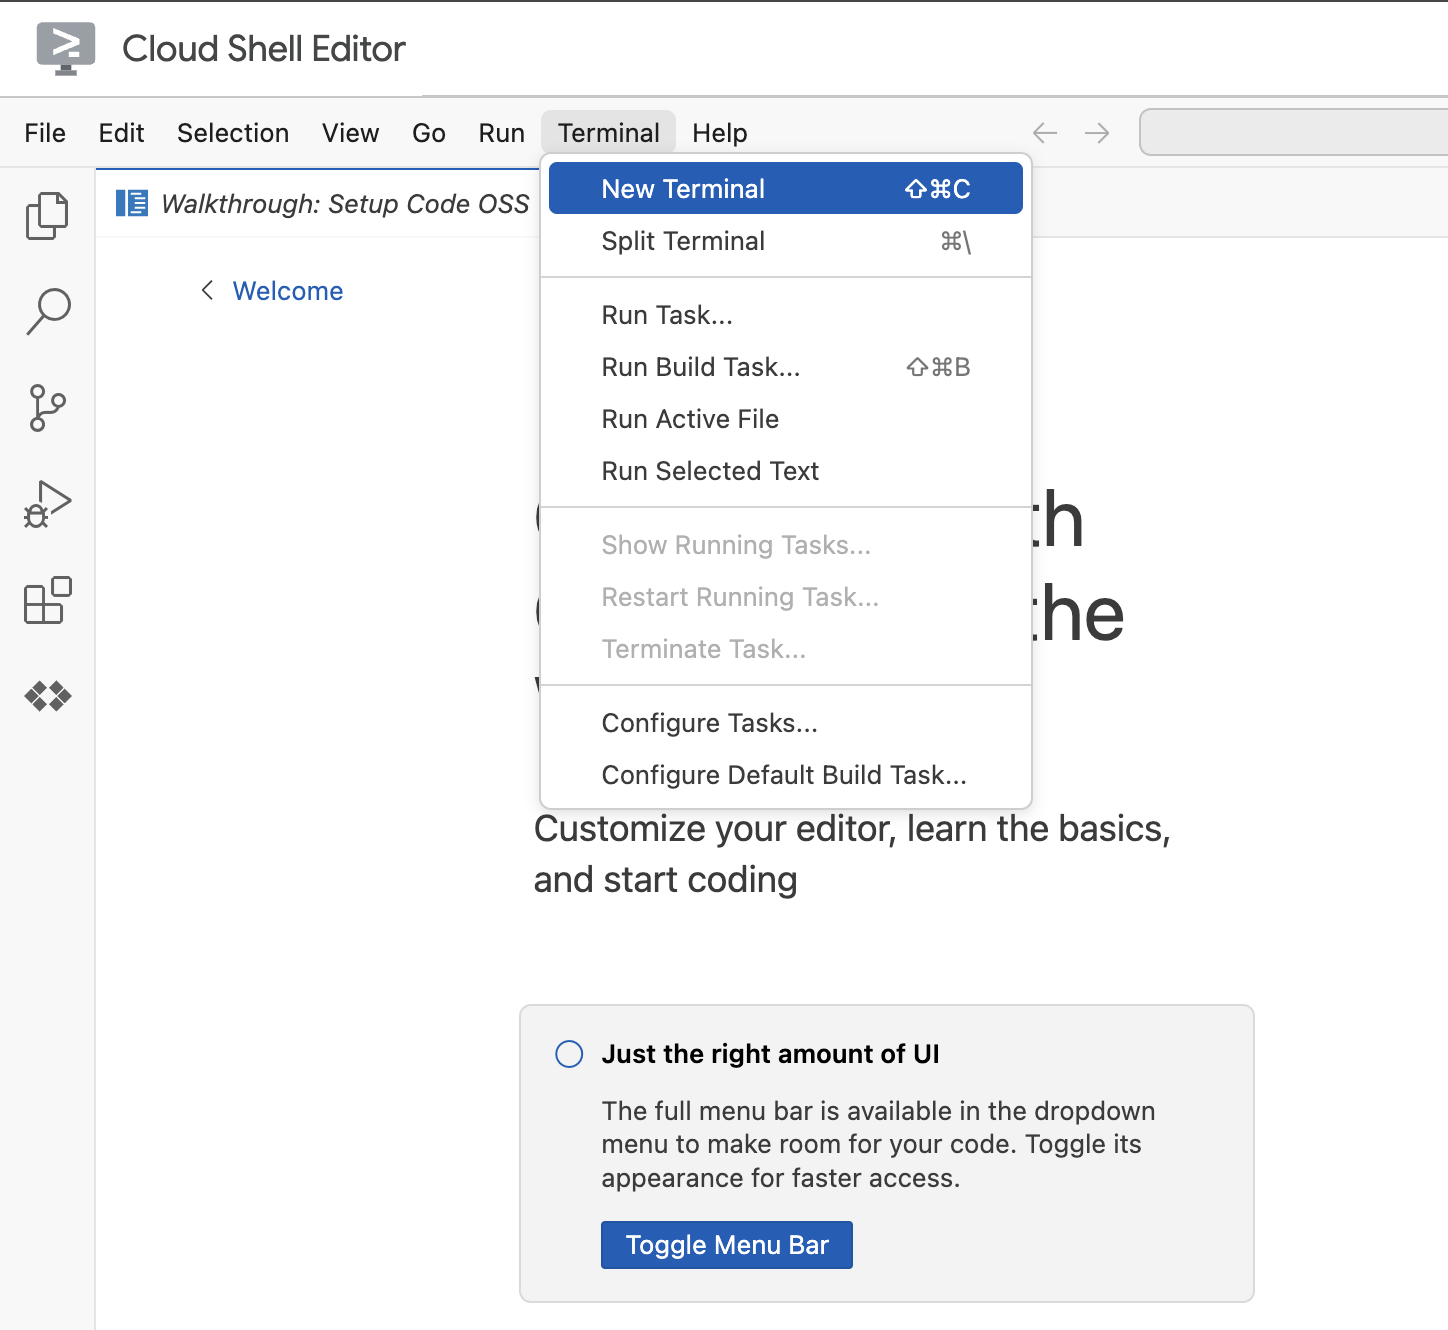
- अगर टर्मिनल, स्क्रीन पर सबसे नीचे नहीं दिखता है, तो इसे खोलें:
- टर्मिनल पर क्लिक करें
- नया टर्मिनल पर क्लिक करें
- टर्मिनल में, इस कमांड का इस्तेमाल करके अपना प्रोजेक्ट सेट करें. अगर आपने पहला लैब पूरा कर लिया है, तो पक्का करें कि आपने एक ही प्रोजेक्ट आईडी का इस्तेमाल किया हो:
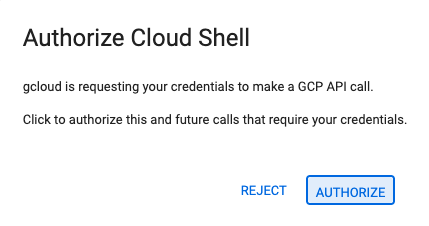
gcloud config set project [YOUR-PROJECT-ID]gcloud projects list | awk '/PROJECT_ID/{print $2}' - अगर अनुमति देने के लिए कहा जाए, तो जारी रखने के लिए अनुमति दें पर क्लिक करें.
- आपको यह मैसेज दिखेगा:
Updated property [core/project].
WARNINGदिखता है और आपसेDo you want to continue (Y/n)?पूछा जाता है, तो इसका मतलब है कि आपने प्रोजेक्ट आईडी गलत डाला है.nदबाएं,Enterदबाएं, औरgcloud config set projectनिर्देश को फिर से चलाने की कोशिश करें.
4. अपना एनवायरमेंट सेट अप करना
एपीआई चालू करना और एनवायरमेंट वैरिएबल सेट करना
सभी ज़रूरी सेवाएं चालू करें:
gcloud services enable \
    run.googleapis.com \
    artifactregistry.googleapis.com \
    cloudbuild.googleapis.com \
    aiplatform.googleapis.com
अनुमानित आउटपुट
Operation "operations/acat.p2-[GUID]" finished successfully.
प्रोजेक्ट डायरेक्ट्री बनाएं.
इस कमांड से, एजेंट के सोर्स कोड के लिए लैब का मुख्य फ़ोल्डर बनता है.
cd && mkdir zoo_guide_agent && cd zoo_guide_agent
requirements.txt फ़ाइल बनाएं. इस फ़ाइल में, आपके एजेंट के लिए ज़रूरी Python लाइब्रेरी की सूची दी गई है. नीचे दी गई कमांड, फ़ाइल बनाती है और उसमें डेटा भरती है.
cloudshell edit requirements.txt
google-adk==1.14.0
langchain-community==0.3.27
wikipedia==1.4.0
अपने मौजूदा प्रोजेक्ट आईडी और प्रोजेक्ट नंबर के लिए वैरिएबल सेट करें. साथ ही, अपने प्रोजेक्ट के लिए एक खास सेवा खाता बनाएं. इन कमांड को चलाने का यह ज़्यादा बेहतर तरीका है.
export PROJECT_ID=$(gcloud config get-value project)
export PROJECT_NUMBER=$(gcloud projects describe $PROJECT_ID --format="value(projectNumber)")
export SA_NAME=lab2-cr-service
export SERVICE_ACCOUNT="${SA_NAME}@${PROJECT_ID}.iam.gserviceaccount.com"
gcloud iam service-accounts create ${SA_NAME} \
    --display-name="Service Account for lab 2 "
zoo_guide_agent डायरेक्ट्री में एजेंट की पुष्टि करने के लिए, .env फ़ाइल बनाएं और उसे खोलें.
cloudshell edit .env
cloudshell edit कमांड, टर्मिनल के ऊपर मौजूद एडिटर में .env फ़ाइल खोलेगी. .env फ़ाइल में यह जानकारी डालें और वापस टर्मिनल पर जाएं.
MODEL="gemini-3.5-flash"
GOOGLE_GENAI_USE_ENTERPRISE=true
GOOGLE_CLOUD_LOCATION=global
एमसीपी सर्वर का यूआरएल जोड़ा जा रहा है. अगर आपने पहला लैब पूरा कर लिया है, तो पहले लैब में बनाए गए एमसीपी सर्वर का इस्तेमाल करने के लिए, यह तरीका अपनाएं:
Gemini Enterprise के एजेंट प्लैटफ़ॉर्म पर Gemini का इस्तेमाल करने और रिमोट एमसीपी सर्वर को कॉल करने के लिए, एजेंट के सेवा खाते को अनुमतियां दें:
gcloud projects add-iam-policy-binding $PROJECT_ID \
  --member="serviceAccount:$SERVICE_ACCOUNT" \
  --role="roles/aiplatform.user"
gcloud projects add-iam-policy-binding $PROJECT_ID \
  --member="serviceAccount:$SERVICE_ACCOUNT" \
  --role="roles/run.invoker"
लैब 1 से एमसीपी सर्वर के यूआरएल को एनवायरमेंट वैरिएबल में सेव करें.
echo -e "\nMCP_SERVER_URL=https://zoo-mcp-server-${PROJECT_NUMBER}.us-west1.run.app/mcp" >> .env
अगर किसी सार्वजनिक एमसीपी सर्वर लिंक का इस्तेमाल किया जा रहा है, तो यहां दिया गया कोड चलाएं. साथ ही, PROJECT_NUMBER की जगह पर दिया गया कोड डालें.
echo -e "\nMCP_SERVER_URL=https://zoo-mcp-server-${PROJECT_NUMBER}.us-west1.run.app/mcp" >> .env
5. एजेंट वर्कफ़्लो बनाना
init.py फ़ाइल बनाएं
init.py फ़ाइल बनाएं. इस फ़ाइल से Python को पता चलता है कि zoo_guide_agent डायरेक्ट्री एक पैकेज है.
cloudshell edit __init__.py
पिछला निर्देश, कोड एडिटर खोलता है. __init__.py में यह कोड जोड़ें:
from . import agent
main_agent.py फ़ाइल बनाना
agent.py नाम की मुख्य फ़ाइल बनाएं. इस कमांड से Python फ़ाइल बनती है और इसमें मल्टी-एजेंट सिस्टम का पूरा कोड चिपकाया जाता है.
cloudshell edit agent.py
इंपोर्ट और शुरुआती सेटअप
पहले ब्लॉक में, ADK और Google Cloud से सभी ज़रूरी लाइब्रेरी शामिल की जाती हैं. यह लॉगिंग भी सेट अप करता है और आपकी .env फ़ाइल से एनवायरमेंट वैरिएबल लोड करता है. यह आपके मॉडल और सर्वर यूआरएल को ऐक्सेस करने के लिए ज़रूरी है.
अपनी agent.py फ़ाइल में यह कोड जोड़ें:
import os
import logging
import google.cloud.logging
from dotenv import load_dotenv

from google.adk import Agent
from google.adk.agents import SequentialAgent
from google.adk.tools.mcp_tool.mcp_toolset import MCPToolset, StreamableHTTPConnectionParams
from google.adk.tools.tool_context import ToolContext
from google.adk.tools.langchain_tool import LangchainTool

from langchain_community.tools import WikipediaQueryRun
from langchain_community.utilities import WikipediaAPIWrapper

import google.auth
import google.auth.transport.requests
import google.oauth2.id_token

# --- Setup Logging and Environment ---

cloud_logging_client = google.cloud.logging.Client()
cloud_logging_client.setup_logging()

load_dotenv()

model_name = os.getenv("MODEL")
टूल तय करना (एजेंट की क्षमताएं)
कोई एजेंट उतना ही अच्छा होता है जितना वह टूल इस्तेमाल कर सकता है. इस सेक्शन में, हम अपने एजेंट की सभी क्षमताओं के बारे में बताते हैं. इनमें डेटा सेव करने के लिए कस्टम फ़ंक्शन, हमारे सुरक्षित एमसीपी सर्वर से कनेक्ट होने वाला एमसीपी टूल, और Wikipedia टूल शामिल है.
agent.py फ़ाइल में सबसे नीचे यह कोड जोड़ें:
# Greet user and save their prompt

def add_prompt_to_state(
    tool_context: ToolContext, prompt: str
) -> dict[str, str]:
    """Saves the user's initial prompt to the state."""
    tool_context.state["PROMPT"] = prompt
    logging.info(f"[State updated] Added to PROMPT: {prompt}")
    return {"status": "success"}


# Configuring the MCP Tool to connect to the Zoo MCP server

mcp_server_url = os.getenv("MCP_SERVER_URL")
if not mcp_server_url:
    raise ValueError("The environment variable MCP_SERVER_URL is not set.")

def get_id_token():
    """Get an ID token to authenticate with the MCP server."""
    target_url = os.getenv("MCP_SERVER_URL")
    audience = target_url.split('/mcp/')[0]
    request = google.auth.transport.requests.Request()
    id_token = google.oauth2.id_token.fetch_id_token(request, audience)
    return id_token

"""
# Use this code if you are using the public MCP Server and comment out the code below defining mcp_tools
mcp_tools = MCPToolset(
    connection_params=StreamableHTTPConnectionParams(
        url=mcp_server_url
    )
)
"""

mcp_tools = MCPToolset(
            connection_params=StreamableHTTPConnectionParams(
                url=mcp_server_url,
                headers={
                    "Authorization": f"Bearer {get_id_token()}",
                },
            ),
        )

# Configuring the Wikipedia Tool
wikipedia_tool = LangchainTool(
    tool=WikipediaQueryRun(api_wrapper=WikipediaAPIWrapper())
)
तीनों टूल के बारे में जानकारी
add_prompt_to_state📝
यह टूल, ज़ू में आने वाले व्यक्ति के सवालों को याद रखता है. जब कोई व्यक्ति पूछता है कि "शेर कहां हैं?", तो यह टूल उस सवाल को एजेंट की मेमोरी में सेव कर लेता है. इससे वर्कफ़्लो में शामिल अन्य एजेंट को पता चलता है कि उन्हें किस बारे में रिसर्च करनी है.
कैसे: यह एक Python फ़ंक्शन है. यह वेबसाइट पर आने वाले व्यक्ति के प्रॉम्प्ट को शेयर की गई tool_context.state डिक्शनरी में लिखता है. इस टूल के कॉन्टेक्स्ट से, एजेंट को किसी बातचीत के दौरान कुछ समय के लिए जानकारी याद रखने में मदद मिलती है. किसी एजेंट के सेव किए गए डेटा को, वर्कफ़्लो में मौजूद अगला एजेंट पढ़ सकता है.
MCPToolset🦁
इसका इस्तेमाल, टूर गाइड एजेंट को Lab 1 में बनाए गए चिड़ियाघर के एमसीपी सर्वर से कनेक्ट करने के लिए किया जाता है. इस सर्वर में हमारे जानवरों के बारे में खास जानकारी देखने के लिए, खास टूल मौजूद हैं. जैसे, उनका नाम, उम्र, और रहने की जगह.
कैसे: यह चिड़ियाघर के निजी सर्वर यूआरएल से सुरक्षित तरीके से कनेक्ट होता है. यह get_id_token का इस्तेमाल करके, सुरक्षित "कीकार्ड" (सेवा खाते का आईडी टोकन) अपने-आप हासिल करता है. इससे यह अपनी पहचान की पुष्टि कर पाता है और ऐक्सेस पा पाता है.
LangchainTool🌍
इससे टूर गाइड एजेंट को दुनिया के बारे में सामान्य जानकारी मिलती है. जब कोई व्यक्ति ऐसा सवाल पूछता है जिसका जवाब चिड़ियाघर के डेटाबेस में मौजूद नहीं है, जैसे कि "जंगल में शेर क्या खाते हैं?", तो यह टूल एजेंट को Wikipedia पर जवाब खोजने की सुविधा देता है.
कैसे: यह एक अडैप्टर के तौर पर काम करता है. इससे हमारा एजेंट, LangChain लाइब्रेरी से पहले से बना हुआ WikipediaQueryRun टूल इस्तेमाल कर पाता है.
संसाधन:
स्पेशलिस्ट एजेंट तय करना
इसके बाद, हम रिसर्चर एजेंट और रिस्पॉन्स फ़ॉर्मेटर एजेंट के बारे में बताएंगे. रिसर्च करने वाला एजेंट, हमारे ऑपरेशन का "दिमाग" होता है. यह एजेंट, शेयर किए गए State से उपयोगकर्ता का प्रॉम्प्ट लेता है. इसके बाद, यह अपने बेहतरीन टूल (ज़ू का एमसीपी सर्वर टूल और Wikipedia टूल) की जांच करता है. इसके बाद, यह तय करता है कि जवाब ढूंढने के लिए किन टूल का इस्तेमाल किया जाए.
जवाब को फ़ॉर्मैट करने वाले एजेंट की भूमिका, जवाब को पेश करना है. यह नई जानकारी ढूंढने के लिए किसी भी टूल का इस्तेमाल नहीं करता. इसके बजाय, यह रिसर्चर एजेंट से इकट्ठा किए गए रॉ डेटा (स्टेट के ज़रिए पास किया गया) का इस्तेमाल करता है. साथ ही, इसे बातचीत के लहज़े में जवाब देने के लिए, एलएलएम की भाषा से जुड़ी क्षमताओं का इस्तेमाल करता है.
agent.py के सबसे नीचे यह कोड जोड़ें:
# 1. Researcher Agent
comprehensive_researcher = Agent(
    name="comprehensive_researcher",
    model=model_name,
    description="The primary researcher that can access both internal zoo data and external knowledge from Wikipedia.",
    instruction="""
    You are a helpful research assistant. Your goal is to fully answer the user's PROMPT.
    You have access to two tools:
    1. A tool for getting specific data about animals AT OUR ZOO (names, ages, locations).
    2. A tool for searching Wikipedia for general knowledge (facts, lifespan, diet, habitat).

    First, analyze the user's PROMPT.
    - If the prompt can be answered by only one tool, use that tool.
    - If the prompt is complex and requires information from both the zoo's database AND Wikipedia,
      you MUST use both tools to gather all necessary information.
    - Synthesize the results from the tool(s) you use into preliminary data outputs.

    PROMPT:
    {{ PROMPT }}
    """,
    tools=[
        mcp_tools,
        wikipedia_tool
    ],
    output_key="RESEARCH_DATA" # A key to store the combined findings
)

# 2. Response Formatter Agent
response_formatter = Agent(
    name="response_formatter",
    model=model_name,
    description="Synthesizes all information into a friendly, readable response.",
    instruction="""
    You are the friendly voice of the Zoo Tour Guide. Your task is to take the
    RESEARCH_DATA and present it to the user in a complete and helpful answer.

    - First, present the specific information from the zoo (like names, ages, and where to find them).
    - Then, add the interesting general facts from the research.
    - If some information is missing, just present the information you have.
    - Be conversational and engaging.

    RESEARCH_DATA:
    {{ RESEARCH_DATA }}
    """
)
वर्कफ़्लो एजेंट
वर्कफ़्लो एजेंट, चिड़ियाघर के टूर के लिए ‘बैक-ऑफ़िस' मैनेजर के तौर पर काम करता है. यह रिसर्च के अनुरोध को लेता है और यह पक्का करता है कि ऊपर बताए गए दोनों एजेंट, अपने काम को सही क्रम में करें: पहले रिसर्च करें, फिर फ़ॉर्मैट करें. इससे, वेबसाइट पर आने वाले व्यक्ति के सवाल का जवाब देने के लिए, भरोसेमंद और अनुमानित प्रोसेस तैयार होती है.
कैसे: यह एक SequentialAgent है. यह एक खास तरह का एजेंट है, जो अपने-आप नहीं सोचता. इसका काम सिर्फ़ sub_agents (रिसर्चर और फ़ॉर्मेटर) की सूची को एक तय क्रम में चलाना है. साथ ही, शेयर की गई मेमोरी को एक से दूसरे में अपने-आप पास करना है.
इस कोड ब्लॉक को agent.py के सबसे नीचे जोड़ें:
tour_guide_workflow = SequentialAgent(
    name="tour_guide_workflow",
    description="The main workflow for handling a user's request about an animal.",
    sub_agents=[
        comprehensive_researcher, # Step 1: Gather all data
        response_formatter,       # Step 2: Format the final response
    ]
)
मुख्य वर्कफ़्लो को असेंबल करना 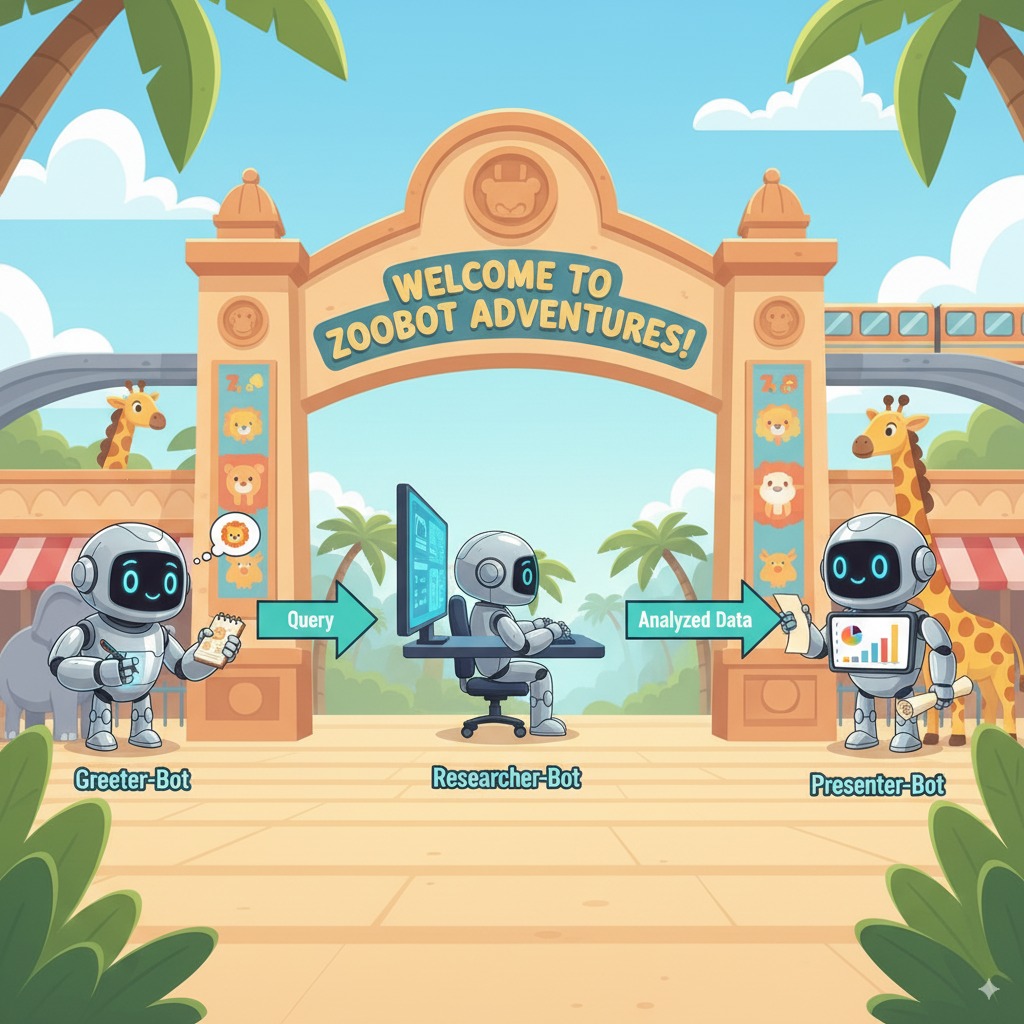
इस एजेंट को root_agent के तौर पर तय किया गया है. ADK फ़्रेमवर्क, सभी नई बातचीत के लिए इसे शुरुआती पॉइंट के तौर पर इस्तेमाल करता है. इसकी मुख्य भूमिका, पूरी प्रोसेस को मैनेज करना है. यह शुरुआती कंट्रोलर के तौर पर काम करता है. यह बातचीत के पहले चरण को मैनेज करता है.
कोड के इस आखिरी ब्लॉक को agent.py में सबसे नीचे जोड़ें:
root_agent = Agent(
    name="greeter",
    model=model_name,
    description="The main entry point for the Zoo Tour Guide.",
    instruction="""
    - Let the user know you will help them learn about the animals we have in the zoo.
    - When the user responds, use the 'add_prompt_to_state' tool to save their response.
    After using the tool, transfer control to the 'tour_guide_workflow' agent.
    """,
    tools=[add_prompt_to_state],
    sub_agents=[tour_guide_workflow]
)
आपकी agent.py फ़ाइल अब पूरी हो गई है! इस तरह से इसे बनाने पर, यह देखा जा सकता है कि हर कॉम्पोनेंट—टूल, वर्कर एजेंट, और मैनेजर एजेंट—की, फ़ाइनल और बेहतर सिस्टम बनाने में क्या भूमिका है. अगला चरण है, डिप्लॉयमेंट!
6. ADK CLI का इस्तेमाल करके एजेंट को डिप्लॉय करना
लोकल कोड तैयार होने और Google Cloud प्रोजेक्ट सेट अप होने के बाद, एजेंट को डिप्लॉय करने का समय आ गया है. आपको adk deploy cloud_run कमांड का इस्तेमाल करना होगा. यह एक सुविधाजनक टूल है, जो पूरे डिप्लॉयमेंट वर्कफ़्लो को अपने-आप पूरा करता है. इस एक कमांड से, आपका कोड पैकेज हो जाता है, कंटेनर इमेज बन जाती है, और उसे Artifact Registry पर पुश कर दिया जाता है. साथ ही, Cloud Run पर सेवा लॉन्च हो जाती है, ताकि इसे वेब पर ऐक्सेस किया जा सके.
लागू करना
अपने एजेंट को डिप्लॉय करने के लिए, यहां दी गई कमांड चलाएं. uvx कमांड की मदद से, Python पैकेज के तौर पर पब्लिश किए गए कमांड लाइन टूल चलाए जा सकते हैं. इसके लिए, इन टूल को ग्लोबल तौर पर इंस्टॉल करने की ज़रूरत नहीं होती.
# Run the deployment command
uvx --from google-adk==1.14.0 \
adk deploy cloud_run \
  --project=$PROJECT_ID \
  --region=us-west1 \
  --service_name=zoo-tour-guide \
  --with_ui \
  . \
  -- \
  --labels=dev-tutorial=codelab-adk \
  --service-account=$SERVICE_ACCOUNT
अनुरोध स्वीकार करना
आपको यह मैसेज दिख सकता है:
Deploying from source requires an Artifact Registry Docker repository to store built containers. A repository named [cloud-run-source-deploy] in region
[us-west1] will be created.

Do you want to continue (Y/n)?
Y टाइप करें और ENTER दबाएं.
आपको यह मैसेज दिख सकता है:
Allow unauthenticated invocations to [your-service-name] (y/N)?.
इस लैब के लिए, हम बिना पुष्टि किए गए अनुरोधों को अनुमति देना चाहते हैं, ताकि आसानी से जांच की जा सके. इसके लिए, y टाइप करें और Enter दबाएं.
डिप्लॉयमेंट लिंक पाना
कमांड के पूरा होने पर, यह डिप्लॉय की गई Cloud Run सेवा का यूआरएल उपलब्ध कराएगी. (यह https://zoo-tour-guide-123456789.us-west1.run.app जैसा दिखेगा). अगले टास्क के लिए, इस यूआरएल को कॉपी करें.
7. डिप्लॉय किए गए एजेंट को टेस्ट करना
आपका एजेंट अब Cloud Run पर लाइव हो गया है. इसलिए, आपको एक टेस्ट करना होगा. इससे यह पुष्टि की जा सकेगी कि एजेंट को सही तरीके से डिप्लॉय किया गया है और वह उम्मीद के मुताबिक काम कर रहा है. ADK के वेब इंटरफ़ेस को ऐक्सेस करने और एजेंट के साथ इंटरैक्ट करने के लिए, सार्वजनिक सेवा के यूआरएल (https://zoo-tour-guide-123456789.us-west1.run.app/ जैसा कुछ) का इस्तेमाल किया जाएगा.
अपने वेब ब्राउज़र में, Cloud Run की सार्वजनिक सेवा का यूआरएल खोलें. आपने --with_ui flag का इस्तेमाल किया है. इसलिए, आपको ADK डेवलपर यूज़र इंटरफ़ेस (यूआई) दिखना चाहिए.
सबसे ऊपर दाईं ओर मौजूद, Token Streaming को टॉगल करके चालू करें.
अब ज़ू एजेंट से इंटरैक्ट किया जा सकता है.
नई बातचीत शुरू करने के लिए, hello टाइप करें और Enter दबाएं.
नतीजा देखें. एजेंट को तुरंत जवाब देना चाहिए. इसमें उसे अभिवादन करना चाहिए:
"Hello! I'm your Zoo Tour Guide. I can help you learn about the amazing animals we have here. What would you like to know or explore today?"
एजेंट से इस तरह के सवाल पूछें:
Where can I find the polar bears in the zoo and what is their diet?
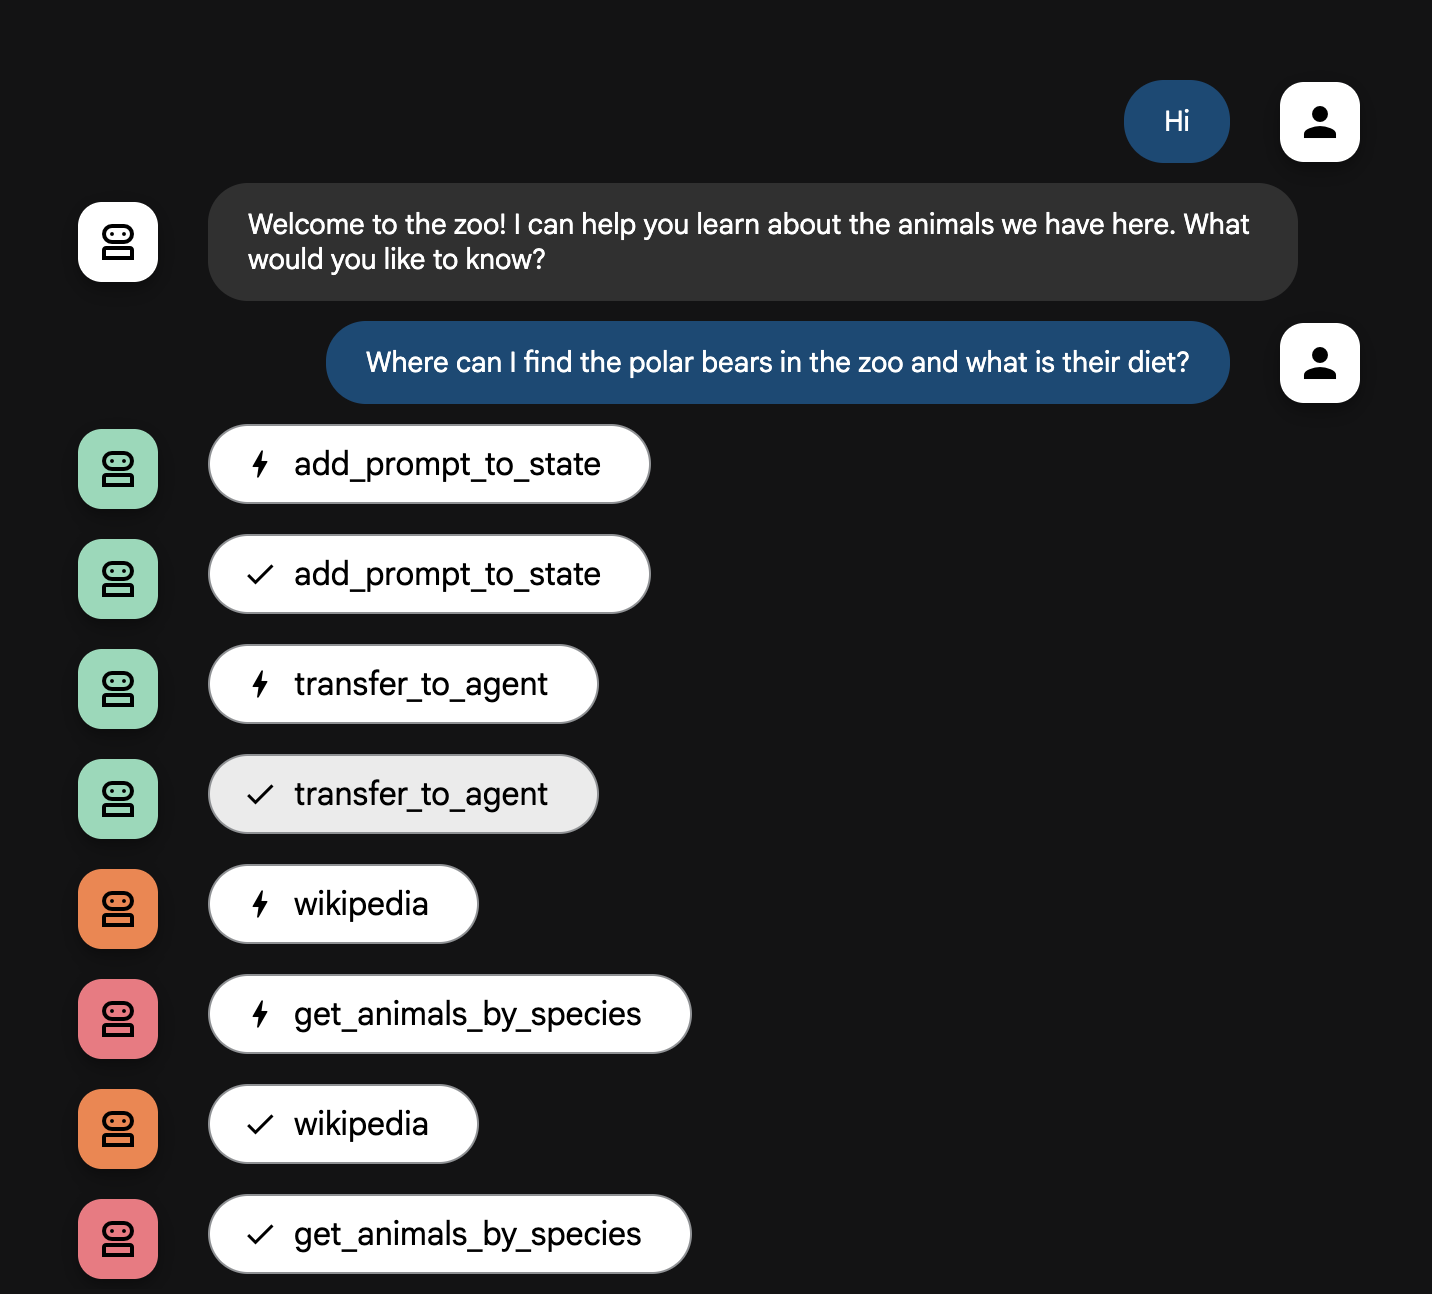
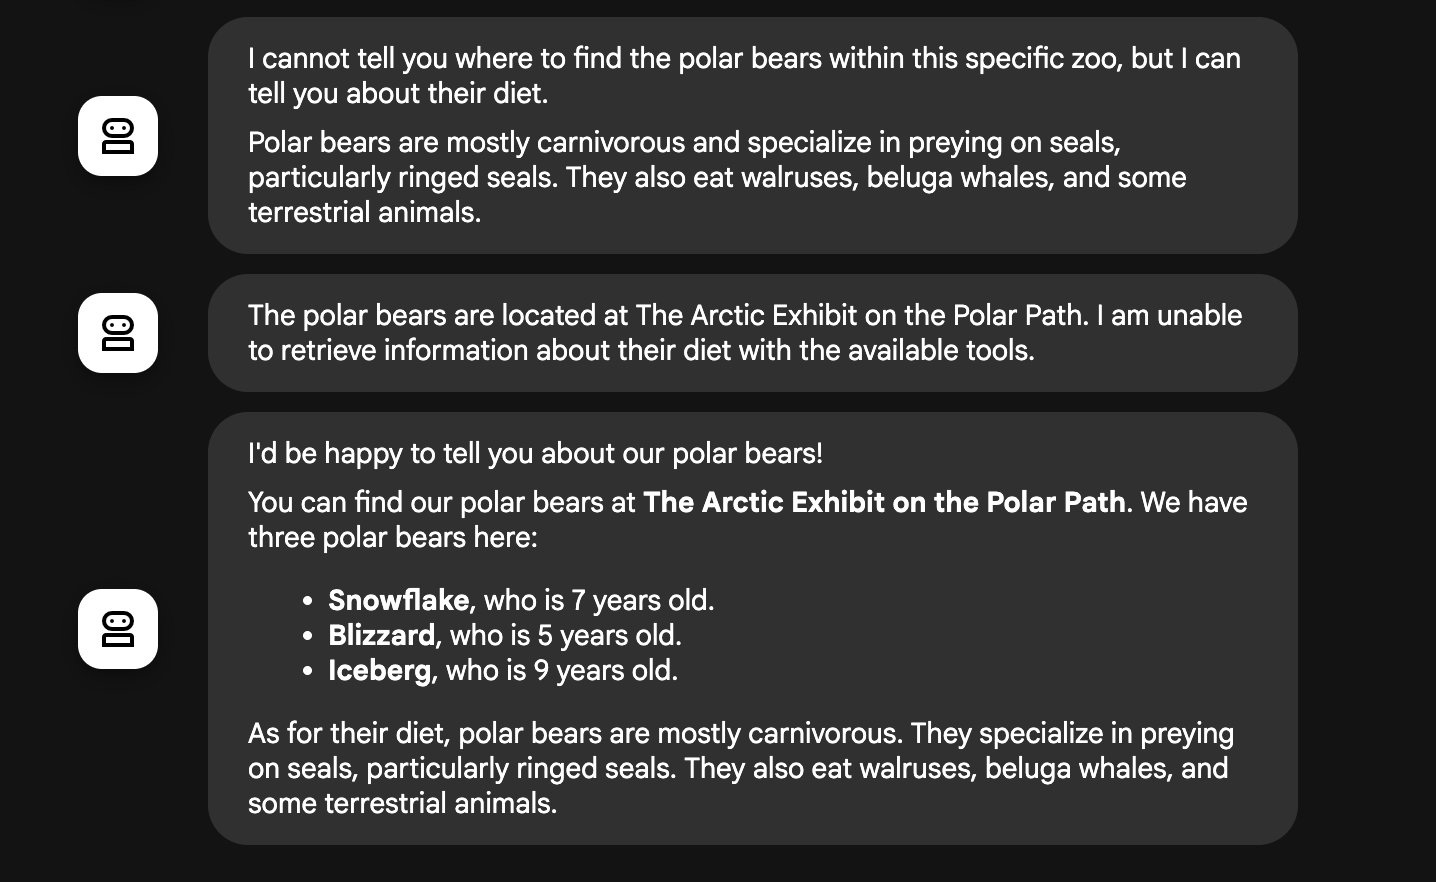
एजेंट फ़्लो के बारे में जानकारी
आपका सिस्टम, एक इंटेलिजेंट मल्टी-एजेंट टीम के तौर पर काम करता है. इस प्रोसेस को एक तय क्रम में मैनेज किया जाता है, ताकि उपयोगकर्ता के सवाल से लेकर जवाब मिलने तक की प्रोसेस आसान और असरदार हो.
1. चिड़ियाघर में स्वागत करने वाला (वेलकम डेस्क)
पूरी प्रोसेस, ग्रीटर एजेंट से शुरू होती है.
इसका काम: बातचीत शुरू करना. इसमें उपयोगकर्ता का अभिवादन करने और यह पूछने का निर्देश दिया गया है कि उसे किस जानवर के बारे में जानना है.
इसका टूल: जब उपयोगकर्ता जवाब देता है, तो Greeter अपने add_prompt_to_state टूल का इस्तेमाल करके, उसके शब्दों को कैप्चर करता है.जैसे, "मुझे शेरों के बारे में बताओ". इसके बाद, वह इन शब्दों को सिस्टम की मेमोरी में सेव करता है.
हैंडऑफ़: प्रॉम्प्ट सेव करने के बाद, यह तुरंत कंट्रोल को अपने सब-एजेंट, tour_guide_workflow को पास कर देता है.
2. रिसर्च करने वाला व्यक्ति (सुपर-रिसर्चर)
यह मुख्य वर्कफ़्लो का पहला चरण है और इसे ऑपरेशन का "दिमाग" कहा जाता है. अब आपके पास बड़ी टीम के बजाय, एक ऐसा एजेंट है जिसके पास सभी ज़रूरी कौशल हैं और जो उपलब्ध सभी जानकारी को ऐक्सेस कर सकता है.
इसका काम: उपयोगकर्ता के सवाल का विश्लेषण करना और एक बेहतर प्लान बनाना. यह भाषा मॉडल के टूल इस्तेमाल करने की क्षमता का इस्तेमाल करके यह तय करता है कि इसे इनकी ज़रूरत है या नहीं:
- चिड़ियाघर के रिकॉर्ड से इंटरनल डेटा (एमसीपी सर्वर के ज़रिए).
- वेब से सामान्य जानकारी (Wikipedia API के ज़रिए).
- इसके अलावा, मुश्किल सवालों के लिए दोनों का इस्तेमाल किया जा सकता है.
इसकी कार्रवाई: यह सभी ज़रूरी रॉ डेटा इकट्ठा करने के लिए, ज़रूरी टूल इस्तेमाल करता है. उदाहरण के लिए, अगर पूछा जाए कि "हमारे शेर कितने साल के हैं और वे जंगल में क्या खाते हैं?", तो यह उम्र की जानकारी के लिए MCP सर्वर और खाने की जानकारी के लिए Wikipedia टूल का इस्तेमाल करेगा.
3. जवाब को फ़ॉर्मैट करने वाला (प्रज़ेंटर)
जब Comprehensive Researcher सभी तथ्यों को इकट्ठा कर लेता है, तब यह एजेंट काम करता है.
इसका काम: यह ज़ू टूर गाइड की तरह काम करता है और दोस्ताना लहजे में जवाब देता है. यह रॉ डेटा (जो एक या दोनों सोर्स से मिल सकता है) लेता है और उसे बेहतर बनाता है.
इसकी कार्रवाई: यह सभी जानकारी को एक साथ जोड़कर, एक ही जवाब में शामिल करता है. यह जवाब, सही क्रम में और दिलचस्प होता है. इसके निर्देशों के मुताबिक, यह सबसे पहले चिड़ियाघर के बारे में खास जानकारी देता है. इसके बाद, सामान्य तथ्यों के बारे में दिलचस्प जानकारी जोड़ता है.
आखिरी नतीजा: इस एजेंट ने जो टेक्स्ट जनरेट किया है वह पूरा और ज़्यादा जानकारी वाला जवाब है. यह जवाब, उपयोगकर्ता को चैट विंडो में दिखता है.
अगर आपको एजेंट बनाने के बारे में ज़्यादा जानना है, तो यहां दिए गए संसाधन देखें:
8. स्टोरेज में जगह बनाएं
gcloud run services delete zoo-tour-guide --region=us-west1 --quiet
gcloud artifacts repositories delete cloud-run-source-deploy --location=us-west1 --quiet
9. बधाई हो
कोडलैब पूरा करने के लिए बधाई.
हमने क्या-क्या बताया
- एडीके के कमांड-लाइन इंटरफ़ेस की मदद से डिप्लॉयमेंट के लिए, Python प्रोजेक्ट को स्ट्रक्चर करने का तरीका.
- SequentialAgent और ParallelAgent का इस्तेमाल करके, मल्टी-एजेंट वर्कफ़्लो लागू करने का तरीका.
- एमसीपी टूलसेट का इस्तेमाल करके, किसी रिमोट एमसीपी सर्वर से कनेक्ट करने का तरीका, ताकि उसके टूल इस्तेमाल किए जा सकें.
- Wikipedia API जैसे बाहरी टूल को इंटिग्रेट करके, इंटरनल डेटा को बेहतर बनाने का तरीका.
- adk deploy कमांड का इस्तेमाल करके, एजेंट को Cloud Run पर सर्वरलेस कंटेनर के तौर पर डिप्लॉय करने का तरीका.