

১. এক নজরে
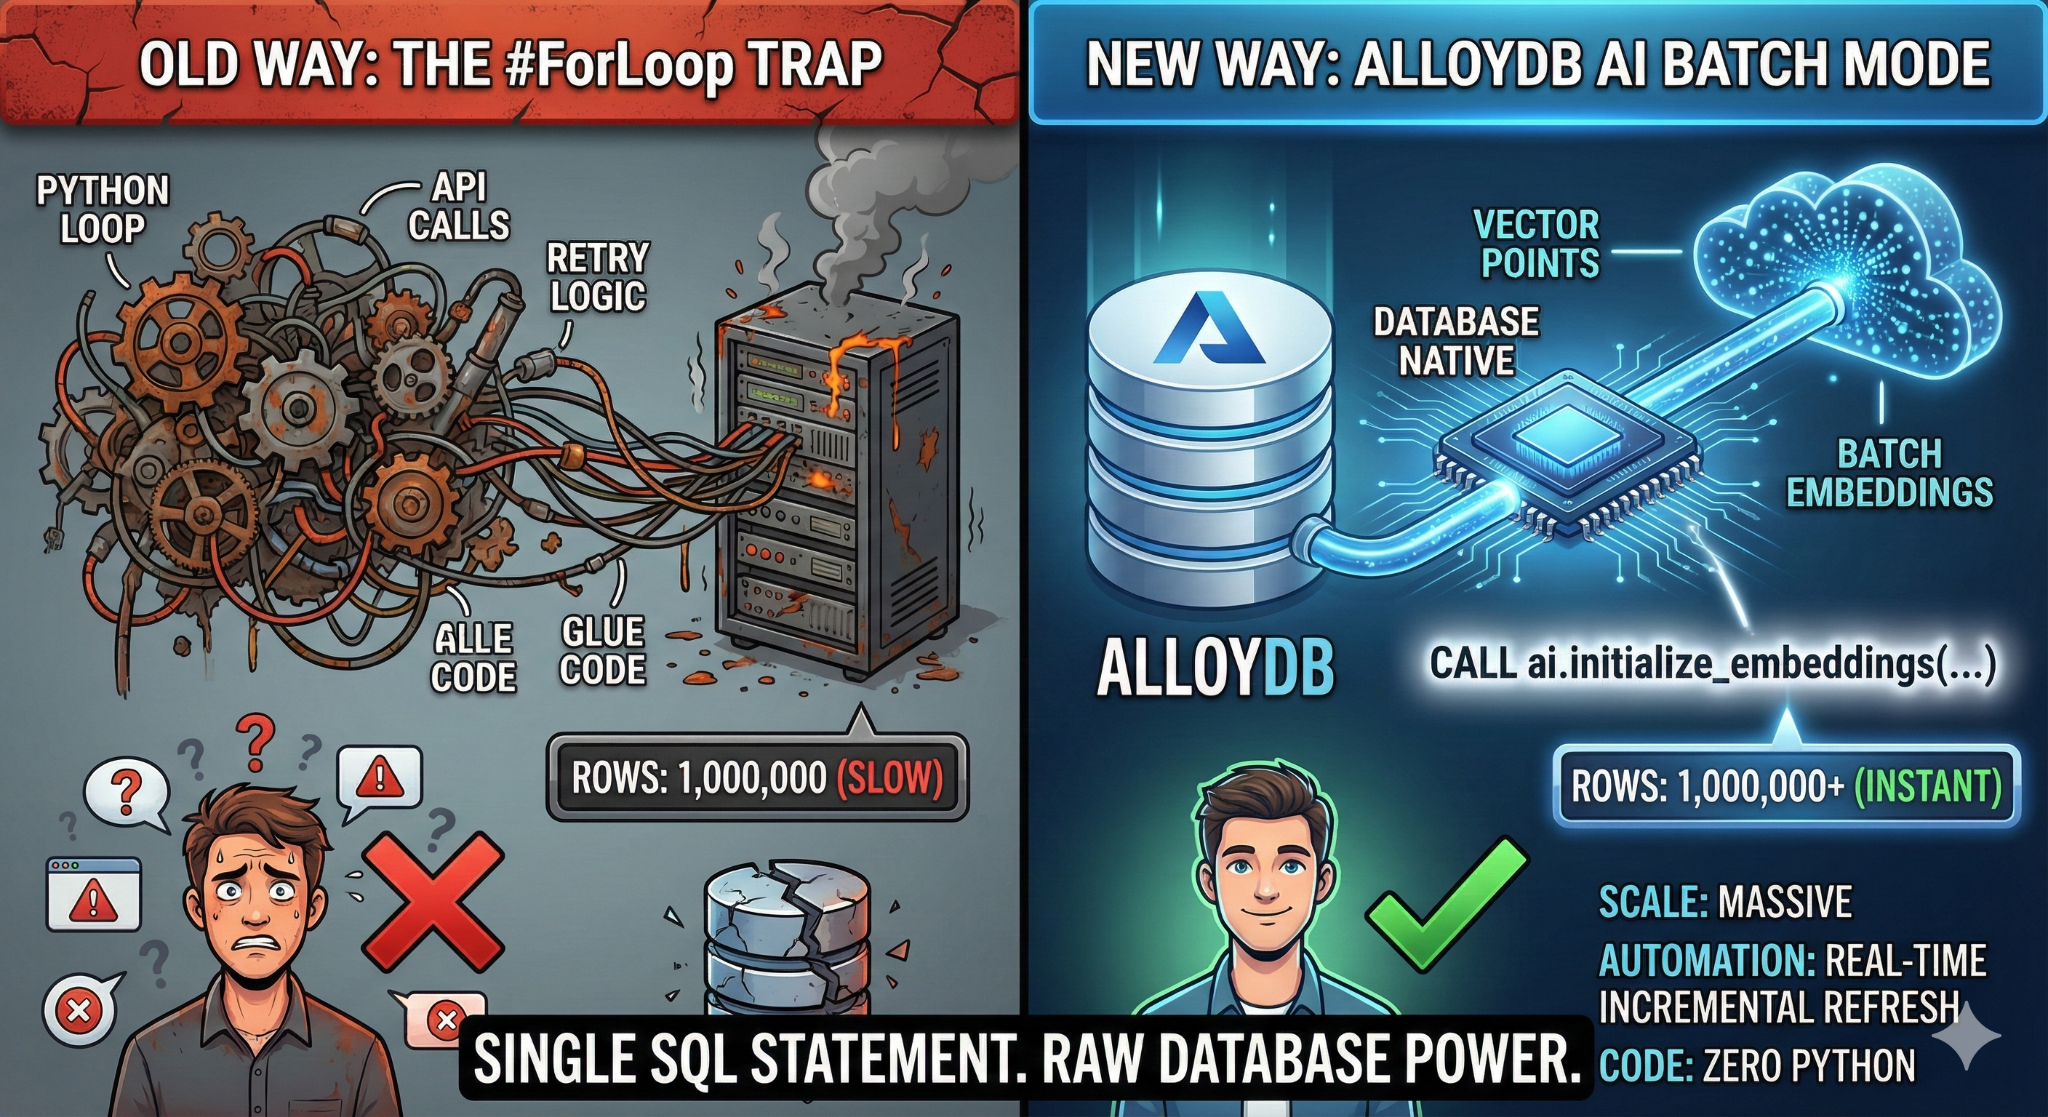
এই কোডল্যাবে, আপনি একটি স্কেলেবল নলেজ বেস সার্চ অ্যাপ্লিকেশন তৈরি করবেন। ভেক্টর এম্বেডিং জেনারেট করার জন্য Python স্ক্রিপ্ট এবং লুপ সহ একটি জটিল ETL পাইপলাইন ম্যানেজ করার পরিবর্তে, আপনি একটি SQL কমান্ড ব্যবহার করে ডেটাবেসের মধ্যে নেটিভভাবে এম্বেডিং জেনারেশন ম্যানেজ করতে AlloyDB AI ব্যবহার করবেন।
আপনি কী তৈরি করবেন
একটি উচ্চ-পারফর্ম্যান্স "সার্চযোগ্য" নলেজ বেস ডেটাবেস অ্যাপ্লিকেশন।
আপনি কী শিখবেন
আপনি শিখবেন কীভাবে:
- AlloyDB ক্লাস্টার প্রোভিশন করা এবং AI এক্সটেনশন চালু করা।
- SQL ব্যবহার করে সিন্থেটিক ডেটা (৫০,০০০+ সারি) জেনারেট করো।
- ব্যাচ প্রসেসিং ব্যবহার করে সম্পূর্ণ ডেটাসেটের জন্য ভেক্টর এম্বেডিং ব্যাকফিল করুন।
- নতুন ডেটা অটো-এম্বেড করতে রিয়েল-টাইম ইনক্রিমেন্টাল ট্রিগার সেট-আপ করুন।
- "Flexing Context"-এর জন্য হাইব্রিড সার্চ (ভেক্টর + SQL ফিল্টার) পারফর্ম করুন।
প্রয়োজনীয়তা
২. শুরু করার আগে
প্রোজেক্ট তৈরি করুন
- Google Cloud Console-এ, প্রোজেক্ট সিলেক্টর পৃষ্ঠায়, কোনও Google Cloud প্রোজেক্ট বেছে নিন বা তৈরি করুন।
- আপনার ক্লাউড প্রোজেক্টের জন্য বিলিং চালু করা আছে কিনা তা ভাল করে দেখে নিন। কীভাবে প্রোজেক্টে বিলিং চালু আছে কিনা তা চেক করবেনতা জানুন।
- আপনি Cloud Shell ব্যবহার করবেন, এটি Google Cloud-এ চলা একটি কমান্ড-লাইন এনভায়রনমেন্ট। Google Cloud কনসোলের উপরে Cloud Shell চালু করুন বিকল্পে ক্লিক করুন।
- Cloud Shell-এ কানেক্ট করার পরে, আপনি যাচাইকরণ করেছেন কিনা এবং নিম্নলিখিত কমান্ড ব্যবহার করে প্রোজেক্টটি আপনার প্রোজেক্ট আইডিতে সেট করা আছে কিনা তা চেক করুন:
gcloud auth list
- gcloud কমান্ড আপনার প্রোজেক্ট সম্পর্কে জানে কিনা তা কনফার্ম করতে Cloud Shell-এ নিম্নলিখিত কমান্ড রান করুন।
gcloud config list project
- আপনার প্রোজেক্ট সেট করা না থাকলে, এটি সেট করতে নিম্নলিখিত কমান্ড ব্যবহার করুন:
gcloud config set project <YOUR_PROJECT_ID>
- প্রয়োজনীয় API চালু করুন: লিঙ্ক অনুসরণ করে API চালু করুন।
বিকল্প হিসেবে, আপনি এর জন্য gcloud কমান্ড ব্যবহার করতে পারেন। gcloud কমান্ড ও ব্যবহার সম্পর্কে জানতে ডকুমেন্টেশন দেখুন।
gcloud services enable \
  alloydb.googleapis.com \
  compute.googleapis.com \
  cloudresourcemanager.googleapis.com \
  servicenetworking.googleapis.com \
  aiplatform.googleapis.com
গটচা ও সমস্যার সমাধানকরণ
"ঘোস্ট প্রোজেক্ট" সিন্ড্রোম | আপনি |
বিলিং ব্যারিকেড | আপনি প্রোজেক্ট চালু করেছেন, কিন্তু বিলিং অ্যাকাউন্ট ভুলে গেছেন। AlloyDB হল একটি হাই-পারফর্ম্যান্স ইঞ্জিন; "গ্যাস ট্যাঙ্ক" (বিলিং) খালি থাকলে এটি চালু হবে না। |
API প্রোপাগেশন ল্যাগ | আপনি "API চালু করুন" বিকল্পে ক্লিক করেছেন, কিন্তু কমান্ড লাইনে এখনও |
কোটা কোয়াগস | আপনি একদম নতুন ট্রায়াল অ্যাকাউন্ট ব্যবহার করলে, AlloyDB ইনস্ট্যান্সের জন্য আঞ্চলিক কোটা শেষ হয়ে যেতে পারে। |
"লুকানো" পরিষেবা এজেন্ট | কখনও কখনও AlloyDB সার্ভিস এজেন্টকে অটোমেটিক |
৩. ডেটাবেস সেট-আপ
এই ল্যাবে আমরা টেস্ট ডেটার জন্য ডেটাবেস হিসেবে AlloyDB ব্যবহার করব। এটি ডেটাবেস ও লগের মতো সব রিসোর্স ধরে রাখতে ক্লাস্টার ব্যবহার করে। প্রতিটি ক্লাস্টারে একটি প্রাইমারি ইনস্ট্যান্স থাকে যা ডেটার অ্যাক্সেস পয়েন্ট প্রদান করে। টেবিলে আসল ডেটা থাকবে।
আসুন, একটি AlloyDB ক্লাস্টার, ইনস্ট্যান্স ও টেবিল তৈরি করি যেখানে টেস্ট ডেটাসেট লোড করা হবে।
- বোতামে ক্লিক করুন অথবা আপনার ব্রাউজারে নিচের লিঙ্ক কপি করুন যেখানে আপনি Google Cloud Console ব্যবহারকারী হিসেবে লগ-ইন করেছেন।
- এই ধাপ সম্পূর্ণ হয়ে গেলে, আপনার স্থানীয় ক্লাউড শেল এডিটরে রেপো ক্লোন করা হবে এবং আপনি প্রোজেক্ট ফোল্ডার থেকে নিচের কমান্ড রান করতে পারবেন (আপনি প্রোজেক্ট ডিরেক্টরিতে আছেন কিনা তা ভাল করে দেখে নিন):
sh run.sh
- এখন UI ব্যবহার করুন (টার্মিনালে লিঙ্কে ক্লিক করা বা টার্মিনালে "ওয়েবে প্রিভিউ" লিঙ্কে ক্লিক করা।
- শুরু করতে প্রোজেক্ট আইডি, ক্লাস্টার ও ইনস্ট্যান্সের নাম লিখুন।
- লগ স্ক্রল করার সময় আপনি কফি খেতে পারেন এবং এটি কীভাবে ব্যাকগ্রাউন্ডে কাজ করছে তা এখানে পড়তে পারেন। এতে প্রায় ১০-১৫ মিনিট সময় লাগতে পারে।
গটচা ও সমস্যার সমাধানকরণ
"ধৈর্য্য" সংক্রান্ত সমস্যা | ডেটাবেস ক্লাস্টার হল ভারী পরিকাঠামো। "আটকে গেছে" বলে মনে হওয়ার কারণে আপনি যদি পৃষ্ঠা রিফ্রেশ করেন বা Cloud Shell সেশন বন্ধ করে দেন, তাহলে আপনি এমন একটি "ঘোস্ট" ইনস্ট্যান্স পেতে পারেন যা আংশিকভাবে প্রোভিশন করা হয়েছে এবং ম্যানুয়ালি হস্তক্ষেপ না করে মুছে ফেলা অসম্ভব। |
অঞ্চল মিলছে না | আপনি |
জম্বি ক্লাস্টার | আপনি আগে কোনও ক্লাস্টারের জন্য একই নাম ব্যবহার করে থাকলে এবং সেটি মুছে না দিলে, স্ক্রিপ্ট দেখাতে পারে যে ক্লাস্টারের নাম আগে থেকেই আছে। কোনও প্রোজেক্টের মধ্যে ক্লাস্টারের নাম অনন্য হতে হবে। |
Cloud Shell টাইমআউট | আপনার কফি ব্রেক ৩০ মিনিটের হলে, Cloud Shell স্লিপ মোডে চলে যেতে পারে এবং |
৪. স্কিমা প্রভিশনিং
এই ধাপে, আমরা নিম্নলিখিত বিষয়গুলি কভার করব:
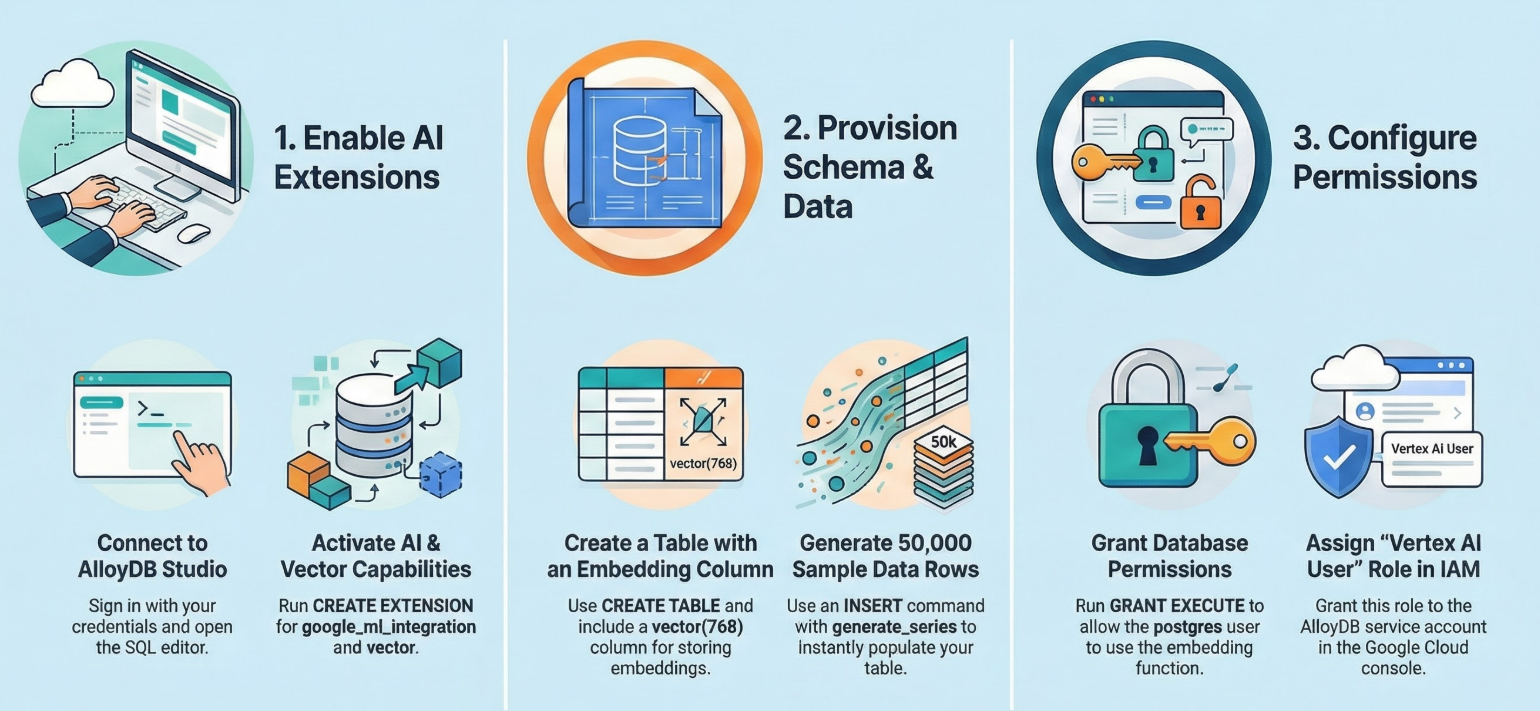
আপনার AlloyDB ক্লাস্টার এবং ইনস্ট্যান্স চালু হয়ে গেলে, AI এক্সটেনশন চালু করতে এবং স্কিমা প্রোভিশন করতে AlloyDB Studio SQL এডিটরে যান।
আপনার ইনস্ট্যান্স তৈরি হওয়া সম্পূর্ণ হওয়ার জন্য আপনাকে অপেক্ষা করতে হতে পারে। এটি হয়ে গেলে, ক্লাস্টার তৈরি করার সময় আপনি যে ক্রেডেনশিয়াল তৈরি করেছিলেন তা ব্যবহার করে AlloyDB-তে সাইন-ইন করুন। PostgreSQL-এ যাচাইকরণের জন্য নিম্নলিখিত ডেটা ব্যবহার করুন:
- ইউজারনেম : "
postgres" - ডেটাবেস : "
postgres" - পাসওয়ার্ড : "
alloydb" (অথবা তৈরি করার সময় আপনি যা সেট করেছেন)
AlloyDB Studio-তে আপনি যাচাইকরণ সম্পূর্ণ করলে, SQL কমান্ড এডিটরে লেখা হয়। শেষ উইন্ডোর ডানদিকে থাকা প্লাস চিহ্ন ব্যবহার করে আপনি একাধিক Editor উইন্ডো যোগ করতে পারবেন।
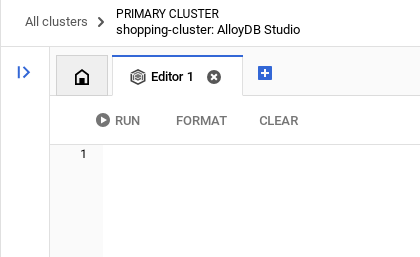
আপনি এডিটর উইন্ডোতে AlloyDB-এর জন্য কমান্ড লিখবেন, প্রয়োজন অনুযায়ী রান, ফর্ম্যাট ও মুছে ফেলার বিকল্প ব্যবহার করবেন।
এক্সটেনশন চালু করুন
এই অ্যাপ তৈরি করার জন্য, আমরা pgvector এবং google_ml_integration এক্সটেনশন ব্যবহার করব। pgvector এক্সটেনশন আপনাকে ভেক্টর এম্বেডিং স্টোর ও সার্চ করতে দেয়। google_ml_integration এক্সটেনশন এমন ফাংশন প্রদান করে যা আপনি SQL-এ প্রেডিকশন পেতে Vertex AI প্রেডিকশন এন্ডপয়েন্ট অ্যাক্সেস করতে ব্যবহার করেন। নিম্নলিখিত DDL রান করে এইসব এক্সটেনশন চালু করুন:
CREATE EXTENSION IF NOT EXISTS google_ml_integration CASCADE;
CREATE EXTENSION IF NOT EXISTS vector;
একটি টেবিল তৈরি করুন
স্কেল দেখানোর জন্য আমাদের একটি ডেটাসেট প্রয়োজন। CSV ইমপোর্ট করার পরিবর্তে, আমরা SQL ব্যবহার করে তাৎক্ষণিকভাবে সিন্থেটিক "সহায়তা নিবন্ধ"-এর ৫০,০০০টি সারি তৈরি করব।
AlloyDB Studio-তে নিচে দেওয়া DDL স্টেটমেন্ট ব্যবহার করে আপনি একটি টেবিল তৈরি করতে পারবেন:
-- 1. Create the table
CREATE TABLE help_articles (
    id SERIAL PRIMARY KEY,
    title TEXT,
    category TEXT,
    product_version TEXT,
    content_body TEXT,
    embedding vector(768) -- Dimension for text-embedding-005
);

-- 2. Generate 50,000 rows of synthetic data
INSERT INTO help_articles (title, category, product_version, content_body)
SELECT
    'Help Article ' || i,
    CASE
        WHEN i % 3 = 0 THEN 'Billing'
        WHEN i % 3 = 1 THEN 'Technical'
        ELSE 'General'
    END,
    CASE
        WHEN i % 2 = 0 THEN '2.0'
        ELSE '1.0'
    END,
    'This article covers common issues regarding ' ||
    CASE
        WHEN i % 3 = 0 THEN 'payment failures, invoice disputes, and credit card updates.'
        WHEN i % 3 = 1 THEN 'connection timeouts, latency issues, and API errors.'
        ELSE 'account profile settings, password resets, and user roles.'
    END
FROM generate_series(1, 50000) AS i;
item_vector কলামে টেক্সটের ভেক্টর ভ্যালু স্টোর করা যাবে।
ডেটা যাচাই করুন:
SELECT count(*) FROM help_articles;
-- Output: 50000
ডেটাবেস ফ্ল্যাগ চালু করুন
ইনস্ট্যান্স কনফিগারেশন কনসোলে যান, "প্রাইমারি এডিট করুন" বিকল্পে ক্লিক করুন, উন্নত কনফিগারেশনে যান এবং "ডেটাবেস ফ্ল্যাগ যোগ করুন" বিকল্পে ক্লিক করুন।
যদি না হয়, তাহলে ফ্ল্যাগ ড্রপ-ডাউনে এটি লিখুন এবং "চালু" হিসেবে সেট করে ইনস্ট্যান্স আপডেট করুন।
না থাকলে, ফ্ল্যাগ ড্রপ-ডাউনে এটি লিখুন এবং "চালু" হিসেবে সেট করে ইনস্ট্যান্স আপডেট করুন।
ডেটাবেস ফ্ল্যাগ কনফিগার করার ধাপ:
- Google Cloud কনসোলে, ক্লাস্টার পৃষ্ঠায় যান।
- রিসোর্সের নাম কলামে কোনও ক্লাস্টারে ক্লিক করুন।
- ওভারভিউ পৃষ্ঠায়, আপনার ক্লাস্টারে ইনস্ট্যান্স বিকল্পে যান, একটি ইনস্ট্যান্স বেছে নিন এবং তারপরে এডিট করুন বিকল্পে ক্লিক করুন।
- আপনার ইনস্ট্যান্স থেকে ডেটাবেস ফ্ল্যাগ যোগ, পরিবর্তন বা মুছে দিন:
ফ্ল্যাগ যোগ করা
- আপনার ইনস্ট্যান্সে ডেটাবেস ফ্ল্যাগ যোগ করতে, 'ফ্ল্যাগ যোগ করুন' বিকল্পে ক্লিক করুন।
- নতুন ডেটাবেস ফ্ল্যাগ তালিকা থেকে একটি ফ্ল্যাগ বেছে নিন।
- ফ্ল্যাগের জন্য একটি ভ্যালু দিন।
- 'হয়ে গেছে' বিকল্পে ক্লিক করুন।
- ইনস্ট্যান্স আপডেট করুন বিকল্পে ক্লিক করুন।
- যাচাই করুন যে google_ml_integration এক্সটেনশনটি ভার্সন 1.5.2 বা তার পরের ভার্সন:
নিম্নলিখিত কমান্ডের সাহায্যে আপনার এক্সটেনশন ভার্সন চেক করতে:
SELECT extversion FROM pg_extension WHERE extname = 'google_ml_integration';
আপনাকে এক্সটেনশন আরও উন্নত ভার্সনে আপডেট করতে হলে, এই কমান্ড ব্যবহার করুন:
ALTER EXTENSION google_ml_integration UPDATE;
অনুমতি দিন
- কোনও ব্যবহারকারীকে অটোমেটিক এম্বেডিং জেনারেশন ম্যানেজ করার অনুমতি দিতে, google_ml.embed_gen_progress এবং google_ml.embed_gen_settings টেবিলে INSERT, UPDATE এবং DELETE করার অনুমতি দিন:
GRANT INSERT, UPDATE, DELETE ON google_ml.embed_gen_progress TO postgres;
‘postgres' হল সেই USER_NAME যার জন্য অনুমতি দেওয়া হয়েছে।
- "এম্বেডিং" ফাংশনে এক্সিকিউট করার অনুমতি দিতে নিচের স্টেটমেন্ট রান করুন:
GRANT EXECUTE ON FUNCTION embedding TO postgres;
AlloyDB পরিষেবা অ্যাকাউন্টে Vertex AI ব্যবহারকারীর ভূমিকা মঞ্জুর করা
Google Cloud IAM কনসোল থেকে, AlloyDB পরিষেবা অ্যাকাউন্টকে (যা দেখতে এইরকম: service-<<PROJECT_NUMBER>>@gcp-sa-alloydb.iam.gserviceaccount.com) "Vertex AI ব্যবহারকারী" ভূমিকায় অ্যাক্সেস দিন। PROJECT_NUMBER-এ আপনার প্রোজেক্ট নম্বর থাকবে।
বিকল্প হিসেবে, আপনি Cloud Shell Terminal থেকে নিচের কমান্ড রান করতে পারেন:
PROJECT_ID=$(gcloud config get-value project)


gcloud projects add-iam-policy-binding $PROJECT_ID \
  --member="serviceAccount:service-$(gcloud projects describe $PROJECT_ID --format="value(projectNumber)")@gcp-sa-alloydb.iam.gserviceaccount.com" \
--role="roles/aiplatform.user"
গটচা ও সমস্যার সমাধানকরণ
"পাসওয়ার্ড ভুলে যাওয়া" লুপ | আপনি যদি "এক ক্লিক" সেট-আপ ব্যবহার করে থাকেন এবং আপনার পাসওয়ার্ড মনে না থাকে, তাহলে কনসোলের ইনস্ট্যান্সের প্রাথমিক তথ্য পৃষ্ঠায় যান এবং |
"এক্সটেনশন খুঁজে পাওয়া যায়নি" সংক্রান্ত সমস্যা |
|
৫. "ওয়ান-শট" ভেক্টর জেনারেশন
এটি ল্যাবের মূল অংশ। এই ৫০,০০০ সারি প্রসেস করার জন্য Python লুপ লেখার পরিবর্তে, আমরা ai.initialize_embeddings ফাংশন ব্যবহার করব।
এই একটি কমান্ড দুটি কাজ করে:
- আগে থেকে থাকা সব সারি ব্যাকফিল করে।
- ভবিষ্যতের সারি অটোমেটিক এম্বেড করার জন্য একটি ট্রিগার তৈরি করে।
AlloyDB কোয়েরি এডিটর থেকে নিচের SQL স্টেটমেন্ট রান করুন
CALL ai.initialize_embeddings(
  model_id => 'text-embedding-005',
  table_name => 'help_articles',
  content_column => 'content_body',
  embedding_column => 'embedding',
  incremental_refresh_mode => 'transactional'
);
এম্বেডিং যাচাই করুন
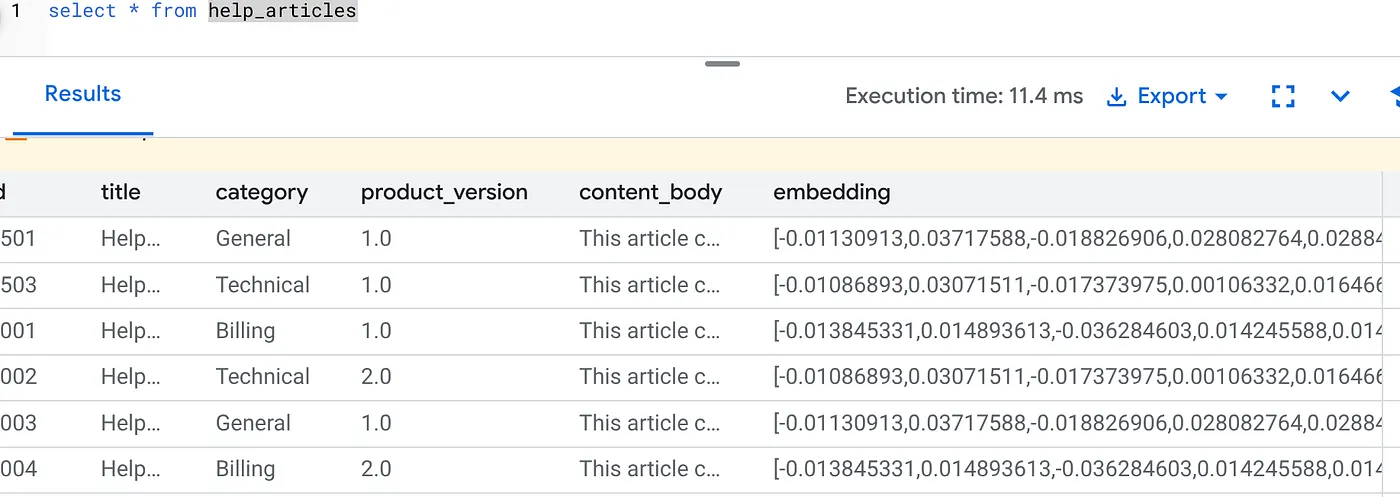
embedding কলাম এখন পূরণ করা হয়েছে কিনা তা চেক করুন:
SELECT id, left(content_body, 30), substring(embedding::text, 1, 30) as vector_partial
FROM help_articles;
আপনি নিচে দেখানো ফলাফলের মতো কিছু দেখতে পাবেন:
ঠিক কী হল এইমাত্র?
- স্কেলে ব্যাকফিল: এটি অটোমেটিক আপনার আগে থেকে থাকা ৫০,০০০ সারি সুইপ করে এবং Vertex AI-এর মাধ্যমে এম্বেডিং জেনারেট করে।
- অটোমেশন: incremental_refresh_mode => 'transactional' সেট করার মাধ্যমে, AlloyDB অটোমেটিক ইন্টার্নাল ট্রিগার সেট-আপ করে। help_articles-এ যোগ করা যেকোনও নতুন সারির এম্বেডিং সাথে সাথে তৈরি করা হবে।
- আপনি চাইলে incremental_refresh_mode => ‘None' সেট করতে পারেন যাতে আপনি বাল্ক আপডেট করার জন্য শুধু স্টেটমেন্ট পান এবং সব সারির এম্বেডিং আপডেট করার জন্য ai.refresh_embeddings() ম্যানুয়ালি কল করতে পারেন।
আপনি এইমাত্র ৬ লাইনের SQL দিয়ে Kafka কিউ, Python ওয়ার্কার ও মাইগ্রেশন স্ক্রিপ্ট রিপ্লেস করেছেন। সব অ্যাট্রিবিউটের জন্য বিস্তারিত অফিসিয়াল ডকুমেন্টেশন এখানে দেওয়া হল।
রিয়েল-টাইম ট্রিগার টেস্ট
"Zero Loop" অটোমেশন নতুন ডেটার জন্য কাজ করে কিনা তা যাচাই করা যাক।
- নতুন সারি যোগ করুন:
INSERT INTO help_articles (title, category, product_version, content_body)
VALUES ('New Scaling Guide', 'Technical', '2.0', 'How to scale AlloyDB to millions of transactions.');
- অবিলম্বে চেক করুন:
SELECT embedding FROM help_articles WHERE title = 'New Scaling Guide';
ফলাফল:
কোনও এক্সটার্নাল স্ক্রিপ্ট রান না করেই আপনি ভেক্টর তৈরি হতে দেখতে পাবেন।
টিউনিং ব্যাচ সাইজ
বর্তমানে AlloyDB-তে ব্যাচের সাইজ ডিফল্ট হিসেবে ৫০ সেট করা থাকে। ডিফল্ট সেটিংস খুব ভাল কাজ করলেও, AlloyDB ব্যবহারকারীদের আপনার অনন্য মডেল এবং ডেটাসেটের জন্য নিখুঁত কনফিগারেশন টিউন করার কন্ট্রোল দেয়।
CALL ai.initialize_embeddings(
  model_id => 'text-embedding-005',
  table_name => 'help_articles',
  content_column => 'content_body',
  embedding_column => 'embedding',
  incremental_refresh_mode => 'transactional',
  batch_size => 20
);
তবে, ব্যবহারকারীদের কোটার সীমা সম্পর্কে সচেতন হতে হবে যা পারফর্ম্যান্স সীমিত করতে পারে। সাজেস্ট করা AlloyDB কোটা পর্যালোচনা করতে, ডকুমেন্টেশন-এর "শুরু করার আগে" বিভাগটি দেখুন।
গটচা ও সমস্যার সমাধানকরণ
IAM প্রোপাগেশন গ্যাপ | আপনি |
ভেক্টর ডাইমেনশন মিলছে না |
|
৬. ফ্লেক্সিং কন্টেক্সট সার্চ
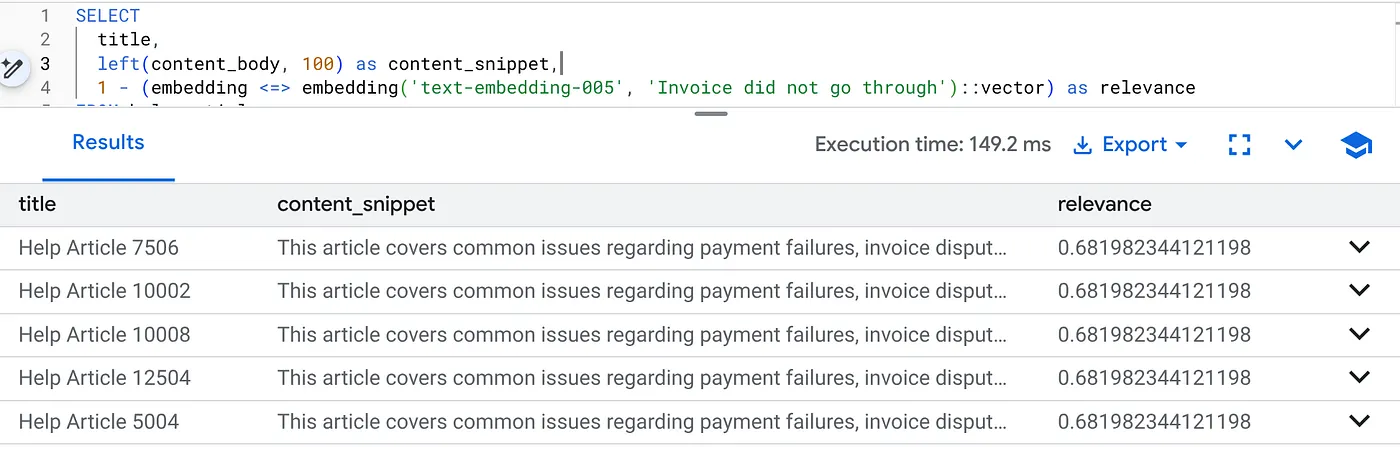
এখন আমরা হাইব্রিড সার্চ করি। আমরা ব্যবসায়িক লজিকের (SQL ফিল্টার) সাথে শব্দার্থগত বোঝাপড়া (ভেক্টর) একত্রিত করি।
বিশেষ করে প্রোডাক্ট ভার্সন ২.০-এর জন্য বিলিং সংক্রান্ত সমস্যা খুঁজতে এই কোয়েরি রান করুন:
SELECT
  title,
  left(content_body, 100) as content_snippet,
  1 - (embedding <=> embedding('text-embedding-005', 'Invoice did not go through')::vector) as relevance
FROM help_articles
WHERE category = 'Billing'  -- Hard SQL Filter
  AND product_version = '2.0' -- Hard SQL Filter
ORDER BY relevance DESC
LIMIT 5;
এটি হল Flexing Context। সার্চটি ব্যবহারকারীর উদ্দেশ্য ("বিলিং সংক্রান্ত সমস্যা") বোঝার জন্য "ফ্লেক্স" করে এবং একই সাথে কঠোর ব্যবসায়িক সীমাবদ্ধতা (ভার্সন ২.০) মেনে চলে।
স্টার্ট-আপ ও মাইগ্রেশনের জন্য এটি কেন সেরা
- ইনফ্রাস্ট্রাকচার ডেট নেই: আপনি আলাদা ভেক্টর ডিবি (Pinecone/Milvus) তৈরি করেননি। আপনি আলাদা ETL জব লেখেননি। সবকিছু Postgres-এ আছে।
- রিয়েল-টাইম আপডেট: 'ট্রানজ্যাকশনাল' মোড ব্যবহার করে, আপনার সার্চ ইন্ডেক্স কখনও পুরনো হয় না। ডেটা কমিট করার সাথে সাথেই তা ভেক্টর-রেডি হয়ে যায়।
- স্কেল: AlloyDB, Google-এর পরিকাঠামোর উপর তৈরি করা হয়েছে। আপনার Python স্ক্রিপ্ট যত দ্রুত করতে পারে তার চেয়েও দ্রুত এটি লক্ষ লক্ষ ভেক্টরের বাল্ক জেনারেশন ম্যানেজ করতে পারে।
গটচা ও সমস্যার সমাধানকরণ
প্রোডাকশন পারফর্ম্যান্স সংক্রান্ত সমস্যা | সমস্যা: ৫০,০০০ সারির জন্য দ্রুত। ১ মিলিয়ন সারির জন্য খুব ধীর যদি বিভাগ ফিল্টার যথেষ্ট নির্বাচনী না হয়।সমাধান:একটি ভেক্টর ইনডেক্স যোগ করুন: প্রোডাকশন স্কেলের জন্য, আপনাকে অবশ্যই একটি ইনডেক্স তৈরি করতে হবে:CREATE INDEX ON help_articles USING hnsw (embedding vector_cosine_ops);ইনডেক্স ব্যবহার যাচাই করুন: ডেটাবেস ইনডেক্স ব্যবহার করছে এবং সিকোয়েন্সিয়াল স্ক্যান করছে না তা নিশ্চিত করতে |
"মডেল অমিল" সংক্রান্ত বিপর্যয় | সমস্যা: আপনি CALL পদ্ধতিতে text-embedding-005 ব্যবহার করে কলামটি শুরু করেছেন। আপনি যদি ভুলবশত SELECT কোয়েরি ফাংশন embedding('model-name', ...)-এ অন্য কোনও মডেল (যেমন, text-embedding-004 বা OSS মডেল) ব্যবহার করেন, তাহলে ডাইমেনশন হয়ত মিলে যাবে (৭৬৮), কিন্তু ভেক্টর স্পেস সম্পূর্ণ আলাদা হবে।কোয়েরি কোনও সমস্যা ছাড়াই রান করবে, কিন্তু ফলাফল সম্পূর্ণ অপ্রাসঙ্গিক হবে (গার্বেজ প্রাসঙ্গিকতা স্কোর)।সমস্যার সমাধানকরণ:নিশ্চিত করুন যে ai.initialize_embeddings-এ model_id আপনার SELECT কোয়েরির model_id-এর সাথে হুবহু মিলে যাচ্ছে। |
"সাইলেন্ট এম্পটি" ফলাফল (অতিরিক্ত ফিল্টার করা) | সমস্যা: হাইব্রিড সার্চ হল একটি "AND" অপারেশন। এটির জন্য সিম্যান্টিক ম্যাচ এবং SQL ম্যাচ প্রয়োজন।কোনও ব্যবহারকারী "বিলিং সংক্রান্ত সহায়তা" সার্চ করলে, কিন্তু
|
৪. অনুমতি/কোটা সংক্রান্ত সমস্যা (500 Error) | সমস্যা:
|
৫. Null এম্বেডিং | সমস্যা:মডেল সম্পূর্ণভাবে শুরু হওয়ার আগে আপনি ডেটা যোগ করলে অথবা ব্যাকগ্রাউন্ড ওয়ার্কার কাজ না করলে, কিছু সারির
|
৭. অপ্রয়োজনীয়গুলি মুছুন
এই ল্যাব সম্পূর্ণ হয়ে গেলে, alloyDB ক্লাস্টার ও ইনস্ট্যান্স মুছে দিতে ভুলবেন না।
এটি ইনস্ট্যান্স সহ ক্লাস্টার ক্লিন-আপ করবে।
৮. অভিনন্দন
আপনি একটি স্কেলেবল নলেজ বেস সার্চ অ্যাপ্লিকেশন তৈরি করেছেন। ভেক্টর এম্বেডিং তৈরি করার জন্য Python স্ক্রিপ্ট এবং লুপ সহ একটি জটিল ETL পাইপলাইন ম্যানেজ করার পরিবর্তে, আপনি একটি SQL কমান্ড ব্যবহার করে ডেটাবেসের মধ্যে নেটিভভাবে এম্বেডিং জেনারেশন ম্যানেজ করতে AlloyDB AI ব্যবহার করেছেন।
আমরা কী কী কভার করেছি
- ডেটা প্রসেসিংয়ের জন্য আমরা "Python For-Loop" বন্ধ করে দিয়েছি।
- আমরা একটি SQL কমান্ড দিয়ে ৫০,০০০ ভেক্টর জেনারেট করেছি।
- আমরা ট্রিগারের মাধ্যমে ভবিষ্যতের ভেক্টর জেনারেশন অটোমেট করেছি।
- আমরা হাইব্রিড সার্চ করেছি।
পরবর্তী ধাপ
- আপনার নিজের ডেটাসেট দিয়ে এটি চেষ্টা করে দেখুন।
- AlloyDB AI ডকুমেন্টেশন এক্সপ্লোর করুন।
- আরও ওয়ার্কশপের জন্য Code Vipassana ওয়েবসাইট দেখুন।