

1. מבוא

העדכון האחרון: 28 בפברואר 2020
בשיעור Codelab הזה נסביר איך להטמיע נתונים בפורמט CSV של נתוני בריאות ב-BigQuery בכמות גדולה. בשיעור ה-Lab הזה נשתמש בצינור נתונים באצווה של Cloud Data Fusion. נתוני בדיקה ריאליסטיים של שירותי בריאות נוצרו והועמדו לרשותכם בקטגוריה של Google Cloud Storage (gs://hcls_testing_data_fhir_10_patients/csv/).
בשיעור ה-Lab הזה תלמדו:
- איך מטמיעים נתוני CSV (טעינה מתוזמנת באצוות) מ-GCS ל-BigQuery באמצעות Cloud Data Fusion.
- איך ליצור באופן ויזואלי צינור לשילוב נתונים ב-Cloud Data Fusion כדי לטעון, לשנות ולהסתיר נתונים בתחום הבריאות בכמות גדולה.
מה צריך כדי להריץ את ה-Codelab הזה?
- אתם צריכים גישה לפרויקט GCP.
- צריכה להיות לכם הרשאת 'בעלים' בפרויקט GCP.
- נתוני בריאות בפורמט CSV, כולל הכותרת.
אם אין לכם פרויקט ב-GCP, אתם יכולים לפעול לפי השלבים האלה כדי ליצור פרויקט חדש ב-GCP.
נתוני בריאות בפורמט CSV נטענו מראש לקטגוריית GCS בכתובת gs://hcls_testing_data_fhir_10_patients/csv/. לכל קובץ CSV של משאב יש מבנה סכמה ייחודי. לדוגמה, ל-Patients.csv יש סכימה שונה מזו של Providers.csv. אפשר למצוא קובצי סכימה שנטענו מראש בכתובת gs://hcls_testing_data_fhir_10_patients/csv_schemas.
אם אתם צריכים מערך נתונים חדש, תמיד תוכלו ליצור אותו באמצעות SyntheaTM. לאחר מכן, מעלים אותו ל-GCS במקום להעתיק אותו מהמאגר בשלב 'העתקת נתוני קלט'.
2. הגדרת פרויקט GCP
מאתחלים משתני מעטפת עבור הסביבה.
כדי למצוא את PROJECT_ID, אפשר לעיין במאמר בנושא זיהוי פרויקטים.
<!-- CODELAB: Initialize shell variables ->
<!-- Your current GCP Project ID ->
export PROJECT_ID=<PROJECT_ID>
<!-- A new GCS Bucket in your current Project  - INPUT ->
export BUCKET_NAME=<BUCKET_NAME>
<!-- A new BQ Dataset ID - OUTPUT ->
export DATASET_ID=<DATASET_ID>
יוצרים קטגוריה ב-GCS לאחסון נתוני הקלט ויומני השגיאות באמצעות הכלי gsutil.
gsutil mb -l us gs://$BUCKET_NAME
קבלת גישה למערך הנתונים הסינתטי
- מכתובת האימייל שבה אתם משתמשים כדי להיכנס למסוף Cloud, שולחים אימייל אל hcls-solutions-external+subscribe@google.com ומבקשים להצטרף.
- תקבלו אימייל עם הוראות לאישור הפעולה.

- משתמשים באפשרות להשיב לאימייל כדי להצטרף לקבוצה. אל תלחצו על הלחצן.
- אחרי שתקבלו את אישור ההרשמה באימייל, תוכלו להמשיך לשלב הבא ב-codelab.
העתקת נתוני הקלט.
gsutil -m cp -r gs://hcls_testing_data_fhir_10_patients/csv gs://$BUCKET_NAME
יוצרים מערך נתונים ב-BigQuery.
bq mk --location=us --dataset $PROJECT_ID:$DATASET_ID
3. הגדרת סביבת Cloud Data Fusion
כדי להפעיל את Cloud Data Fusion API ולהעניק את ההרשאות הנדרשות:
מפעילים את ממשקי ה-API.
- עוברים אל GCP Console API Library.
- ברשימת הפרויקטים, בוחרים את הפרויקט הרצוי.
- ב-API Library, בוחרים את ה-API שרוצים להפעיל. אם אתם צריכים עזרה באיתור ה-API, אתם יכולים להשתמש בשדה החיפוש או במסננים.
- בדף ה-API, לוחצים על ENABLE (הפעלה).
יוצרים מכונת Cloud Data Fusion.
- ב-GCP Console, בוחרים את ProjectID.
- בתפריט הימני, בוחרים באפשרות Data Fusion ולוחצים על הלחצן CREATE AN INSTANCE (יצירת מופע) באמצע הדף (יצירה ראשונה) או בתפריט העליון (יצירה נוספת).


- מזינים את שם המכונה. בוחרים באפשרות Enterprise.

- לוחצים על הלחצן CREATE (יצירה).
הגדרת הרשאות למופע.
אחרי שיוצרים מופע, מבצעים את השלבים הבאים כדי לתת לחשבון השירות שמשויך למופע הרשאות בפרויקט:
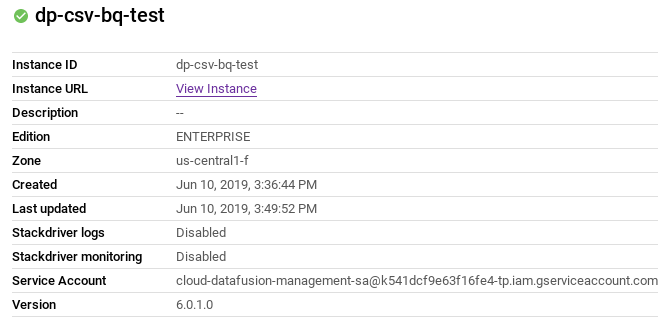
- כדי לעבור לדף הפרטים של המכונה, לוחצים על שם המכונה.

- מעתיקים את חשבון השירות.
- עוברים לדף IAM של הפרויקט.
- בדף ההרשאות של IAM, מוסיפים את חשבון השירות כחבר חדש ומעניקים לו את התפקיד Cloud Data Fusion API Service Agent. לוחצים על הלחצן Add, מדביקים את 'חשבון השירות' בשדה New members ובוחרים באפשרות Service Management -> Cloud Data Fusion API Server Agent role.

- לוחצים על שמירה.
אחרי שמבצעים את השלבים האלה, אפשר להתחיל להשתמש ב-Cloud Data Fusion. לשם כך, לוחצים על הקישור View Instance (הצגת המכונה) בדף המכונות של Cloud Data Fusion או בדף הפרטים של מכונה.
מגדירים את הכלל בחומת האש.
- עוברים אל GCP Console -> VPC Network -> Firewall rules כדי לבדוק אם הכלל default-allow-ssh קיים או לא.

- אם לא, מוסיפים כלל חומת אש שמאפשר את כל תעבורת הנתונים הנכנסת דרך SSH לרשת שמוגדרת כברירת מחדל.
באמצעות שורת הפקודה:
gcloud beta compute --project={PROJECT_ID} firewall-rules create default-allow-ssh --direction=INGRESS --priority=1000 --network=default --action=ALLOW --rules=tcp:22 --source-ranges=0.0.0.0/0 --enable-logging
באמצעות ממשק המשתמש: לוחצים על Create Firewall Rule (יצירת כלל של חומת אש) וממלאים את הפרטים:


4. יצירת סכימה לטרנספורמציה
עכשיו, אחרי שיש לנו את סביבת Cloud Fusion ב-GCP, נבנה סכימה. אנחנו צריכים את הסכימה הזו כדי לבצע טרנספורמציה של נתוני ה-CSV.
- בחלון Cloud Data Fusion, לוחצים על הקישור 'הצגת המופע' בעמודה 'פעולה'. המערכת תפנה אתכם לדף אחר. לוחצים על כתובת ה-URL שמופיעה כדי לפתוח את מכונת Cloud Data Fusion. הבחירה שלכם אם ללחוץ על הלחצן 'התחלת סיור' או על הלחצן 'לא, תודה' בחלון הקופץ של הודעת הפתיחה.
- מרחיבים את תפריט ההמבורגר, בוחרים באפשרות Pipeline (צינור) -> Studio.

- בקטע Transform (טרנספורמציה) בפלטת התוספים בצד ימין, לוחצים לחיצה כפולה על הצומת Wrangler שיופיע בממשק המשתמש של Data Pipelines (צינורות נתונים).

- מציבים את הסמן מעל צומת ה-Wrangler ולוחצים על Properties (מאפיינים). לוחצים על הלחצן Wrangle ואז בוחרים קובץ מקור מסוג .csv (לדוגמה, patients.csv). בקובץ הזה צריכים להיות כל שדות הנתונים כדי ליצור את הסכימה הרצויה.
- לוחצים על החץ למטה (שינויים בעמודות) לצד כל שם עמודה (לדוגמה, body).

- כברירת מחדל, הייבוא הראשוני יניח שיש רק עמודה אחת בקובץ הנתונים. כדי לנתח אותו כקובץ CSV, בוחרים באפשרות ניתוח → CSV, ואז בוחרים את התו להפרדה ומסמנים את התיבה 'הגדרת השורה הראשונה ככותרת' לפי הצורך. לוחצים על הלחצן 'אישור'.
- לוחצים על החץ למטה לצד השדה 'גוף ההודעה' ובוחרים באפשרות 'מחיקת העמודה' כדי להסיר את השדה 'גוף ההודעה'. בנוסף, אפשר לנסות טרנספורמציות אחרות כמו הסרת עמודות, שינוי סוג הנתונים של חלק מהעמודות (ברירת המחדל היא סוג 'מחרוזת'), פיצול עמודות, הגדרת שמות עמודות וכו'.

- בכרטיסיות 'עמודות' ו'שלבי טרנספורמציה' מוצגים סכימת הפלט והמתכון של Wrangler. לוחצים על אישור בפינה השמאלית העליונה. לוחצים על הלחצן 'אימות'. ההודעה הירוקה 'לא נמצאו שגיאות' מציינת שהפעולה הצליחה.

- ב-Wrangler Properties, לוחצים על התפריט הנפתח Actions (פעולות) כדי Export (לייצא) את הסכימה הרצויה לאחסון המקומי לטובת Import (ייבוא) עתידי, אם צריך.
- שומרים את המתכון של Wrangler לשימוש עתידי.
parse-as-csv :body ',' true
drop body
- כדי לסגור את החלון Wrangler Properties (מאפייני Wrangler), לוחצים על הלחצן X.
5. פיתוח צמתים לצינור עיבוד הנתונים
בקטע הזה ניצור את רכיבי צינור העיבוד.
- בממשק המשתמש של צינורות להעברת נתונים, בפינה הימנית העליונה, אמורה להיות האפשרות צינור להעברת נתונים – אצווה שנבחרה כסוג הצינור.

- בחלונית הימנית יש קטעים שונים כמו Filter (סינון), Source (מקור), Transform (שינוי), Analytics (ניתוח), Sink (יעד), Conditions and Actions (תנאים ופעולות), Error Handlers (טיפול בשגיאות) ו-Alerts (התראות), שבהם אפשר לבחור צומת או צמתים לצינור.

צומת מקור
- בוחרים את צומת המקור.
- בקטע Source (מקור) בלוח התוספים מימין, לוחצים לחיצה כפולה על הצומת Google Cloud Storage שמופיע בממשק המשתמש של Data Pipelines.
- מצביעים על צומת המקור של GCS ולוחצים על מאפיינים.

- מזינים את הפרטים בשדות הדרושים. מגדירים את השדות הבאים:
- Label = {any text}
- שם הפניה = {כל טקסט}
- Project ID = זיהוי אוטומטי
- Path = כתובת ה-URL של GCS לקטגוריה בפרויקט הנוכחי. לדוגמה, gs://$BUCKET_NAME/csv/
- Format = text
- Path Field = filename
- Path Filename Only = true
- Read Files Recursively = true
- מוסיפים את השדה filename (שם הקובץ) לסכימת הפלט של GCS בלחיצה על הלחצן +.
- לחיצה על Documentation תציג הסבר מפורט. לוחצים על הלחצן 'אימות'. ההודעה הירוקה 'לא נמצאו שגיאות' מציינת שהפעולה הצליחה.
- כדי לסגור את המאפיינים של GCS, לוחצים על הלחצן X.
צומת של שינוי
- בוחרים את צומת הטרנספורמציה.
- בקטע Transform (טרנספורמציה) בלוח התוספים בצד ימין, לוחצים פעמיים על הצומת Wrangler שמופיע בממשק המשתמש של Data Pipelines (צינורות נתונים). מחברים את צומת המקור GCS לצומת ההמרה Wrangler.
- מציבים את הסמן מעל צומת ה-Wrangler ולוחצים על Properties (מאפיינים).
- לוחצים על התפריט הנפתח פעולות ובוחרים באפשרות ייבוא כדי לייבא סכימה שנשמרה (לדוגמה: gs://hcls_testing_data_fhir_10_patients/csv_schemas/ schema (Patients).json), ומדביקים את המתכון שנשמר מהקטע הקודם.
- אפשר גם להשתמש מחדש בצומת Wrangler מהקטע יצירת סכימה לטרנספורמציה.
- מזינים את הפרטים בשדות הדרושים. מגדירים את השדות הבאים:
- Label = {any text}
- שם השדה להזנת קלט = {*}
- Precondition = {filename != "patients.csv"} כדי להבחין בין כל קובץ קלט (לדוגמה, patients.csv, providers.csv, allergies.csv וכו') לבין צומת המקור.

- מוסיפים צומת JavaScript כדי להפעיל את ה-JavaScript שהמשתמש סיפק, שמבצע טרנספורמציה נוספת של הרשומות. בשיעור Codelab הזה נשתמש בצומת JavaScript כדי לקבל חותמת זמן לכל עדכון של רשומה. מחברים את צומת ההמרה של Wrangler לצומת ההמרה של JavaScript. פותחים את Properties (מאפיינים) של JavaScript ומוסיפים את הפונקציה הבאה:

function transform(input, emitter, context) {
  input.TIMESTAMP = (new Date()).getTime()*1000;
  emitter.emit(input);
}
- לוחצים על הסמל + כדי להוסיף את השדה TIMESTAMP (אם הוא לא קיים) לסכימת הפלט. בוחרים את חותמת הזמן כסוג הנתונים.

- לקבלת הסבר מפורט, לוחצים על Documentation (מסמכים). לוחצים על הלחצן 'אימות' כדי לאמת את כל פרטי הקלט. ההודעה הירוקה 'לא נמצאו שגיאות' מציינת שהפעולה הצליחה.
- כדי לסגור את החלון Transform Properties (מאפייני שינוי הצורה), לוחצים על הלחצן X.
אנונימיזציה והסרת פרטי הזיהוי מהנתונים
- כדי לבחור עמודות נתונים ספציפיות, לוחצים על החץ למטה בעמודה ומחילים כללי מיסוך בהתאם לדרישות (לדוגמה, עמודת מספר הביטוח הלאומי).

- אפשר להוסיף עוד הוראות בחלון Recipe (מתכון) של הצומת Wrangler (מנהל נתונים). לדוגמה, כדי להסיר את הפרטים המזהים, משתמשים בהנחיית הגיבוב עם אלגוריתם הגיבוב לפי התחביר הבא:
hash <column> <algorithm> <encode>

<column>: name of the column
<algorithm>: Hashing algorithm (i.e. MD5, SHA-1, etc.)
<encode>: default is true (hashed digest is encoded as hex with left-padding zeros). To disable hex encoding, set <encode> to false.

Sink node
- בוחרים את צומת היעד.
- בקטע Sink בפלטת התוספים בצד ימין, לוחצים פעמיים על הצומת BigQuery שיופיע בממשק המשתמש של צינור הנתונים.
- מציבים את הסמן מעל צומת היעד של BigQuery ולוחצים על Properties (מאפיינים).

- ממלאים את שדות החובה. מגדירים את השדות הבאים:
- Label = {any text}
- שם הפניה = {כל טקסט}
- Project ID = זיהוי אוטומטי
- Dataset = מערך נתונים ב-BigQuery שמשמש בפרויקט הנוכחי (כלומר, DATASET_ID)
- Table = {table name}
- לקבלת הסבר מפורט, לוחצים על Documentation (מסמכים). לוחצים על הלחצן 'אימות' כדי לאמת את כל פרטי הקלט. ההודעה הירוקה 'לא נמצאו שגיאות' מציינת שהפעולה הצליחה.

- כדי לסגור את BigQuery Properties (מאפייני BigQuery), לוחצים על הלחצן X.
6. פיתוח צינור עיבוד נתונים באצווה
חיבור כל הצמתים בצינור
- גוררים חץ של חיבור > מהקצה השמאלי של צומת המקור ומשחררים אותו על הקצה הימני של צומת היעד.
- לצינור יכולים להיות כמה ענפים שמקבלים קובצי קלט מאותו צומת מקור GCS.

- נותנים שם לצינור.
זה הכול. יצרתם עכשיו את צינור הנתונים הראשון שלכם לעיבוד באצווה, ואתם יכולים לפרוס ולהפעיל אותו.
שליחת התראות על צינורות עיבוד נתונים באימייל (אופציונלי)
כדי להשתמש בתכונה Pipeline Alert SendEmail, צריך להגדיר שרת דואר לשליחת דואר ממופע של מכונה וירטואלית. מידע נוסף זמין בקישור הבא:
שליחת אימייל ממופע | מאמרי עזרה של Compute Engine
ב-Codelab הזה נגדיר שרת ממסר דואר דרך Mailgun לפי השלבים הבאים:
- פועלים לפי ההוראות במאמר שליחת אימייל באמצעות Mailgun | חומרי עזר בנושא Compute Engine כדי להגדיר חשבון ב-Mailgun ולהגדיר את שירות ממסר האימייל. בהמשך מפורטים שינויים נוספים.
- מוסיפים את כל כתובות האימייל של הנמענים לרשימת ההרשאות של Mailgun. הרשימה הזו נמצאת באפשרות Mailgun>Sending>Overview בחלונית הימנית.


אחרי שהנמענים ילחצו על 'אני מסכים/ה' באימייל שנשלח מכתובת support@mailgun.net, כתובות האימייל שלהם יישמרו ברשימה המורשית לקבלת התראות על צינורות.

- שלב 3 בקטע 'לפני שמתחילים' – יצירת כלל לחומת האש באופן הבא:

- שלב 3 מתוך 'הגדרת Mailgun כממסר דואר עם Postfix'. בוחרים באפשרות אתר אינטרנט או אינטרנט עם שרת חכם, במקום באפשרות רק מקומי כמו שמופיע בהוראות.

- שלב 4 במאמר בנושא הגדרת Mailgun כשרת דואר ממסר באמצעות Postfix. עורכים את vi /etc/postfix/main.cf כדי להוסיף את 10.128.0.0/9 בסוף mynetworks.

- עורכים את vi /etc/postfix/master.cf כדי לשנות את ברירת המחדל של smtp (25) ליציאה 587.

- בפינה השמאלית העליונה של סטודיו Data Fusion, לוחצים על Configure (הגדרה). לוחצים על התראה על צינור ואז על לחצן + כדי לפתוח את החלון התראות. בוחרים באפשרות SendEmail (שליחת אימייל).

- ממלאים את טופס ההגדרה של אימייל. בתפריט הנפתח Run Condition בוחרים באפשרות completion, success או failure לכל סוג התראה. אם Include Workflow Token = false, נשלח רק המידע מהשדה Message. אם Include Workflow Token = true, המידע מהשדה Message ופרטים על Workflow Token נשלחים. צריך להשתמש באותיות קטנות בשדה Protocol. אל תשתמשו בכתובת אימייל פיקטיבית בשדה שולח, אלא בכתובת האימייל של החברה.

7. הגדרה, פריסה, הפעלה או תזמון של צינור עיבוד נתונים

- בפינה השמאלית העליונה של סטודיו Data Fusion, לוחצים על Configure (הגדרה). בוחרים באפשרות Spark for Engine Config (הגדרת מנוע). לוחצים על Save (שמירה) בחלון Configure (הגדרה).

- לוחצים על תצוגה מקדימה כדי לראות תצוגה מקדימה של הנתונים**,** ולוחצים שוב על תצוגה מקדימה כדי לחזור לחלון הקודם. אפשר גם להפעיל את צינור העיבוד במצב תצוגה מקדימה.

- לוחצים על יומנים כדי לראות את היומנים.
- לוחצים על שמירה כדי לשמור את כל השינויים.
- לוחצים על ייבוא כדי לייבא הגדרת צינור עיבוד נתונים שנשמרה כשיוצרים צינור עיבוד נתונים חדש.
- לוחצים על ייצוא כדי לייצא הגדרה של צינור עיבוד נתונים.
- לוחצים על Deploy (פריסה) כדי לפרוס את צינור עיבוד הנתונים.
- אחרי הפריסה, לוחצים על Run ומחכים עד שהצינור יפעל עד הסוף.

- כדי לשכפל את צינור המכירות, לוחצים על Duplicate (שכפול) מתחת ללחצן Actions (פעולות).
- כדי לייצא את הגדרות הצינור, לוחצים על Export (ייצוא) מתחת ללחצן Actions (פעולות).
- אם רוצים להגדיר טריגרים של צינורות, לוחצים על Inbound triggers (טריגרים נכנסים) או על Outbound triggers (טריגרים יוצאים) בקצה השמאלי או הימני של חלון Studio.
- לוחצים על תזמון כדי לתזמן את הפעלת צינור הנתונים וטעינת הנתונים באופן תקופתי.

- בכרטיסייה סיכום מוצגים תרשימים של היסטוריית ההרצה, הרשומות, יומני השגיאות והאזהרות.
8. אימות
- הצינור Validate הופעל בהצלחה.

- מוודאים שלמערך הנתונים ב-BigQuery יש את כל הטבלאות.
bq ls $PROJECT_ID:$DATASET_ID
     tableId       Type    Labels   Time Partitioning
----------------- ------- -------- -------------------
 Allergies         TABLE
 Careplans         TABLE
 Conditions        TABLE
 Encounters        TABLE
 Imaging_Studies   TABLE
 Immunizations     TABLE
 Medications       TABLE
 Observations      TABLE
 Organizations     TABLE
 Patients          TABLE
 Procedures        TABLE
 Providers         TABLE
- קבלת התראות באימייל (אם הוגדרו).
איך רואים את התוצאות
כדי לראות את התוצאות אחרי הפעלת הצינור:
- מריצים שאילתה בטבלה בממשק המשתמש של BigQuery. מעבר לממשק המשתמש של BigQuery
- מעדכנים את השאילתה שלמטה לשם הפרויקט, מערך הנתונים והטבלה שלכם.

9. סידור וארגון
כדי להימנע מחיובים בחשבון Google Cloud Platform בגלל השימוש במשאבים שנעשה במסגרת המדריך הזה:
בסיום המדריך, חשוב להסיר את המשאבים שיצרתם ב-GCP כדי שלא יתפסו את המכסה שלכם ולא תחויבו עליהם בעתיד. בסעיפים הבאים מוסבר איך למחוק או להשבית את המשאבים האלו.
מחיקת מערך הנתונים ב-BigQuery
כדי למחוק את מערך הנתונים ב-BigQuery שיצרתם כחלק מההדרכה הזו, פועלים לפי ההוראות האלה.
מחיקת קטגוריית GCS
כדי למחוק את קטגוריית GCS שיצרתם כחלק מההדרכה הזו, פועלים לפי ההוראות הבאות.
מחיקת מכונת Cloud Data Fusion
פועלים לפי ההוראות כדי למחוק את מופע Cloud Data Fusion.
מחיקת הפרויקט
הדרך הקלה ביותר לבטל את החיוב היא למחוק את הפרויקט שיצרתם בשביל המדריך.
כדי למחוק את הפרויקט:
- במסוף GCP, נכנסים לדף Projects. כניסה לדף Projects
- ברשימת הפרויקטים, בוחרים את הפרויקט שרוצים למחוק ולוחצים על Delete.
- כדי למחוק את הפרויקט, כותבים את מזהה הפרויקט בתיבת הדו-שיח ולוחצים על Shut down.
10. מזל טוב
סיימתם בהצלחה את סדנת הקוד להטמעת נתונים בתחום הבריאות ב-BigQuery באמצעות Cloud Data Fusion.
ייבאתם נתוני CSV מ-Google Cloud Storage ל-BigQuery.
יצרתם באופן ויזואלי את צינור עיבוד הנתונים לשילוב נתונים כדי לטעון, לשנות ולהסתיר נתונים של שירותי בריאות בכמות גדולה.
עכשיו אתם יודעים מהם השלבים העיקריים שצריך לבצע כדי להתחיל לנתח נתונים בתחום הבריאות באמצעות BigQuery ב-Google Cloud Platform.