

1. نظرة عامة
لنلقِ نظرة على البنية الضخمة التي أنشأناها على مدار الأجزاء الأربعة السابقة:
الجزء الأول: استخدمنا BigQuery Knowledge Catalog لتحويل ملفات PDF الأولية لوصفات الفرويو إلى جداول منظَّمة وعلائقية.
الجزء الثاني: أنشأنا جسرًا للمعاملات لا يتطلّب الاستخراج والتحويل والتحميل (ETL)، ودمجنا مستودع BigQuery مباشرةً في AlloyDB.
الجزء الثالث: نظّمنا تطبيقًا متعدد الوكلاء (FroyoOS) باستخدام "حزمة تطوير الوكلاء" وMCP Toolbox.
الجزء 4: أثبتنا أنّ وكيلنا آمن للاستخدام في الإنتاج من خلال إنشاء مسار تقييم مزدوج.
عملياتنا تسير بسلاسة. ولكن ماذا عن المطوّرين ومحلّلي الأعمال الذين يحتاجون إلى فهم الكميات الهائلة من البيانات التي ينشئها هذا النظام؟
اليوم، سنستكشف مستقبل الإحصاءات. سنبدأ مباشرةً من داخل أداة تعديل الرموز Antigravity IDE باستخدام حزمة Google Cloud Data Agent Kit، ثم ننتقل إلى وحدة تحكّم Google Cloud لعرض بياناتنا باستخدام BigQuery Conversational Analytics.
لنبدأ بإنشاء النماذج.
أهداف الدورة التعليمية
في هذا الدرس التطبيقي الأخير حول الترميز من سلسلة Agentic Data Cloud، ستجمع كل أجزاء البنية معًا لتقديم إحصاءات تجارية قابلة للاستخدام. ستتعرّف على ما يلي:
- IDE-First Analytics: كيفية تثبيت وإعداد ANTIGRAVITY IDE وGoogle Cloud Data Agent Kit لطلب البحث عن البنية مباشرةً من بيئة التطوير.
- Conversational BigQuery: كيفية إنشاء BigQuery Data Agents وإعدادها وتوجيهها لإجراء مهام SQL المعقّدة والتوقّعات باستخدام لغة طبيعية
- إتاحة البيانات للجميع: كيفية نشر الوكلاء في المؤسسة، ما يتيح للمحللين والمستخدمين التجاريين الوصول إليهم في جميع أقسام المؤسسة.
- عرض الإحصاءات: كيفية دمج إحصاءات المحادثات الخاصة بوكيلك بسلاسة في مركز البيانات لإنشاء لوحات بيانات ديناميكية جاهزة للتوقّعات
- منظومة Agentic Data Cloud المتكاملة: كيفية توضيح قيمة البنية الشاملة، بدءًا من البيانات الأولية غير المنظَّمة في الجزء الأول وحتى لوحات البيانات الجاهزة للمدراء التنفيذيين في الجزء الخامس.
المتطلبات
2. قبل البدء
إنشاء مشروع
- في Google Cloud Console، في صفحة أداة اختيار المشاريع، اختَر مشروعًا على Google Cloud أو أنشِئه.
- تأكَّد من تفعيل الفوترة لمشروعك على السحابة الإلكترونية. كيفية التحقّق من تفعيل الفوترة في مشروع
- ستستخدم Cloud Shell، وهي بيئة سطر أوامر تعمل في Google Cloud. انقر على "تفعيل Cloud Shell" (Activate Cloud Shell) في أعلى "وحدة تحكّم Google Cloud" (Google Cloud console).

- بعد الاتصال بـ Cloud Shell، يمكنك التحقّق من أنّه تمت مصادقتك وأنّ المشروع تم ضبطه على رقم تعريف مشروعك باستخدام الأمر التالي:
gcloud auth list
- نفِّذ الأمر التالي في Cloud Shell للتأكّد من أنّ أمر gcloud يتعرّف على مشروعك.
gcloud config list project
- إذا أردت المصادقة
gcloud auth login
- إذا لم يتم ضبط مشروعك، استخدِم الأمر التالي لضبطه:
export PROJECT_ID=<YOUR_PROJECT_ID>
gcloud config set project <YOUR_PROJECT_ID>
- تفعيل واجهات برمجة التطبيقات المطلوبة: نفِّذ هذا الأمر لتفعيل جميع واجهات برمجة التطبيقات المطلوبة:
gcloud services enable \
  alloydb.googleapis.com \
  bigquery.googleapis.com \
  run.googleapis.com \
  cloudbuild.googleapis.com \
  artifactregistry.googleapis.com \
  iam.googleapis.com \
  secretmanager.googleapis.com \
  compute.googleapis.com \
  servicenetworking.googleapis.com \
  aiplatform.googleapis.com
إنشاء مجموعة بيانات وتعبئة الجداول (فقط إذا لم تكن قد أكملت الجزء الأول)
في Cloud Shell، نفِّذ الأوامر التالية.
- أولاً، أنشئ مجموعة بيانات BigQuery من خلال تشغيل الأمر التالي من Cloud Shell Terminal:
bq mk --location us-central1 --dataset froyo_data
- بعد ذلك، نزِّل ملفات البيانات الثمانية (ملفات csv) من مستودع github إلى دليل العمل من خلال تشغيل الأوامر التالية واحدًا تلو الآخر:
wget https://raw.githubusercontent.com/AbiramiSukumaran/raw-data-to-gold/refs/heads/main/data/froyo_data.allergen.csv
- نفِّذ الأوامر التالية واحدًا تلو الآخر لإنشاء هذه الجداول باستخدام البيانات في مجموعة البيانات التي تم إنشاؤها حديثًا
bq load --autodetect --source_format=CSV --skip_leading_rows=1 --allow_quoted_newlines --quote="" froyo_data.allergen ./froyo_data.allergen.csv allergen_name:STRING
bq load --autodetect --source_format=CSV --skip_leading_rows=1 --allow_quoted_newlines --quote="" froyo_data.consistsof ./froyo_data.consistsof.csv product_id:STRING,ingredient_id:STRING
bq load --autodetect --source_format=CSV --skip_leading_rows=1 --allow_quoted_newlines --quote="" froyo_data.containsallergen ./froyo_data.containsallergen.csv ingredient_id:STRING,allergen_name:STRING
bq load --autodetect --source_format=CSV --skip_leading_rows=1 --allow_quoted_newlines --quote="" froyo_data.froyo_data_materialized ./froyo_data.froyo_data_materialized.csv allergen:STRING,containsallergen:STRING,ingredient:STRING,product:STRING,suppliedby:STRING,supplier:STRING,ref:STRING,md5_hash:STRING
bq load --autodetect --source_format=CSV --skip_leading_rows=1 --allow_quoted_newlines --quote="" froyo_data.ingredient ./froyo_data.ingredient.csv ingredient_id:STRING,ingredient_name:STRING,purity:STRING,moisture_content:STRING,ph_range:STRING,specific_gravity_range:STRING
bq load --autodetect --source_format=CSV --skip_leading_rows=1 --allow_quoted_newlines --quote="" froyo_data.product ./froyo_data.product.csv product_id:STRING,product_name:STRING,category:STRING,stability:STRING
bq load --autodetect --source_format=CSV --skip_leading_rows=1 --allow_quoted_newlines --quote="" froyo_data.suppliedby ./froyo_data.suppliedby.csv ingredient_id:STRING,supplier_id:STRING
bq load --autodetect --source_format=CSV --skip_leading_rows=1 --allow_quoted_newlines --quote="" froyo_data.supplier ./froyo_data.supplier.csv supplier_id:STRING,supplier_name:STRING,production_site_id:STRING,facility_grade:STRING
3- توسيع مستودع البيانات
هل تتذكرون جداول BigQuery التي أنشأناها من بياناتنا غير المنظَّمة؟
لإجراء بعض الإحصاءات المفيدة، نحتاج إلى بيانات المعاملات السابقة. في BigQuery، ضمن مجموعة بيانات froyo_data، لننشئ ثلاثة جداول جديدة لمحاكاة سنوات من عمليات الامتياز:
- froyo_data.orders: عناوين الطلبات السابقة (التواريخ وأرقام تعريف المتاجر والمجاميع)
- froyo_data.order_items: تفاصيل العناصر (الكميات والأسعار)
- froyo_data.customer_allergen_data: جدول في نظام إدارة علاقات العملاء يتتبّع أنواع الحساسية المعروفة لدى عملائنا الأوفياء
لنضِف هذه الجداول المتعلّقة بالمبيعات والعملاء إلى مجموعة البيانات هذه استعدادًا لحالة استخدام الإحصاءات.
- انتقِل إلى Cloud Shell Terminal من Google Cloud Console.
- انتقِل إلى المجلد الجذر لمساحة العمل أو إلى المجلد الجذر لمشروع froyo-data (الذي كنّا نعمل عليه في الجزأين السابقين من هذه السلسلة).
- نزِّل ملفات البيانات السابقة الثلاثة (في ملفات csv) إلى دليل العمل من خلال تشغيل الأوامر التالية واحدًا تلو الآخر:
wget https://raw.githubusercontent.com/AbiramiSukumaran/froyo-data/main/customer_allergen_data.csv
wget https://raw.githubusercontent.com/AbiramiSukumaran/froyo-data/main/order_items.csv
wget https://raw.githubusercontent.com/AbiramiSukumaran/froyo-data/main/orders.csv
- بعد ظهور هذه الملفات في جذر دليل العمل، انتقِل إلى Cloud Shell Terminal من خلال التبديل إلى الوحدة الطرفية.
- انتقِل إلى الدليل الذي يحتوي على هذه الملفات الثلاثة في Cloud Shell Terminal.
- تأكَّد من أنّ BigQuery يحتوي على مجموعة البيانات باسم "froyo_data" من الجزء 1 من هذه السلسلة (إذا لم يكن الأمر كذلك، ارجع وأنشئ مجموعة البيانات والجداول).
- نفِّذ الأوامر التالية من Cloud Shell Terminal:
bq load \
  --autodetect \
  --source_format=CSV \
  --skip_leading_rows=1 \
  --allow_quoted_newlines \
  --quote="" \
  froyo_data.orders \
  ./orders.csv
bq load \
  --autodetect \
  --source_format=CSV \
  --skip_leading_rows=1 \
  --allow_quoted_newlines \
  --quote="" \
  froyo_data.order_items \
  ./order_items.csv
bq load \
  --autodetect \
  --source_format=CSV \
  --skip_leading_rows=1 \
  --allow_quoted_newlines \
  --quote="" \
  froyo_data.customer_allergen_data \
  ./customer_allergen_data.csv
من المفترض أن يؤدي ذلك إلى إنشاء الجداول الثلاثة الإضافية في مجموعة بيانات froyo_data.
4. تجربة المطوّر: تعرَّف على "مجموعة أدوات وكيل البيانات"
في السابق، إذا أراد المطوّر تحليل البيانات أو كتابة طلبات بحث معقّدة لتعلُّم الآلة، كان عليه التبديل باستمرار بين بيئة التطوير المتكاملة (IDE) ووحدات تحكّم قواعد البيانات والمستندات.
ليس بعد الآن. بفضل إضافة Google Cloud Data Agent Kit التي تم إطلاقها حديثًا، تصبح بيئة التطوير المتكاملة (IDE) مركزًا قويًا للبيانات. توفّر إضافة Google Cloud Data Agent Kit تكاملاً عميقًا مع خدمات بيانات Google Cloud مباشرةً داخل المحرِّر، ما يتيح لك التفاعل مع BigQuery وCloud SQL وCloud Storage والمزيد بدون تبديل السياقات.
المتطلبات الأساسية
- Node.js (أحدث إصدار يُنصح به)
- ثبِّت gcloud CLI.
- سجِّل الدخول باستخدام حسابك على Google Cloud:
gcloud auth login
- سجِّل الدخول إلى "بيانات الاعتماد التلقائية للتطبيق" (ADC):
gcloud auth application-default login
Antigravity IDE
Antigravity IDE هي بيئة تطوير من الجيل التالي من Google تستند إلى الذكاء الاصطناعي الوكيل ومصمّمة خصيصًا لعصر الذكاء الاصطناعي. فهو يدمج بشكل أصلي نوافذ سياق متعددة الوسائط ضخمة واستخدام أدوات مستقلة مباشرةً في المحرِّر، ما يتيح للمطوّرين تنظيم الموارد السحابية ومسارات البيانات المعقّدة بدون مغادرة الرمز البرمجي.
إعداد Antigravity IDE
- نزِّل Antigravity IDE وثبِّته من صفحة تنزيل Google Antigravity.
- التثبيت والتشغيل: شغِّل أداة التثبيت وافتح Antigravity IDE.
- انقر على "المتابعة باستخدام Google"، واختَر حسابك على Gmail وامنحه الإذن.
- اتّبِع الإعدادات الأولية. ملاحظة: يمكنك دائمًا تعديل هذه الإعدادات لاحقًا.
- أنشئ مجلدًا جديدًا فارغًا على جهازك المحلي (مثلاً باسم
agentic-data-labs)، وافتحه في بيئة التطوير المتكاملة (IDE) من خلال اختيار "فتح مجلد". سيكون هذا بمثابة مساحة العمل المحلية للدرس التطبيقي حول الترميز.
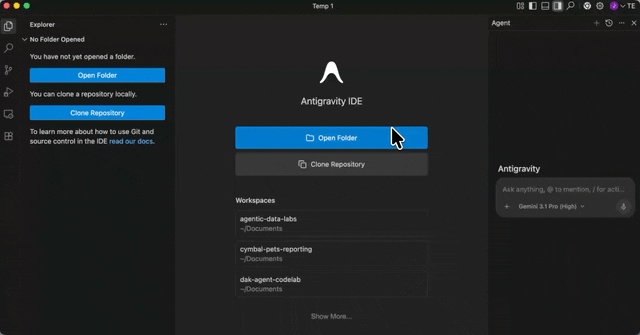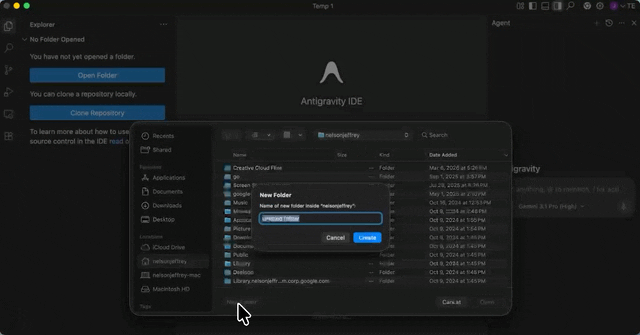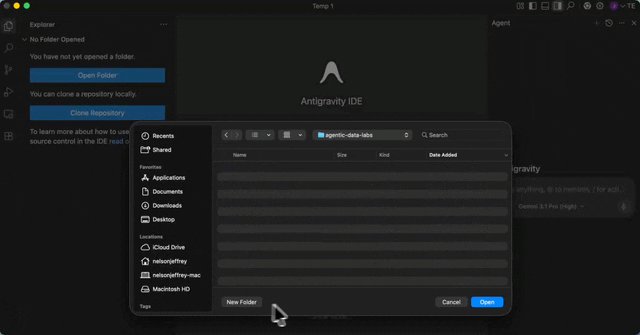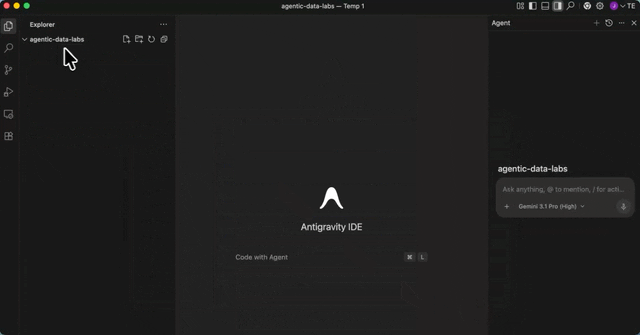
على يسار الصفحة، من المفترض أن تظهر لوحة الوكيل، وعلى يمينها متصفّح المشاريع، وفي الوسط مساحة التطوير.
تثبيت إضافة Data Agent Kit
توفّر إضافة Google Cloud Data Agent Kit تكاملاً عميقًا مع خدمات بيانات Google Cloud مباشرةً داخل المحرِّر، ما يتيح لك التفاعل مع BigQuery وCloud SQL وCloud Storage والمزيد بدون تبديل السياقات.
- في Antigravity IDE، انقر على رمز "الإضافات" (Extensions) في "شريط النشاط" (Activity Bar) في أقصى يمين الشاشة (يبدو كأربعة مربعات).
- في شريط البحث في أعلى لوحة "الإضافات"، اكتب
Google Cloud Data Agent Kit. - ابحث عن الإضافة المسماة Google Cloud Data Agent Kit التي نشرتها
googlecloudtools. - انقر على الزر تثبيت.
- قد يظهر طلب يسألك: "هل تثق في الناشر googlecloudtools وإضافاته؟". انقر على الوثوق بالناشرين والتثبيت (Trust Publishers & Install) للمتابعة.
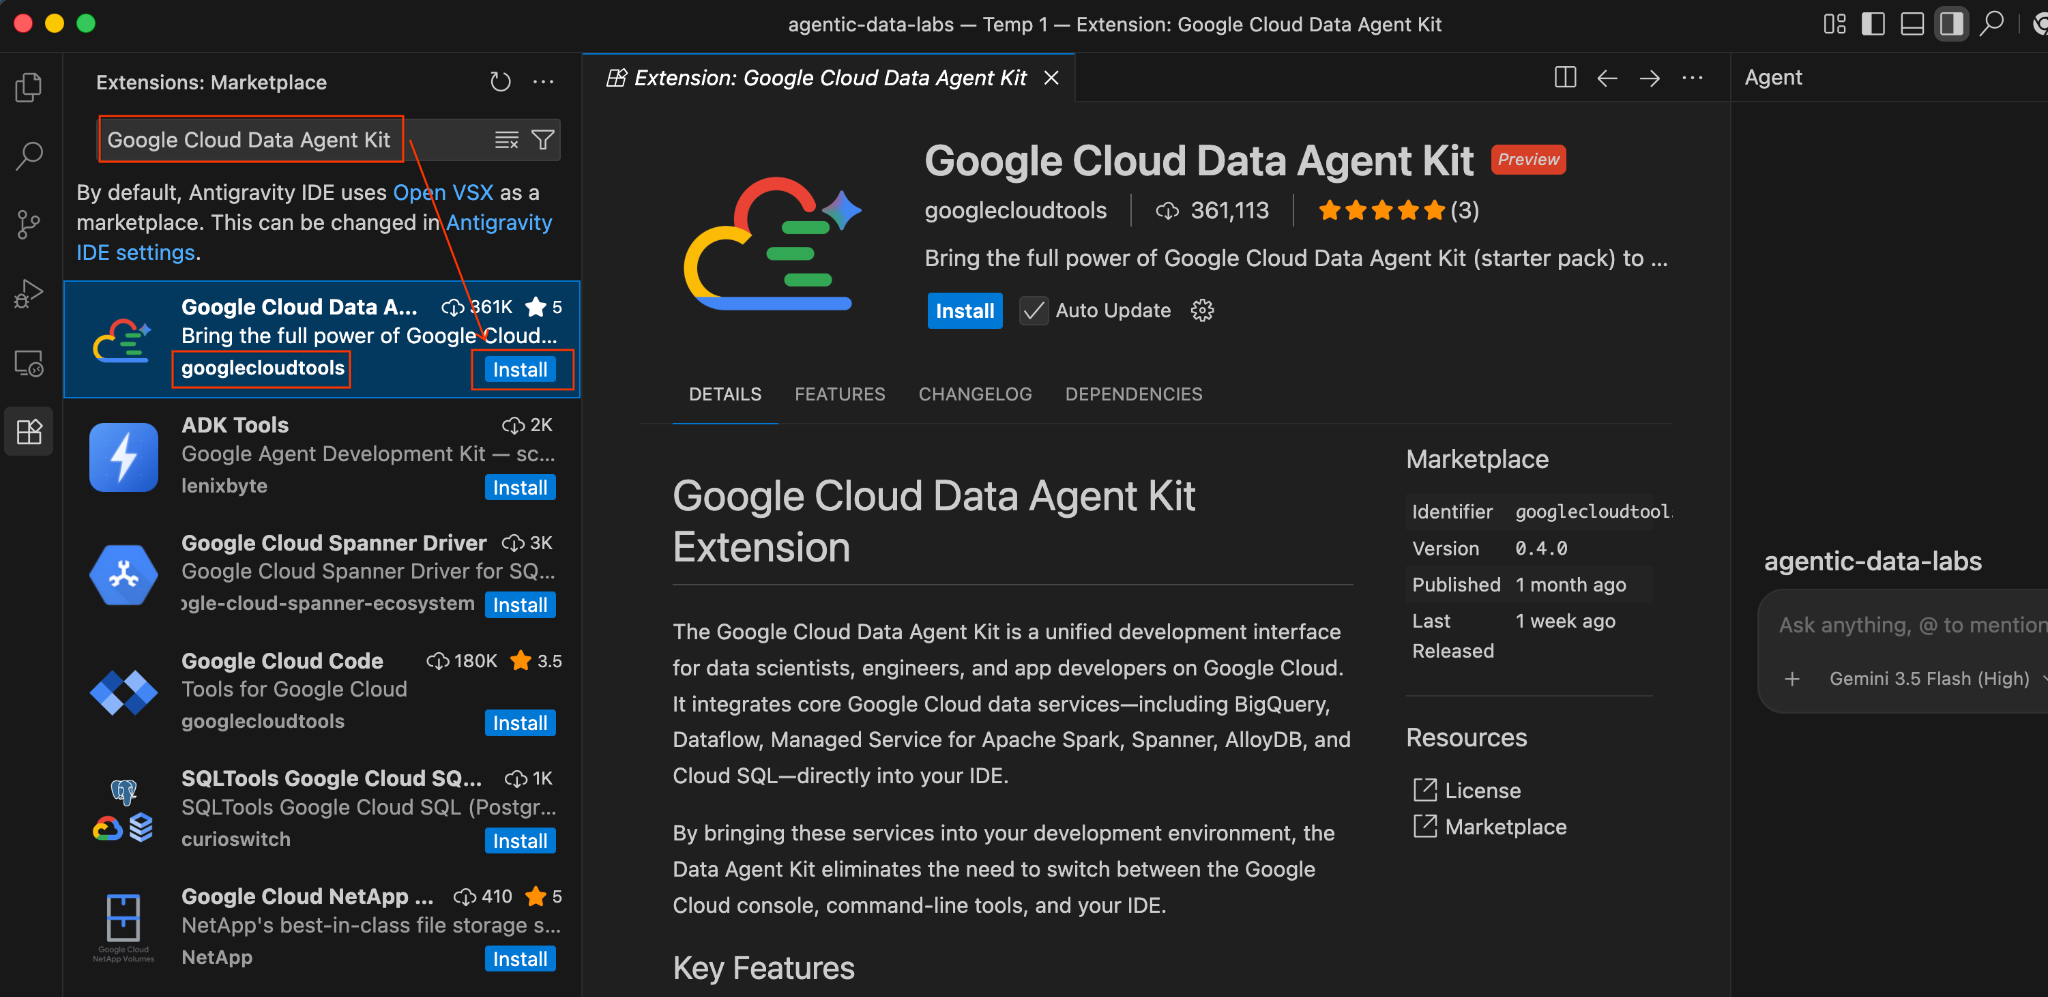
بعد التثبيت، سيظهر رمز Google Cloud Data Agent Kit جديد في شريط النشاط في أقصى يمين Antigravity IDE.
- من المفترض أن تفتح تلقائيًا صفحة إعداد بعنوان "مرحبًا بك في Google Cloud Data Agent Kit". إذا لم تكن مسجِّلاً الدخول إلى حسابك على Cloud، اتّبِع أي تعليمات للسماح بالوصول.
- في قسم "ملخّص الإعدادات"، ابحث عن حقل المشروع. انقر على القائمة المنسدلة واختَر مشروعك على Google Cloud. اضبط منطقتك على us-central1. بعد ذلك، انقر على "ضبط خوادم MCP".
- ألصِق ما يلي في ملف جديد في مشروعك باسم
GEMINI.md(لا تنسَ استبدال <<YOUR_PROJECT_ID>> بقيمتك):
## 1. Project Context
- **Project ID**: <<YOUR_PROJECT_ID>>
- **Domain**: This project is centralized around "Froyo", a brand of frozen yogurt offering multiple flavors.
- **Data**: All froyo, customer, order related information is processed and stored in BigQuery `froyo_data` dataset.

## 2. Execution & Data Processing Rules
- **CRITICAL RULE - Structured Specs**: The semantic and structured information extracted from the PDFs is available in a BigQuery dataset named `froyo_data`.
- **CRITICAL RULE - Customer Data**: Existing Froyo customer data resides in BigQuery in the tables `customers_allergen_data`.
- ** CRITICAL RULE - Sales Data**: Sales data is present in tables `orders` and `order_items`.
- ** CRITICAL RULE - General: When you are referencing a dataset, ensure you are using it with the dataset ID (`froyo_data`) . For example, to query orders table in this dataset you should use `froyo_data.orders`.
- **CRITICAL RULE - Allergen & Ingredient Mapping**: Never join `consistsof` directly to `containsallergen` on `ingredient_id`. The `consistsof` table often contains ingredient names (e.g. `Midnight Base 204`) while `containsallergen` maps CAS/code IDs (e.g. `9412-78-0`). Always bridge them through `froyo_data.ingredient` (`ON c.ingredient_id = i.ingredient_name OR c.ingredient_id = i.ingredient_id`) to accurately detect allergens.
أصبح لديك الآن وكيل ذكاء اصطناعي ذو إمكانات عالية مدمج مباشرةً في بيئة التطوير المتكاملة (IDE)، وهو جاهز لكتابة الرموز البرمجية وإنشاء طلبات SQL وتحليل البنية.
نواجه الآن تحديًا تحليليًا رائعًا: هل يمكننا ربط مبيعاتنا السابقة ببيانات مسبّبات الحساسية المعقّدة والمستنتَجة التي استخرجناها من ملفات PDF في الجزء الأول؟
5- استنتاج المعلومات من خلال وكيل IDE
لنطلب من IDE Agent تنفيذ المهام الصعبة. افتح نافذة محادثة Agent Data Kit داخل Antigravity IDE مباشرةً وأدخِل الطلب التالي:
Does Midnight Swirl contain any allergen?
سيطلب منك التطبيق سلسلة من الأذونات، لذا عليك منحها حسب الاقتضاء.
أخيرًا، سيستردّ الردّ لك في نهاية تحليله:

رائع!!! لقد حدّد بشكل صحيح أنّ منتج Midnight Swirl يحتوي على الصويا.
لنطرح الآن سؤالاً أكثر تعقيدًا بعض الشيء. أرسِل الطلب التالي في Antigravity IDE:
I want to see the top 5 most popular products purchased by
customers who have a registered 'Dairy' allergy.
الردّ:

يمكنك مواصلة العمل. جرِّب طلبات مثل:
Forecast the sales volume of our top non-dairy products
for the next 30 days based on historical data.
بدون الحاجة إلى البحث عن بنية BQML، تُضيف Agent Data Kit الرمزَين CREATE MODEL وML.FORECAST بالضبط إلى المحرّر. يمكن تنفيذ ذلك مباشرةً في بيئة BigQuery بدون مغادرة Antigravity IDE.
هذا رائع جدًا!!!
6. "الإحصاءات الحوارية" في BigQuery
في حين أنّ المطوّرين يفضّلون بيئة التطوير المتكاملة (IDE)، يفضّل المستخدمون التجاريون والمدراء التنفيذيون استخدام وحدة تحكّم السحابة الإلكترونية. لا يريدون رؤية SQL، بل يريدون فقط إجابات.
لنبدأ:
- منح نفسك الأدوار المطلوبة
انتقِل إلى صفحة "إدارة الهوية وإمكانية الوصول" (IAM) الخاصة بالمشروع وامنح نفسك دور "مالك وكيل البيانات" في Gemini Data Analytics:

يمنحك هذا الدور الإذن بإنشاء جميع وكلاء البيانات في المشروع وتعديلهم ومشاركتهم وحذفهم.
- تفعيل واجهات برمجة التطبيقات المطلوبة
انتقِل إلى BigQuery على Google Cloud Console. استخدِم عناصر التنقل في الشريط الجانبي أو قائمة البحث في أعلى الصفحة للانتقال إلى BigQuery > الوكلاء.
انقر على "تفعيل Data Analytics API باستخدام Gemini":

فعِّل كلاً من Gemini في BigQuery API وGemini في Google Cloud API:

من المفترض أن تظهر لك الآن صفحة الوكيل الجديد:

- ضبط معلومات الوكيل
اسم الوكيل: وكيل Froyo
وصف الوكيل: يساعد في الإجابة عن الأسئلة المتعلّقة بمنتجات الزبادي المثلّج والمواد المسبّبة للحساسية والمكوّنات والوصفات والعملاء والطلبات والمبيعات.

- انتقِل إلى قسم "مصادر المعرفة" واختَر جميع الجداول التالية من مجموعة بياناتك:

أ. أضِف الجداول في الصورة أعلاه وانقر على "إضافة مصدر".
ب. لكل مصدر، انقر على الزر تخصيص على يسار الصفحة. سيظهر لك النموذج أدناه:

ج. انقر على "قبول" لوصف الجدول.
د. انقر على "قبول" لكل وصف من أوصاف الحقول أيضًا.

هـ. انقر على "تعديل".
عليك تكرار هذه الخطوة لجميع الجداول في المصدر.
- ضبط التعليمات
أدخِل هنا التعليمات نفسها التي استخدمناها في ملف GEMINI.md في Antigravity IDE:
1. Project Context
Project ID: <<YOUR_PROJECT_ID>>
Domain: This project is centralized around "Froyo", a brand of frozen yogurt offering multiple flavors.
Data: All froyo, customer, order related information is processed and stored in BigQuery froyo_data dataset. Use all the tables and data in the dataset for querying for user questions.
Context: Use Data Agent Kit skills wherever possible.
2. Execution & Data Processing Rules
CRITICAL RULE - Structured Specs: The semantic and structured information extracted from the PDFs is available in a BigQuery dataset named froyo_data.
CRITICAL RULE - Customer Data: Existing Froyo customer data resides in BigQuery in the tables customers_allergen_data. When you are referencing a dataset, ensure you are using it with the dataset ID (froyo_data) . For example, to query orders table in this dataset you should use froyo_data.orders.
- احفظ الوكيل.
7. الدردشة مع بياناتك
- اختبِرها في قسم المعاينة على يسار الصفحة:

طرح سؤالك:
Does midnight swirl contain any allergen?

إليك الردّ:

والآن، لنطرح السؤال المعقّد:
I want to see the top 5 most popular products purchased by
customers who have a registered 'Dairy' allergy.
الردّ:


لنجرّب الآن طلبًا للحصول على إحصاءات معمّقة:
Forecast the sales volume of our top non-dairy products
for the next 30 days based on historical data.
يمكنك الاطّلاع على طلب البحث الذي تستخدمه، مع نتيجة الجدول والرسم البياني:


رائع! كانت الرسوم البيانية والإحصاءات مفيدة جدًا. حان الوقت لطرح السؤال الأهم حول المنتجات.
8. الاختبار النهائي
اطرح السؤال:
What will be the top most selling product of 2026


انظر إلى تلك الرؤية النهائية. لم يقدّم لنا BigQuery Data Agent رقمًا فحسب، بل ربط توقّعات المبيعات بشكل صريح بالمخزون وسلسلة الإمداد للمكوّنات، وهي البيانات نفسها التي استخرجناها من ملفات PDF غير المنظَّمة في الجزء الأول.
9. نشر الوكيل في المؤسسة
انقر على الزر نشر في أعلى وكيل المعاينة.

بعد إنشاء وكيل Froyo وإعداده واختباره، حان الوقت لإطلاقه لبقية أقسام الشركة.
في أعلى يسار صفحة إعدادات الوكيل، انقر على الزر "نشر".
من خلال نشر الوكيل، يصبح متاحًا على الفور عبر ثلاث قنوات فعّالة للمؤسسات لك ولأي شخص تشاركه معه:
- BigQuery: يمكن لمحلّلي البيانات الآن التحدّث مع هذا الوكيل مباشرةً من مركز الوكلاء أو داخل مساحة عمل SQL في BigQuery Studio.
- Conversational Analytics API: يمكن للمطوّرين الوصول إلى هذا الوكيل من خلال REST API، ما يتيح لهم دمج إحصاءات المحادثات هذه في تطبيقات الويب الداخلية المخصّصة.
- مركز البيانات: يمكن للمدراء التنفيذيين التفاعل مع هذا الوكيل وإنشاء لوحات بيانات حوارية ديناميكية مباشرةً داخل "مركز البيانات".
لقد نجحنا في إخراج بياناتنا من المستودعات ووضعها مباشرةً في أيدي الأشخاص الذين يحتاجون إليها، في مكان عملهم بالضبط!
انقر على القائمة المنسدلة لزر "مشاركة" (Share) في أعلى وكيل BigQuery المنشور، واختَر "نسخ رابط الوكيل في مركز البيانات" (Copy Link to agent in data studio) من القائمة:

الصِق هذا الرابط في المتصفّح واضغط على Enter. يُرجى تأكيد تنبيه الوصول إلى تفاعلات الوكيل:

يمكنك بدء محادثات تفاعلية وعروض مرئية باستخدام الوكيل المنشور حديثًا من مركز البيانات، وكذلك يمكن لقادتك والفرق الأخرى التي تحتاج إلى هذه المعلومات!
10. تَنظيم
بعد الانتهاء من هذا التمرين، لا تنسَ إزالة الأذونات لجميع المستخدمين في وكيل BigQuery الذي أنشأته للتو.
11. تهانينا!
لقد أنشأت رسميًا Agentic Data Cloud.
لم تنشئوا روبوت دردشة بسيطًا فحسب. على مدار هذه الجلسات الخمس، نجحت في تصميم نظام ذكاء اصطناعي متكامل وحديث ومقيَّم للمؤسسات من البداية. لقد انتقلت من "البيانات غير المنظَّمة" إلى معلومات المعاملات في الوقت الفعلي، وأخيرًا إلى توقّعات الأنشطة التجارية المستندة إلى المحادثات.
12. الصورة الكاملة
لنلقِ نظرة على ما حققناه في هذه السلسلة. لم ننشئ روبوت دردشة بسيطًا فحسب. لقد صمّمنا منصة Agentic Data Cloud كاملة وحديثة:
الجزء 1: الوصول إلى البيانات غير المنظَّمة من خلال تحويل ملفات PDF إلى جداول ارتباطية منظَّمة باستخدام Knowledge Catalog
الجزء 2: تم تقسيم صوامع البيانات من خلال دمج مستودعنا التحليلي مباشرةً في قاعدة بيانات معاملات AlloyDB.
الجزء 3: تمكين المستخدمين من خلال إنشاء نظام تشغيل متعدد الوكلاء ينفّذ أدوات قواعد البيانات الآمنة بسلاسة عبر بروتوكول MCP
الجزء 4: ضمان الأمان من خلال تنفيذ مسار تقييم صارم لرصد الهلوسات ومحاولات كسر القيود
الجزء الخامس: الإحصاءات المتاحة للجميع باستخدام Antigravity IDE و"الإحصاءات الحوارية" في BigQuery
هذا هو مستقبل برامج المؤسسات. لم يعُد وكيل الذكاء الاصطناعي مجرّد برنامج يغلّف نموذجًا لغويًا كبيرًا. وهو محرّك تنسيق متكامل وآمن تم تقييمه ويعمل على منصة بيانات موحّدة.