

1. 總覽
我們花點時間看看過去四個部分建構的龐大架構:
第 1 部分:我們使用 BigQuery Knowledge Catalog,將原始優格冰淇淋食譜 PDF 轉換為結構化關聯資料表。
第 2 部分:我們建構了免 ETL 的交易橋接,直接將 BigQuery 倉儲與 AlloyDB 建立聯合查詢。
第 3 部分:我們使用 Agent Development Kit 和 MCP Toolbox,自動調度管理多代理應用程式 (FroyoOS)。
第 4 部分:我們建構了雙軌評估管道,證明代理可安全用於正式環境。
我們的營運狀況良好,但開發人員和業務分析師需要瞭解這個系統產生的大量資料,該怎麼辦?
今天,我們將探討數據分析的未來趨勢。首先,我們會使用 Google Cloud Data Agent Kit,在程式碼編輯器 Antigravity IDE 中操作,接著前往 Google Cloud 控制台,使用 BigQuery 對話式數據分析功能,以圖表呈現資料。
開始建構吧!
課程內容
在本程式碼實驗室中,您將整合架構的所有部分,提供可做為行動依據的業務洞察資訊。這是代理式資料雲端系列的最後一個程式碼實驗室。您將學會:
- IDE 優先數據分析:如何安裝及設定 ANTIGRAVITY IDE 和 Google Cloud Data Agent Kit,直接從開發環境查詢架構。
- 對話式 BigQuery:如何建立、設定及指示 BigQuery 資料代理,使用自然語言自動執行複雜的 SQL 工作和預測。
- 資料普及化:如何將代理發布至企業,讓組織內的分析師和業務使用者都能存取。
- 以圖表呈現洞察資料:如何將代理的對話數據分析完美整合至數據分析,建立可預測趨勢的動態資訊主頁。
- 代理式資料雲端生態系統:如何清楚說明端對端架構的價值,從第 1 部分的原始非結構化資料,到第 5 部分的高階主管專用資訊主頁。
需求條件
2. 事前準備
建立專案
- 在 Google Cloud 控制台的專案選取器頁面中,選取或建立 Google Cloud 專案。
- 確認 Cloud 專案已啟用計費功能。瞭解如何確認專案是否已啟用計費功能。
- 您將使用 Cloud Shell,這是在 Google Cloud 中運作的指令列環境。點選 Google Cloud 控制台頂端的「啟用 Cloud Shell」。

- 連至 Cloud Shell 後,請使用下列指令,確認您已通過驗證,且專案已設為您的專案 ID:
gcloud auth list
- 在 Cloud Shell 執行下列指令,確認 gcloud 指令能辨識您的專案。
gcloud config list project
- 如要驗證
gcloud auth login
- 如果未設定專案,請使用下列指令設定:
export PROJECT_ID=<YOUR_PROJECT_ID>
gcloud config set project <YOUR_PROJECT_ID>
- 啟用必要的 API:執行下列指令,啟用所有必要的 API:
gcloud services enable \
  alloydb.googleapis.com \
  bigquery.googleapis.com \
  run.googleapis.com \
  cloudbuild.googleapis.com \
  artifactregistry.googleapis.com \
  iam.googleapis.com \
  secretmanager.googleapis.com \
  compute.googleapis.com \
  servicenetworking.googleapis.com \
  aiplatform.googleapis.com
建立資料集並填入資料表 (僅限未完成第 1 部分的情況)
在 Cloud Shell 執行下列指令。
- 首先,在 Cloud Shell 終端機執行下列指令,建立 BigQuery 資料集:
bq mk --location us-central1 --dataset froyo_data
- 接著,請逐一執行下列指令,從 GitHub 存放區將 8 個資料檔案 (CSV 檔案) 下載到目前使用的目錄:
wget https://raw.githubusercontent.com/AbiramiSukumaran/raw-data-to-gold/refs/heads/main/data/froyo_data.allergen.csv
- 逐一執行下列指令,使用新建立資料集中的資料建立這些資料表
bq load --autodetect --source_format=CSV --skip_leading_rows=1 --allow_quoted_newlines --quote="" froyo_data.allergen ./froyo_data.allergen.csv allergen_name:STRING
bq load --autodetect --source_format=CSV --skip_leading_rows=1 --allow_quoted_newlines --quote="" froyo_data.consistsof ./froyo_data.consistsof.csv product_id:STRING,ingredient_id:STRING
bq load --autodetect --source_format=CSV --skip_leading_rows=1 --allow_quoted_newlines --quote="" froyo_data.containsallergen ./froyo_data.containsallergen.csv ingredient_id:STRING,allergen_name:STRING
bq load --autodetect --source_format=CSV --skip_leading_rows=1 --allow_quoted_newlines --quote="" froyo_data.froyo_data_materialized ./froyo_data.froyo_data_materialized.csv allergen:STRING,containsallergen:STRING,ingredient:STRING,product:STRING,suppliedby:STRING,supplier:STRING,ref:STRING,md5_hash:STRING
bq load --autodetect --source_format=CSV --skip_leading_rows=1 --allow_quoted_newlines --quote="" froyo_data.ingredient ./froyo_data.ingredient.csv ingredient_id:STRING,ingredient_name:STRING,purity:STRING,moisture_content:STRING,ph_range:STRING,specific_gravity_range:STRING
bq load --autodetect --source_format=CSV --skip_leading_rows=1 --allow_quoted_newlines --quote="" froyo_data.product ./froyo_data.product.csv product_id:STRING,product_name:STRING,category:STRING,stability:STRING
bq load --autodetect --source_format=CSV --skip_leading_rows=1 --allow_quoted_newlines --quote="" froyo_data.suppliedby ./froyo_data.suppliedby.csv ingredient_id:STRING,supplier_id:STRING
bq load --autodetect --source_format=CSV --skip_leading_rows=1 --allow_quoted_newlines --quote="" froyo_data.supplier ./froyo_data.supplier.csv supplier_id:STRING,supplier_name:STRING,production_site_id:STRING,facility_grade:STRING
3. 擴充資料倉儲
還記得我們從非結構化資料建立的 BigQuery 資料表嗎?
為了進行有意義的分析,我們需要歷來交易資料。在 BigQuery 的 froyo_data 資料集下,建立三個新資料表,模擬加盟店多年的營運資料:
- froyo_data.orders:歷來訂單標頭 (日期、商店 ID、總計)
- froyo_data.order_items:明細項目詳細資料 (數量、價格)
- froyo_data.customer_allergen_data:CRM 資料表,追蹤忠實顧客已知的過敏原
接著,我們將這些銷售和客戶相關資料表新增至該資料集,為數據分析用途做好準備。
- 前往 Google Cloud 控制台的 Cloud Shell 終端機。
- 前往工作區的根資料夾,或 froyo-data 專案根資料夾 (本系列過去幾個部分使用的資料夾)。
- 逐一執行下列指令,將 3 個歷來資料檔案 (CSV 格式) 下載到目前使用的目錄:
wget https://raw.githubusercontent.com/AbiramiSukumaran/froyo-data/main/customer_allergen_data.csv
wget https://raw.githubusercontent.com/AbiramiSukumaran/froyo-data/main/order_items.csv
wget https://raw.githubusercontent.com/AbiramiSukumaran/froyo-data/main/orders.csv
- 在工作目錄的根目錄中看到這些檔案後,請切換至 Cloud Shell 終端機。
- 在 Cloud Shell 終端機中,前往這 3 個檔案所在的目錄。
- 確認 BigQuery 含有本系列第 1 部分的「froyo_data」資料集 (如果沒有,請返回建立資料集和資料表)。
- 在 Cloud Shell 終端機執行下列指令:
bq load \
  --autodetect \
  --source_format=CSV \
  --skip_leading_rows=1 \
  --allow_quoted_newlines \
  --quote="" \
  froyo_data.orders \
  ./orders.csv
bq load \
  --autodetect \
  --source_format=CSV \
  --skip_leading_rows=1 \
  --allow_quoted_newlines \
  --quote="" \
  froyo_data.order_items \
  ./order_items.csv
bq load \
  --autodetect \
  --source_format=CSV \
  --skip_leading_rows=1 \
  --allow_quoted_newlines \
  --quote="" \
  froyo_data.customer_allergen_data \
  ./customer_allergen_data.csv
這樣應該會在 froyo_data 資料集建立 3 個額外資料表。
4. 開發人員體驗:Data Agent Kit 簡介
以往,開發人員如要分析資料或編寫複雜的機器學習查詢,必須在 IDE、Databases Console 和說明文件之間不斷切換。
答案是不需要。有了新推出的 Google Cloud Data Agent Kit 擴充功能,IDE 就能成為強大的資料處理中心。Google Cloud Data Agent Kit 擴充功能可直接在編輯器中與 Google Cloud 資料服務深度整合,讓您與 BigQuery、Cloud SQL、Cloud Storage 等服務互動,不必切換環境。
必要條件
- Node.js (最新建議版本)
- 安裝 gcloud CLI。
- 使用 Google Cloud 帳戶登入:
gcloud auth login
- 登入應用程式預設憑證 (ADC):
gcloud auth application-default login
Antigravity IDE
Antigravity IDE 是 Google 新一代的代理優先開發環境,專為 AI 時代打造。這項工具將龐大的多模態脈絡視窗和自主工具使用功能,直接整合至編輯器,讓開發人員不必離開程式碼,就能調度管理雲端資源和複雜的資料管道。
設定 Antigravity IDE
- 前往 Google Antigravity 下載頁面,下載並安裝 Antigravity IDE。
- 安裝並啟動:執行安裝程式,然後開啟 Antigravity IDE。
- 按一下「使用 Google 帳戶繼續」,選取 Gmail 帳戶並授權。
- 完成初始設定。注意:你之後隨時可以前往「設定」頁面調整通知設定。
- 在本機電腦上建立新的空白資料夾 (例如命名為
agentic-data-labs),然後在 IDE 中選擇「Open Folder」開啟該資料夾。這個目錄將做為程式碼實驗室的本機工作區。
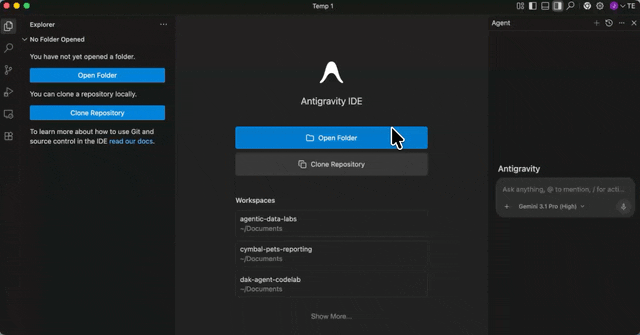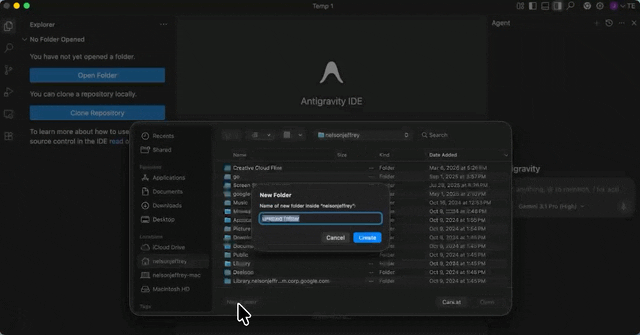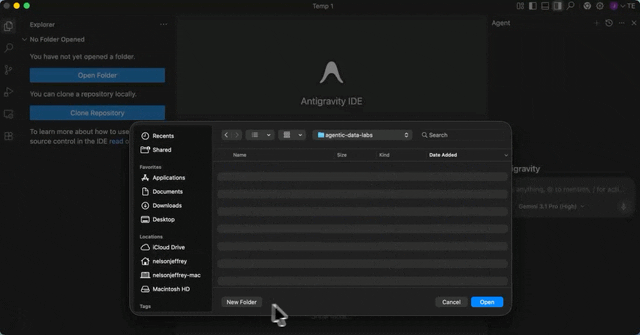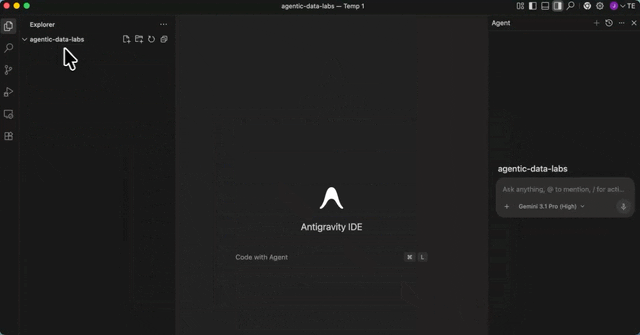
右側是代理窗格,左側是專案探索工具,中間則是開發空間。
安裝 Data Agent Kit 擴充功能
Google Cloud Data Agent Kit 擴充功能可直接在編輯器中與 Google Cloud 資料服務深度整合,讓您與 BigQuery、Cloud SQL、Cloud Storage 等服務互動,不必切換環境。
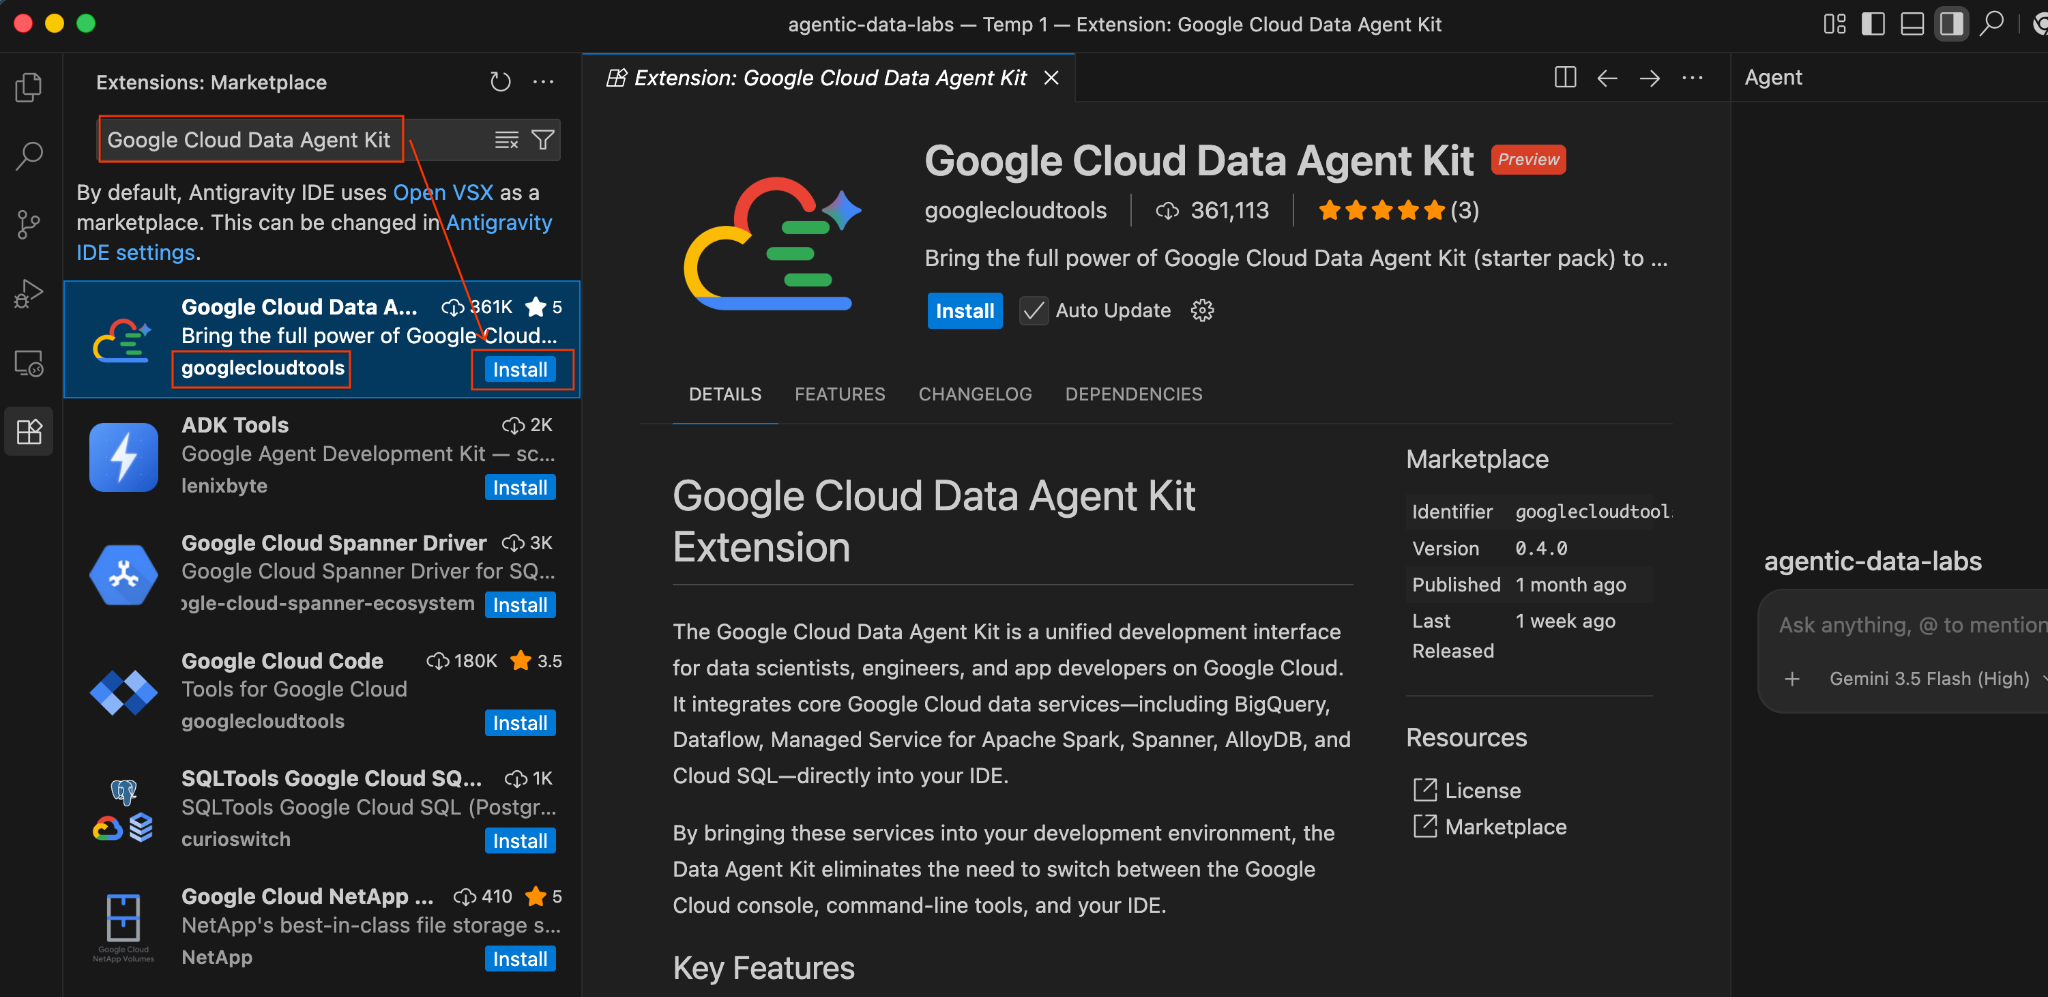
- 在 Antigravity IDE 中,點選畫面最左側活動列中的「擴充功能」圖示 (看起來像四個正方形)。
- 在「Extensions」窗格頂端的搜尋列中,輸入
Google Cloud Data Agent Kit。 - 找到
googlecloudtools發布的擴充功能「Google Cloud Data Agent Kit」。 - 按一下「Install」按鈕。
- 系統可能會顯示提示,詢問「您是否信任發布者『googlecloudtools』及其擴充功能?」。按一下「Trust Publishers & Install」繼續操作。
安裝完成後,Antigravity IDE 最左側的「活動列」會顯示新的「Google Cloud Data Agent Kit」圖示。
- 系統應會自動開啟名為「Welcome to Google Cloud Data Agent Kit」的新手上路頁面。如果未登入 Cloud 帳戶,請按照提示允許存取。
- 在「設定摘要」部分,找出專案欄位。按一下下拉式選單,選取 Google Cloud 專案。將區域設為 us-central1。然後選取「設定 MCP 伺服器」。
- 在專案中建立名為
GEMINI.md的新檔案,並貼上以下內容 (請務必將 <<YOUR_PROJECT_ID>> 替換為您的值):
## 1. Project Context
- **Project ID**: <<YOUR_PROJECT_ID>>
- **Domain**: This project is centralized around "Froyo", a brand of frozen yogurt offering multiple flavors.
- **Data**: All froyo, customer, order related information is processed and stored in BigQuery `froyo_data` dataset.

## 2. Execution & Data Processing Rules
- **CRITICAL RULE - Structured Specs**: The semantic and structured information extracted from the PDFs is available in a BigQuery dataset named `froyo_data`.
- **CRITICAL RULE - Customer Data**: Existing Froyo customer data resides in BigQuery in the tables `customers_allergen_data`.
- ** CRITICAL RULE - Sales Data**: Sales data is present in tables `orders` and `order_items`.
- ** CRITICAL RULE - General: When you are referencing a dataset, ensure you are using it with the dataset ID (`froyo_data`) . For example, to query orders table in this dataset you should use `froyo_data.orders`.
- **CRITICAL RULE - Allergen & Ingredient Mapping**: Never join `consistsof` directly to `containsallergen` on `ingredient_id`. The `consistsof` table often contains ingredient names (e.g. `Midnight Base 204`) while `containsallergen` maps CAS/code IDs (e.g. `9412-78-0`). Always bridge them through `froyo_data.ingredient` (`ON c.ingredient_id = i.ingredient_name OR c.ingredient_id = i.ingredient_id`) to accurately detect allergens.
現在,您可以在 IDE 中直接使用功能強大的 AI 代理,編寫程式碼、生成 SQL 及分析架構。
現在,我們面臨一項有趣的分析挑戰:能否將歷史銷售資料,與第 1 部分從 PDF 擷取的複雜推論過敏原資料建立關聯?
5. 透過 IDE 代理推論智慧
我們請 IDE 代理來處理繁重的工作。在 ANTIGRAVITY IDE 中開啟 Agent Data Kit 對話視窗,並輸入下列提示詞:
Does Midnight Swirl contain any allergen?
系統會要求一系列權限,請視情況允許。
最後,系統會在分析結束時為您擷取回覆:

太棒了!正確辨識出 Midnight Swirl 含有大豆。
現在來問一個稍微複雜的問題。在 Antigravity IDE 中傳送下列提示:
I want to see the top 5 most popular products purchased by
customers who have a registered 'Dairy' allergy.
回覆:

你可以繼續操作。試試下列提示詞:
Forecast the sales volume of our top non-dairy products
for the next 30 days based on historical data.
Agent Data Kit 會將正確的 CREATE MODEL 和 ML.FORECAST 程式碼放入編輯器,您不必查詢 BQML 語法。您可以直接在 BigQuery 環境中執行這項操作,不必離開 ANTIGRAVITY IDE!
太棒了!!!
6. BigQuery 對話式數據分析
開發人員喜歡 IDE,而企業使用者和主管則習慣使用 Cloud 控制台。他們不想看到 SQL,只想得到答案。
開始設定的方式如下:
- 為自己設定必要角色
前往專案的 IAM 頁面,並為自己授予 Gemini Data Analytics 資料分析資料代理擁有者角色:

這個角色可讓您建立、編輯、共用及刪除專案中的所有資料代理。
- 啟用必要的 API
前往 Google Cloud 控制台中的 BigQuery。使用側欄導覽選單或頁面頂端的搜尋選單,依序前往「BigQuery」>「代理」。
點選「啟用 Data Analytics API with Gemini」:

啟用 Gemini in BigQuery API 和 Gemini for Google Cloud API:

您現在應該會看到新代理頁面:

- 設定代理資訊
Agent Name:Froyo Agent
代理說明:協助回答優格冰淇淋產品、過敏原、成分、食譜、顧客、訂單、銷售相關問題。

- 前往「知識來源」部分,從資料集選取下列所有資料表:

a. 新增上圖中的表格,然後點選「新增來源」。
b. 按一下每個來源右側的「自訂」按鈕,您會看到以下表單:

c. 點選資料表說明的「接受」。
d. 請一併點選各欄位說明中的「接受」。

e. 點選「更新」。
您必須對來源中的所有資料表重複這項操作。
- 設定操作說明
將我們在 Antigravity IDE GEMINI.md 中使用的相同指令放在這裡:
1. Project Context
Project ID: <<YOUR_PROJECT_ID>>
Domain: This project is centralized around "Froyo", a brand of frozen yogurt offering multiple flavors.
Data: All froyo, customer, order related information is processed and stored in BigQuery froyo_data dataset. Use all the tables and data in the dataset for querying for user questions.
Context: Use Data Agent Kit skills wherever possible.
2. Execution & Data Processing Rules
CRITICAL RULE - Structured Specs: The semantic and structured information extracted from the PDFs is available in a BigQuery dataset named froyo_data.
CRITICAL RULE - Customer Data: Existing Froyo customer data resides in BigQuery in the tables customers_allergen_data. When you are referencing a dataset, ensure you are using it with the dataset ID (froyo_data) . For example, to query orders table in this dataset you should use froyo_data.orders.
- 儲存代理。
7. 與資料對話!
- 在右側的預覽區測試:

提出問題:
Does midnight swirl contain any allergen?

以下是回覆內容:

現在來問個複雜的問題:
I want to see the top 5 most popular products purchased by
customers who have a registered 'Dairy' allergy.
回覆:


現在來試試深入洞察提示:
Forecast the sales volume of our top non-dairy products
for the next 30 days based on historical data.
您可以看到它顯示使用的查詢,以及表格結果和圖表:


太棒了!因此,圖表和洞察資訊的成效良好。現在要問產品的終極問題。
8. 終極考驗
提出問題:
What will be the top most selling product of 2026


查看最後一項洞察。BigQuery 資料代理不只提供數字,還明確將銷售預測與庫存和原料供應鏈連結,而這些正是我們在第 1 部分從雜亂 PDF 擷取的資料!
9. 將代理發布至企業
按一下預覽代理頂端的「發布」按鈕。

Froyo 代理程式建構、設定及測試完畢後,就能發布給公司其他部門使用。
在代理設定頁面的右上角,按一下「發布」按鈕。
發布後,您和共用對象就能立即在三個強大的企業管道使用代理:
- BigQuery:資料分析師現在可以直接在代理中心或 BigQuery Studio SQL 工作區中,與這個代理對話。
- Conversational Analytics API:開發人員可透過 REST API 存取這個代理,將這些對話式數據分析功能整合至自訂內部網頁應用程式。
- 數據分析:主管可以直接在數據分析中與這個代理互動,建立動態對話式資訊主頁。
我們成功打破資料孤島,直接將資料提供給需要的人,而且就在他們的工作環境中!
按一下已發布 BigQuery 代理頂端的「分享」按鈕下拉式選單,然後從清單中選取「複製數據分析中的代理連結」選項:

將連結貼到瀏覽器,然後按下 Enter 鍵。確認代理互動存取權快訊:

您、主管和其他需要這項資訊的團隊,可以開始與新發布的代理進行互動式對話和視覺化。
10. 清除
完成本實驗室後,請務必移除所有使用者對剛才建立的 BigQuery 代理的權限。
11. 恭喜!
您已正式建構代理式資料雲端!
您不只建構了簡單的聊天機器人,在這五堂課程中,您成功從頭開始建構完整、現代化且經過評估的企業 AI 系統。您已從「暗資料」轉為即時交易智慧,最後再轉為對話式業務預測。
12. 完整資訊
回顧一下我們在本系列中達成的成果。我們不只打造了簡單的聊天機器人,我們建構了完整、現代化的代理式資料雲端:
第 1 部分:使用 Knowledge Catalog 將 PDF 轉換為結構化關聯資料表,解鎖暗資料。
第 2 部分:將分析型資料倉儲直接與 AlloyDB 交易資料庫聯合,打破資料孤島。
第 3 部分:建構多代理 OS,透過 MCP 通訊協定順暢執行安全的資料庫工具,為使用者提供更優質的體驗
第 4 部分:實施嚴格的評估管道,確保安全性,並找出幻覺和越獄行為。
第 5 部分:使用 ANTIGRAVITY IDE 和 BigQuery 對話式數據分析,讓所有人都能取得深入分析結果。
這就是企業軟體的未來。AI 代理不再只是 LLM 的包裝,這項引擎經過完整整合、評估且安全無虞,並建構於統合式資料平台之上。