

১. এক নজরে
আসুন, গত চারটি পর্বে আমরা যে বিশাল আর্কিটেকচার তৈরি করেছি তা এক ঝলকে দেখে নেওয়া যাক:
পার্ট ১: আমরা BigQuery নলেজ ক্যাটালগ ব্যবহার করে ফ্রোজেন ইয়োগার্ট রেসিপির কাঁচা পিডিএফকে স্ট্রাকচার্ড, রিলেশনাল টেবিলে রূপান্তরিত করেছি।
পার্ট ২: আমরা একটি জিরো-ETL ট্রানজ্যাকশনাল ব্রিজ তৈরি করেছি, যা আমাদের BigQuery ওয়্যারহাউসকে সরাসরি AlloyDB-তে ফেডারেট করে।
পার্ট ৩: আমরা Agent Development Kit এবং MCP টুলবক্স ব্যবহার করে একটি মাল্টি-এজেন্ট অ্যাপ্লিকেশন (FroyoOS) সাজিয়েছি।
পার্ট ৪: আমরা ডুয়াল-ট্র্যাক মূল্যায়ন পাইপলাইন তৈরি করে প্রমাণ করেছি যে আমাদের এজেন্ট প্রোডাকশনের জন্য নিরাপদ।
আমাদের অপারেশন কোনও সমস্যা ছাড়াই চলছে। কিন্তু ডেভেলপার এবং বিজনেস অ্যানালিস্টদের কী হবে যাদের এই সিস্টেমের তৈরি করা বিপুল পরিমাণ ডেটা বুঝতে হবে?
আজ আমরা অ্যানালিটিক্সের ভবিষ্যৎ নিয়ে আলোচনা করব। আমরা Google Cloud ডেটা এজেন্ট কিটের সাথে আমাদের কোড এডিটর Antigravity IDE-এর ঠিক ভিতরে শুরু করব এবং তারপরে BigQuery Conversational Analytics ব্যবহার করে আমাদের ডেটা ভিজ্যুয়ালাইজ করতে Google Cloud কনসোলে যাব।
তৈরি করা শুরু করা যাক!
আপনি কী শিখবেন
এজেন্টিক ডেটা ক্লাউড সিরিজের এই ফাইনাল কোডল্যাবে, আপনি অ্যাকশনেবল বিজনেস ইনসাইট প্রদান করার জন্য আপনার আর্কিটেকচারের সব অংশ একসাথে নিয়ে আসবেন। আপনি এগুলি শিখবেন:
- IDE-ফার্স্ট অ্যানালিটিক্স: আপনার ডেভেলপমেন্ট এনভায়রনমেন্ট থেকে সরাসরি আপনার আর্কিটেকচার কোয়েরি করার জন্য কীভাবে ANTIGRAVITY IDE এবং Google Cloud Data Agent Kit ইনস্টল ও কনফিগার করবেন।
- কনভারসেশনাল BigQuery: কীভাবে ন্যাচারাল ল্যাঙ্গুয়েজ ব্যবহার করে জটিল SQL টাস্ক ও ফোরকাস্টিং অটোমেট করার জন্য BigQuery ডেটা এজেন্ট তৈরি, কনফিগার ও নির্দেশ দিতে হয়।
- ডেটা ডেমোক্রেটাইজেশন: কীভাবে আপনার এজেন্টকে এন্টারপ্রাইজে প্রকাশ করবেন, যাতে পুরো সংস্থা জুড়ে অ্যানালিস্ট এবং ব্যবসায়িক ব্যবহারকারীরা তাদের অ্যাক্সেস করতে পারেন।
- ইনসাইট ভিজ্যুয়ালাইজ করা: ডায়নামিক, পূর্বাভাস-রেডি ড্যাশবোর্ড তৈরি করতে কীভাবে আপনার এজেন্টের কথোপকথন সংক্রান্ত অ্যানালিটিক্স Data Studio-তে নির্বিঘ্নে ইন্টিগ্রেট করবেন।
- এজেন্টিক ডেটা ক্লাউড ইকোসিস্টেম: আপনার এন্ড-টু-এন্ড আর্কিটেকচারের ভ্যালু কীভাবে প্রকাশ করবেন — পার্ট ১-এ কাঁচা অসংগঠিত ডেটা থেকে পার্ট ৫-এ এক্সিকিউটিভ-রেডি ড্যাশবোর্ড পর্যন্ত।
প্রয়োজনীয়তা
২. শুরু করার আগে
প্রোজেক্ট তৈরি করুন
- Google Cloud Console-এ, প্রোজেক্ট সিলেক্টর পৃষ্ঠায়, কোনও Google Cloud প্রোজেক্ট বেছে নিন বা তৈরি করুন।
- আপনার ক্লাউড প্রোজেক্টের জন্য বিলিং চালু করা আছে কিনা তা নিশ্চিত করুন। কীভাবে প্রোজেক্টে বিলিং চালু আছে কিনা তা চেক করবেন তা জানুন।
- আপনি Cloud Shell ব্যবহার করবেন, এটি Google Cloud-এ চলা একটি কমান্ড-লাইন এনভায়রনমেন্ট। Google Cloud Console-এর সবচেয়ে উপরে 'Cloud Shell চালু করুন' বিকল্পে ক্লিক করুন।
- Cloud Shell-এ কানেক্ট করার পরে, আপনি যাচাইকরণ করেছেন কিনা এবং নিম্নলিখিত কমান্ড ব্যবহার করে প্রোজেক্টটি আপনার প্রোজেক্ট আইডিতে সেট করা আছে কিনা তা চেক করুন:
gcloud auth list
- gcloud কমান্ড আপনার প্রোজেক্ট সম্পর্কে জানে কিনা তা কনফার্ম করতে Cloud Shell-এ নিম্নলিখিত কমান্ড রান করুন।
gcloud config list project
- আপনি যদি যাচাই করতে চান
gcloud auth login
- আপনার প্রোজেক্ট সেট করা না থাকলে, এটি সেট করতে এই কমান্ড ব্যবহার করুন:
export PROJECT_ID=<YOUR_PROJECT_ID>
gcloud config set project <YOUR_PROJECT_ID>
- প্রয়োজনীয় API চালু করুন: প্রয়োজনীয় সব API চালু করতে এই কমান্ড রান করুন:
gcloud services enable \
  alloydb.googleapis.com \
  bigquery.googleapis.com \
  run.googleapis.com \
  cloudbuild.googleapis.com \
  artifactregistry.googleapis.com \
  iam.googleapis.com \
  secretmanager.googleapis.com \
  compute.googleapis.com \
  servicenetworking.googleapis.com \
  aiplatform.googleapis.com
- এর জন্য প্রস্তুতি নিতে, আপনি ল্যাব পার্ট ১, পার্ট ২ এবং পার্ট ৩ সম্পূর্ণ করেছেন কিনা তা নিশ্চিত করুন:
ডেটাসেট তৈরি করা এবং টেবিল পপুলেট করা (শুধুমাত্র আপনি পার্ট ১ না করে থাকলে)
Cloud Shell-এ, নিম্নলিখিত কমান্ডগুলি রান করুন।
- প্রথমে, Cloud Shell Terminal থেকে নিচের কমান্ড রান করে BigQuery ডেটাসেট তৈরি করুন:
bq mk --location us-central1 --dataset froyo_data
- এরপর, নিচে উল্লেখ করা কমান্ডগুলি এক এক করে রান করে github রেপো থেকে আপনার ওয়ার্কিং ডিরেক্টরিতে ৮টি ডেটা ফাইল (csv ফাইল) ডাউনলোড করুন:
wget https://raw.githubusercontent.com/AbiramiSukumaran/raw-data-to-gold/refs/heads/main/data/froyo_data.allergen.csv
- আপনার নতুন তৈরি করা ডেটাসেটে ডেটা সহ এই টেবিলগুলি তৈরি করতে নিম্নলিখিত কমান্ডগুলি এক এক করে রান করুন
bq load --autodetect --source_format=CSV --skip_leading_rows=1 --allow_quoted_newlines --quote="" froyo_data.allergen ./froyo_data.allergen.csv allergen_name:STRING
bq load --autodetect --source_format=CSV --skip_leading_rows=1 --allow_quoted_newlines --quote="" froyo_data.consistsof ./froyo_data.consistsof.csv product_id:STRING,ingredient_id:STRING
bq load --autodetect --source_format=CSV --skip_leading_rows=1 --allow_quoted_newlines --quote="" froyo_data.containsallergen ./froyo_data.containsallergen.csv ingredient_id:STRING,allergen_name:STRING
bq load --autodetect --source_format=CSV --skip_leading_rows=1 --allow_quoted_newlines --quote="" froyo_data.froyo_data_materialized ./froyo_data.froyo_data_materialized.csv allergen:STRING,containsallergen:STRING,ingredient:STRING,product:STRING,suppliedby:STRING,supplier:STRING,ref:STRING,md5_hash:STRING
bq load --autodetect --source_format=CSV --skip_leading_rows=1 --allow_quoted_newlines --quote="" froyo_data.ingredient ./froyo_data.ingredient.csv ingredient_id:STRING,ingredient_name:STRING,purity:STRING,moisture_content:STRING,ph_range:STRING,specific_gravity_range:STRING
bq load --autodetect --source_format=CSV --skip_leading_rows=1 --allow_quoted_newlines --quote="" froyo_data.product ./froyo_data.product.csv product_id:STRING,product_name:STRING,category:STRING,stability:STRING
bq load --autodetect --source_format=CSV --skip_leading_rows=1 --allow_quoted_newlines --quote="" froyo_data.suppliedby ./froyo_data.suppliedby.csv ingredient_id:STRING,supplier_id:STRING
bq load --autodetect --source_format=CSV --skip_leading_rows=1 --allow_quoted_newlines --quote="" froyo_data.supplier ./froyo_data.supplier.csv supplier_id:STRING,supplier_name:STRING,production_site_id:STRING,facility_grade:STRING
৩. ডেটা ওয়্যারহাউস বাড়ানো হচ্ছে
আমাদের আনস্ট্রাকচার্ড ডেটা থেকে তৈরি করা BigQuery টেবিলগুলি মনে আছে?
কিছু অর্থপূর্ণ বিশ্লেষণ করতে, আমাদের ঐতিহাসিক ট্রানজ্যাকশন ডেটা প্রয়োজন। BigQuery-তে, আমাদের froyo_data ডেটাসেটের অধীনে, আসুন বছরের পর বছর ফ্র্যাঞ্চাইজি অপারেশন সিমুলেট করার জন্য তিনটি নতুন টেবিল তৈরি করি:
- froyo_data.orders: পুরনো অর্ডারের হেডার (তারিখ, স্টোর আইডি, মোট)
- froyo_data.order_items: লাইন-আইটেমের বিবরণ (পরিমাণ, দাম)
- froyo_data.customer_allergen_data: একটি CRM টেবিল যা আমাদের অনুগত গ্রাহকদের পরিচিত অ্যালার্জি ট্র্যাক করে
আমাদের অ্যানালিটিক্স ব্যবহারের কেস প্রস্তুত করার জন্য, আসুন এই সেলস ও গ্রাহক সম্পর্কিত টেবিলগুলি সেই ডেটাসেটে যোগ করি।
- আপনার Google Cloud Console থেকে Cloud Shell Terminal-এ যান।
- আপনার ওয়ার্কস্পেসের রুট ফোল্ডার বা froyo-data প্রোজেক্ট রুট ফোল্ডারে (এই সিরিজের গত কয়েকটি অংশে আমরা যেটির উপর কাজ করছি) নেভিগেট করুন।
- নিম্নলিখিত কমান্ডগুলি একটির পর একটি রান করে আপনার ওয়ার্কিং ডিরেক্টরিতে ৩টি ঐতিহাসিক ডেটা ফাইল (csv ফাইলে) ডাউনলোড করুন:
wget https://raw.githubusercontent.com/AbiramiSukumaran/froyo-data/main/customer_allergen_data.csv
wget https://raw.githubusercontent.com/AbiramiSukumaran/froyo-data/main/order_items.csv
wget https://raw.githubusercontent.com/AbiramiSukumaran/froyo-data/main/orders.csv
- আপনার ওয়ার্কিং ডিরেক্টরির রুটে সেইসব ফাইল দেখতে পেলে, টার্মিনালে টগল করে আপনার Cloud Shell Terminal-এ নেভিগেট করুন।
- আপনার Cloud Shell Terminal-এ এই ৩টি ফাইল যে ডিরেক্টরিতে আছে সেখানে যান।
- আপনার BigQuery-তে এই সিরিজের পার্ট ১ থেকে "froyo_data" নামের ডেটাসেট আছে কিনা তা নিশ্চিত করুন (যদি না থাকে, তাহলে ফিরে যান এবং ডেটাসেট ও টেবিল তৈরি করুন)।
- আপনার Cloud Shell Terminal থেকে নিম্নলিখিত কমান্ডগুলি রান করুন:
bq load \
  --autodetect \
  --source_format=CSV \
  --skip_leading_rows=1 \
  --allow_quoted_newlines \
  --quote="" \
  froyo_data.orders \
  ./orders.csv
bq load \
  --autodetect \
  --source_format=CSV \
  --skip_leading_rows=1 \
  --allow_quoted_newlines \
  --quote="" \
  froyo_data.order_items \
  ./order_items.csv
bq load \
  --autodetect \
  --source_format=CSV \
  --skip_leading_rows=1 \
  --allow_quoted_newlines \
  --quote="" \
  froyo_data.customer_allergen_data \
  ./customer_allergen_data.csv
এটি আপনার froyo_data ডেটাসেটে ৩টি অতিরিক্ত টেবিল তৈরি করবে।
৪. ডেভেলপার অভিজ্ঞতা — "ডেটা এজেন্ট কিট" লিখুন
সাধারণত, কোনও ডেভেলপার ডেটা বিশ্লেষণ করতে বা জটিল মেশিন লার্নিং কোয়েরি লিখতে চাইলে, তাকে ক্রমাগত IDE, ডেটাবেস কনসোল এবং ডকুমেন্টেশনের মধ্যে কনটেক্সট পরিবর্তন করতে হয়।
আর নয়। নতুন লঞ্চ করা Google Cloud Data Agent Kit এক্সটেনশনের মাধ্যমে, আপনার IDE একটি ডেটা পাওয়ারহাউস হয়ে ওঠে। Google Cloud Data Agent Kit এক্সটেনশন সরাসরি আপনার এডিটরের মধ্যে Google Cloud ডেটা পরিষেবার সাথে গভীর ইন্টিগ্রেশন প্রদান করে, যা আপনাকে প্রসঙ্গ পরিবর্তন না করেই BigQuery, Cloud SQL, Cloud Storage এবং আরও অনেক কিছুর সাথে ইন্টার্যাক্ট করার সুবিধা দেয়।
পূর্বশর্ত
- Node.js (লেটেস্ট সাজেস্ট করা হয়েছে)
- gcloud CLI ইনস্টল করুন।
- আপনার Google Cloud অ্যাকাউন্ট দিয়ে লগ-ইন করুন:
gcloud auth login
- অ্যাপ্লিকেশন ডিফল্ট ক্রেডেনশিয়াল (ADC)-এ লগ-ইন করুন:
gcloud auth application-default login
Antigravity IDE
Antigravity IDE হল Google-এর পরবর্তী-জেনারেশন, এজেন্ট-ফার্স্ট ডেভেলপমেন্ট এনভায়রনমেন্ট যা বিশেষভাবে AI যুগের জন্য ডিজাইন করা হয়েছে। এটি নেটিভভাবে বিশাল মাল্টি-মোডাল কনটেক্সট উইন্ডো এবং অটোনোমাস টুলের ব্যবহার সরাসরি এডিটরে ইন্টিগ্রেট করে, যা ডেভেলপারদের তাদের কোড না ছেড়েই ক্লাউড রিসোর্স এবং জটিল ডেটা পাইপলাইন অর্কেস্ট্রেট করতে দেয়।
Antigravity IDE সেট-আপ করা
- Google Antigravity ডাউনলোড পৃষ্ঠা থেকে Antigravity IDE ডাউনলোড ও ইনস্টল করুন।
- ইনস্টল ও লঞ্চ করা: ইনস্টলার রান করুন এবং Antigravity IDE খুলুন।
- 'Google-এর মাধ্যমে চালিয়ে যান' বিকল্পে ক্লিক করে আপনার Gmail অ্যাকাউন্ট বেছে নিন এবং অনুমতি দিন।
- প্রাথমিক কনফিগারেশনগুলি দেখুন। মনে রাখবেন: আপনি পরে যেকোনও সময় সেটিংস থেকে এগুলি আপডেট করতে পারবেন।
- আপনার লোকাল মেশিনে একটি নতুন, খালি ফোল্ডার তৈরি করুন (যেমন,
agentic-data-labsনামে) এবং 'ফোল্ডার খুলুন' বিকল্প বেছে নিয়ে IDE-তে এটি খুলুন। এটি কোডল্যাবের জন্য আপনার লোকাল ওয়ার্কস্পেস হিসেবে কাজ করবে।
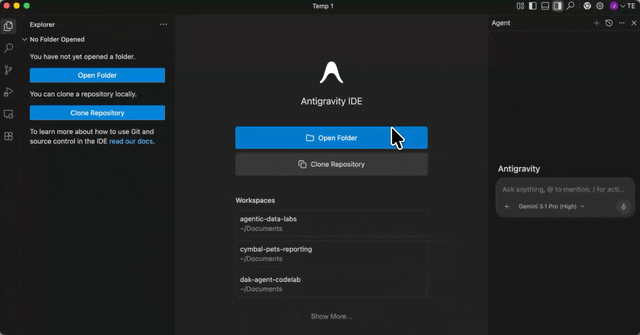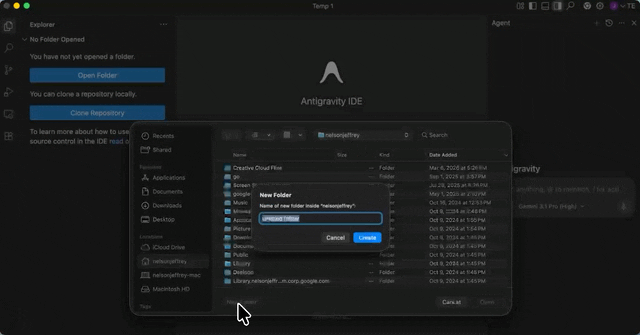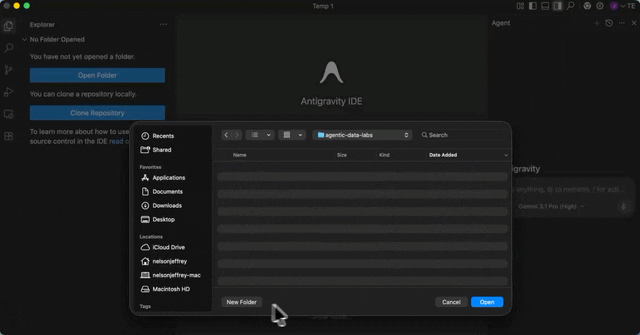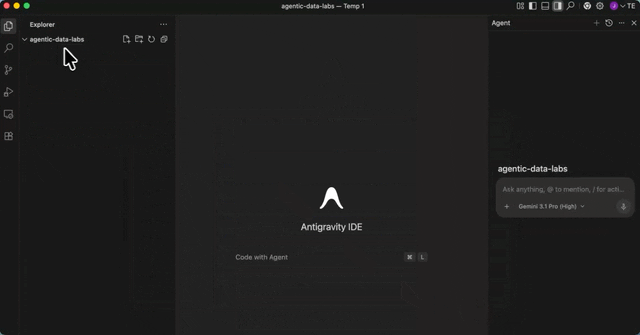
ডানদিকে আপনি এজেন্ট প্যান, বাঁদিকে প্রোজেক্ট এক্সপ্লোরার এবং মাঝখানে আপনার ডেভেলপমেন্টের জন্য জায়গা দেখতে পাবেন।
Data Agent Kit এক্সটেনশন ইনস্টল করুন
Google Cloud Data Agent Kit এক্সটেনশন সরাসরি আপনার এডিটরের মধ্যে Google Cloud ডেটা পরিষেবার সাথে গভীর ইন্টিগ্রেশন প্রদান করে, যা আপনাকে প্রসঙ্গ পরিবর্তন না করেই BigQuery, Cloud SQL, Cloud Storage এবং আরও অনেক কিছুর সাথে ইন্টার্যাক্ট করার সুবিধা দেয়।
- Antigravity IDE-তে, স্ক্রিনের একেবারে বাঁদিকে অ্যাক্টিভিটি বারে এক্সটেনশন আইকনে ক্লিক করুন (এটি চারটি বর্গক্ষেত্রের মতো দেখায়)।
- এক্সটেনশন প্যানেলের সবচেয়ে উপরে সার্চ বারে
Google Cloud Data Agent Kitটাইপ করুন। googlecloudtools-এর মাধ্যমে প্রকাশিত Google Cloud Data Agent Kit নামের এক্সটেনশনটি খুঁজুন।- ইনস্টল করুন বোতামে ক্লিক করুন।
- "আপনি কি প্রকাশক ‘googlecloudtools' এবং তাদের এক্সটেনশনকে বিশ্বাস করেন?" জিজ্ঞাসা করে একটি প্রম্পট দেখানো হতে পারে। এগিয়ে যেতে প্রকাশককে বিশ্বাস করুন এবং ইনস্টল করুন বিকল্পে ক্লিক করুন।
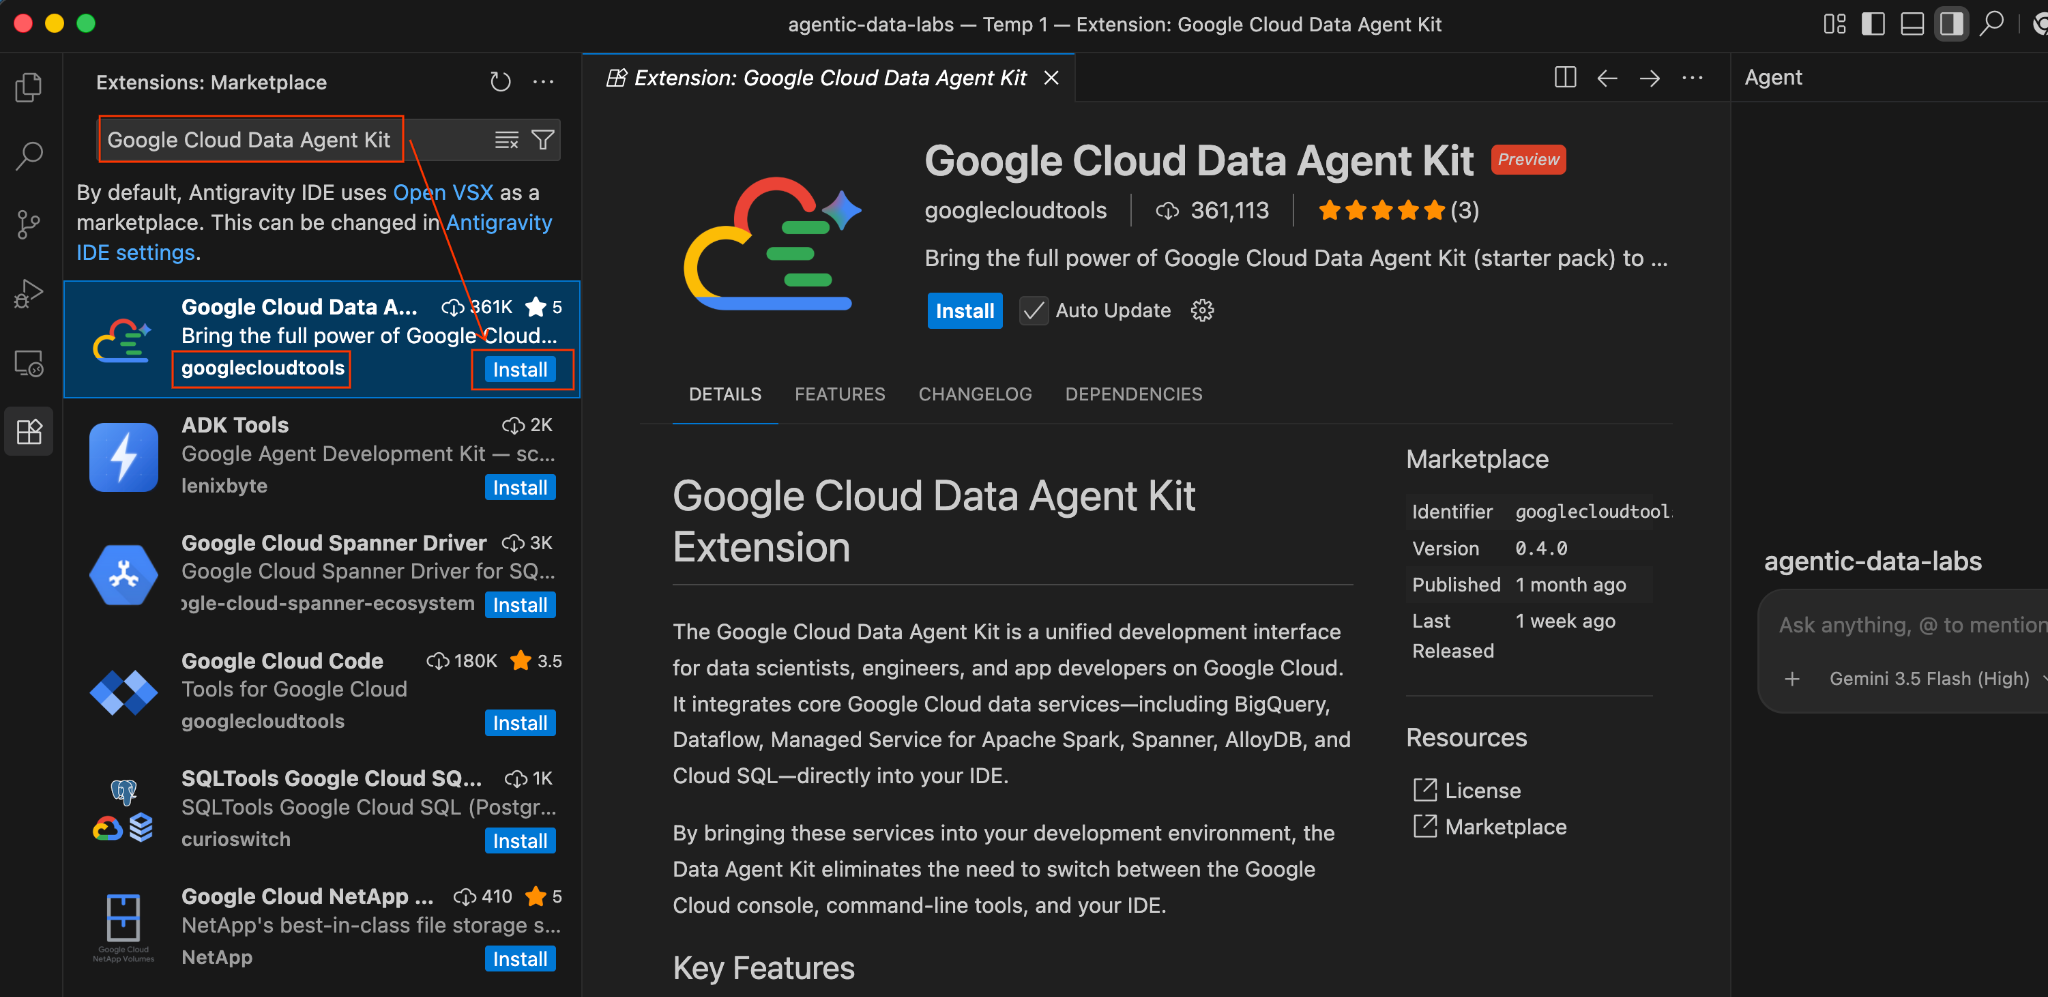
ইনস্টল করা হয়ে গেলে, Antigravity IDE-এর একেবারে বাঁদিকে অ্যাক্টিভিটি বারে একটি নতুন Google Cloud Data Agent Kit আইকন দেখতে পাবেন।
- "Google Cloud Data Agent Kit-এ স্বাগতম" শীর্ষক অনবোর্ডিং পৃষ্ঠা অটোমেটিক খুলে যাবে। আপনি Cloud অ্যাকাউন্টে সাইন-ইন না করে থাকলে, অ্যাক্সেসের অনুমতি দিতে যেকোনও প্রম্পট অনুসরণ করুন।
- কনফিগারেশন সারসংক্ষেপ বিভাগে, প্রোজেক্ট ফিল্ডটি খুঁজুন। ড্রপডাউনে ক্লিক করে আপনার Google Cloud প্রোজেক্ট বেছে নিন। আপনার অঞ্চল us-central1 হিসেবে সেট করুন। তারপর MCP সার্ভার কনফিগার করুন বিকল্প বেছে নিন।
- আপনার প্রোজেক্টে
GEMINI.mdনামের একটি নতুন ফাইলে নিম্নলিখিত কোডটি পেস্ট করুন (<<YOUR_PROJECT_ID>> আপনার প্রোজেক্ট আইডি দিয়ে পরিবর্তন করতে ভুলবেন না):
## 1. Project Context
- **Project ID**: <<YOUR_PROJECT_ID>>
- **Domain**: This project is centralized around "Froyo", a brand of frozen yogurt offering multiple flavors.
- **Data**: All froyo, customer, order related information is processed and stored in BigQuery `froyo_data` dataset.

## 2. Execution & Data Processing Rules
- **CRITICAL RULE - Structured Specs**: The semantic and structured information extracted from the PDFs is available in a BigQuery dataset named `froyo_data`.
- **CRITICAL RULE - Customer Data**: Existing Froyo customer data resides in BigQuery in the tables `customers_allergen_data`.
- ** CRITICAL RULE - Sales Data**: Sales data is present in tables `orders` and `order_items`.
- ** CRITICAL RULE - General: When you are referencing a dataset, ensure you are using it with the dataset ID (`froyo_data`) . For example, to query orders table in this dataset you should use `froyo_data.orders`.
- **CRITICAL RULE - Allergen & Ingredient Mapping**: Never join `consistsof` directly to `containsallergen` on `ingredient_id`. The `consistsof` table often contains ingredient names (e.g. `Midnight Base 204`) while `containsallergen` maps CAS/code IDs (e.g. `9412-78-0`). Always bridge them through `froyo_data.ingredient` (`ON c.ingredient_id = i.ingredient_name OR c.ingredient_id = i.ingredient_id`) to accurately detect allergens.
এখন, আপনার IDE-তে সরাসরি অত্যন্ত দক্ষ AI এজেন্ট রয়েছে, যা কোড লিখতে, SQL তৈরি করতে এবং আপনার আর্কিটেকচার বিশ্লেষণ করতে প্রস্তুত।
আমাদের কাছে এখন একটি আকর্ষণীয় বিশ্লেষণাত্মক চ্যালেঞ্জ রয়েছে: আমরা কি আমাদের ঐতিহাসিক বিক্রির সাথে জটিল, অনুমান করা অ্যালার্জেন ডেটা সম্পর্কযুক্ত করতে পারি যা আমরা পার্ট ১-এ পিডিএফ থেকে এক্সট্র্যাক্ট করেছি?
৫. IDE এজেন্টের মাধ্যমে ইনটেলিজেন্স অনুমান করা
আসুন, আমাদের IDE এজেন্টকে কঠিন কাজ করতে বলি। আপনার ANTIGRAVITY IDE-এর মধ্যে Agent Data Kit চ্যাট উইন্ডো খুলুন এবং নিম্নলিখিত প্রম্পট দিন:
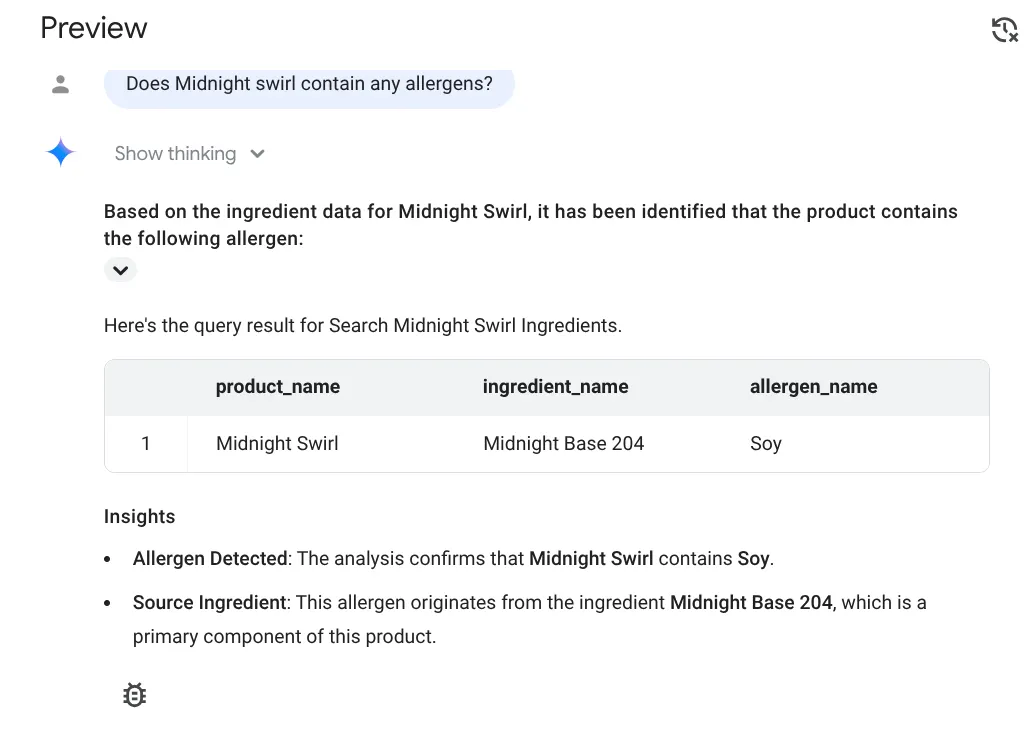
Does Midnight Swirl contain any allergen?
এটি একাধিক অনুমতি চাইবে, প্রযোজ্য হলে অনুমতি দিন।
অবশেষে, এটি বিশ্লেষণ শেষ করে আপনার জন্য উত্তর নিয়ে আসবে:
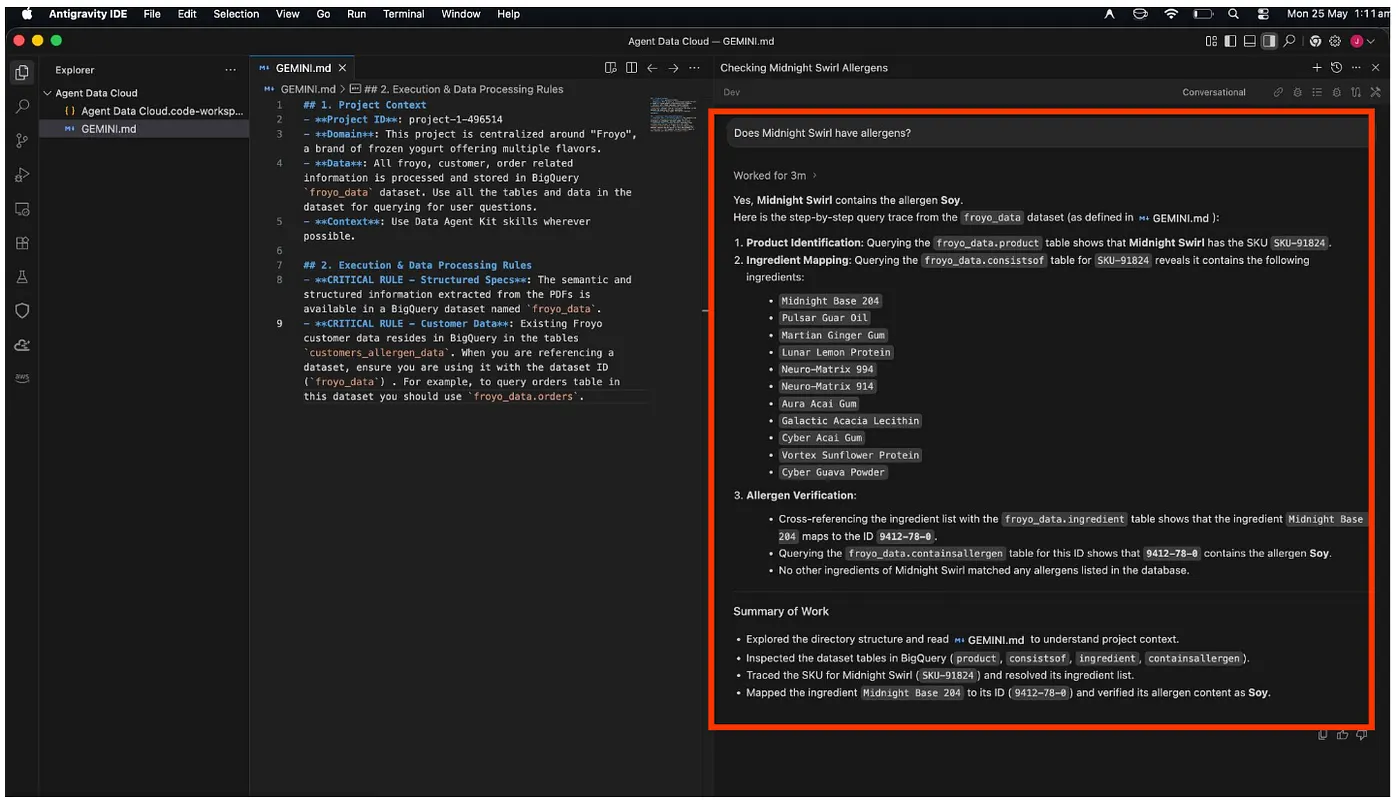
অসাধারণ!!! এটি সঠিকভাবে শনাক্ত করেছে যে মিডনাইট সোয়ার্ল আইটেমে সয়াবিন আছে।
এবার একটু জটিল প্রশ্ন করা যাক। Antigravity IDE-তে নিম্নলিখিত প্রম্পট পাঠান:
I want to see the top 5 most popular products purchased by
customers who have a registered 'Dairy' allergy.
উত্তর:
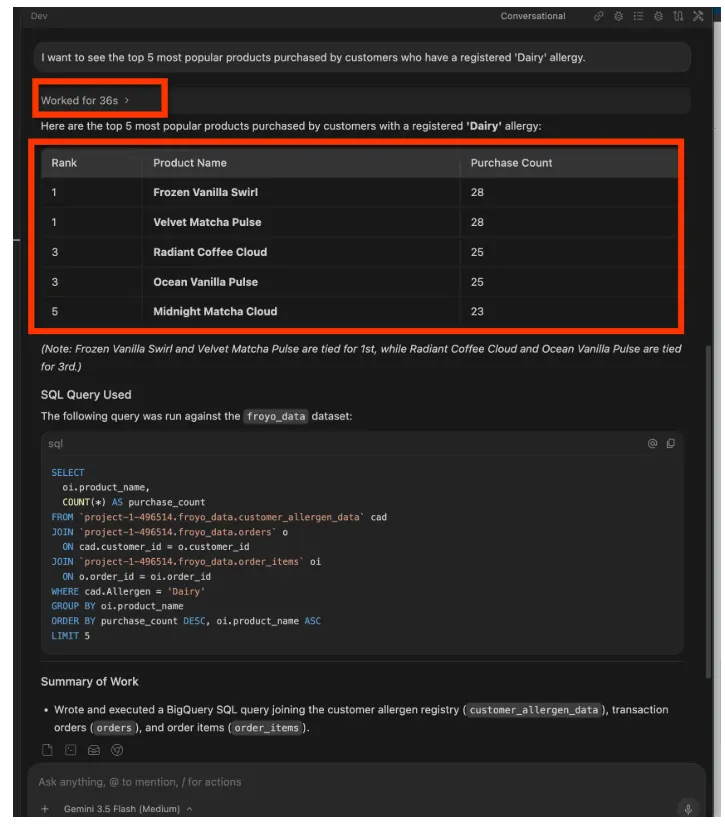
আপনি চালিয়ে যেতে পারেন। এই ধরনের প্রম্পট ব্যবহার করে দেখুন:
Forecast the sales volume of our top non-dairy products
for the next 30 days based on historical data.
BQML সিনট্যাক্স না দেখেই, Agent Data Kit আপনার এডিটরে সঠিক CREATE MODEL এবং ML.FORECAST কোড ড্রপ করে। ANTIGRAVITY IDE থেকে না বেরিয়েই আপনার BigQuery এনভায়রনমেন্টে সরাসরি এটি এক্সিকিউট করতে পারবেন!
কী দারুণ!!!
৬. BigQuery-তে Conversational Analytics
ডেভেলপাররা IDE পছন্দ করলেও, ব্যবসায়িক ব্যবহারকারী এবং এক্সিকিউটিভরা ক্লাউড কনসোল ব্যবহার করেন। তারা SQL দেখতে চায় না, শুধু উত্তর চায়।
আসুন শুরু করা যাক:
- নিজেকে প্রয়োজনীয় ভূমিকা দেওয়া
প্রোজেক্টের IAM পৃষ্ঠায় নেভিগেট করুন এবং নিজেকে Gemini Data Analytics ডেটা এজেন্ট মালিকের ভূমিকা দিন:
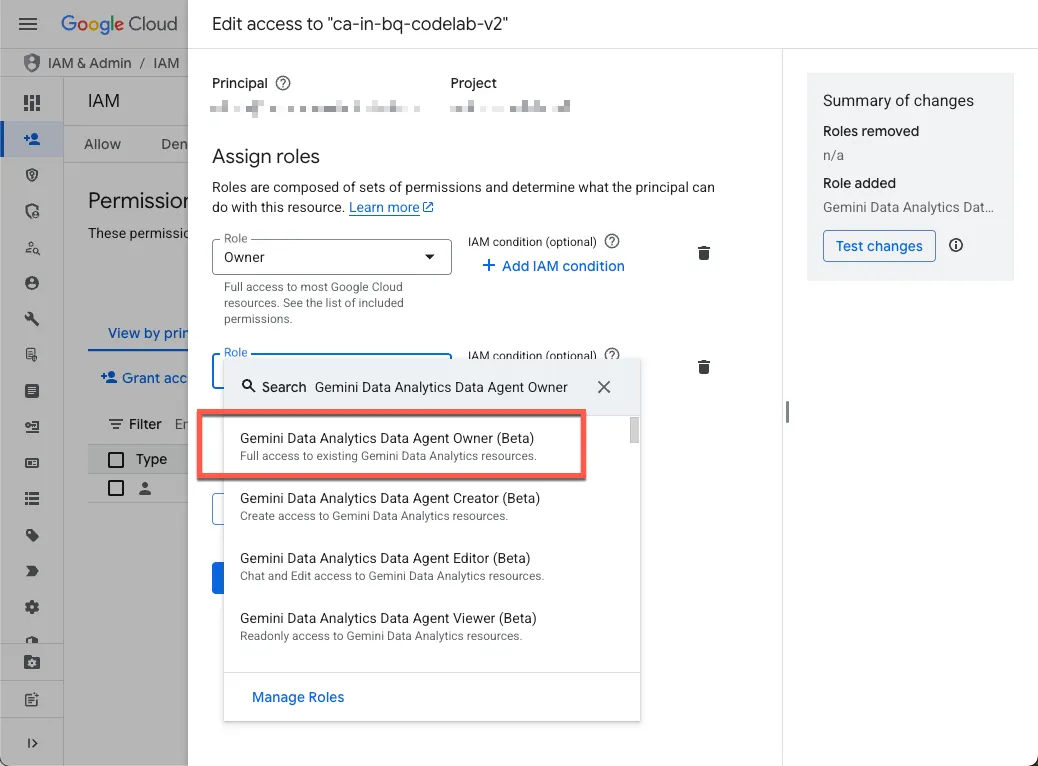
এই ভূমিকা আপনাকে প্রোজেক্টের সব ডেটা এজেন্ট তৈরি, এডিট, শেয়ার ও মুছে ফেলার অনুমতি দেয়।
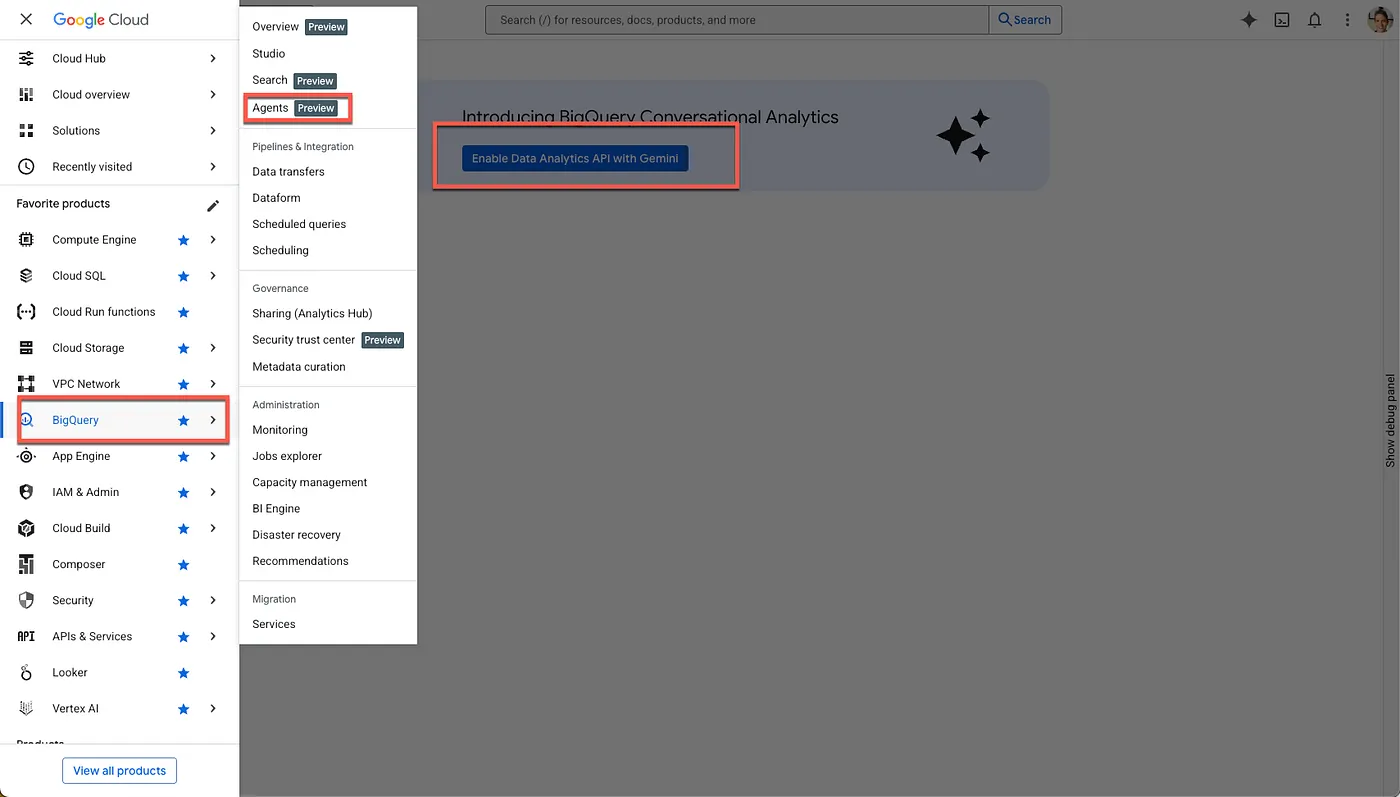
- প্রয়োজনীয় API চালু করুন
Google Cloud Console-এ BigQuery-তে যান। BigQuery > এজেন্ট বিকল্পে নেভিগেট করতে, পৃষ্ঠার উপরে সাইডবার নেভিগেশন মেনু বা সার্চ মেনু ব্যবহার করুন।
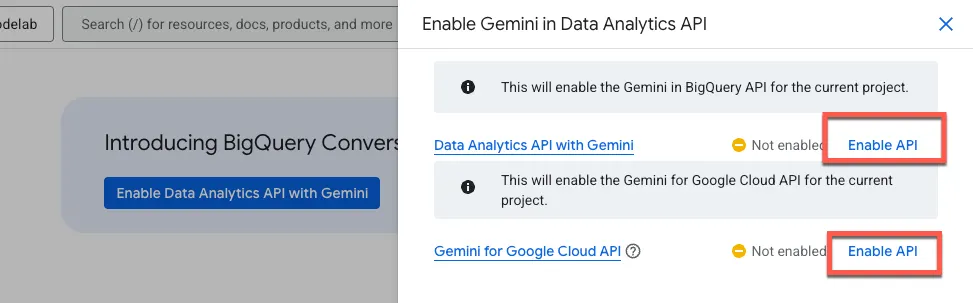
Gemini-র সাথে Data Analytics API চালু করুন বিকল্পে ক্লিক করুন:
BigQuery API-তে Gemini এবং Google Cloud API-এর জন্য Gemini, দুটিই চালু করুন:
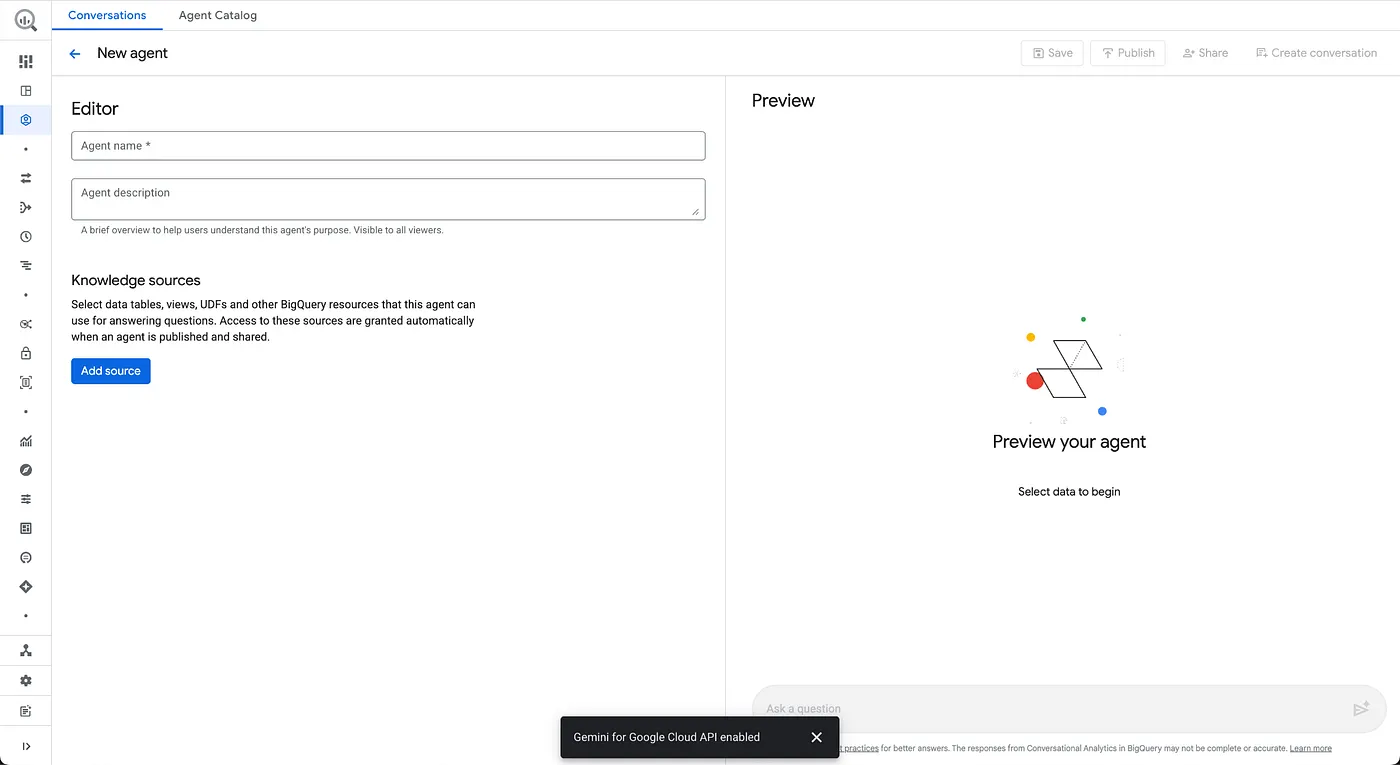
আপনি এখন নতুন এজেন্ট পৃষ্ঠা দেখতে পাবেন:
- এজেন্ট সংক্রান্ত তথ্য কনফিগার করুন
এজেন্টের নাম: Froyo Agent
এজেন্টের বিবরণ: ফ্রোজেন ইয়োগার্ট প্রোডাক্ট, অ্যালার্জেন, উপকরণ, রেসিপি, গ্রাহক,অর্ডার,বিক্রি সংক্রান্ত প্রশ্নের উত্তর দিতে সাহায্য করে।
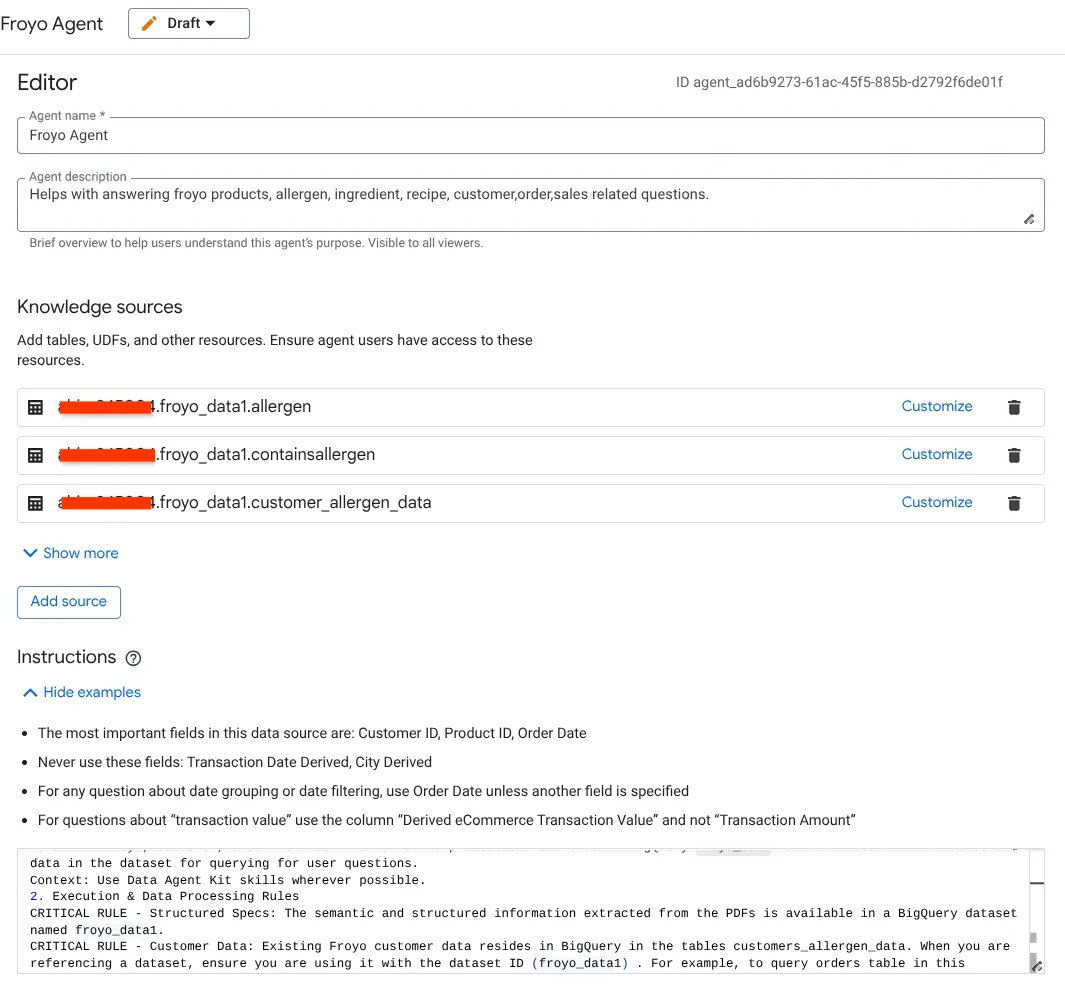
- নলেজ সোর্স বিভাগে যান এবং আপনার ডেটাসেট থেকে নিচের সব টেবিল বেছে নিন:
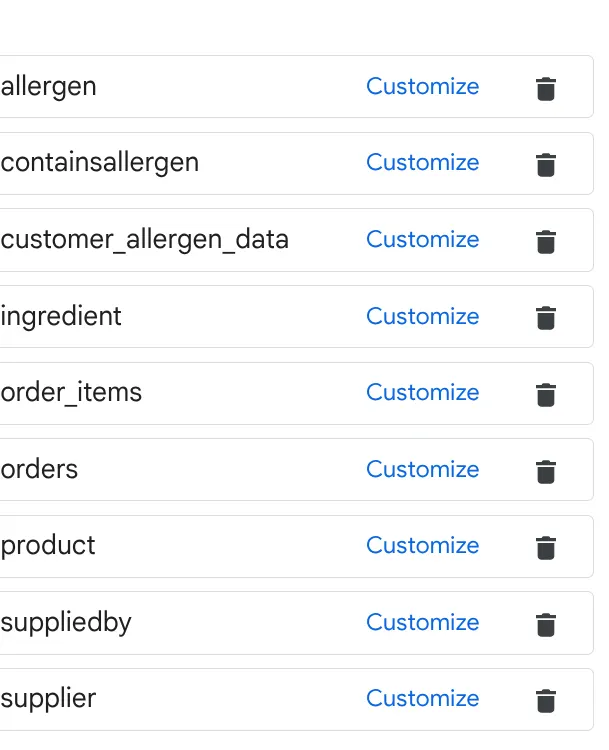
ক. উপরের ছবিতে দেখানো টেবিল যোগ করুন এবং 'সোর্স যোগ করুন' বিকল্পে ক্লিক করুন।
খ. প্রতিটি সোর্সের জন্য, ডানদিকে কাস্টমাইজ করুন বোতামে ক্লিক করুন। আপনি নিচে দেওয়া ফর্মটি দেখতে পাবেন:
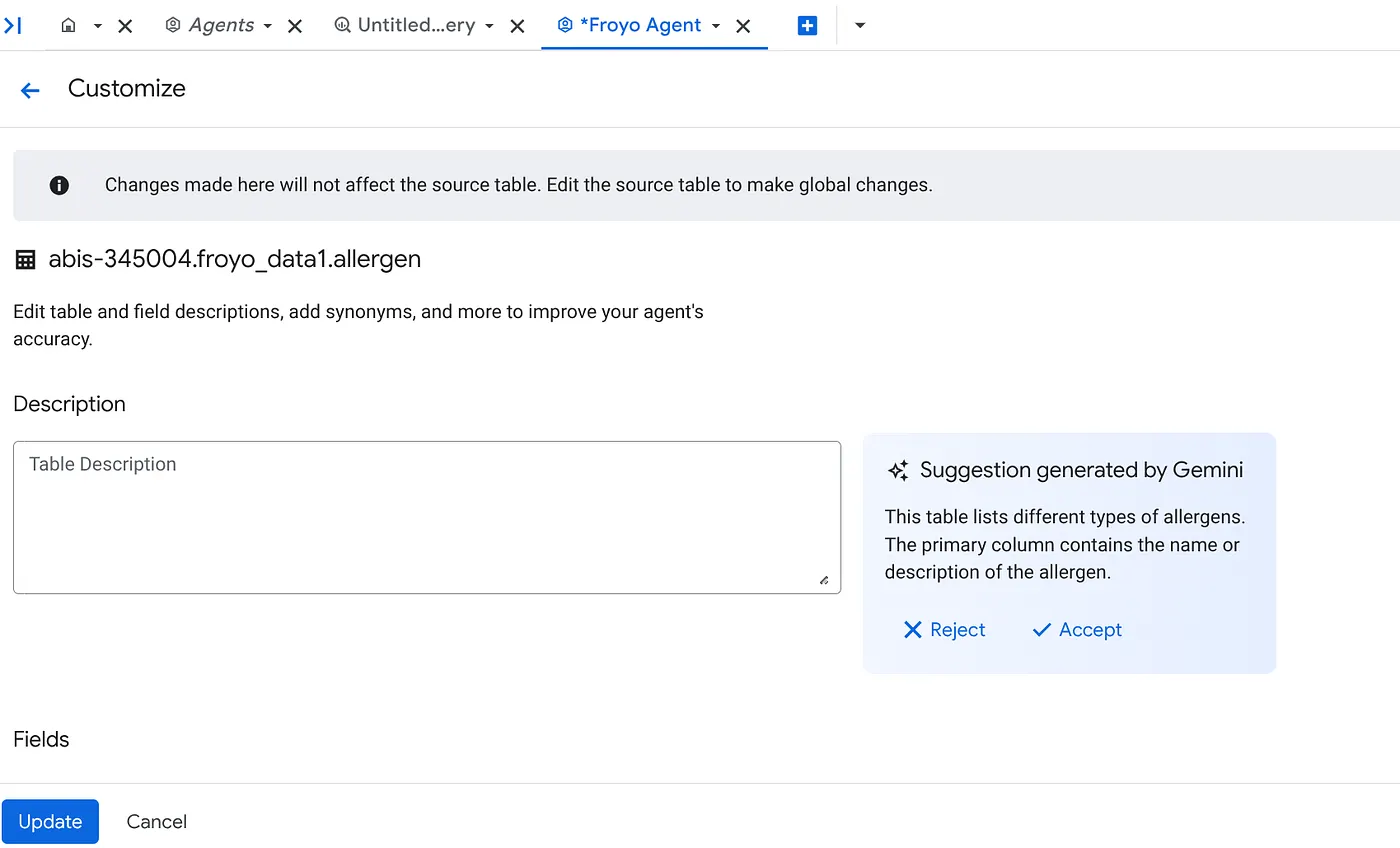
গ. টেবিলের বিবরণের জন্য "সম্মতি দিন" বিকল্পে ক্লিক করুন।
ঘ. এছাড়াও, প্রতিটি ফিল্ডের বিবরণের জন্য "সম্মতি দিন" বিকল্পে ক্লিক করুন।
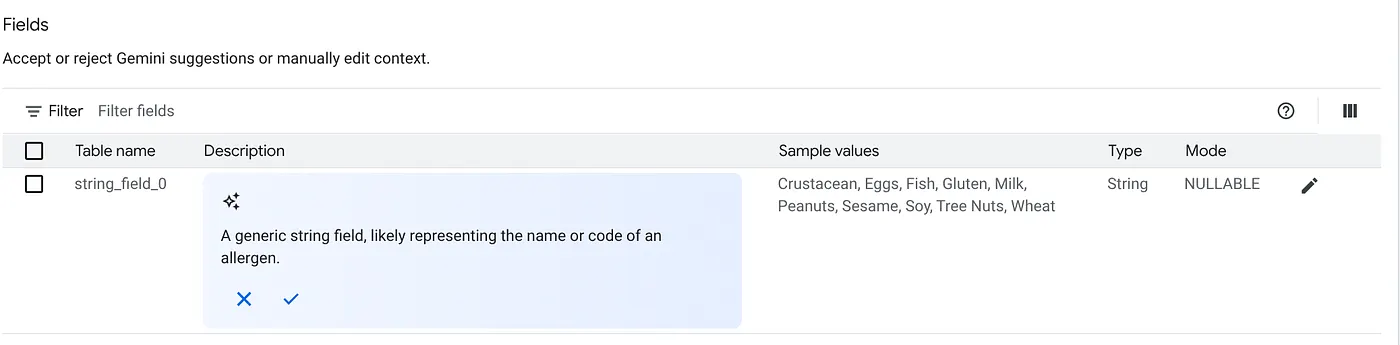
e. 'আপডেট করুন' বোতামে ক্লিক করুন।
সোর্সের সব টেবিলের জন্য আপনাকে এটি করতে হবে।
- নির্দেশাবলী কনফিগার করা
Antigravity IDE GEMINI.md-তে আমরা যে নির্দেশাবলী ব্যবহার করেছি, এখানেও একই নির্দেশাবলী দিন:
1. Project Context
Project ID: <<YOUR_PROJECT_ID>>
Domain: This project is centralized around "Froyo", a brand of frozen yogurt offering multiple flavors.
Data: All froyo, customer, order related information is processed and stored in BigQuery froyo_data dataset. Use all the tables and data in the dataset for querying for user questions.
Context: Use Data Agent Kit skills wherever possible.
2. Execution & Data Processing Rules
CRITICAL RULE - Structured Specs: The semantic and structured information extracted from the PDFs is available in a BigQuery dataset named froyo_data.
CRITICAL RULE - Customer Data: Existing Froyo customer data resides in BigQuery in the tables customers_allergen_data. When you are referencing a dataset, ensure you are using it with the dataset ID (froyo_data) . For example, to query orders table in this dataset you should use froyo_data.orders.
- আপনার এজেন্ট সেভ করুন।
৭. আপনার ডেটার সাথে চ্যাট করুন!
- ডানদিকে প্রিভিউ বিভাগে এটি পরীক্ষা করে দেখুন:
আপনার প্রশ্ন জিজ্ঞাসা করুন:
Does midnight swirl contain any allergen?
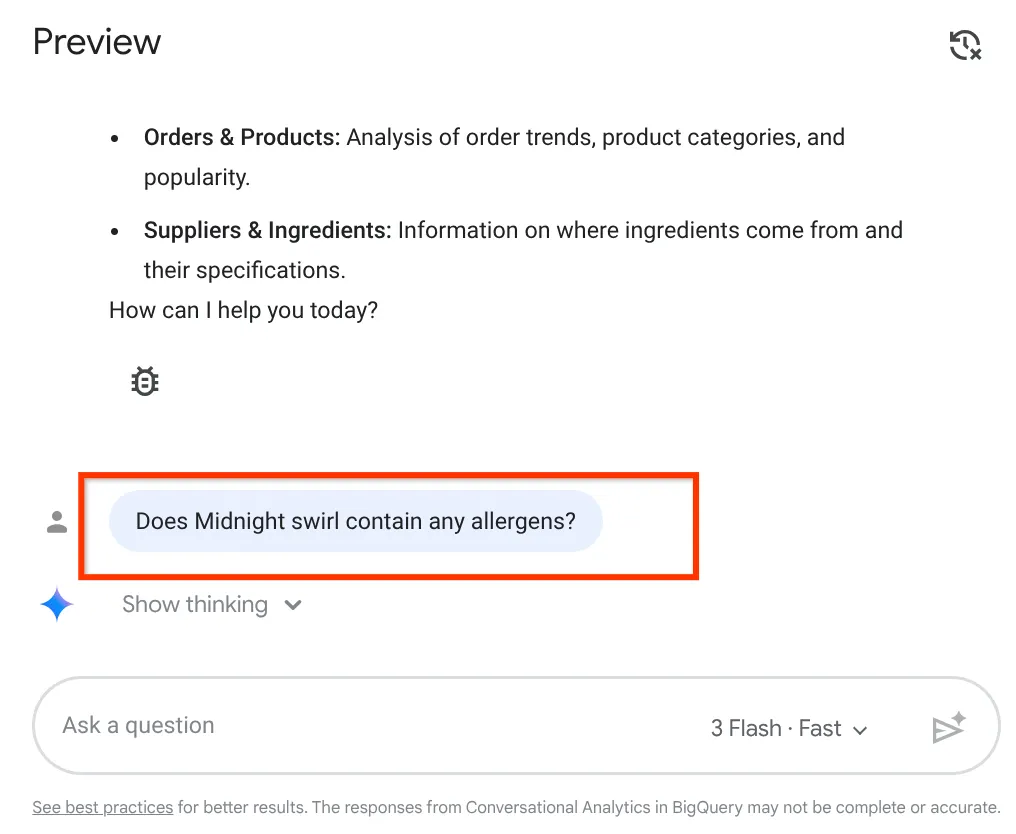
এখানে উত্তর দেওয়া হল:
এবার জটিল প্রশ্নটা করা যাক:
I want to see the top 5 most popular products purchased by
customers who have a registered 'Dairy' allergy.
উত্তর:
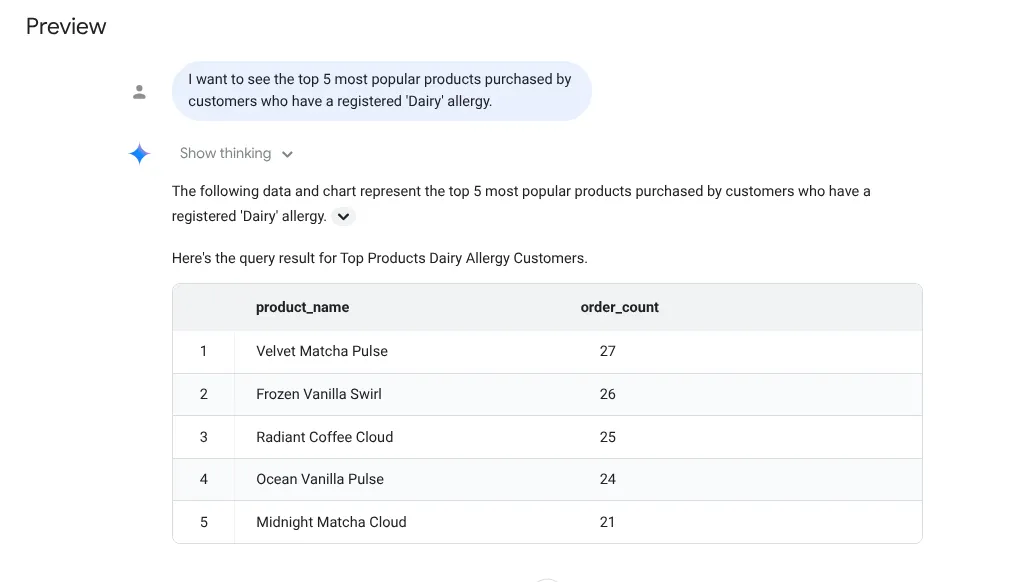
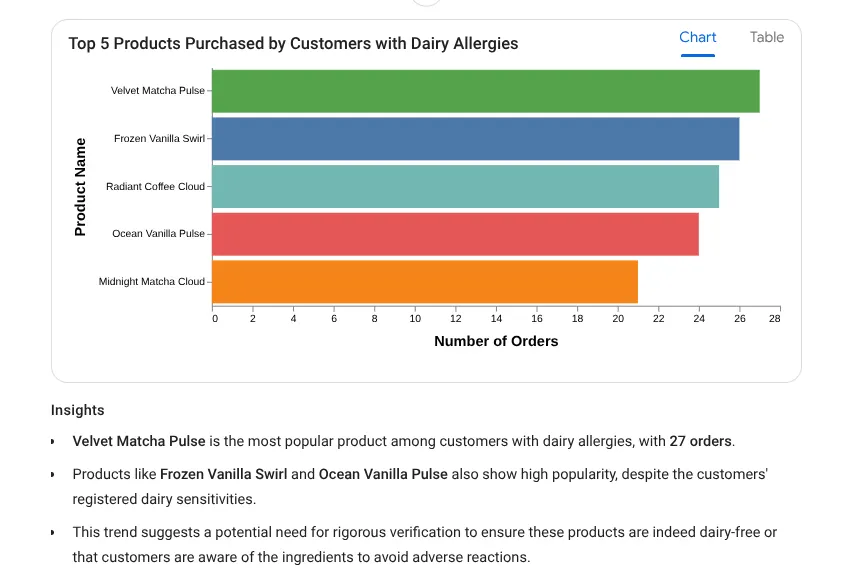
এখন গভীর ইনসাইট সংক্রান্ত প্রম্পট ব্যবহার করে দেখা যাক:
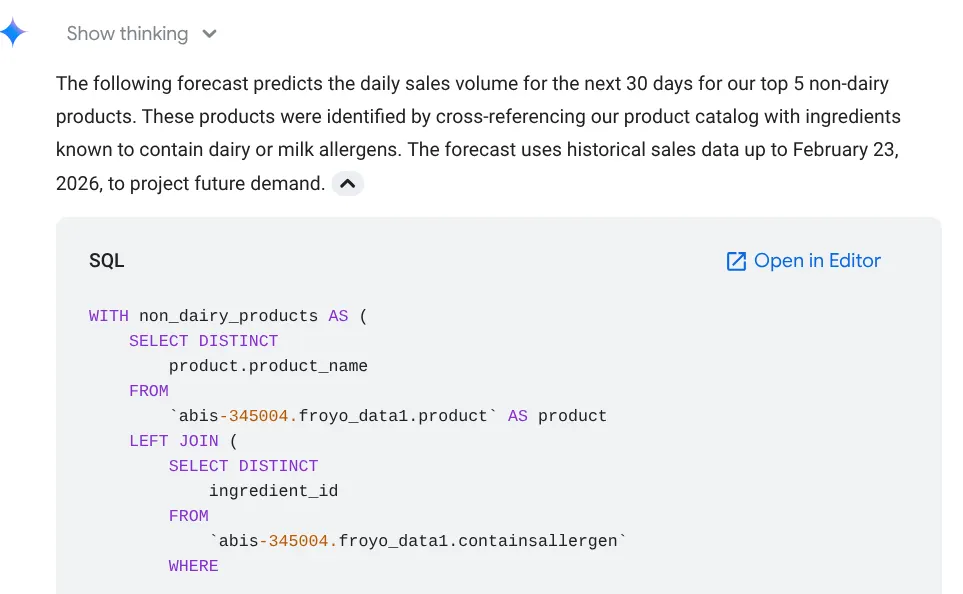
Forecast the sales volume of our top non-dairy products
for the next 30 days based on historical data.
আপনি দেখতে পাবেন যে এটি আপনাকে যে কোয়েরি ব্যবহার করে তা দেখায়, সাথে চার্টের সাথে টেবিল ফলাফলও দেখায়:
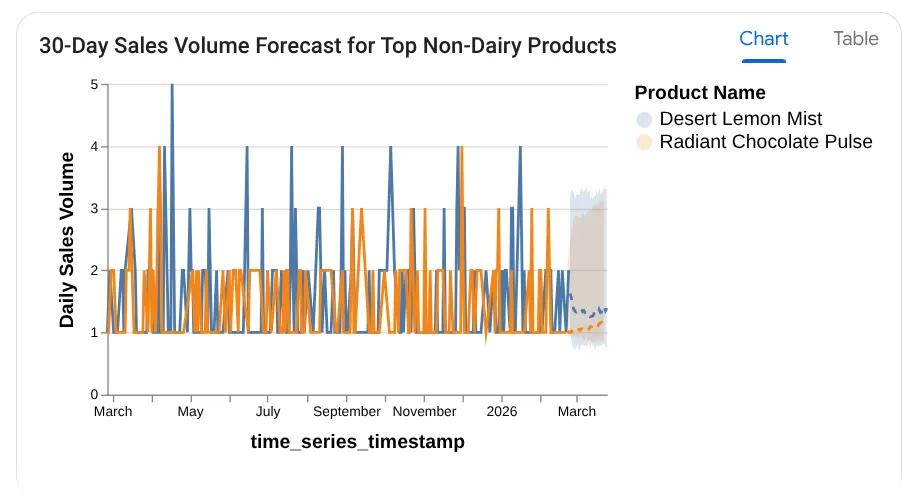
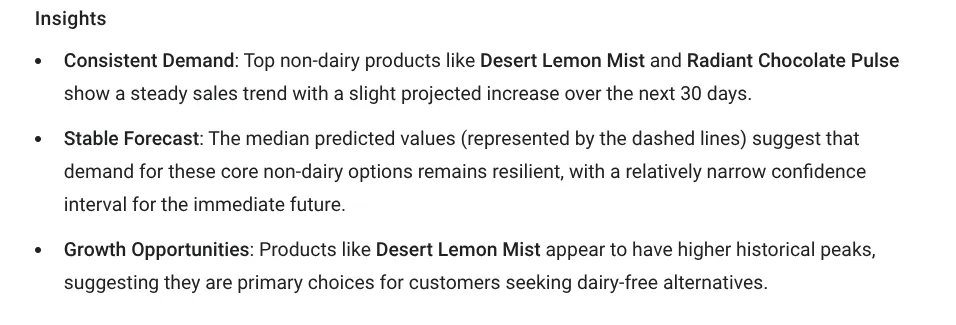
বাহ্! তাই চার্ট ও ইনসাইটের সাথে এটি ভালভাবে কাজ করেছে। প্রোডাক্ট সম্পর্কে চূড়ান্ত প্রশ্ন করার সময়।
৮. The Ultimate Test
প্রশ্নটি জিজ্ঞাসা করুন:
What will be the top most selling product of 2026
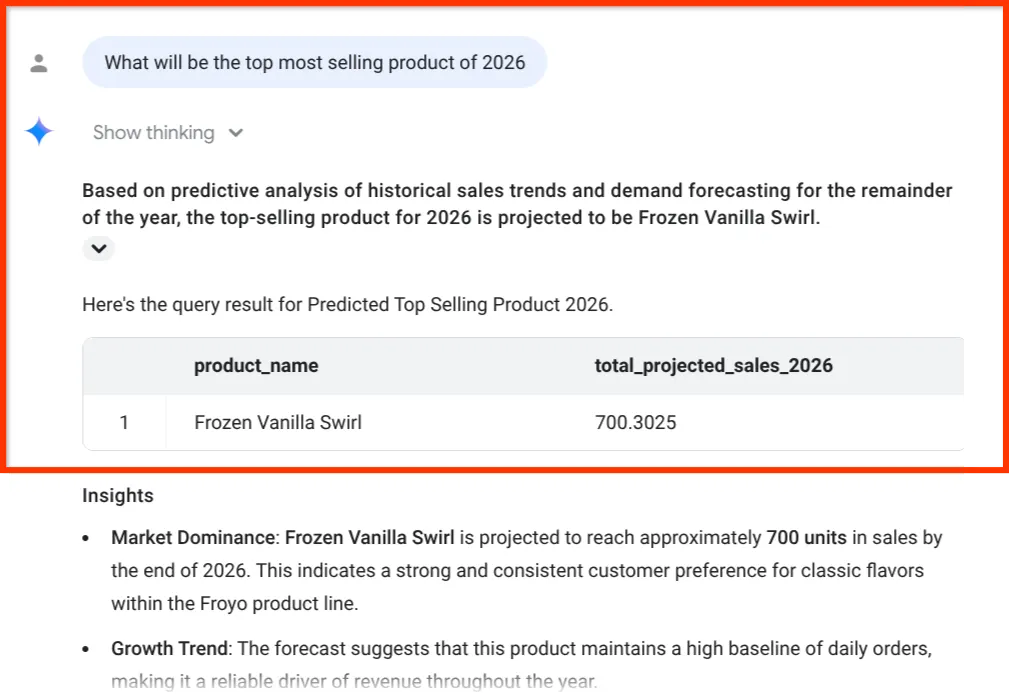
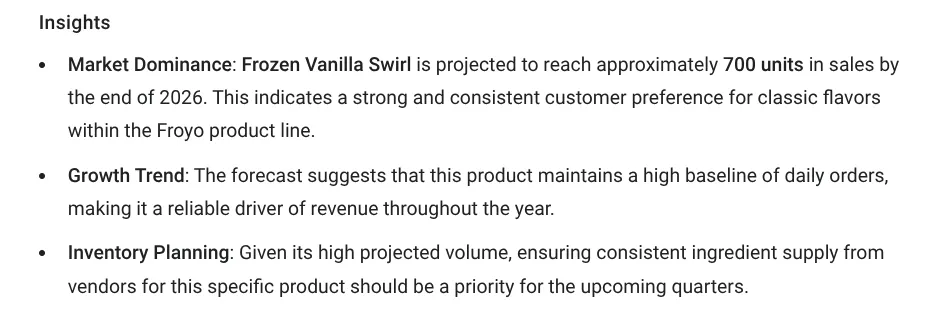
চূড়ান্ত ইনসাইটটি দেখুন। BigQuery Data Agent আমাদের শুধু একটি সংখ্যাই দেয়নি; এটি বিক্রির পূর্বাভাসকে আমাদের ইনভেন্টরি এবং উপাদানের সাপ্লাই চেনের সাথে স্পষ্টভাবে যুক্ত করেছে — ঠিক সেই ডেটা যা আমরা পার্ট ১-এ অগোছালো পিডিএফ থেকে বের করেছিলাম!
৯. এন্টারপ্রাইজে আপনার এজেন্ট প্রকাশ করা হচ্ছে
প্রিভিউ এজেন্টের উপরে প্রকাশ করুন বোতামে ক্লিক করুন।
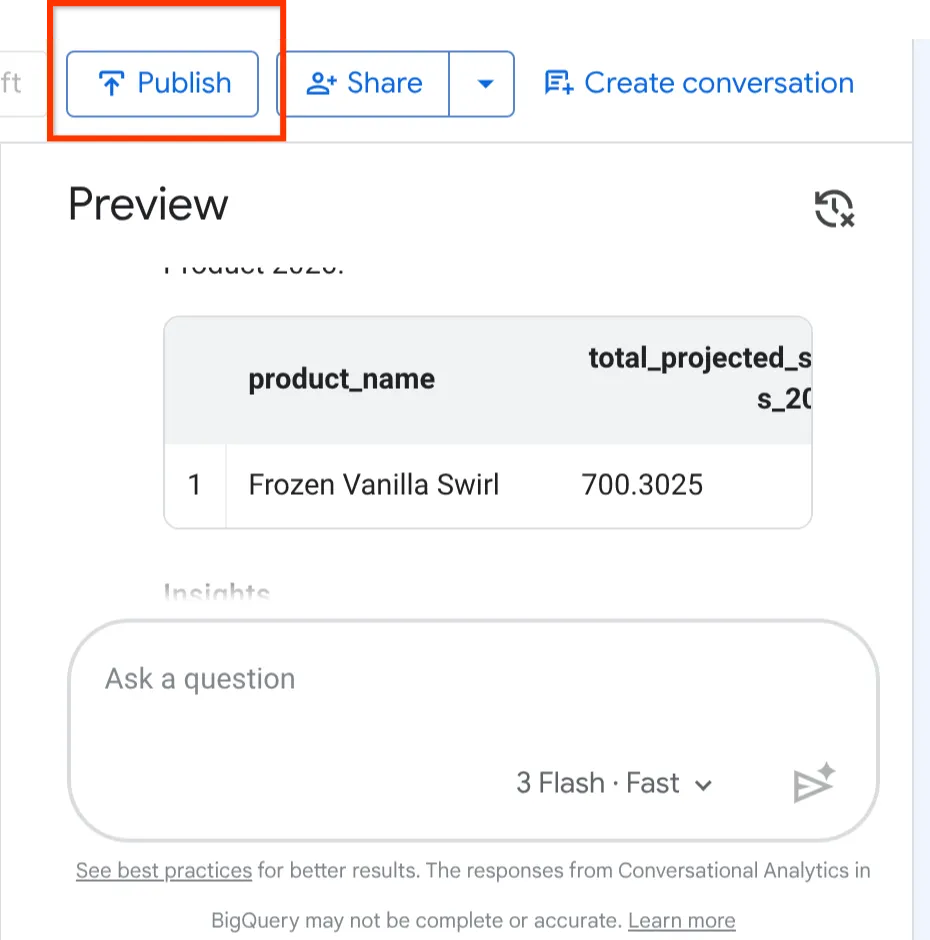
এখন আমরা Froyo এজেন্ট তৈরি, কনফিগার এবং পরীক্ষা করেছি, এটি ব্যবসার বাকি অংশে রিলিজ করার সময় এসেছে।
এজেন্ট কনফিগারেশন পৃষ্ঠার উপরে ডানদিকের কোণে, 'প্রকাশ করুন' বোতামে ক্লিক করুন।
প্রকাশ করার মাধ্যমে, আপনার এজেন্ট আপনার এবং আপনি যার সাথে এটি শেয়ার করেন তার জন্য তিনটি শক্তিশালী এন্টারপ্রাইজ চ্যানেল জুড়ে অবিলম্বে উপলভ্য হয়ে যায়:
- BigQuery: আপনার ডেটা অ্যানালিস্টরা এখন এজেন্ট হাব থেকে সরাসরি বা তাদের BigQuery Studio SQL ওয়ার্কস্পেসের মধ্যে এই এজেন্টের সাথে চ্যাট করতে পারবেন।
- Conversational Analytics API: আপনার ডেভেলপাররা REST API-এর মাধ্যমে এই এজেন্ট অ্যাক্সেস করতে পারবেন, যা তাদের এই সঠিক কথোপকথনমূলক অ্যানালিটিক্স আপনার নিজস্ব কাস্টম ইন্টার্নাল ওয়েব অ্যাপ্লিকেশনে ইন্টিগ্রেট করার অনুমতি দেয়।
- Data Studio: আপনার এক্সিকিউটিভরা এই এজেন্টের সাথে ইন্টার্যাক্ট করতে এবং সরাসরি Data Studio-র মধ্যে ডাইনামিক কথোপকথনমূলক ড্যাশবোর্ড তৈরি করতে পারবেন।
আমরা সাইলো থেকে ডেটা বের করে সরাসরি সেইসব ব্যক্তির হাতে তুলে দিতে পেরেছি যাদের এটি প্রয়োজন, ঠিক যেখানে তারা আগে থেকেই কাজ করেন!
আপনার প্রকাশিত BigQuery এজেন্টের উপরে শেয়ার বোতামের ড্রপ-ডাউনে ক্লিক করুন এবং তালিকা থেকে "Data Studio-তে এজেন্টের লিঙ্ক কপি করুন" বিকল্প বেছে নিন:
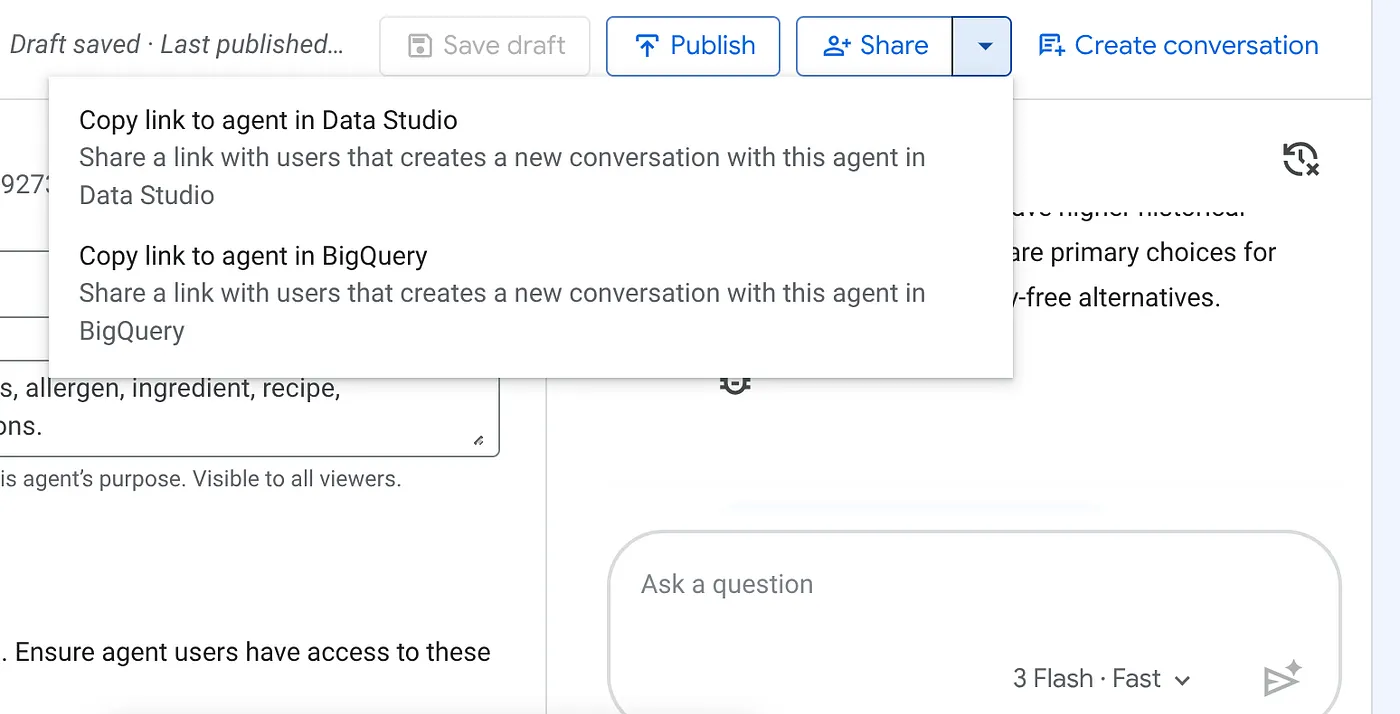
আপনার ব্রাউজারে সেই লিঙ্কটি পেস্ট করে Enter প্রেস করুন। এজেন্ট ইন্টার্যাকশন অ্যাক্সেস অ্যালার্টের জন্য কনফার্মেশন দিন:
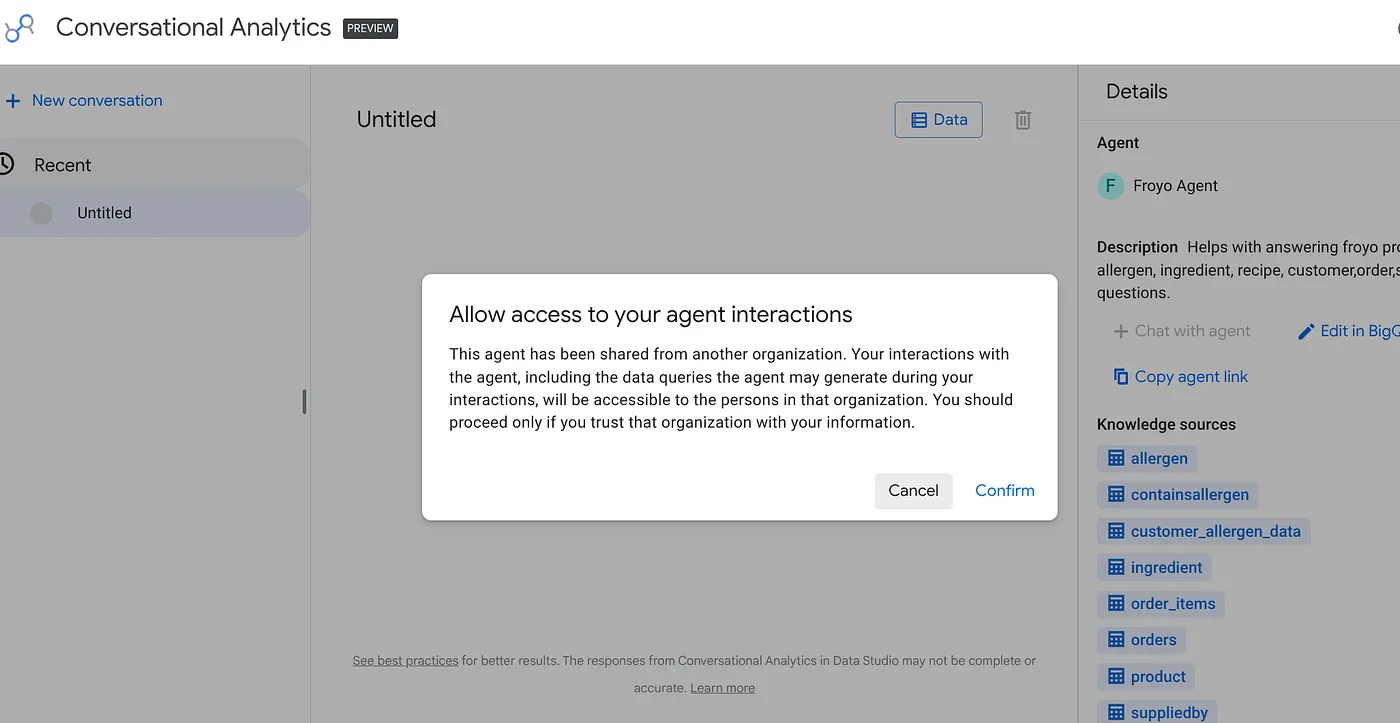
আপনি Data Studio থেকে নতুন প্রকাশিত এজেন্টের সাথে ইন্টার্যাক্টিভ কথোপকথন এবং ভিজ্যুয়ালাইজেশন শুরু করতে পারেন এবং আপনার লিডারশিপ এবং অন্যান্য টিম যাদের এই তথ্যের প্রয়োজন তারাও এটি করতে পারে!
১০. অপ্রয়োজনীয়গুলি মুছুন
এই ল্যাব সম্পূর্ণ হয়ে গেলে, আপনি এইমাত্র যে BigQuery এজেন্ট তৈরি করেছেন, সেটির জন্য সব ব্যবহারকারীর অনুমতি সরিয়ে দিতে ভুলবেন না।
১১. অভিনন্দন!
আপনি অফিসিয়ালি একটি এজেন্টিক ডেটা ক্লাউড তৈরি করেছেন!
আপনি শুধু একটি সাধারণ চ্যাটবট তৈরি করেননি। এই পাঁচটি সেশনের মাধ্যমে, আপনি সম্পূর্ণ, আধুনিক এবং মূল্যায়ন করা এন্টারপ্রাইজ AI সিস্টেমের আর্কিটেকচার তৈরি করেছেন। আপনি "ডার্ক ডেটা" থেকে রিয়েল-টাইম ট্রানজ্যাকশনাল ইন্টেলিজেন্স এবং অবশেষে কথোপকথনের মাধ্যমে ব্যবসার পূর্বাভাসে চলে এসেছেন।
১২. সম্পূর্ণ ছবি
একটু পিছনে ফিরে তাকান এবং এই সিরিজে আমরা কী অর্জন করেছি তা দেখুন। আমরা শুধু একটি সাধারণ চ্যাটবট তৈরি করিনি। আমরা একটি সম্পূর্ণ, আধুনিক এজেন্টিক ডেটা ক্লাউড তৈরি করেছি:
পার্ট ১: নলেজ ক্যাটালগ ব্যবহার করে পিডিএফকে স্ট্রাকচার্ড রিলেশনাল টেবিলে পরিণত করার মাধ্যমে ডার্ক ডেটা আনলক করা।
পার্ট ২: আমাদের অ্যানালিটিক্যাল ওয়্যারহাউস সরাসরি AlloyDB ট্রানজ্যাকশনাল ডেটাবেসে ফেডারেট করে ডেটা সাইলো ভেঙেছি।
পার্ট ৩: মাল্টি-এজেন্ট OS তৈরি করে ব্যবহারকারীদের ক্ষমতায়ন করা যা MCP প্রোটোকলের মাধ্যমে সুরক্ষিত ডেটাবেস টুল নির্বিঘ্নে এক্সিকিউট করে
৪র্থ অংশ: হ্যালুসিনেশন ও জেলব্রেক শনাক্ত করার জন্য কঠোর মূল্যায়ন পাইপলাইন প্রয়োগ করে নিরাপত্তা নিশ্চিত করা হয়েছে।
পার্ট ৫: ANTIGRAVITY IDE এবং BigQuery-তে Conversational Analytics ব্যবহার করে ডেমোক্রেটাইজড ইনসাইট।
এন্টারপ্রাইজ সফ্টওয়্যারের ভবিষ্যৎ হল এটি। AI এজেন্ট এখন আর শুধু LLM-এর র্যাপার নয়। এটি একটি সম্পূর্ণ ইন্টিগ্রেটেড, মূল্যায়ন করা এবং সুরক্ষিত অর্কেস্ট্রেশন ইঞ্জিন যা একটি ইউনিফায়েড ডেটা প্ল্যাটফর্মের উপরে বসে আছে।