

1. खास जानकारी
चलिए, अब उस बड़े आर्किटेक्चर पर एक नज़र डालते हैं जिसे हमने पिछले चार हिस्सों में बनाया है:
पहला हिस्सा: हमने BigQuery नॉलेज कैटलॉग का इस्तेमाल करके, फ़्रोजन योगर्ट की रेसिपी वाली रॉ PDF फ़ाइलों को स्ट्रक्चर्ड और रिलेशनल टेबल में बदला.
दूसरा हिस्सा: हमने एक ज़ीरो-ईटीएल ट्रांज़ैक्शनल ब्रिज बनाया है. इससे BigQuery वेयरहाउस को सीधे AlloyDB में फ़ेडरेट किया जा सकता है.
तीसरा पार्ट: हमने Agent Development Kit और MCP Toolbox का इस्तेमाल करके, एक मल्टी-एजेंट ऐप्लिकेशन (FroyoOS) बनाया.
चौथा चरण: हमने ड्यूअल-ट्रैक इवैलुएशन पाइपलाइन बनाकर, यह साबित किया कि हमारा एजेंट प्रोडक्शन के लिए सुरक्षित है.
हमारे काम बिना किसी रुकावट के चल रहे हैं. हालांकि, उन डेवलपर और बिज़नेस ऐनलिस्ट का क्या जिन्हें इस सिस्टम से जनरेट होने वाले बड़े डेटा को समझने की ज़रूरत होती है?
आज हम Analytics के भविष्य के बारे में बात करेंगे. हम Google Cloud Data Agent Kit के साथ, अपने कोड एडिटर Antigravity IDE में काम शुरू करेंगे. इसके बाद, BigQuery Conversational Analytics का इस्तेमाल करके अपने डेटा को विज़ुअलाइज़ करने के लिए, Google Cloud Console पर जाएंगे.
चलिए, अब ऐप्लिकेशन बनाना शुरू करते हैं!
आपको क्या सीखने को मिलेगा
Agentic Data Cloud सीरीज़ के इस आखिरी कोडलैब में, आपको अपने आर्किटेक्चर के सभी हिस्सों को एक साथ लाना होगा, ताकि कारोबार से जुड़ी अहम जानकारी मिल सके. आपको इनके बारे में जानकारी मिलेगी:
- IDE-First Analytics: ANTIGRAVITY IDE और Google Cloud Data Agent Kit को इंस्टॉल और कॉन्फ़िगर करने का तरीका जानें. इससे आपको अपने डेवलपमेंट एनवायरमेंट से सीधे अपने आर्किटेक्चर के बारे में क्वेरी करने में मदद मिलेगी.
- Conversational BigQuery: BigQuery डेटा एजेंट को बनाने, कॉन्फ़िगर करने, और निर्देश देने का तरीका जानें. इससे, एसक्यूएल से जुड़े जटिल टास्क और पूर्वानुमान लगाने की प्रोसेस को ऑटोमेट किया जा सकता है. इसके लिए, नैचुरल लैंग्वेज का इस्तेमाल किया जा सकता है.
- डेटा डेमोक्रेटाइज़ेशन: अपने एजेंट को एंटरप्राइज़ में पब्लिश करने का तरीका. इससे संगठन में मौजूद विश्लेषक और कारोबारी उपयोगकर्ता, एजेंट को ऐक्सेस कर पाएंगे.
- अहम जानकारी को विज़ुअलाइज़ करना: अपने एजेंट के बातचीत के आंकड़ों को Data Studio में आसानी से इंटिग्रेट करने का तरीका जानें. इससे डाइनैमिक और अनुमान लगाने के लिए तैयार डैशबोर्ड बनाए जा सकते हैं.
- एजेंटिक डेटा क्लाउड नेटवर्क: अपने एंड-टू-एंड आर्किटेक्चर की वैल्यू को कैसे समझाएं — पहले पार्ट में रॉ अनस्ट्रक्चर्ड डेटा से लेकर, पांचवें पार्ट में एक्ज़ीक्यूटिव के लिए तैयार डैशबोर्ड तक.
ज़रूरी शर्तें
2. शुरू करने से पहले
प्रोजेक्ट बनाना
- Google Cloud Console में, प्रोजेक्ट चुनने वाले पेज पर जाकर, कोई Google Cloud प्रोजेक्ट चुनें या बनाएं.
- पक्का करें कि आपके क्लाउड प्रोजेक्ट के लिए बिलिंग की सुविधा चालू हो. किसी प्रोजेक्ट के लिए बिलिंग की सुविधा चालू है या नहीं, यह देखने का तरीका जानें.
- आपको Cloud Shell का इस्तेमाल करना होगा. यह Google Cloud में चलने वाला कमांड-लाइन एनवायरमेंट है. Google Cloud Console में सबसे ऊपर, 'Cloud Shell चालू करें' पर क्लिक करें.

- Cloud Shell से कनेक्ट करने के बाद, यह देखें कि आपकी पुष्टि पहले ही हो चुकी है और प्रोजेक्ट को आपके प्रोजेक्ट आईडी पर सेट किया गया है. इसके लिए, इस कमांड का इस्तेमाल करें:
gcloud auth list
- Cloud Shell में यह कमांड चलाकर पुष्टि करें कि gcloud कमांड को आपके प्रोजेक्ट के बारे में पता है.
gcloud config list project
- अगर आपको पुष्टि करनी है, तो
gcloud auth login
- अगर आपका प्रोजेक्ट सेट नहीं है, तो उसे सेट करने के लिए इस निर्देश का इस्तेमाल करें:
export PROJECT_ID=<YOUR_PROJECT_ID>
gcloud config set project <YOUR_PROJECT_ID>
- ज़रूरी एपीआई चालू करें: सभी ज़रूरी एपीआई चालू करने के लिए, यह कमांड चलाएं:
gcloud services enable \
  alloydb.googleapis.com \
  bigquery.googleapis.com \
  run.googleapis.com \
  cloudbuild.googleapis.com \
  artifactregistry.googleapis.com \
  iam.googleapis.com \
  secretmanager.googleapis.com \
  compute.googleapis.com \
  servicenetworking.googleapis.com \
  aiplatform.googleapis.com
डेटासेट बनाना और टेबल में डेटा भरना (सिर्फ़ तब, जब आपने पहला पार्ट पूरा न किया हो)
Cloud Shell में, ये कमांड चलाएं.
- सबसे पहले, Cloud Shell टर्मिनल से नीचे दिया गया कमांड चलाकर BigQuery डेटासेट बनाएं:
bq mk --location us-central1 --dataset froyo_data
- इसके बाद, GitHub रिपॉज़िटरी से आठ डेटा फ़ाइलें (csv फ़ाइलें) अपनी वर्किंग डायरेक्ट्री में डाउनलोड करें. इसके लिए, यहां दिए गए कमांड एक-एक करके चलाएं:
wget https://raw.githubusercontent.com/AbiramiSukumaran/raw-data-to-gold/refs/heads/main/data/froyo_data.allergen.csv
- अपने नए डेटासेट में मौजूद डेटा की मदद से ये टेबल बनाने के लिए, एक-एक करके ये कमांड चलाएं
bq load --autodetect --source_format=CSV --skip_leading_rows=1 --allow_quoted_newlines --quote="" froyo_data.allergen ./froyo_data.allergen.csv allergen_name:STRING
bq load --autodetect --source_format=CSV --skip_leading_rows=1 --allow_quoted_newlines --quote="" froyo_data.consistsof ./froyo_data.consistsof.csv product_id:STRING,ingredient_id:STRING
bq load --autodetect --source_format=CSV --skip_leading_rows=1 --allow_quoted_newlines --quote="" froyo_data.containsallergen ./froyo_data.containsallergen.csv ingredient_id:STRING,allergen_name:STRING
bq load --autodetect --source_format=CSV --skip_leading_rows=1 --allow_quoted_newlines --quote="" froyo_data.froyo_data_materialized ./froyo_data.froyo_data_materialized.csv allergen:STRING,containsallergen:STRING,ingredient:STRING,product:STRING,suppliedby:STRING,supplier:STRING,ref:STRING,md5_hash:STRING
bq load --autodetect --source_format=CSV --skip_leading_rows=1 --allow_quoted_newlines --quote="" froyo_data.ingredient ./froyo_data.ingredient.csv ingredient_id:STRING,ingredient_name:STRING,purity:STRING,moisture_content:STRING,ph_range:STRING,specific_gravity_range:STRING
bq load --autodetect --source_format=CSV --skip_leading_rows=1 --allow_quoted_newlines --quote="" froyo_data.product ./froyo_data.product.csv product_id:STRING,product_name:STRING,category:STRING,stability:STRING
bq load --autodetect --source_format=CSV --skip_leading_rows=1 --allow_quoted_newlines --quote="" froyo_data.suppliedby ./froyo_data.suppliedby.csv ingredient_id:STRING,supplier_id:STRING
bq load --autodetect --source_format=CSV --skip_leading_rows=1 --allow_quoted_newlines --quote="" froyo_data.supplier ./froyo_data.supplier.csv supplier_id:STRING,supplier_name:STRING,production_site_id:STRING,facility_grade:STRING
3. डेटा वेयरहाउस को बढ़ाना
क्या आपको याद है कि हमने अनस्ट्रक्चर्ड डेटा से BigQuery टेबल बनाई थीं?
काम का विश्लेषण करने के लिए, हमें लेन-देन के पुराने डेटा की ज़रूरत होती है. BigQuery में, हमारे froyo_data डेटासेट में, तीन नई टेबल बनाते हैं. इससे, फ़्रेंचाइज़ के कई सालों के ऑपरेशन को सिम्युलेट किया जा सकेगा:
- froyo_data.orders: पुराने ऑर्डर हेडर (तारीखें, स्टोर आईडी, कुल संख्या)
- froyo_data.order_items: लाइन-आइटम का ब्यौरा (संख्या, कीमत)
- froyo_data.customer_allergen_data: सीआरएम टेबल, जिसमें हमारे लॉयल ग्राहकों को होने वाली एलर्जी की जानकारी ट्रैक की जाती है
आइए, बिक्री और ग्राहक से जुड़ी इन टेबल को उस डेटासेट में जोड़ें, ताकि हम आंकड़ों के इस्तेमाल के उदाहरण तैयार कर सकें.
- अपने Google Cloud Console से Cloud Shell Terminal पर जाएं.
- अपने फ़ोल्डर के रूट फ़ोल्डर या froyo-data प्रोजेक्ट के रूट फ़ोल्डर पर जाएं. हम इस सीरीज़ के पिछले कुछ हिस्सों से इस पर काम कर रहे हैं.
- एक-एक करके ये कमांड चलाकर, पुराने डेटा की तीन फ़ाइलों (csv फ़ाइलों में) को अपनी वर्किंग डायरेक्ट्री में डाउनलोड करें:
wget https://raw.githubusercontent.com/AbiramiSukumaran/froyo-data/main/customer_allergen_data.csv
wget https://raw.githubusercontent.com/AbiramiSukumaran/froyo-data/main/order_items.csv
wget https://raw.githubusercontent.com/AbiramiSukumaran/froyo-data/main/orders.csv
- जब आपको वे फ़ाइलें अपनी वर्किंग डायरेक्ट्री के रूट में दिखें, तो टर्मिनल पर टॉगल करके अपने Cloud Shell टर्मिनल पर जाएं.
- उस डायरेक्ट्री पर जाएं जहां आपके Cloud Shell टर्मिनल पर ये तीन फ़ाइलें मौजूद हैं.
- पक्का करें कि आपके BigQuery में, इस सीरीज़ के पहले पार्ट का "froyo_data" नाम का डेटासेट मौजूद हो. अगर ऐसा नहीं है, तो वापस जाएं और डेटासेट और टेबल बनाएं.
- अपने Cloud Shell टर्मिनल से ये कमांड चलाएं:
bq load \
  --autodetect \
  --source_format=CSV \
  --skip_leading_rows=1 \
  --allow_quoted_newlines \
  --quote="" \
  froyo_data.orders \
  ./orders.csv
bq load \
  --autodetect \
  --source_format=CSV \
  --skip_leading_rows=1 \
  --allow_quoted_newlines \
  --quote="" \
  froyo_data.order_items \
  ./order_items.csv
bq load \
  --autodetect \
  --source_format=CSV \
  --skip_leading_rows=1 \
  --allow_quoted_newlines \
  --quote="" \
  froyo_data.customer_allergen_data \
  ./customer_allergen_data.csv
इससे आपके froyo_data डेटासेट में तीन अतिरिक्त टेबल बन जाएंगी.
4. डेवलपर का अनुभव — "डेटा एजेंट किट" के बारे में जानें
पहले, अगर किसी डेवलपर को डेटा का विश्लेषण करना होता था या मशीन लर्निंग की जटिल क्वेरी लिखनी होती थीं, तो उसे अपने IDE, डेटाबेस कंसोल, और दस्तावेज़ों के बीच लगातार स्विच करना पड़ता था.
अब नहीं. हाल ही में लॉन्च किए गए Google Cloud Data Agent Kit एक्सटेंशन की मदद से, आपका IDE डेटा का पावरहाउस बन जाता है. Google Cloud Data Agent Kit एक्सटेंशन, सीधे आपके एडिटर में Google Cloud की डेटा सेवाओं के साथ बेहतर इंटिग्रेशन की सुविधा देता है. इससे आपको BigQuery, Cloud SQL, Cloud Storage वगैरह के साथ इंटरैक्ट करने के लिए, कॉन्टेक्स्ट स्विच करने की ज़रूरत नहीं पड़ती.
ज़रूरी शर्तें
- Node.js (सुझाया गया सबसे नया वर्शन)
- gcloud सीएलआई इंस्टॉल करें.
- अपने Google Cloud खाते से लॉग इन करें:
gcloud auth login
- ऐप्लिकेशन के डिफ़ॉल्ट क्रेडेंशियल (एडीसी) में लॉग इन करें:
gcloud auth application-default login
Antigravity IDE
Antigravity IDE, Google का अगली पीढ़ी का एजेंट-फ़र्स्ट डेवलपमेंट एनवायरमेंट है. इसे खास तौर पर एआई के दौर के लिए डिज़ाइन किया गया है. यह एडिटर में सीधे तौर पर, बड़े मल्टी-मोडल कॉन्टेक्स्ट विंडो और ऑटोनॉमस टूल के इस्तेमाल को इंटिग्रेट करता है. इससे डेवलपर, अपने कोड को छोड़े बिना क्लाउड रिसॉर्स और जटिल डेटा पाइपलाइन को मैनेज कर सकते हैं.
Antigravity IDE को सेट अप करना
- Google Antigravity के डाउनलोड पेज पर जाकर, Antigravity IDE को डाउनलोड और इंस्टॉल करें.
- इंस्टॉल और लॉन्च करना: इंस्टॉलर को चलाएं और Antigravity IDE खोलें.
- 'Google खाते से जारी रखें' पर क्लिक करें. इसके बाद, अपना Gmail खाता चुनें और अनुमति दें.
- शुरुआती कॉन्फ़िगरेशन को पूरा करें. ध्यान दें: सेटिंग में जाकर, इन्हें बाद में कभी भी अपडेट किया जा सकता है.
- अपनी लोकल मशीन पर एक नया और खाली फ़ोल्डर बनाएं (उदाहरण के लिए,
agentic-data-labsनाम से) और Open Folder को चुनकर, इसे IDE में खोलें. यह कोडलैब के लिए, आपके लोकल फ़ोल्डर के तौर पर काम करेगा.
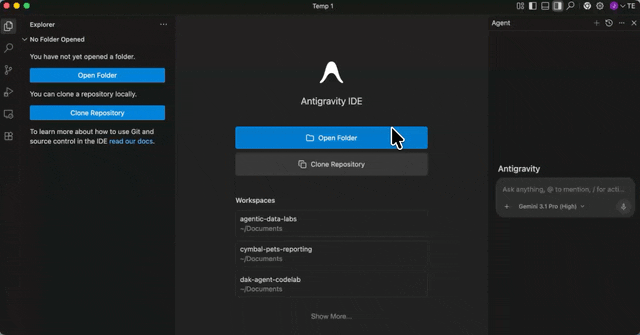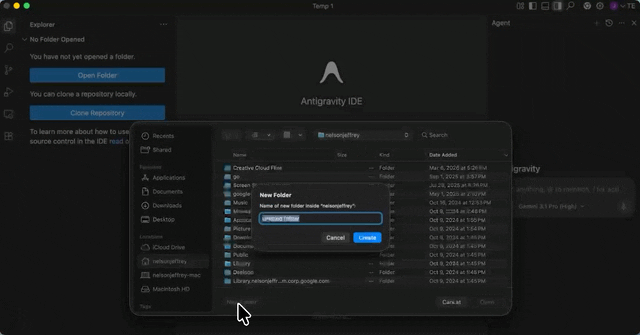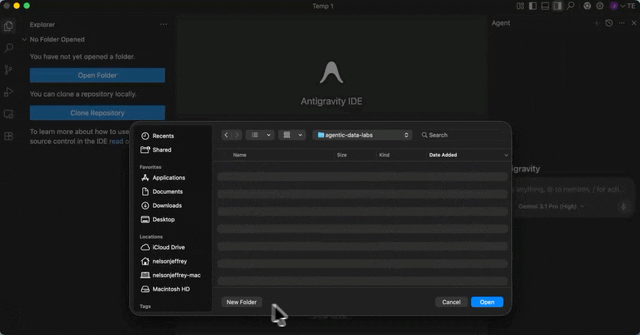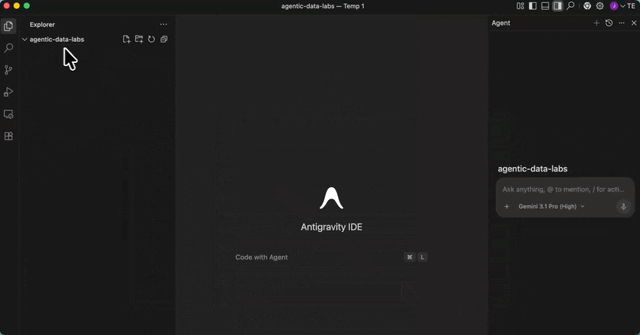
आपको दाईं ओर एजेंट पैनल, बाईं ओर प्रोजेक्ट एक्सप्लोरर, और बीच में डेवलपमेंट के लिए स्पेस दिखेगा.
Data Agent Kit एक्सटेंशन इंस्टॉल करना
Google Cloud Data Agent Kit एक्सटेंशन, सीधे आपके एडिटर में Google Cloud की डेटा सेवाओं के साथ बेहतर इंटिग्रेशन की सुविधा देता है. इससे आपको कॉन्टेक्स्ट स्विच किए बिना, BigQuery, Cloud SQL, Cloud Storage वगैरह के साथ इंटरैक्ट करने की सुविधा मिलती है.
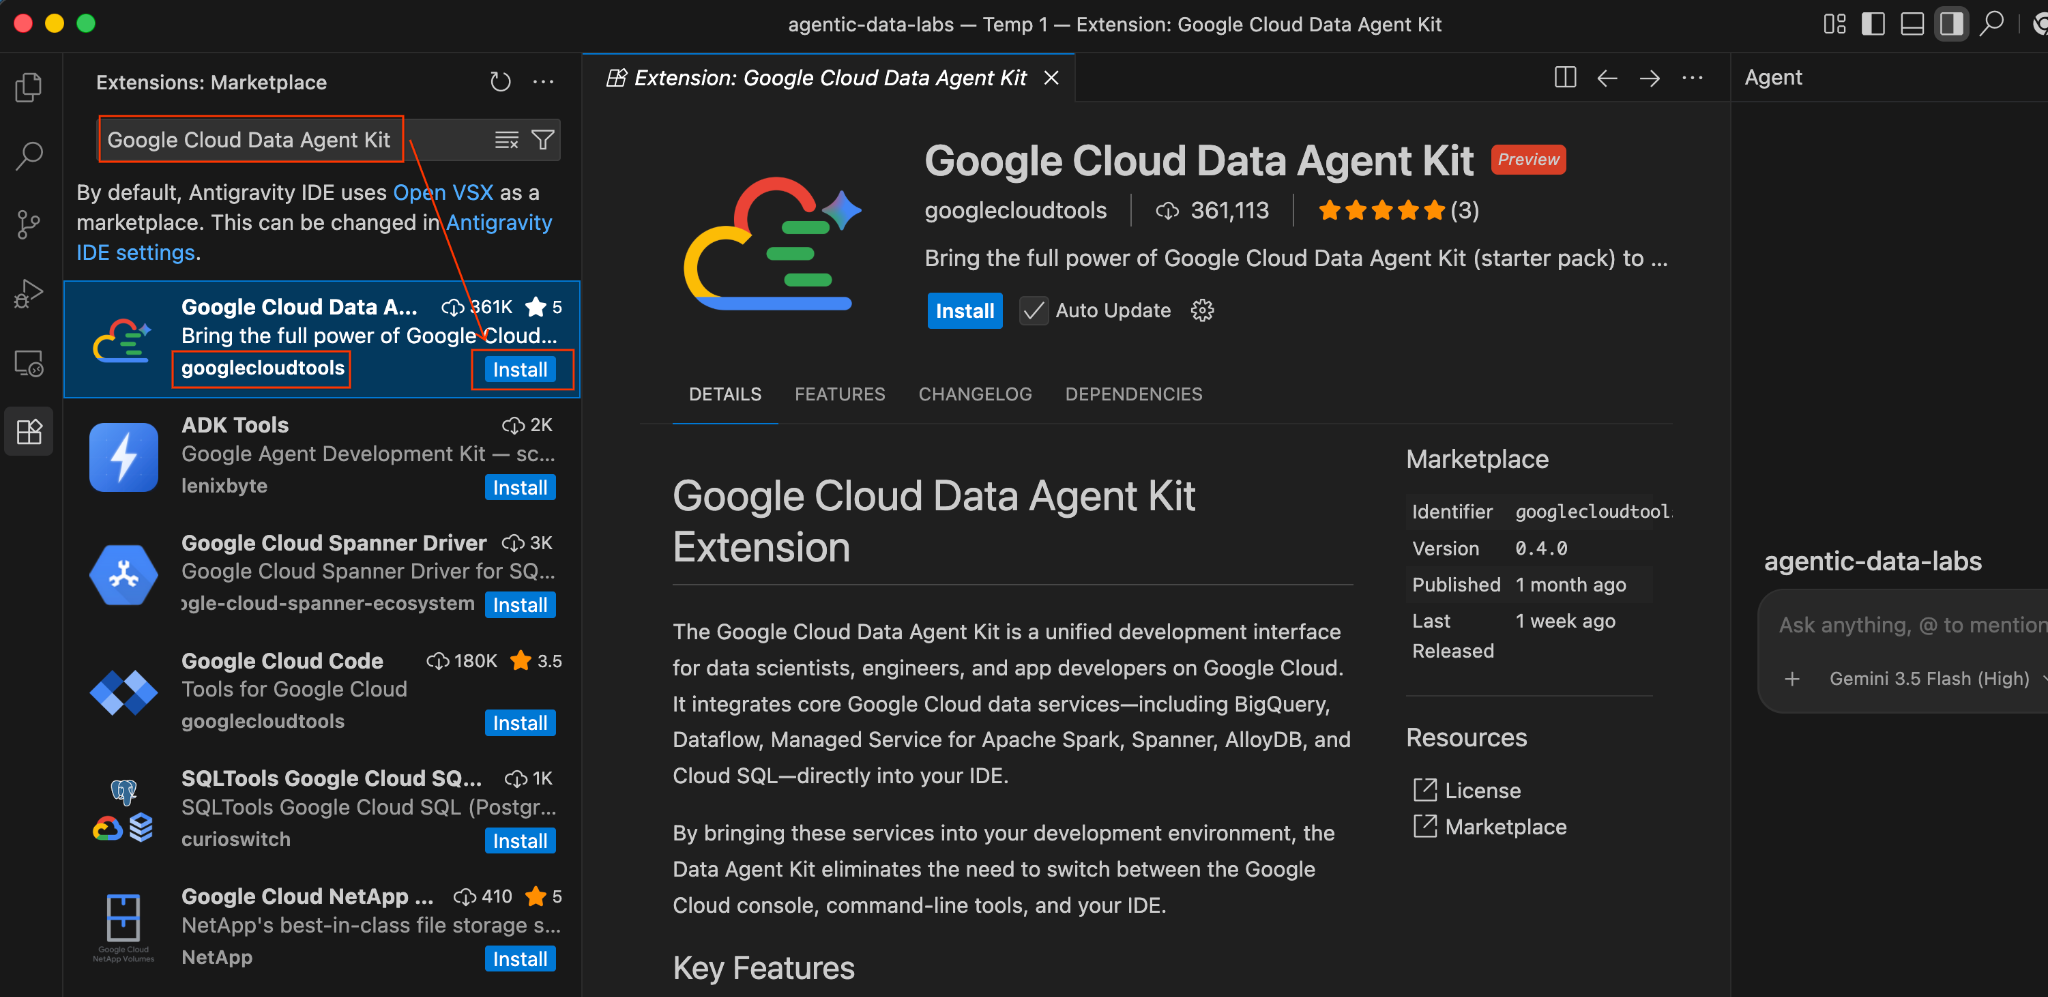
- Antigravity IDE में, स्क्रीन पर सबसे बाईं ओर मौजूद गतिविधि बार में, एक्सटेंशन आइकॉन पर क्लिक करें. यह आइकॉन, चार स्क्वेयर जैसा दिखता है.
- एक्सटेंशन पैनल में सबसे ऊपर मौजूद खोज बार में,
Google Cloud Data Agent Kitटाइप करें. - Google Cloud Data Agent Kit नाम का एक्सटेंशन ढूंढें. इसे
googlecloudtoolsने पब्लिश किया है. - इंस्टॉल करें बटन पर क्लिक करें.
- आपको एक प्रॉम्प्ट दिख सकता है, जिसमें पूछा जाएगा कि "क्या आपको पब्लिशर ‘googlecloudtools' और उनके एक्सटेंशन पर भरोसा है?". आगे बढ़ने के लिए, Trust Publishers & Install पर क्लिक करें.
इंस्टॉल होने के बाद, आपको Antigravity IDE में सबसे बाईं ओर मौजूद ऐक्टिविटी बार में, Google Cloud Data Agent Kit का नया आइकॉन दिखेगा.
- "Google Cloud Data Agent Kit में आपका स्वागत है" टाइटल वाला ऑनबोर्डिंग पेज अपने-आप खुल जाएगा. अगर आपने अपने क्लाउड खाते में साइन इन नहीं किया है, तो ऐक्सेस की अनुमति देने के लिए, स्क्रीन पर दिए गए निर्देशों का पालन करें.
- कॉन्फ़िगरेशन की खास जानकारी वाले सेक्शन में, प्रोजेक्ट फ़ील्ड ढूंढें. ड्रॉपडाउन पर क्लिक करें और अपना Google Cloud प्रोजेक्ट चुनें. अपने क्षेत्र को us-central1 के तौर पर सेट करें. इसके बाद, 'एमसीपी सर्वर कॉन्फ़िगर करें' को चुनें.
- अपने प्रोजेक्ट में
GEMINI.mdनाम की नई फ़ाइल में, यह कोड चिपकाएं. <<YOUR_PROJECT_ID>> की जगह अपनी वैल्यू डालना न भूलें:
## 1. Project Context
- **Project ID**: <<YOUR_PROJECT_ID>>
- **Domain**: This project is centralized around "Froyo", a brand of frozen yogurt offering multiple flavors.
- **Data**: All froyo, customer, order related information is processed and stored in BigQuery `froyo_data` dataset.

## 2. Execution & Data Processing Rules
- **CRITICAL RULE - Structured Specs**: The semantic and structured information extracted from the PDFs is available in a BigQuery dataset named `froyo_data`.
- **CRITICAL RULE - Customer Data**: Existing Froyo customer data resides in BigQuery in the tables `customers_allergen_data`.
- ** CRITICAL RULE - Sales Data**: Sales data is present in tables `orders` and `order_items`.
- ** CRITICAL RULE - General: When you are referencing a dataset, ensure you are using it with the dataset ID (`froyo_data`) . For example, to query orders table in this dataset you should use `froyo_data.orders`.
- **CRITICAL RULE - Allergen & Ingredient Mapping**: Never join `consistsof` directly to `containsallergen` on `ingredient_id`. The `consistsof` table often contains ingredient names (e.g. `Midnight Base 204`) while `containsallergen` maps CAS/code IDs (e.g. `9412-78-0`). Always bridge them through `froyo_data.ingredient` (`ON c.ingredient_id = i.ingredient_name OR c.ingredient_id = i.ingredient_id`) to accurately detect allergens.
अब आपके पास सीधे अपने आईडीई में, बेहतरीन एआई एजेंट मौजूद है. यह कोड लिखने, एसक्यूएल जनरेट करने, और आपके आर्किटेक्चर का विश्लेषण करने के लिए तैयार है.
अब हमारे पास विश्लेषण से जुड़ी एक दिलचस्प चुनौती है: क्या हम बिक्री के पुराने डेटा को, एलर्जी पैदा करने वाले पदार्थों के उस जटिल और अनुमानित डेटा से जोड़ सकते हैं जिसे हमने पहले भाग में PDF से निकाला था?
5. आईडीई एजेंट की मदद से इंटेलिजेंस का अनुमान लगाना
चलिए, अपने IDE एजेंट से यह मुश्किल काम करने के लिए कहते हैं. अपने ANTIGRAVITY IDE में Agent Data Kit की चैट विंडो खोलें और उसे यह प्रॉम्प्ट दें:
Does Midnight Swirl contain any allergen?
यह आपसे कई अनुमतियां मांगेगा. ज़रूरत के हिसाब से अनुमतियां दें.
आखिर में, विश्लेषण पूरा होने के बाद आपको जवाब मिलेगा:

वाह!!! इसने सही तरीके से पहचाना है कि मिडनाइट स्वर्ल आइटम में सोयाबीन है.
अब थोड़ा मुश्किल सवाल पूछते हैं. Antigravity IDE में यह प्रॉम्प्ट भेजें:
I want to see the top 5 most popular products purchased by
customers who have a registered 'Dairy' allergy.
जवाब:

आप आगे बढ़ सकती हैं. इस तरह के प्रॉम्प्ट आज़माएं:
Forecast the sales volume of our top non-dairy products
for the next 30 days based on historical data.
BQML सिंटैक्स को देखे बिना, Agent Data Kit आपके एडिटर में CREATE MODEL और ML.FORECAST कोड को डाल देता है. इसे ANTIGRAVITY IDE से बाहर निकले बिना, सीधे BigQuery एनवायरमेंट में चलाया जा सकता है!
यह कितना शानदार है!!!
6. BigQuery में कन्वर्सेशनल ऐनलिटिक्स
डेवलपर को आईडीई पसंद है, जबकि कारोबारी उपयोगकर्ता और अधिकारी, Cloud Console का इस्तेमाल करते हैं. उन्हें एसक्यूएल नहीं देखना है, उन्हें सिर्फ़ जवाब चाहिए.
आइए शुरू करें:
- खुद को ज़रूरी भूमिकाएं देना
प्रोजेक्ट के IAM पेज पर जाएं और खुद को Gemini Data Analytics Data Agent Owner की भूमिका दें:

इस भूमिका के तहत, आपको प्रोजेक्ट में मौजूद सभी डेटा एजेंट बनाने, उनमें बदलाव करने, उन्हें शेयर करने, और मिटाने की अनुमति मिलती है.
- ज़रूरी एपीआई चालू करना
Google Cloud Console पर BigQuery पर जाएं. BigQuery > एजेंट पर जाने के लिए, साइडबार नेविगेशन मेन्यू या पेज पर सबसे ऊपर मौजूद खोज मेन्यू का इस्तेमाल करें.
Gemini के साथ डेटा ऐनलिटिक्स एपीआई चालू करें पर क्लिक करें:

Gemini in BigQuery API और Gemini for Google Cloud API, दोनों को चालू करें:

अब आपको नया एजेंट पेज दिखेगा:

- एजेंट की जानकारी कॉन्फ़िगर करना
Agent Name: Froyo Agent
एजेंट का ब्यौरा: यह एजेंट, फ़्रोज़न योगर्ट प्रॉडक्ट, एलर्जी पैदा करने वाली चीज़ों, सामग्री, रेसिपी, ग्राहक, ऑर्डर, और बिक्री से जुड़े सवालों के जवाब देने में मदद करता है.

- 'जानकारी के स्रोत' सेक्शन पर जाएं और अपने डेटासेट से नीचे दी गई सभी टेबल चुनें:

a. ऊपर दी गई इमेज में मौजूद टेबल जोड़ें और 'सोर्स जोड़ें' पर क्लिक करें.
b. हर सोर्स के लिए, दाईं ओर मौजूद पसंद के मुताबिक बनाएं बटन पर क्लिक करें. आपको यहां दिया गया फ़ॉर्म दिखेगा:

c. टेबल के ब्यौरे के लिए, "स्वीकार करें" पर क्लिक करें.
d. हर फ़ील्ड के ब्यौरे के लिए भी "स्वीकार करें" पर क्लिक करें.

e. 'अपडेट करें' पर क्लिक करें.
आपको सोर्स में मौजूद सभी टेबल के लिए, यह प्रोसेस दोहरानी होगी.
- निर्देश कॉन्फ़िगर करना
Antigravity IDE GEMINI.md में इस्तेमाल किए गए निर्देशों को यहां डालें:
1. Project Context
Project ID: <<YOUR_PROJECT_ID>>
Domain: This project is centralized around "Froyo", a brand of frozen yogurt offering multiple flavors.
Data: All froyo, customer, order related information is processed and stored in BigQuery froyo_data dataset. Use all the tables and data in the dataset for querying for user questions.
Context: Use Data Agent Kit skills wherever possible.
2. Execution & Data Processing Rules
CRITICAL RULE - Structured Specs: The semantic and structured information extracted from the PDFs is available in a BigQuery dataset named froyo_data.
CRITICAL RULE - Customer Data: Existing Froyo customer data resides in BigQuery in the tables customers_allergen_data. When you are referencing a dataset, ensure you are using it with the dataset ID (froyo_data) . For example, to query orders table in this dataset you should use froyo_data.orders.
- अपना एजेंट सेव करें.
7. अपने डेटा के बारे में चैट करें!
- दाईं ओर मौजूद झलक वाले सेक्शन में इसे आज़माएं:

अपना सवाल पूछें:
Does midnight swirl contain any allergen?

यह रहा जवाब:

अब मुश्किल सवाल पूछते हैं:
I want to see the top 5 most popular products purchased by
customers who have a registered 'Dairy' allergy.
जवाब:


चलिए, अब ज़्यादा जानकारी पाने के लिए एक प्रॉम्प्ट आज़माते हैं:
Forecast the sales volume of our top non-dairy products
for the next 30 days based on historical data.
आपको दिखेगा कि यह आपको वह क्वेरी दिखाता है जिसका इस्तेमाल किया जाता है. साथ ही, चार्ट के साथ टेबल का नतीजा भी दिखाता है:


वाह! इस तरह, चार्ट और अहम जानकारी जनरेट करने की सुविधा का इस्तेमाल किया जा सकता है. अब प्रॉडक्ट से जुड़ा सबसे अहम सवाल.
8. The Ultimate Test
सवाल पूछना:
What will be the top most selling product of 2026


इस आखिरी अहम जानकारी को देखें. BigQuery डेटा एजेंट ने हमें सिर्फ़ एक संख्या नहीं दी, बल्कि बिक्री के अनुमान को हमारी इन्वेंट्री और सामग्री की सप्लाई चेन से साफ़ तौर पर जोड़ा. यह वही डेटा है जिसे हमने पहले पार्ट में, खराब तरीके से फ़ॉर्मैट की गई PDF फ़ाइलों से निकाला था!
9. एंटरप्राइज़ के लिए अपना एजेंट पब्लिश करना
एजेंट की झलक वाले पैनल में सबसे ऊपर मौजूद, पब्लिश करें बटन पर क्लिक करें.

हमने Froyo एजेंट को बना लिया है, कॉन्फ़िगर कर लिया है, और टेस्ट कर लिया है. अब इसे कारोबार के बाकी हिस्सों के लिए रिलीज़ करने का समय आ गया है.
एजेंट कॉन्फ़िगरेशन पेज के सबसे ऊपर दाएं कोने में, 'पब्लिश करें' बटन पर क्लिक करें.
एजेंट को पब्लिश करने पर, वह आपके और उन लोगों के लिए तीन बेहतरीन एंटरप्राइज़ चैनलों पर तुरंत उपलब्ध हो जाता है जिनके साथ आपने इसे शेयर किया है:
- BigQuery: आपके डेटा ऐनलिस्ट, अब इस एजेंट के साथ सीधे Agents hub या BigQuery Studio SQL फ़ाइल फ़ोल्डर से चैट कर सकते हैं.
- Conversational Analytics API: आपके डेवलपर, REST API के ज़रिए इस एजेंट को ऐक्सेस कर सकते हैं. इससे वे बातचीत के इन आंकड़ों को आपके कस्टम इंटरनल वेब ऐप्लिकेशन में इंटिग्रेट कर सकते हैं.
- Data Studio: आपकी कंपनी के अधिकारी, इस एजेंट के साथ इंटरैक्ट कर सकते हैं. साथ ही, सीधे Data Studio में डाइनैमिक और इंटरैक्टिव डैशबोर्ड बना सकते हैं.
हमने अपने डेटा को अलग-अलग जगहों से इकट्ठा करके, सीधे उन लोगों तक पहुंचाया है जिन्हें इसकी ज़रूरत है. साथ ही, यह डेटा उन्हें उसी प्लैटफ़ॉर्म पर उपलब्ध कराया है जहां वे पहले से काम करते हैं!
पब्लिश किए गए BigQuery एजेंट के सबसे ऊपर मौजूद, 'शेयर करें' बटन के ड्रॉप-डाउन पर क्लिक करें. इसके बाद, सूची से "Data Studio में एजेंट के साथ चैट करने का लिंक कॉपी करें" विकल्प चुनें:

उस लिंक को अपने ब्राउज़र में चिपकाएं और Enter दबाएं. एजेंट के साथ किए गए इंटरैक्शन के ऐक्सेस से जुड़ी चेतावनी की पुष्टि करने के लिए:

Data Studio से पब्लिश किए गए नए एजेंट की मदद से, इंटरैक्टिव बातचीत और विज़ुअलाइज़ेशन शुरू किए जा सकते हैं. साथ ही, आपकी लीडरशिप और अन्य टीमें भी ऐसा कर सकती हैं जिन्हें इस जानकारी की ज़रूरत है!
10. व्यवस्थित करें
इस लैब को पूरा करने के बाद, आपने जो BigQuery एजेंट बनाया है उसके लिए सभी उपयोगकर्ताओं की अनुमतियां हटाना न भूलें.
11. बधाई हो!
आपने आधिकारिक तौर पर एक एजेंटिक डेटा क्लाउड बना लिया है!
आपने सिर्फ़ एक सामान्य चैटबॉट नहीं बनाया है. इन पांच सेशन के दौरान, आपने एक आधुनिक और पूरी तरह से जांचा-परखा एंटरप्राइज़ एआई सिस्टम तैयार किया है. आपने "डार्क डेटा" से रीयल-टाइम ट्रांज़ैक्शनल इंटेलिजेंस और फिर बातचीत के आधार पर कारोबार के पूर्वानुमान की सुविधा का इस्तेमाल शुरू किया है.
12. पूरी जानकारी
एक कदम पीछे हटें और देखें कि हमने इस सीरीज़ में क्या हासिल किया है. हमने सिर्फ़ एक सामान्य चैटबॉट नहीं बनाया है. हमने एक पूरा और आधुनिक एजेंटिक डेटा क्लाउड बनाया है:
पहला पार्ट: नॉलेज कैटलॉग का इस्तेमाल करके, PDF को स्ट्रक्चर्ड रिलेशनल टेबल में बदलकर डार्क डेटा को अनलॉक किया.
दूसरा पार्ट: हमने अपने ऐनलिटिकल वेयरहाउस को सीधे AlloyDB ट्रांज़ैक्शनल डेटाबेस से फ़ेडरेट करके, डेटा साइलो को खत्म किया.
तीसरा: मल्टी-एजेंट ओएस बनाकर उपयोगकर्ताओं को सशक्त बनाना, जो एमसीपी प्रोटोकॉल के ज़रिए सुरक्षित डेटाबेस टूल को आसानी से इस्तेमाल करता है
चौथा हिस्सा: हमने सुरक्षा को ध्यान में रखते हुए, हैलुसिनेशन और जेलब्रेक का पता लगाने के लिए, एक सख्त इवैलुएशन पाइपलाइन लागू की है.
पांचवां हिस्सा: Antigravity IDE और BigQuery में कन्वर्सेशनल ऐनलिटिक्स का इस्तेमाल करके, अहम जानकारी को सभी के लिए उपलब्ध कराना.
यह एंटरप्राइज़ सॉफ़्टवेयर का भविष्य है. एआई एजेंट अब सिर्फ़ एलएलएम के लिए रैपर नहीं है. यह एक पूरी तरह से इंटिग्रेट किया गया, जांचा-परखा, और सुरक्षित ऑर्केस्ट्रेशन इंजन है. यह एक यूनिफ़ाइड डेटा प्लैटफ़ॉर्म पर काम करता है.