

1. 概览
我们先花点时间回顾一下过去四个部分中构建的庞大架构:
第 1 部分:我们使用 BigQuery Knowledge Catalog 将原始冻酸奶配方 PDF 转换为结构化的关系表。
第 2 部分:我们构建了一个零 ETL 事务桥,将 BigQuery 仓库直接联合到 AlloyDB 中。
第 3 部分:我们使用智能体开发套件和 MCP Toolbox 编排了一个多智能体应用 (FroyoOS)。
第 4 部分:我们构建了一个双轨评估流水线,证明了我们的智能体可以安全地用于生产环境。
我们的运营工作进展顺利。但对于需要理解该系统生成的海量数据的开发者和业务分析师来说,情况又如何呢?
今天,我们将探讨分析技术的未来。我们将首先在代码编辑器 Antigravity IDE 中使用 Google Cloud Data Agent Kit,然后转到 Google Cloud 控制台,使用 BigQuery Conversational Analytics 直观呈现数据。
我们开始构建吧!
学习内容
在本 Agentic Data Cloud 系列的最后一个 Codelab 中,您将整合架构的所有部分,以提供切实可行的业务洞见。您会了解到以下内容:
- IDE 优先分析:如何安装和配置 ANTIGRAVITY IDE 和 Google Cloud Data Agent Kit,以便直接从开发环境查询架构。
- 对话式 BigQuery:如何创建、配置和指示 BigQuery 数据智能体,以使用自然语言自动执行复杂的 SQL 任务和预测。
- 数据民主化:如何将智能体发布到企业,让整个组织的分析师和业务用户都能访问。
- 直观呈现数据洞见:如何将智能体的对话分析数据无缝集成到数据洞察中,以创建动态、可预测的信息中心。
- Agentic Data Cloud 生态系统:如何清晰阐述端到端架构的价值,从第 1 部分的原始非结构化数据,到第 5 部分的高管级信息中心。
要求
2. 准备工作
创建项目
- 在 Google Cloud Console 的项目选择器页面上,选择或创建一个 Google Cloud 项目。
- 确保您的 Cloud 项目已启用结算功能。了解如何检查项目是否已启用结算功能。
- 您将使用 Cloud Shell,这是一个在 Google Cloud 中运行的命令行环境。点击 Google Cloud 控制台顶部的“激活 Cloud Shell”。

- 连接到 Cloud Shell 后,您可以使用以下命令检查自己是否已通过身份验证,以及项目是否已设置为您的项目 ID:
gcloud auth list
- 在 Cloud Shell 中运行以下命令,以确认 gcloud 命令了解您的项目。
gcloud config list project
- 如果您想进行身份验证
gcloud auth login
- 如果项目未设置,请使用以下命令进行设置:
export PROJECT_ID=<YOUR_PROJECT_ID>
gcloud config set project <YOUR_PROJECT_ID>
- 启用所需的 API:运行以下命令可启用所有必需的 API:
gcloud services enable \
  alloydb.googleapis.com \
  bigquery.googleapis.com \
  run.googleapis.com \
  cloudbuild.googleapis.com \
  artifactregistry.googleapis.com \
  iam.googleapis.com \
  secretmanager.googleapis.com \
  compute.googleapis.com \
  servicenetworking.googleapis.com \
  aiplatform.googleapis.com
创建数据集并填充表(仅在您未完成第 1 部分的情况下)
在 Cloud Shell 中,运行以下命令。
- 首先,在 Cloud Shell 终端中运行以下命令,创建 BigQuery 数据集:
bq mk --location us-central1 --dataset froyo_data
- 接下来,逐一运行以下命令,将 8 个数据文件(csv 文件)从 GitHub 代码库下载到您的工作目录中:
wget https://raw.githubusercontent.com/AbiramiSukumaran/raw-data-to-gold/refs/heads/main/data/froyo_data.allergen.csv
- 逐一运行以下命令,使用新创建的数据集中的数据创建这些表
bq load --autodetect --source_format=CSV --skip_leading_rows=1 --allow_quoted_newlines --quote="" froyo_data.allergen ./froyo_data.allergen.csv allergen_name:STRING
bq load --autodetect --source_format=CSV --skip_leading_rows=1 --allow_quoted_newlines --quote="" froyo_data.consistsof ./froyo_data.consistsof.csv product_id:STRING,ingredient_id:STRING
bq load --autodetect --source_format=CSV --skip_leading_rows=1 --allow_quoted_newlines --quote="" froyo_data.containsallergen ./froyo_data.containsallergen.csv ingredient_id:STRING,allergen_name:STRING
bq load --autodetect --source_format=CSV --skip_leading_rows=1 --allow_quoted_newlines --quote="" froyo_data.froyo_data_materialized ./froyo_data.froyo_data_materialized.csv allergen:STRING,containsallergen:STRING,ingredient:STRING,product:STRING,suppliedby:STRING,supplier:STRING,ref:STRING,md5_hash:STRING
bq load --autodetect --source_format=CSV --skip_leading_rows=1 --allow_quoted_newlines --quote="" froyo_data.ingredient ./froyo_data.ingredient.csv ingredient_id:STRING,ingredient_name:STRING,purity:STRING,moisture_content:STRING,ph_range:STRING,specific_gravity_range:STRING
bq load --autodetect --source_format=CSV --skip_leading_rows=1 --allow_quoted_newlines --quote="" froyo_data.product ./froyo_data.product.csv product_id:STRING,product_name:STRING,category:STRING,stability:STRING
bq load --autodetect --source_format=CSV --skip_leading_rows=1 --allow_quoted_newlines --quote="" froyo_data.suppliedby ./froyo_data.suppliedby.csv ingredient_id:STRING,supplier_id:STRING
bq load --autodetect --source_format=CSV --skip_leading_rows=1 --allow_quoted_newlines --quote="" froyo_data.supplier ./froyo_data.supplier.csv supplier_id:STRING,supplier_name:STRING,production_site_id:STRING,facility_grade:STRING
3. 扩展数据仓库
还记得我们根据非结构化数据创建的 BigQuery 表吗?
为了进行有意义的分析,我们需要历史交易数据。在 BigQuery 的 froyo_data 数据集下,我们创建三个新表来模拟多年的加盟店运营情况:
- froyo_data.orders:历史订单标题(日期、商店 ID、总计)
- froyo_data.order_items:订单项详情(数量、价格)
- froyo_data.customer_allergen_data:一个 CRM 表,用于跟踪忠实客户的已知过敏原
我们将这些与销售和客户相关的表添加到该数据集中,为分析用例做好准备。
- 从 Google Cloud 控制台前往 Cloud Shell 终端。
- 前往工作区的根文件夹或 froyo-data 项目根文件夹(我们在本系列的前几个部分中一直在使用该文件夹)。
- 逐一运行以下命令,将 3 个历史数据文件(CSV 文件)下载到您的工作目录中:
wget https://raw.githubusercontent.com/AbiramiSukumaran/froyo-data/main/customer_allergen_data.csv
wget https://raw.githubusercontent.com/AbiramiSukumaran/froyo-data/main/order_items.csv
wget https://raw.githubusercontent.com/AbiramiSukumaran/froyo-data/main/orders.csv
- 在工作目录的根目录中看到这些文件后,切换到 Cloud Shell 终端。
- 在 Cloud Shell 终端中,前往包含这 3 个文件的目录。
- 确保您的 BigQuery 包含本系列第 1 部分中名为“froyo_data”的数据集(如果没有,请返回并创建数据集和表)。
- 在 Cloud Shell 终端中运行以下命令:
bq load \
  --autodetect \
  --source_format=CSV \
  --skip_leading_rows=1 \
  --allow_quoted_newlines \
  --quote="" \
  froyo_data.orders \
  ./orders.csv
bq load \
  --autodetect \
  --source_format=CSV \
  --skip_leading_rows=1 \
  --allow_quoted_newlines \
  --quote="" \
  froyo_data.order_items \
  ./order_items.csv
bq load \
  --autodetect \
  --source_format=CSV \
  --skip_leading_rows=1 \
  --allow_quoted_newlines \
  --quote="" \
  froyo_data.customer_allergen_data \
  ./customer_allergen_data.csv
这应该会在 froyo_data 数据集中创建 3 个额外的表。
4. 开发者体验 - 引入“Data Agent Kit”
过去,如果开发者想要分析数据或编写复杂的机器学习查询,就必须在 IDE、Databases Console 和文档之间不断切换。
现在不需要了。借助新推出的 Google Cloud Data Agent Kit 扩展程序,您的 IDE 将成为强大的数据处理中心。Google Cloud Data Agent Kit 扩展程序可直接在编辑器中与 Google Cloud 数据服务深度集成,让您无需切换上下文即可与 BigQuery、Cloud SQL、Cloud Storage 等服务进行交互。
前提条件
- Node.js(最新推荐版本)
- 安装 gcloud CLI。
- 使用您的 Google Cloud 账号登录:
gcloud auth login
- 登录应用默认凭证 (ADC):
gcloud auth application-default login
Antigravity IDE
Antigravity IDE 是 Google 专为 AI 时代打造的新一代智能体优先开发环境。它将海量多模态上下文窗口和自主工具使用功能直接原生集成到编辑器中,让开发者无需离开代码即可编排云资源和复杂的数据流水线。
设置 Antigravity IDE
- 从 Google Antigravity 下载页面下载并安装 Antigravity IDE。
- 安装并启动:运行安装程序,然后打开 Antigravity IDE。
- 点击“继续使用 Google 账号”,选择您的 Gmail 账号并授权。
- 完成初始配置。注意:您之后可随时在设置中更新这些信息。
- 在本地机器上创建一个新的空文件夹(例如,命名为
agentic-data-labs),然后选择“打开文件夹”在 IDE 中打开该文件夹。此目录将用作您在此 Codelab 中的本地工作区。
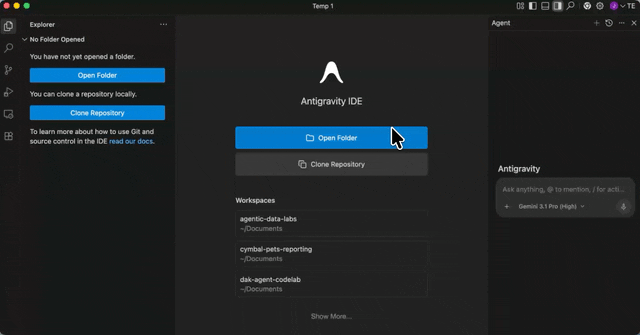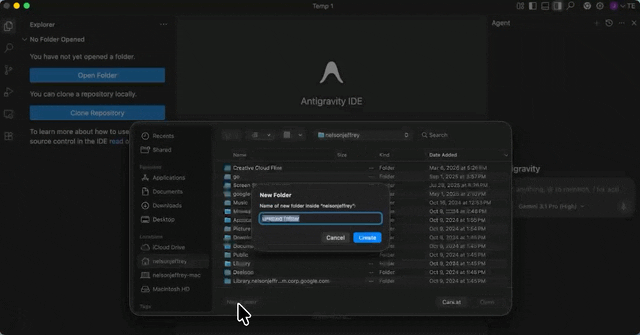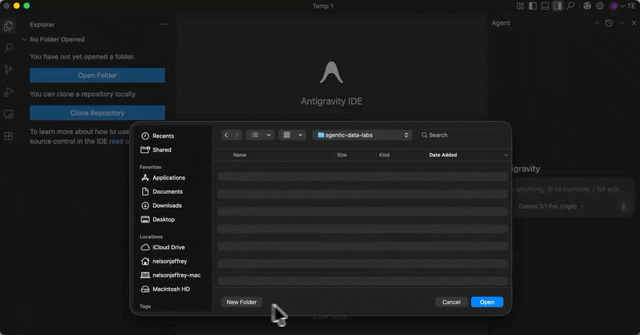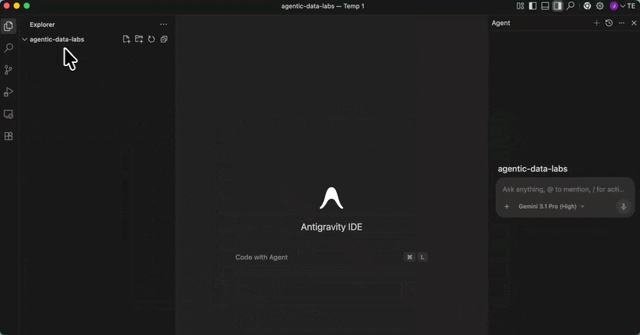
您应该会在右侧看到智能体窗格,在左侧看到项目探索器,在中间看到开发空间。
安装 Data Agent Kit 扩展程序
Google Cloud Data Agent Kit 扩展程序可直接在编辑器中与 Google Cloud 数据服务深度集成,让您无需切换上下文即可与 BigQuery、Cloud SQL、Cloud Storage 等服务进行交互。
- 在 Antigravity IDE 中,点击屏幕最左侧活动栏中的“扩展程序”图标(看起来像四个方块)。
- 在“扩展程序”窗格顶部的搜索栏中,输入
Google Cloud Data Agent Kit。 - 找到由
googlecloudtools发布的名为 Google Cloud Data Agent Kit 的扩展程序。 - 点击 Install 按钮。
- 系统可能会显示一条提示,询问“您是否信任发布商‘googlecloudtools’及其扩展程序?”。点击信任发布商并安装以继续。
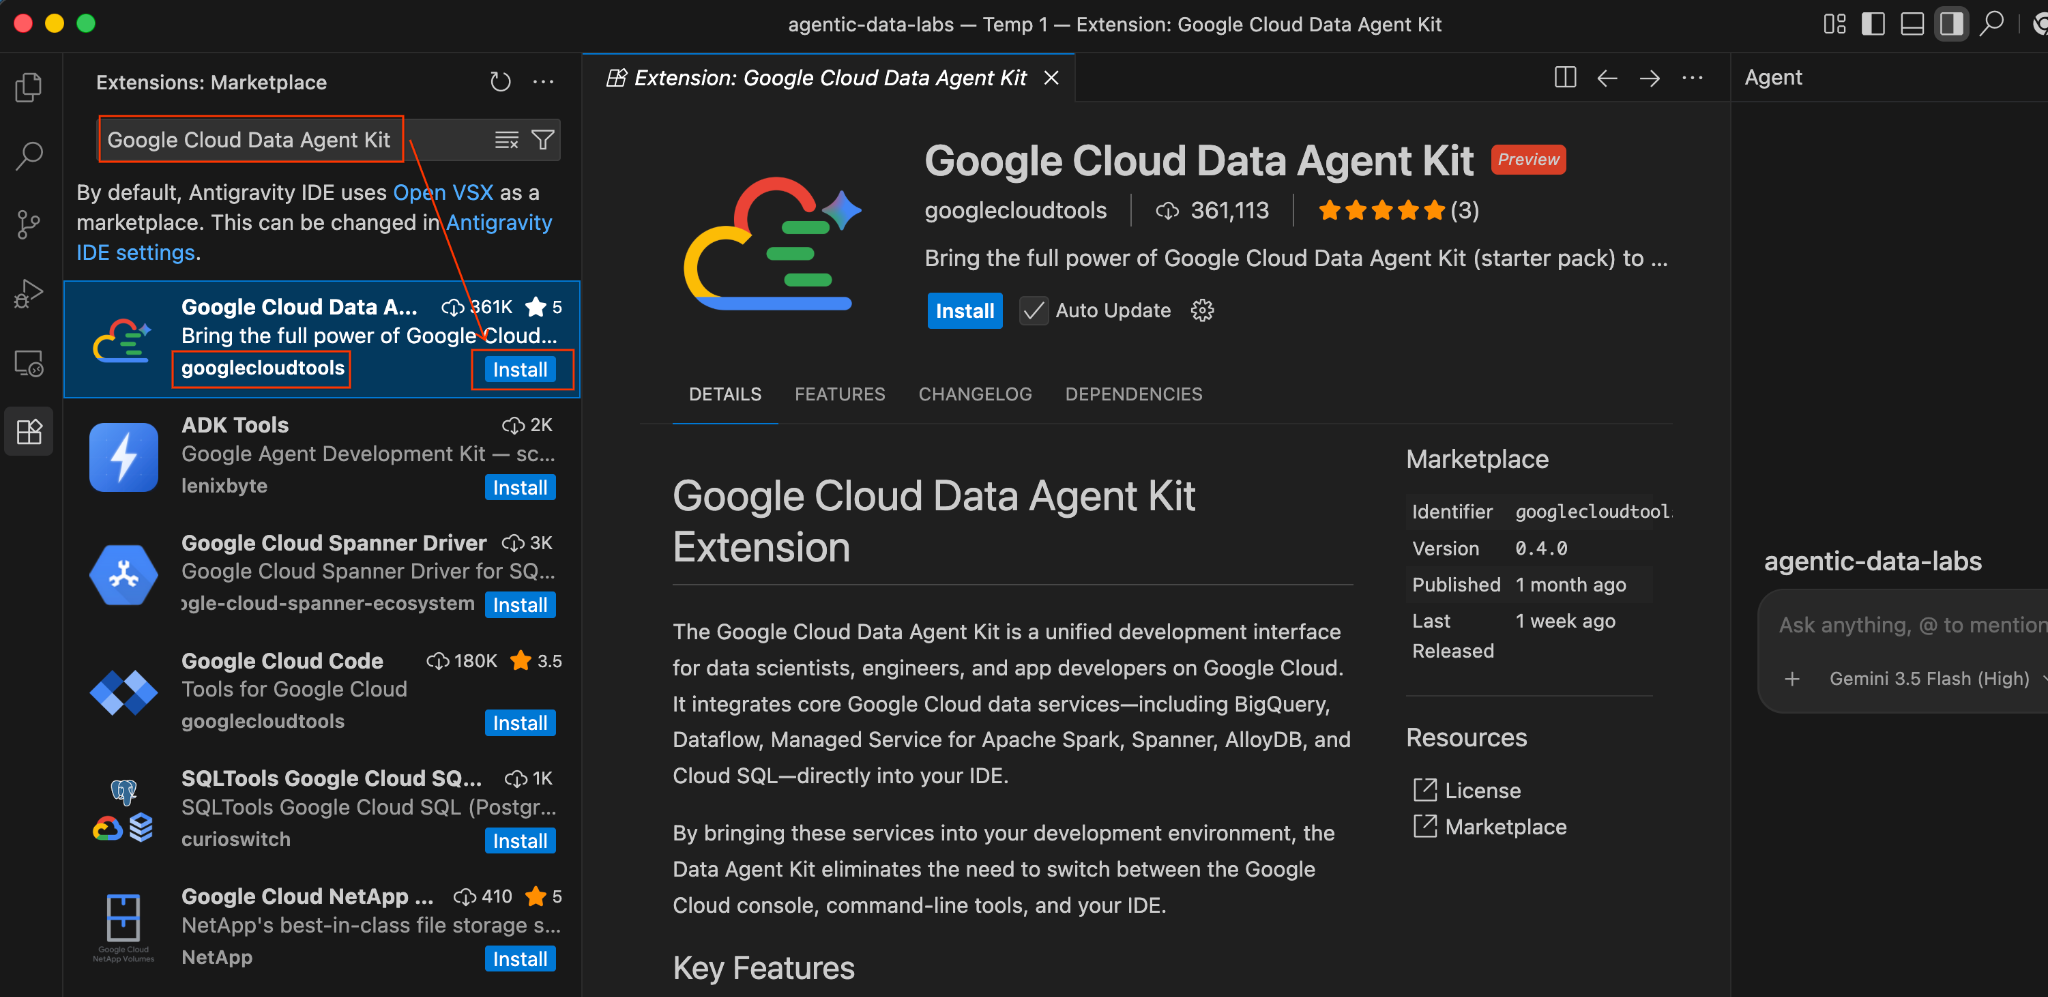
安装完成后,您会在 Antigravity IDE 最左侧的活动栏中看到一个新的 Google Cloud Data Agent Kit 图标。
- 系统应该会自动打开一个名为“欢迎使用 Google Cloud Data Agent Kit”的新手入门页面。如果您尚未登录 Cloud 账号,请按照提示允许访问。
- 在“配置摘要”部分中,找到“项目”字段。点击下拉菜单,然后选择您的 Google Cloud 项目。将区域设置为 us-central1。然后选择“配置 MCP 服务器”。
- 将以下内容粘贴到项目中名为
GEMINI.md的新文件中(请务必将 <<YOUR_PROJECT_ID>> 替换为您的值):
## 1. Project Context
- **Project ID**: <<YOUR_PROJECT_ID>>
- **Domain**: This project is centralized around "Froyo", a brand of frozen yogurt offering multiple flavors.
- **Data**: All froyo, customer, order related information is processed and stored in BigQuery `froyo_data` dataset.

## 2. Execution & Data Processing Rules
- **CRITICAL RULE - Structured Specs**: The semantic and structured information extracted from the PDFs is available in a BigQuery dataset named `froyo_data`.
- **CRITICAL RULE - Customer Data**: Existing Froyo customer data resides in BigQuery in the tables `customers_allergen_data`.
- ** CRITICAL RULE - Sales Data**: Sales data is present in tables `orders` and `order_items`.
- ** CRITICAL RULE - General: When you are referencing a dataset, ensure you are using it with the dataset ID (`froyo_data`) . For example, to query orders table in this dataset you should use `froyo_data.orders`.
- **CRITICAL RULE - Allergen & Ingredient Mapping**: Never join `consistsof` directly to `containsallergen` on `ingredient_id`. The `consistsof` table often contains ingredient names (e.g. `Midnight Base 204`) while `containsallergen` maps CAS/code IDs (e.g. `9412-78-0`). Always bridge them through `froyo_data.ingredient` (`ON c.ingredient_id = i.ingredient_name OR c.ingredient_id = i.ingredient_id`) to accurately detect allergens.
现在,您在 IDE 中拥有了一个功能强大的 AI 智能体,随时可以编写代码、生成 SQL 并分析架构。
现在,我们面临一个有趣的分析挑战:能否将历史销售数据与我们在第 1 部分中从 PDF 中提取的复杂、推断出的过敏原数据关联起来?
5. 通过 IDE 智能体推断智能
让 IDE 智能体来完成繁重的工作。在 ANTIGRAVITY IDE 中打开 Agent Data Kit 对话窗口,并输入以下提示:
Does Midnight Swirl contain any allergen?
系统会请求一系列权限,请根据需要授予。
最后,它会在分析结束时为您检索回答:

太棒了!它正确识别出 Midnight Swirl 商品含有大豆。
现在,我们来问一个稍微复杂一点的问题。在 Antigravity IDE 中发送以下提示:
I want to see the top 5 most popular products purchased by
customers who have a registered 'Dairy' allergy.
响应:

您可以继续。尝试使用以下提示:
Forecast the sales volume of our top non-dairy products
for the next 30 days based on historical data.
无需查找 BQML 语法,Agent Data Kit 即可将确切的 CREATE MODEL 和 ML.FORECAST 代码放入编辑器中。您可以直接在 BigQuery 环境中执行此操作,而无需离开 ANTIGRAVITY IDE!
太棒了!!!
6. BigQuery 中的对话式分析
开发者喜欢 IDE,而业务用户和高管则更习惯使用 Cloud 控制台。他们不想看到 SQL,只想得到答案。
下面我们开始吧:
- 为自己授予所需角色
前往项目的 IAM 页面,为自己授予 Gemini 数据分析数据代理所有者 角色:

此角色授予您创建、修改、共享和删除项目中所有数据智能体的权限。
- 启用所需的 API
前往 Google Cloud 控制台中的 BigQuery。使用页面顶部的导航边栏菜单或搜索菜单,前往“BigQuery”>“智能体”。
点击“启用 Data Analytics API with Gemini”:

同时启用 Gemini in BigQuery API 和 Gemini for Google Cloud API:

现在,您应该会看到新的代理页面:

- 配置代理信息
Agent Name: Froyo Agent
智能体说明:帮助回答与冻酸奶产品、过敏原、配料、配方、客户、订单、销售相关的问题。

- 前往“知识来源”部分,然后从数据集中选择以下所有表:

a. 添加上图中的表,然后点击“添加来源”。
b. 对于每个来源,点击右侧的自定义按钮。您会看到以下表单:

c. 点击“接受”以采用表说明。
d. 点击每个字段说明对应的“接受”。

e. 点击“更新”。
您必须对源中的所有表重复此操作。
- 配置说明
Put the same instructions we used in Antigravity IDE GEMINI.md here:
1. Project Context
Project ID: <<YOUR_PROJECT_ID>>
Domain: This project is centralized around "Froyo", a brand of frozen yogurt offering multiple flavors.
Data: All froyo, customer, order related information is processed and stored in BigQuery froyo_data dataset. Use all the tables and data in the dataset for querying for user questions.
Context: Use Data Agent Kit skills wherever possible.
2. Execution & Data Processing Rules
CRITICAL RULE - Structured Specs: The semantic and structured information extracted from the PDFs is available in a BigQuery dataset named froyo_data.
CRITICAL RULE - Customer Data: Existing Froyo customer data resides in BigQuery in the tables customers_allergen_data. When you are referencing a dataset, ensure you are using it with the dataset ID (froyo_data) . For example, to query orders table in this dataset you should use froyo_data.orders.
- 保存智能体。
7. 与数据对话!
- 在右侧的预览部分进行测试:

提出问题:
Does midnight swirl contain any allergen?

以下是回复内容:

现在,我们来问一个复杂的问题:
I want to see the top 5 most popular products purchased by
customers who have a registered 'Dairy' allergy.
响应:


现在,我们来试试一条深度洞察提示:
Forecast the sales volume of our top non-dairy products
for the next 30 days based on historical data.
您可以看到,它会显示所用的查询,以及表格结果和图表:


哇!因此,图表和数据分析功能非常实用。现在,我们要提出关于产品的终极问题。
8. 终极测试
提出问题:
What will be the top most selling product of 2026


看看最后一条数据洞见。BigQuery 数据智能体不仅给出了一个数字,还明确地将销售预测与我们的库存和原料供应链联系起来,而这些正是我们在第 1 部分中从杂乱的 PDF 文件中提取的数据!
9. 将智能体发布到企业
点击预览代理顶部的发布按钮。

现在,我们已经构建、配置并测试了 Froyo 智能体,接下来可以将其发布给企业中的其他人员。
在代理配置页面的右上角,点击“发布”按钮。
发布后,您和您的共享用户可以立即通过以下三个强大的企业渠道使用您的代理:
- BigQuery:您的数据分析师现在可以直接在智能体中心或 BigQuery Studio SQL 工作区中与此智能体对话。
- Conversational Analytics API:您的开发者可以通过 REST API 访问此智能体,从而将这些精确的对话式分析功能集成到您自己的自定义内部 Web 应用中。
- 数据洞察:高管可以直接在数据洞察中与此智能体互动,并创建动态对话式信息中心。
我们成功地将数据从孤岛中解放出来,直接交到需要它的人手中,就在他们已经工作的地方!
点击已发布的 BigQuery 智能体顶部的“分享”按钮下拉菜单,然后从列表中选择“复制数据洞察中智能体的链接”选项:

将该链接粘贴到浏览器中,然后按 Enter 键。确认代理互动访问权限提醒:

您可以使用数据洞察中新发布的代理开始互动式对话和可视化,您的领导层和其他需要这些信息的团队也可以这样做!
10. 清理
完成本实验后,请务必移除所有用户对您刚刚创建的 BigQuery 智能体的权限。
11. 恭喜!
您已正式构建了一个 Agentic Data Cloud!
您不仅构建了一个简单的聊天机器人,在这五节课中,您成功地从零开始构建了一个完整、现代且经过评估的企业级 AI 系统。您已从“暗数据”过渡到实时交易智能,最后过渡到对话式业务预测。
12. 完整画面
让我们回顾一下,看看我们在这个系列中取得了哪些成果。我们不只是构建了一个简单的聊天机器人。我们构建了一个完整的现代化 Agentic Data Cloud:
第 1 部分:使用 Knowledge Catalog 将 PDF 转换为结构化关系表,从而解锁暗数据。
第 2 部分:通过将分析仓库直接联合到 AlloyDB 事务数据库,打破数据孤岛。
第 3 部分:构建了一个多智能体操作系统,该系统可通过 MCP 协议无缝执行安全的数据库工具,从而为用户赋能
第 4 部分:通过实施严格的评估流水线来捕获幻觉和越狱,确保安全性。
第 5 部分:使用 ANTIGRAVITY IDE 和 BigQuery 中的对话式分析功能普及数据洞见。
这是企业软件的未来。AI 智能体不再只是大语言模型的“套壳”。它是一个完全集成、经过评估且安全的编排引擎,位于统一的数据平台之上。