

1. نظرة عامة
تم تعديل هذا البرنامج التعليمي ليتوافق مع الإصدار 2.2 من TensorFlow.

في هذا الدرس التطبيقي حول الترميز، ستتعلّم كيفية إنشاء شبكة عصبية وتدريبها للتعرّف على الأرقام المكتوبة بخط اليد. أثناء ذلك، وبينما تعمل على تحسين شبكتك العصبية لتحقيق دقة بنسبة% 99، ستتعرّف أيضًا على الأدوات التي يستخدمها خبراء التعلّم العميق لتدريب نماذجهم بكفاءة.
يستخدم هذا الدرس التطبيقي حول الترميز مجموعة بيانات MNIST، وهي مجموعة من 60,000 رقم مصنّف شغلت أجيالاً من حاملي شهادات الدكتوراه لمدة عقدَين تقريبًا. ستحلّ المشكلة باستخدام أقل من 100 سطر من رموز Python / TensorFlow البرمجية.
أهداف الدورة التعليمية
- ما هي الشبكة العصبية وكيفية تدريبها؟
- كيفية إنشاء شبكة عصبية أساسية ذات طبقة واحدة باستخدام tf.keras
- كيفية إضافة المزيد من الطبقات
- كيفية إعداد جدول معدّل التعلّم
- كيفية إنشاء شبكات عصبونية التفافية
- كيفية استخدام تقنيات التسوية: الإسقاط، والتسوية الدفعية
- ما هو المطابقة بشكل مفرط؟
المتطلبات
متصفّح فقط يمكن إجراء ورشة العمل هذه بالكامل باستخدام Google Colaboratory.
الملاحظات
يُرجى إعلامنا إذا لاحظت أي خطأ في هذا المختبر أو إذا كنت تعتقد أنّه يجب تحسينه. نتعامل مع الملاحظات من خلال المشاكل التي يتم الإبلاغ عنها في GitHub [ رابط الملاحظات].
2. البدء السريع في Google Colaboratory
تستخدِم هذه الميزة الاختبارية Google Colaboratory ولا تتطلّب أي إعداد من جانبك. يمكنك تشغيلها من جهاز Chromebook. يُرجى فتح الملف أدناه وتنفيذ الخلايا للتعرّف على دفاتر ملاحظات Colab.

في ما يلي تعليمات إضافية:
اختيار واجهة خلفية لوحدة معالجة الرسومات

في قائمة Colab، اختَر بيئة التشغيل > تغيير نوع بيئة التشغيل، ثم اختَر "وحدة معالجة الرسومات". سيتم الاتصال بوقت التشغيل تلقائيًا عند التنفيذ لأول مرة، أو يمكنك استخدام الزر "ربط" في أعلى يسار الصفحة.
تنفيذ دفتر الملاحظات
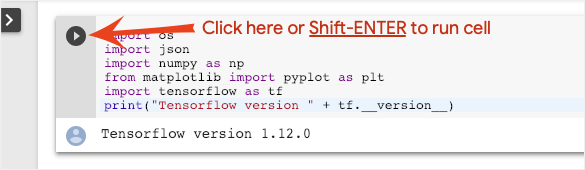
نفِّذ الخلايا واحدة تلو الأخرى من خلال النقر على إحدى الخلايا واستخدام Shift-ENTER. يمكنك أيضًا تشغيل ورقة الملاحظات بأكملها من خلال بيئة التشغيل > تشغيل الكل
جدول المحتويات

تحتوي جميع دفاتر الملاحظات على جدول محتويات. يمكنك فتحها باستخدام السهم الأسود على اليمين.
الخلايا المخفية
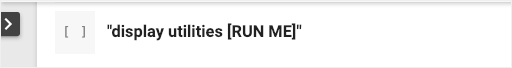
ستعرض بعض الخلايا عناوينها فقط. هذه ميزة خاصة بأوراق ملاحظات Colab. يمكنك النقر مرّتين على هذه الملفات للاطّلاع على الرمز البرمجي بداخلها، ولكنّه عادةً لا يكون مثيرًا للاهتمام. عادةً ما تكون وظائف دعم أو عرض مرئي. ومع ذلك، يجب تشغيل هذه الخلايا لتعريف الدوال بداخلها.
3- تدريب شبكة عصبونية
سنشاهد أولاً تدريب شبكة عصبية. يُرجى فتح دفتر الملاحظات أدناه وتنفيذ جميع الخلايا. لا تركّز على الرمز البرمجي الآن، سنبدأ في شرحه لاحقًا.
أثناء تنفيذ دفتر الملاحظات، ركِّز على الرسومات البيانية. يمكنك الاطّلاع على التفسيرات أدناه.
بيانات التدريب
لدينا مجموعة بيانات من الأرقام المكتوبة بخط اليد والتي تم تصنيفها حتى نعرف ما تمثله كل صورة، أي رقم بين 0 و9. في دفتر الملاحظات، سيظهر لك مقتطف:

ستصنّف الشبكة العصبية التي سننشئها الأرقام المكتوبة بخط اليد في فئاتها العشر (من 0 إلى 9). ويتم ذلك استنادًا إلى مَعلمات داخلية يجب أن تكون لها قيمة صحيحة لكي يعمل التصنيف بشكل جيد. يتم تعلُّم هذه "القيمة الصحيحة" من خلال عملية تدريب تتطلّب "مجموعة بيانات مصنَّفة" تحتوي على صور والإجابات الصحيحة المرتبطة بها.
كيف نعرف ما إذا كانت الشبكة العصبية المدرَّبة تعمل بشكل جيد أم لا؟ إنّ استخدام مجموعة بيانات التدريب لاختبار الشبكة هو بمثابة غش. وقد رأى مجموعة البيانات هذه عدة مرات أثناء التدريب، ومن المؤكد أنّه سيحقق أداءً جيدًا جدًا عليها. نحتاج إلى مجموعة بيانات مصنّفة أخرى لم يتم استخدامها أثناء التدريب لتقييم أداء الشبكة في "العالم الحقيقي". ويُطلق عليها اسم "مجموعة بيانات التحقّق من الصحة".
التدريب
مع تقدّم التدريب، يتم تعديل مَعلمات النموذج الداخلية دفعة واحدة من بيانات التدريب في كل مرة، ويصبح النموذج أفضل وأفضل في التعرّف على الأرقام المكتوبة بخط اليد. يمكنك الاطّلاع عليه في الرسم البياني الخاص بالتدريب:

على اليسار، "الدقة" هي ببساطة النسبة المئوية للأرقام التي تم التعرّف عليها بشكل صحيح. ويزداد مع تقدّم التدريب، وهذا أمر جيد.
على اليمين، يمكننا رؤية "الخسارة". لإجراء التدريب، سنحدّد دالة "الخسارة" التي تمثّل مدى سوء تعرّف النظام على الأرقام، وسنحاول تقليلها. ما تراه هنا هو أنّ الخسارة تنخفض في كلّ من بيانات التدريب وبيانات التحقّق من الصحة مع تقدّم التدريب، وهذا أمر جيد. وهذا يعني أنّ الشبكة العصبونية تتعلّم.
يمثّل المحور السيني عدد "الحقب" أو التكرارات خلال مجموعة البيانات بأكملها.
التوقّعات
بعد تدريب النموذج، يمكننا استخدامه للتعرّف على الأرقام المكتوبة بخط اليد. يوضّح التمثيل البصري التالي مدى جودة الأداء على بضعة أرقام معروضة من الخطوط المحلية (السطر الأول)، ثم على 10,000 رقم من مجموعة بيانات التحقّق. يظهر التصنيف المتوقّع أسفل كل رقم، ويكون باللون الأحمر إذا كان غير صحيح.

كما ترون، هذا النموذج الأوّلي ليس جيدًا جدًا، لكنه لا يزال يتعرّف على بعض الأرقام بشكل صحيح. تبلغ دقة التحقّق النهائي حوالي% 90، وهي نسبة جيدة بالنسبة إلى النموذج البسيط الذي نبدأ به، ولكن هذا يعني أيضًا أنّه لا ينجح في التحقّق من 1, 000 رقم من أصل 10,000 رقم. هذا العدد أكبر بكثير من العدد الذي يمكن عرضه، ولهذا السبب يبدو أنّ جميع الإجابات خاطئة (باللون الأحمر).
الموترات
يتم تخزين البيانات في مصفوفات. تتلاءم صورة بتدرّج الرمادي بحجم 28x28 بكسل مع مصفوفة ثنائية الأبعاد بحجم 28x28. ولكن بالنسبة إلى صورة ملونة، نحتاج إلى المزيد من الأبعاد. هناك 3 قيم ألوان لكل بكسل (أحمر وأخضر وأزرق)، لذا سيلزم جدول ثلاثي الأبعاد بالأبعاد [28 و28 و3]. ولتخزين مجموعة من 128 صورة ملونة، يجب استخدام جدول رباعي الأبعاد بالأبعاد [128, 28, 28, 3].
تُسمّى هذه الجداول المتعدّدة الأبعاد "موترات"، وتُسمّى قائمة أبعادها "الشكل".
4. [INFO]: neural networks 101
باختصار
إذا كنت تعرف جميع المصطلحات بالخط العريض في الفقرة التالية، يمكنك الانتقال إلى التمرين التالي. إذا كنت مبتدئًا في مجال التعلّم العميق، أهلاً بك، ويُرجى مواصلة القراءة.

بالنسبة إلى النماذج التي تم إنشاؤها كتسلسل من الطبقات، يوفّر Keras واجهة Sequential API. على سبيل المثال، يمكن كتابة مصنّف صور يستخدم ثلاث طبقات كثيفة في Keras على النحو التالي:
model = tf.keras.Sequential([
    tf.keras.layers.Flatten(input_shape=[28, 28, 1]),
    tf.keras.layers.Dense(200, activation="relu"),
    tf.keras.layers.Dense(60, activation="relu"),
    tf.keras.layers.Dense(10, activation='softmax') # classifying into 10 classes
])

# this configures the training of the model. Keras calls it "compiling" the model.
model.compile(
  optimizer='adam',
  loss= 'categorical_crossentropy',
  metrics=['accuracy']) # % of correct answers

# train the model
model.fit(dataset, ... )

طبقة كثيفة واحدة
الأرقام المكتوبة بخط اليد في مجموعة بيانات MNIST هي صور بتدرّج الرمادي بحجم 28x28 بكسل. أبسط طريقة لتصنيفها هي استخدام 784 بكسل (28 × 28) كمدخلات لشبكة عصبية ذات طبقة واحدة.

يُجري كل "عصبون" في الشبكة العصبية مجموعًا مرجّحًا لجميع مدخلاته، ويضيف ثابتًا يُعرف باسم "الانحياز"، ثم يمرّر النتيجة من خلال "دالة التنشيط" غير الخطية. "الأوزان" و"الانحيازات" هما مَعلمتان سيتم تحديدهما من خلال التدريب. يتمّ تهيئتها بقيم عشوائية في البداية.
تمثّل الصورة أعلاه شبكة عصبية ذات طبقة واحدة مع 10 خلايا عصبية للناتج لأنّنا نريد تصنيف الأرقام إلى 10 فئات (من 0 إلى 9).
باستخدام عملية ضرب المصفوفات
في ما يلي كيفية تمثيل طبقة شبكة عصبونية تعالج مجموعة من الصور من خلال عملية ضرب المصفوفات:

باستخدام العمود الأول من الأوزان في مصفوفة الأوزان W، نحسب المجموع المرجّح لجميع وحدات البكسل في الصورة الأولى. يتجاوب هذا المجموع مع العصبون الأول. باستخدام العمود الثاني من الأوزان، نفعل الشيء نفسه مع العصبون الثاني وهكذا حتى العصبون العاشر. يمكننا بعد ذلك تكرار العملية للصور الـ 99 المتبقية. إذا أطلقنا على المصفوفة التي تحتوي على 100 صورة اسم X، فإنّ جميع المجموعات المرجّحة للخلايا العصبية العشر، والتي يتم احتسابها على 100 صورة، هي ببساطة X.W، أي عملية ضرب المصفوفات.
يجب أن تضيف كل خلية عصبية الآن الانحياز (قيمة ثابتة). بما أنّ لدينا 10 عصبونات، لدينا 10 ثوابت تحيّز. سنسمّي هذا المتّجه المكوّن من 10 قيم b. يجب إضافته إلى كل سطر من المصفوفة التي تم احتسابها سابقًا. باستخدام بعض السحر الذي يُعرف باسم "البث"، سنكتب هذا باستخدام علامة الجمع البسيطة.
وأخيرًا، نطبّق دالة تنشيط، مثل "softmax" (سيتم توضيحها أدناه) ونحصل على الصيغة التي تصف شبكة عصبية ذات طبقة واحدة، يتم تطبيقها على 100 صورة:

في Keras
باستخدام مكتبات الشبكات العصبونية العالية المستوى، مثل Keras، لن نحتاج إلى تنفيذ هذه الصيغة. ومع ذلك، من المهم أن نفهم أنّ طبقة الشبكة العصبية هي مجرد مجموعة من عمليات الضرب والجمع. في Keras، تتم كتابة طبقة كثيفة على النحو التالي:
tf.keras.layers.Dense(10, activation='softmax')
التعمّق في الموضوع
من السهل ربط طبقات الشبكة العصبونية. تحسب الطبقة الأولى المجموعات المرجّحة من وحدات البكسل. تحسب الطبقات اللاحقة المجموعات المرجّحة لنتائج الطبقات السابقة.

والفرق الوحيد، بصرف النظر عن عدد الخلايا العصبية، سيكون اختيار دالة التنشيط.
دوال التنشيط: relu وsoftmax وsigmoid
عادةً ما تستخدم دالة التنشيط "relu" لجميع الطبقات باستثناء الطبقة الأخيرة. تستخدم الطبقة الأخيرة في المصنّف التنشيط "softmax".

مرة أخرى، تحسب "العصبونة" مجموعًا مرجّحًا لجميع مدخلاتها، وتضيف قيمة تُعرف باسم "الانحياز"، ثم تنقل النتيجة من خلال دالة التنشيط.
تُعرف دالة التنشيط الأكثر شيوعًا باسم "RELU"، وهي اختصار لعبارة Rectified Linear Unit. إنّها دالة بسيطة جدًا كما يظهر في الرسم البياني أعلاه.
كانت دالة التفعيل التقليدية في الشبكات العصبية هي "الدالة السينية"، ولكن تبيّن أنّ "دالة التفعيل" تتمتّع بخصائص تقارب أفضل في كل مكان تقريبًا، وهي الآن الخيار المفضّل.

تفعيل Softmax للتصنيف
تحتوي الطبقة الأخيرة من شبكتنا العصبية على 10 عُقد عصبية لأنّنا نريد تصنيف الأرقام المكتوبة بخط اليد إلى 10 فئات (من 0 إلى 9). يجب أن تعرض 10 أرقام بين 0 و1 تمثّل احتمال أن يكون هذا الرقم 0 أو 1 أو 2 وما إلى ذلك. لذلك، سنستخدم في الطبقة الأخيرة دالّة تفعيل تُسمى "softmax".
يتم تطبيق دالة softmax على متّجه من خلال أخذ الأس لكل عنصر ثم تسوية المتّجه، عادةً عن طريق قسمته على معيار "L1" (أي مجموع القيم المطلقة) بحيث يصل مجموع القيم المسوّاة إلى 1 ويمكن تفسيرها على أنّها احتمالات.
يُطلق على ناتج الطبقة الأخيرة، قبل التفعيل، اسم "اللوغاريتمات" في بعض الأحيان. إذا كان هذا المتّجه L = [L0, L1, L2, L3, L4, L5, L6, L7, L8, L9]، يكون:


فقدان الإنتروبيا المتقاطعة
بعد أن أصبحت شبكتنا العصبية تنتج توقّعات من الصور المُدخَلة، علينا قياس مدى صحة هذه التوقّعات، أي المسافة بين ما تخبرنا به الشبكة والإجابات الصحيحة، والتي تُعرف غالبًا باسم "التصنيفات". يُرجى العِلم أنّ لدينا تصنيفات صحيحة لكل الصور في مجموعة البيانات.
يمكن استخدام أي مسافة، ولكن بالنسبة إلى مشاكل التصنيف، تكون "مسافة الإنتروبيا المتقاطعة" هي الأكثر فعالية. سنسمّي هذا الخطأ أو دالة "الخسارة" على النحو التالي:

نزول التدرّج
"تدريب" الشبكة العصبونية يعني في الواقع استخدام صور وتصنيفات التدريب لضبط الأوزان والانحيازات من أجل تقليل دالة فقدان الإنتروبيا المتقاطعة. إليك طريقة عملها:
الإنتروبيا المتقاطعة هي دالة للأوزان والانحيازات ووحدات البكسل في صورة التدريب وفئتها المعروفة.
إذا حسبنا المشتقات الجزئية للإنتروبيا المتقاطعة بالنسبة إلى جميع الأوزان وجميع الانحيازات، نحصل على "تدرّج" يتم حسابه لصورة وتصنيف وقيمة حالية للأوزان والانحيازات. تذكَّر أنّه يمكن أن يكون لدينا ملايين الأوزان والانحيازات، لذا يبدو أنّ حساب التدرّج يتطلّب الكثير من العمل. لحسن الحظ، تتولّى TensorFlow هذه العملية نيابةً عنا. إنّ الخاصية الرياضية للتدرّج هي أنّه يشير إلى "الأعلى". بما أنّنا نريد الانتقال إلى المكان الذي تكون فيه الإنتروبيا المتداخلة منخفضة، فإنّنا نتّجه في الاتجاه المعاكس. نعدّل معاملات الترجيح والانحياز بجزء من التدرّج. بعد ذلك، نكرّر العملية نفسها مرارًا وتكرارًا باستخدام الدفعات التالية من صور التدريب والتصنيفات، وذلك في حلقة تدريب. نأمل أن يؤدي ذلك إلى تقليل الإنتروبيا المتقاطعة إلى الحد الأدنى، مع العلم أنّه لا يوجد ما يضمن أنّ هذا الحد الأدنى فريد.

التقسيم إلى دفعات صغيرة والزخم
يمكنك احتساب التدرّج على صورة مثال واحدة فقط وتعديل الأوزان والانحيازات على الفور، ولكنّ إجراء ذلك على مجموعة من 128 صورة مثلاً يعطي تدرّجًا يمثّل القيود التي تفرضها صور الأمثلة المختلفة بشكل أفضل، وبالتالي من المرجّح أن يتقارب مع الحلّ بشكل أسرع. حجم الدُفعة المصغّرة هو مَعلمة قابلة للتعديل.
تتميّز هذه التقنية، التي تُعرف أحيانًا باسم "النزول التدريجي العشوائي"، بميزة عملية أخرى، وهي أنّ استخدام الدُفعات يعني أيضًا استخدام مصفوفات أكبر، وعادةً ما يكون من الأسهل تحسينها على وحدات معالجة الرسومات ووحدات معالجة الموتّرات.
ومع ذلك، يمكن أن يكون التقارب فوضويًا بعض الشيء، ويمكن أن يتوقف حتى إذا كان متجه التدرّج كله أصفارًا. هل يعني ذلك أنّنا عثرنا على حدّ أدنى؟ ليس دائمًا. يمكن أن يكون مكوّن التدرّج اللوني صفرًا عند الحدّ الأدنى أو الحدّ الأقصى. مع وجود متجه تدرّج يحتوي على ملايين العناصر، إذا كانت جميعها أصفارًا، يكون احتمال أن يتوافق كل صفر مع نقطة دنيا وألا يتوافق أي منها مع نقطة قصوى صغيرًا جدًا. في مساحة ذات أبعاد عديدة، تكون نقاط السرج شائعة جدًا ولا نريد التوقف عندها.

صورة توضيحية: نقطة سرج يكون الانحدار 0 ولكنّه ليس الحد الأدنى في جميع الاتجاهات. (معلومات تحديد مصدر الصورة Wikimedia: By Nicoguaro - Own work, CC BY 3.0)
الحلّ هو إضافة بعض الزخم إلى خوارزمية التحسين حتى تتمكّن من تجاوز نقاط السرج بدون توقّف.
مسرد المصطلحات
الدُفعات أو الدُفعات الصغيرة: يتم التدريب دائمًا على دُفعات من بيانات التدريب والتصنيفات. يساعد ذلك الخوارزمية في التوافق. عادةً ما تكون سمة "الحزمة" هي السمة الأولى لموترات البيانات. على سبيل المثال، يحتوي متّجه متعدّد الأبعاد بالشكل [100, 192, 192, 3] على 100 صورة بحجم 192x192 بكسل مع ثلاث قيم لكل بكسل (النموذج اللوني أحمر أخضر أزرق).
فقدان الإنتروبيا المتقاطعة: دالة فقدان خاصة تُستخدم غالبًا في أدوات التصنيف.
الطبقة الكثيفة: هي طبقة من الخلايا العصبية حيث تكون كل خلية عصبية مرتبطة بجميع الخلايا العصبية في الطبقة السابقة.
الميزات: يُطلق أحيانًا على مدخلات الشبكة العصبية اسم "الميزات". يُطلق على فن تحديد أجزاء مجموعة البيانات (أو مجموعات الأجزاء) التي يجب إدخالها إلى الشبكة العصبونية للحصول على توقّعات جيدة اسم "هندسة الخصائص".
التصنيفات: اسم آخر "للفئات" أو الإجابات الصحيحة في مشكلة التصنيف الخاضع للإشراف
معدّل التعلّم: جزء من التدرّج يتم من خلاله تعديل الأوزان والانحيازات في كل تكرار من حلقة التدريب.
القيم المنطقية: تُسمى نواتج إحدى طبقات الخلايا العصبية قبل تطبيق دالة التنشيط "القيم المنطقية". يأتي المصطلح من "الدالة اللوجستية" المعروفة أيضًا باسم "الدالة السينية" التي كانت دالة التنشيط الأكثر شيوعًا. تم اختصار "مخرجات الخلايا العصبية قبل الدالة اللوجستية" إلى "اللوغاريتمات".
loss: دالة الخطأ التي تقارن نواتج الشبكة العصبية بالإجابات الصحيحة
الخلية العصبية: تحسب المجموع المرجّح لمدخلاتها، وتضيف تحيّزًا، وتمرّر النتيجة من خلال دالة تنشيط.
الترميز الأحادي: يتم ترميز الفئة 3 من 5 كمتجه من 5 عناصر، وكلها أصفار باستثناء العنصر الثالث الذي تكون قيمته 1.
relu: وحدة خطية مصحَّحة دالّة تفعيل شائعة للعصبونات
sigmoid: دالّة تفعيل أخرى كانت شائعة وما زالت مفيدة في حالات خاصة.
softmax: هي دالة تنشيط خاصة تعمل على متّجه، وتزيد الفرق بين أكبر مكوّن وجميع المكوّنات الأخرى، كما أنّها تعمل على تسوية المتّجه ليكون مجموع عناصره 1، وبالتالي يمكن تفسيره على أنّه متّجه احتمالات. يُستخدَم كخطوة أخيرة في المصنّفات.
متّجه متعدّد الأبعاد: "متّجه متعدّد الأبعاد" يشبه المصفوفة ولكن مع عدد عشوائي من الأبعاد. الموتر أحادي الأبعاد هو متجه. الموتر الثنائي الأبعاد هو مصفوفة. ويمكنك بعد ذلك الحصول على موترات ذات 3 أو 4 أو 5 أبعاد أو أكثر.
5- لننتقل إلى التعليمات البرمجية
لنرجع إلى دفتر الملاحظات الدراسي ونقرأ الرمز هذه المرة.
لنستعرض كل الخلايا في ورقة الملاحظات هذه.
الخلية "المَعلمات"
يتم هنا تحديد حجم المجموعة وعدد مرات التدريب وموقع ملفات البيانات. تتم استضافة ملفات البيانات في حزمة Google Cloud Storage (GCS)، ولهذا السبب يبدأ عنوانها بـ gs://
الخلية "عمليات الاستيراد"
يتم استيراد جميع مكتبات Python الضرورية هنا، بما في ذلك TensorFlow وmatplotlib للرسومات البيانية.
الخلية "أدوات عرض البيانات [RUN ME]****"
تحتوي هذه الخلية على رمز مرئي غير مهم. يتم تصغيرها تلقائيًا، ولكن يمكنك فتحها وإلقاء نظرة على الرمز البرمجي عندما يتوفر لديك الوقت من خلال النقر عليها مرّتين.
الخلية "tf.data.Dataset: تحليل الملفات وإعداد مجموعات بيانات التدريب والتحقّق"
استخدمت هذه الخلية واجهة برمجة التطبيقات tf.data.Dataset لتحميل مجموعة بيانات MNIST من ملفات البيانات. ليس من الضروري قضاء الكثير من الوقت في هذه الخلية. إذا كنت مهتمًا بواجهة برمجة التطبيقات tf.data.Dataset، إليك برنامجًا تعليميًا يشرحها: مسارات بيانات بسرعة وحدة معالجة الموتّرات (TPU). في الوقت الحالي، تشمل الأساسيات ما يلي:
يتم تخزين الصور والتصنيفات (الإجابات الصحيحة) من مجموعة بيانات MNIST في سجلات ثابتة الطول في 4 ملفات. يمكن تحميل الملفات باستخدام دالة السجلّ الثابت المخصّصة:
imagedataset = tf.data.FixedLengthRecordDataset(image_filename, 28*28, header_bytes=16)
لدينا الآن مجموعة بيانات من وحدات بايت للصور. ويجب فك ترميزها إلى صور. نحدّد دالة لإجراء ذلك، ولا يتم ضغط الصورة، لذا لا تحتاج الدالة إلى فك ترميز أي شيء (decode_raw لا تفعل أي شيء أساسًا). يتم بعد ذلك تحويل الصورة إلى قيم نقطة عائمة بين 0 و1. يمكننا إعادة تشكيلها هنا كصورة ثنائية الأبعاد، ولكننا في الواقع نحتفظ بها كمجموعة مسطّحة من وحدات البكسل بحجم 28*28 لأنّ هذا ما تتوقّعه الطبقة الكثيفة الأولية.
def read_image(tf_bytestring):
    image = tf.io.decode_raw(tf_bytestring, tf.uint8)
    image = tf.cast(image, tf.float32)/256.0
    image = tf.reshape(image, [28*28])
    return image
نطبّق هذه الدالة على مجموعة البيانات باستخدام .map ونحصل على مجموعة بيانات من الصور:
imagedataset = imagedataset.map(read_image, num_parallel_calls=16)
نستخدم النوع نفسه من القراءة وفك الترميز للتصنيفات، ونجمع .zip الصور والتصنيفات معًا:
dataset = tf.data.Dataset.zip((imagedataset, labelsdataset))
لدينا الآن مجموعة بيانات من أزواج (صورة، تصنيف). هذا ما يتوقّعه نموذجنا. لسنا مستعدين تمامًا لاستخدامه في دالة التدريب بعد:
dataset = dataset.cache()
dataset = dataset.shuffle(5000, reshuffle_each_iteration=True)
dataset = dataset.repeat()
dataset = dataset.batch(batch_size)
dataset = dataset.prefetch(tf.data.experimental.AUTOTUNE)
تحتوي واجهة برمجة التطبيقات tf.data.Dataset على جميع دوال الأدوات المساعدة اللازمة لإعداد مجموعات البيانات:
يخزّن .cache مجموعة البيانات مؤقتًا في ذاكرة الوصول العشوائي (RAM). هذه مجموعة بيانات صغيرة جدًا، لذا ستنجح العملية. .shuffle ترتّبها عشوائيًا مع مخزن مؤقت يتضمّن 5000 عنصر. من المهم ترتيب بيانات التدريب بشكل عشوائي. تعيد .repeat عرض مجموعة البيانات. وسنتدرّب عليه عدة مرات (عدة دورات تدريبية). تجمع .batch صورًا وتصنيفات متعددة في دفعة صغيرة. أخيرًا، يمكن .prefetch استخدام وحدة المعالجة المركزية لإعداد المجموعة التالية أثناء تدريب المجموعة الحالية على وحدة معالجة الرسومات.
يتم إعداد مجموعة بيانات التحقّق بطريقة مشابهة. نحن الآن على استعداد لتحديد نموذج واستخدام مجموعة البيانات هذه لتدريبه.
الخلية "نموذج Keras"
ستكون جميع نماذجنا عبارة عن تسلسلات مباشرة من الطبقات، لذا يمكننا استخدام نمط tf.keras.Sequential لإنشائها. في البداية، تكون طبقة كثيفة واحدة. تحتوي هذه الطبقة على 10 عُقد عصبية لأنّنا نصنّف الأرقام المكتوبة بخط اليد إلى 10 فئات. تستخدم هذه الشبكة وظيفة التنشيط "softmax" لأنّها الطبقة الأخيرة في المصنّف.
يحتاج نموذج Keras أيضًا إلى معرفة شكل المدخلات. يمكن استخدام tf.keras.layers.Input لتحديدها. في هذه الحالة، تكون متجهات الإدخال متجهات مسطّحة لقيم وحدات البكسل بطول 28*28.
model = tf.keras.Sequential(
  [
    tf.keras.layers.Input(shape=(28*28,)),
    tf.keras.layers.Dense(10, activation='softmax')
  ])

model.compile(optimizer='sgd',
              loss='categorical_crossentropy',
              metrics=['accuracy'])

# print model layers
model.summary()

# utility callback that displays training curves
plot_training = PlotTraining(sample_rate=10, zoom=1)
يتم إعداد النموذج في Keras باستخدام الدالة model.compile. نستخدم هنا أداة التحسين الأساسية 'sgd' (نزول التدرّج العشوائي). يتطلّب نموذج التصنيف دالة خسارة الإنتروبيا المتداخلة، تُعرف باسم 'categorical_crossentropy' في Keras. أخيرًا، نطلب من النموذج حساب مقياس 'accuracy'، وهو النسبة المئوية للصور المصنَّفة بشكل صحيح.
توفّر Keras الأداة المساعدة model.summary() الرائعة التي تطبع تفاصيل النموذج الذي أنشأته. أضاف المدرّب اللطيف الأداة PlotTraining (المحدّدة في خلية "أدوات التصوّر") التي ستعرض منحنيات تدريب مختلفة أثناء التدريب.
الخطوة "تدريب النموذج والتحقّق من صحته"
هذا هو المكان الذي يتم فيه التدريب، وذلك من خلال استدعاء model.fit وتمرير كلّ من مجموعتَي بيانات التدريب والتحقّق. تُجري Keras تلقائيًا عملية تحقّق في نهاية كل حقبة.
model.fit(training_dataset, steps_per_epoch=steps_per_epoch, epochs=EPOCHS,
          validation_data=validation_dataset, validation_steps=1,
          callbacks=[plot_training])
في Keras، يمكن إضافة سلوكيات مخصّصة أثناء التدريب باستخدام عمليات معاودة الاتصال. هذه هي الطريقة التي تم بها تنفيذ الرسم البياني للتدريب الذي يتم تعديله ديناميكيًا في ورشة العمل هذه.
الخلية "عرض التوقعات"
بعد تدريب النموذج، يمكننا الحصول على توقّعات منه من خلال استدعاء model.predict():
probabilities = model.predict(font_digits, steps=1)
predicted_labels = np.argmax(probabilities, axis=1)
لقد أعددنا هنا مجموعة من الأرقام المطبوعة المعروضة من الخطوط المحلية، وذلك كاختبار. تذكَّر أنّ الشبكة العصبية تعرض متجهًا من 10 احتمالات من دالة "softmax" النهائية. للحصول على التصنيف، علينا معرفة الاحتمالية الأكبر. تنفّذ الدالة np.argmax من مكتبة numpy هذه العملية.
لفهم سبب الحاجة إلى المَعلمة axis=1، يُرجى تذكُّر أنّنا عالجنا مجموعة من 128 صورة، وبالتالي يعرض النموذج 128 متّجهًا من الاحتمالات. يكون شكل موتر الإخراج [128, 10]. نحتسب argmax على مستوى الاحتمالات العشرة التي يتم عرضها لكل صورة، وبالتالي axis=1 (المحور الأول هو 0).
يتعرّف هذا النموذج البسيط على% 90 من الأرقام. لا بأس بهذه النتيجة، ولكنّك ستحسّنها بشكل كبير الآن.

6. إضافة طبقات

لتحسين دقة التعرّف، سنضيف المزيد من الطبقات إلى الشبكة العصبية.

نحتفظ بدالة softmax كدالّة التفعيل في الطبقة الأخيرة لأنّها الأنسب للتصنيف. في الطبقات الوسيطة، سنستخدم دالة التنشيط الأكثر كلاسيكية: دالة سيغمويد:
على سبيل المثال، يمكن أن يبدو النموذج على النحو التالي (لا تنسَ الفواصل، إذ تأخذ tf.keras.Sequential قائمة قيم مفصولة بفاصلة من الطبقات):
model = tf.keras.Sequential(
  [
      tf.keras.layers.Input(shape=(28*28,)),
      tf.keras.layers.Dense(200, activation='sigmoid'),
      tf.keras.layers.Dense(60, activation='sigmoid'),
      tf.keras.layers.Dense(10, activation='softmax')
  ])
اطّلِع على "ملخّص" النموذج. ويحتوي الآن على 10 أضعاف المَعلمات على الأقل. يجب أن يكون أفضل بعشر مرات! ولكن لسبب ما، لا يمكن ذلك ...

يبدو أنّ الخسارة قد ارتفعت بشكل كبير أيضًا. هناك خطأ ما.
7. اعتبارات خاصة للشبكات العميقة
لقد جرّبت للتو الشبكات العصبونية، كما كان يصمّمها الأشخاص في الثمانينيات والتسعينيات. لذلك، لم يكن من المستغرب أن يتخلّوا عن الفكرة، ما أدّى إلى ما يُعرف باسم "خريف الذكاء الاصطناعي". في الواقع، كلما أضفت طبقات، زادت صعوبة تقارب الشبكات العصبية.
تبيّن أنّ الشبكات العصبية العميقة التي تتضمّن العديد من الطبقات (20 أو 50 أو حتى 100 طبقة اليوم) يمكن أن تعمل بشكل جيد جدًا، شرط توفُّر بعض الحيل الرياضية لجعلها تتقارب. إنّ اكتشاف هذه الحيل البسيطة هو أحد أسباب النهضة التي شهدها التعلّم العميق في العقد الأول من الألفية الثانية.
دالة التفعيل RELU
في الواقع، دالة التنشيط السينية تسبّب مشاكل كبيرة في الشبكات العميقة. فهي تقلّل جميع القيم بين 0 و1، وعندما تفعل ذلك بشكل متكرر، يمكن أن تختفي مخرجات الخلايا العصبية وتدرّجاتها تمامًا. تمت الإشارة إليه لأسباب تاريخية، ولكن تستخدم الشبكات الحديثة RELU (وحدة خطية مصحَّحة) التي تبدو على النحو التالي:

من ناحية أخرى، فإنّ دالة relu لها مشتقة تساوي 1، على الأقل على الجانب الأيمن. باستخدام تنشيط RELU، حتى إذا كانت التدرجات اللونية الواردة من بعض الخلايا العصبية صفرًا، ستكون هناك دائمًا خلايا أخرى تعطي تدرجًا لونيًا واضحًا غير صفري ويمكن أن يستمر التدريب بوتيرة جيدة.
أداة تحسين أفضل
في المساحات العالية الأبعاد، مثل المساحة هنا التي تضمّ حوالي 10 آلاف وزن وانحياز، تكون "نقاط السرج" شائعة. هذه نقاط ليست الحد الأدنى المحلي، ولكن يكون فيها التدرّج صفرًا، ويبقى مُحسِّن النزول التدرّجي عالقًا فيها. تتضمّن TensorFlow مجموعة كاملة من أدوات التحسين المتاحة، بما في ذلك بعض الأدوات التي تعمل مع مقدار من القصور الذاتي وستتجاوز نقاط السرج بأمان.
عمليات التهيئة العشوائية
إنّ فن تهيئة الأوزان والتحيزات قبل التدريب هو مجال بحثي بحد ذاته، وقد نُشرت العديد من الأوراق البحثية حول هذا الموضوع. يمكنك الاطّلاع على جميع أدوات التهيئة المتاحة في Keras هنا. لحسن الحظ، تتّبع Keras الإجراء الصحيح تلقائيًا وتستخدم أداة التهيئة 'glorot_uniform' التي تُعدّ الأفضل في جميع الحالات تقريبًا.
ليس عليك اتّخاذ أي إجراء، لأنّ Keras يتّخذ الإجراء المناسب تلقائيًا.
NaN ???
تتضمّن صيغة الإنتروبيا المتقاطعة لوغاريتمًا، وقيمة log(0) هي "ليس رقمًا" (NaN، وهو عطل عددي إذا كنت تفضّل ذلك). هل يمكن أن تكون قيمة الإدخال في الإنتروبيا المتداخلة 0؟ تأتي المدخلات من دالة softmax التي تكون في الأساس دالة أسية، والدالة الأسية لا تساوي صفرًا أبدًا. إذًا نحن بأمان.
حقًا؟ في عالم الرياضيات الجميل، سنكون في أمان، ولكن في عالم الكمبيوتر، فإنّ exp(-150) الممثَّل بتنسيق float32 هو صفر تمامًا، وبالتالي يتعطّل حساب الإنتروبيا المتقاطعة.
لحسن الحظ، ليس عليك اتّخاذ أي إجراء هنا أيضًا، لأنّ Keras يتولّى ذلك ويحسب دالة softmax متبوعة بدالة الإنتروبيا المتقاطعة بطريقة دقيقة للغاية لضمان الاستقرار العددي وتجنُّب قيم NaN المخيفة.
هل تم بنجاح؟

من المفترض أن تصل الآن إلى دقة تبلغ% 97. الهدف من ورشة العمل هذه هو تحقيق نسبة أعلى من% 99، لذا لنواصل العمل.
إذا واجهت صعوبة، إليك الحلّ في هذه المرحلة:
8. اضمحلال معدّل التعلّم
هل يمكننا محاولة التدريب بشكل أسرع؟ معدّل التعلّم التلقائي في محسِّن Adam هو 0.001. لنجرّب زيادته.
يبدو أنّ زيادة السرعة لا تساعد كثيرًا، فما كل هذه الضوضاء؟

من الواضح أنّ منحنيات التدريب تتضمّن الكثير من التشويش، ويمكن ملاحظة ذلك في منحنيات التحقّق التي تتأرجح صعودًا وهبوطًا. وهذا يعني أنّنا نتحرّك بسرعة كبيرة. يمكننا العودة إلى السرعة السابقة، ولكن هناك طريقة أفضل.

الحلّ الجيّد هو البدء بسرعة وتقليل معدّل التعلّم بشكل كبير. في Keras، يمكنك إجراء ذلك باستخدام عملية الاستدعاء tf.keras.callbacks.LearningRateScheduler.
رمز مفيد للنسخ واللصق:
# lr decay function
def lr_decay(epoch):
  return 0.01 * math.pow(0.6, epoch)

# lr schedule callback
lr_decay_callback = tf.keras.callbacks.LearningRateScheduler(lr_decay, verbose=True)

# important to see what you are doing
plot_learning_rate(lr_decay, EPOCHS)
لا تنسَ استخدام lr_decay_callback الذي أنشأته. أضِفها إلى قائمة الدوالّ التي يتم استدعاؤها في model.fit:
model.fit(..., callbacks=[plot_training, lr_decay_callback])
ويُحدث هذا التغيير البسيط تأثيرًا مذهلاً. ستلاحظ أنّ معظم التشويش قد اختفى وأنّ دقة الاختبار أصبحت الآن أعلى من% 98 بشكل مستمر.

9. التسرب، المطابقة بشكل مفرط
يبدو أنّ النموذج يتقارب بشكل جيد الآن. لنحاول التوغّل أكثر في التفاصيل.
هل يساعد ذلك؟

لا، فالدقة لا تزال ثابتة عند% 98، ويمكنك الاطّلاع على فقدان التحقّق. إنّها تتزايد! تعمل خوارزمية التعلّم على بيانات التدريب فقط وتحسِّن من خسارة التدريب وفقًا لذلك. ولا يرى أبدًا بيانات التحقّق، لذا ليس من المستغرب أن يتوقف عمله بعد فترة عن التأثير في خسارة التحقّق التي تتوقف عن الانخفاض بل وترتفع أحيانًا.
لا يؤثّر ذلك بشكل مباشر في إمكانات التعرّف على العالم الحقيقي في نموذجك، ولكنّه سيمنعك من تنفيذ العديد من التكرارات، وهو بشكل عام علامة على أنّ التدريب لم يعُد له تأثير إيجابي.

يُطلق على هذا الانفصال عادةً اسم "التطابق الزائد"، وعندما تلاحظه، يمكنك محاولة تطبيق أسلوب تسوية يُعرف باسم "التسرب". تستهدف تقنية التسرب العصبونات العشوائية في كل تكرار للتدريب.
هل نجح الأمر؟

تظهر الضوضاء مجددًا (وهذا أمر متوقّع نظرًا لطريقة عمل الانقطاع). يبدو أنّ فقدان صحة البيانات لم يعُد يزداد، ولكنّه أعلى بشكل عام مما كان عليه بدون التسرب. وانخفضت دقة التحقّق قليلاً. هذه نتيجة مخيّبة للآمال إلى حدّ ما.
يبدو أنّ عملية الحذف لم تكن الحلّ الصحيح، أو ربما يكون "المطابقة بشكل مفرط" مفهومًا أكثر تعقيدًا ولا يمكن حلّ بعض أسبابه من خلال عملية الحذف؟
ما هو "المطابقة بشكل مفرط"؟ يحدث فرط التخصيص عندما تتعلّم الشبكة العصبونية "بشكل سيئ"، بطريقة تناسب أمثلة التدريب ولكنها لا تناسب البيانات الواقعية. هناك أساليب تسوية، مثل التسرب، يمكن أن تجبر النموذج على التعلّم بطريقة أفضل، ولكن الإفراط في التكيّف له أيضًا جذور أعمق.

يحدث الإفراط الأساسي في التكيّف عندما يكون لدى الشبكة العصبية عدد كبير جدًا من درجات الحرية للمشكلة المطروحة. لنفترض أنّ لدينا العديد من الخلايا العصبية التي يمكن للشبكة تخزين جميع صور التدريب فيها ثم التعرّف عليها من خلال مطابقة الأنماط. ولن ينجح في التعامل مع بيانات العالم الواقعي على الإطلاق. يجب أن تكون الشبكة العصبية محدودة إلى حد ما حتى يتم إجبارها على تعميم ما تتعلمه أثناء التدريب.
إذا كانت لديك بيانات تدريب قليلة جدًا، يمكن حتى لشبكة صغيرة أن تحفظها عن ظهر قلب وستلاحظ "الملاءمة الزائدة". بشكل عام، تحتاج دائمًا إلى الكثير من البيانات لتدريب الشبكات العصبية.
أخيرًا، إذا كنت قد نفّذت كل الخطوات بشكل صحيح، وجرّبت أحجامًا مختلفة للشبكة للتأكّد من أنّ درجات الحرية محدودة، وطبّقت التسرب، ودربت النموذج على الكثير من البيانات، قد تظل عالقًا عند مستوى أداء لا يبدو أنّ هناك أي شيء يمكنه تحسينه. وهذا يعني أنّ شبكتك العصبية، بشكلها الحالي، غير قادرة على استخراج المزيد من المعلومات من بياناتك، كما هو الحال هنا.
تذكَّر كيف نستخدم صورنا، التي تم تسويتها في متّجه واحد؟ كانت تلك فكرة سيئة للغاية. تتكوّن الأرقام المكتوبة بخط اليد من أشكال، وقد تجاهلنا معلومات الأشكال عند تسوية وحدات البكسل. ومع ذلك، هناك نوع من الشبكات العصبية يمكنه الاستفادة من معلومات الشكل، وهو الشبكات الالتفافية. لنجرّبها.
إذا واجهت صعوبة، إليك الحلّ في هذه المرحلة:
10. [INFO] الشبكات الالتفافية
باختصار
إذا كنت تعرف جميع المصطلحات بالخط العريض في الفقرة التالية، يمكنك الانتقال إلى التمرين التالي. إذا كنت مبتدئًا في استخدام الشبكات العصبونية الالتفافية، يُرجى مواصلة القراءة.

صورة توضيحية: فلترة صورة باستخدام فلترَين متتاليَين يتألف كل منهما من 48 وزنًا قابلاً للتعلم (4x4x3).
في ما يلي شكل شبكة عصبونية التفافية بسيطة في Keras:
model = tf.keras.Sequential([
    tf.keras.layers.Reshape(input_shape=(28*28,), target_shape=(28, 28, 1)),
    tf.keras.layers.Conv2D(kernel_size=3, filters=12, activation='relu'),
    tf.keras.layers.Conv2D(kernel_size=6, filters=24, strides=2, activation='relu'),
    tf.keras.layers.Conv2D(kernel_size=6, filters=32, strides=2, activation='relu'),
    tf.keras.layers.Flatten(),
    tf.keras.layers.Dense(10, activation='softmax')
])
في إحدى طبقات الشبكة الالتفافية، تقوم إحدى "الخلايا العصبية" بإجراء مجموع مرجّح لوحدات البكسل التي تعلوها مباشرةً، وذلك على مستوى منطقة صغيرة من الصورة فقط. تضيف هذه الطبقة تحيزًا وتمرّر المجموع من خلال دالّة التفعيل، تمامًا كما تفعل عصبون في طبقة كثيفة عادية. بعد ذلك، يتم تكرار هذه العملية على مستوى الصورة بأكملها باستخدام الأوزان نفسها. تذكَّر أنّه في الطبقات الكثيفة، كان لكل عصبون أوزانه الخاصة. في هذه الحالة، تنزلق "رقعة" واحدة من الأوزان على الصورة في كلا الاتجاهين (وهي عملية "التفاف"). يحتوي الناتج على عدد من القيم يساوي عدد وحدات البكسل في الصورة (مع العلم أنّه يجب إضافة بعض المساحة المتروكة على الحواف). إنّها عملية فلترة. في الصورة التوضيحية أعلاه، يتم استخدام فلتر يتضمّن 48 وزنًا، أي 4x4x3=48.
ومع ذلك، لن يكون 48 وزنًا كافيًا. لإضافة المزيد من درجات الحرية، نكرّر العملية نفسها باستخدام مجموعة جديدة من معاملات الترجيح. يؤدي ذلك إلى إنشاء مجموعة جديدة من نتائج الفلتر. لنسمِّها "قناة" للنتائج، وذلك قياسًا على قنوات الأحمر والأخضر والأزرق في الصورة المدخلة.

يمكن جمع مجموعتَي الأوزان (أو أكثر) في موتر واحد عن طريق إضافة بُعد جديد. يمنحنا هذا الشكل العام لموتر الأوزان في الطبقة الالتفافية. بما أنّ عدد قنوات الإدخال والإخراج هي مَعلمات، يمكننا البدء في تجميع الطبقات الالتفافية وتسلسلها.

صورة توضيحية: تحوّل شبكة عصبية التفافية "مكعبات" البيانات إلى "مكعبات" أخرى من البيانات.
الالتفافات المخطَّطة، والتجميع الأقصى
ومن خلال إجراء عمليات الالتفاف بخطوة 2 أو 3، يمكننا أيضًا تقليل حجم مكعّب البيانات الناتج في أبعاده الأفقية. هناك طريقتان شائعتان لإجراء ذلك:
- الالتفاف المتقطع: فلتر منزلق كما هو موضح أعلاه ولكن مع خطوة >1
- التجميع الأقصى: نافذة منزلقة تطبّق عملية MAX (عادةً على رقع 2x2، يتم تكرارها كل بكسلَين)
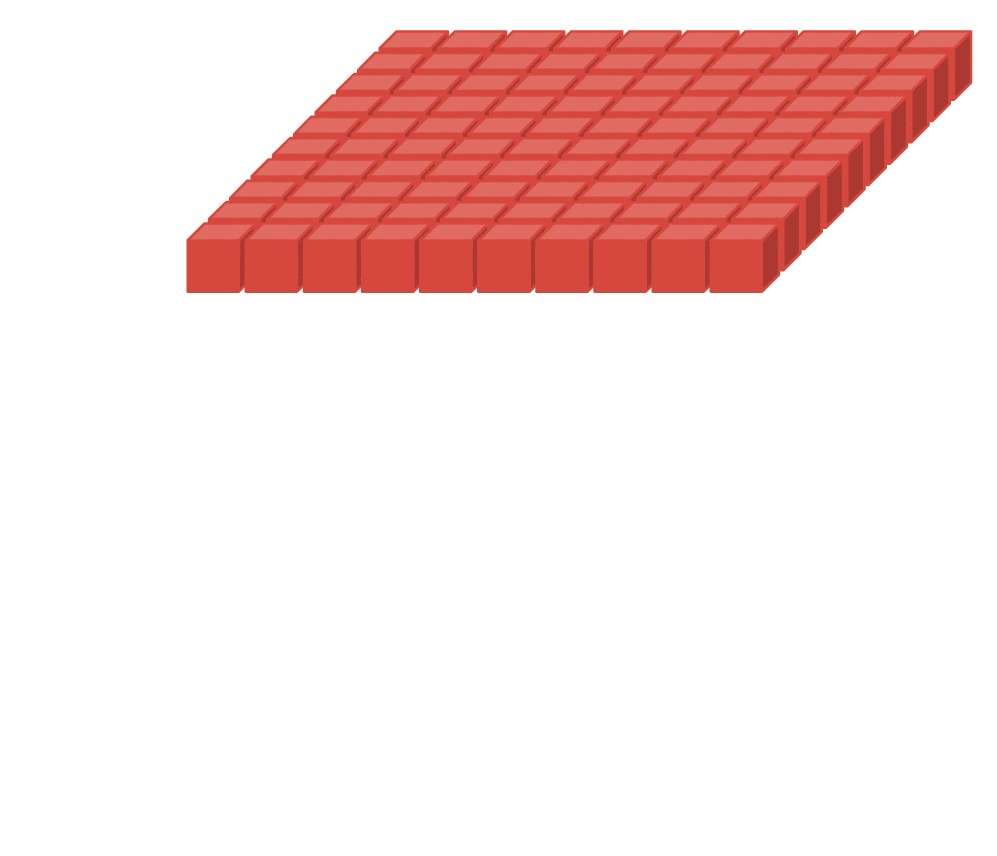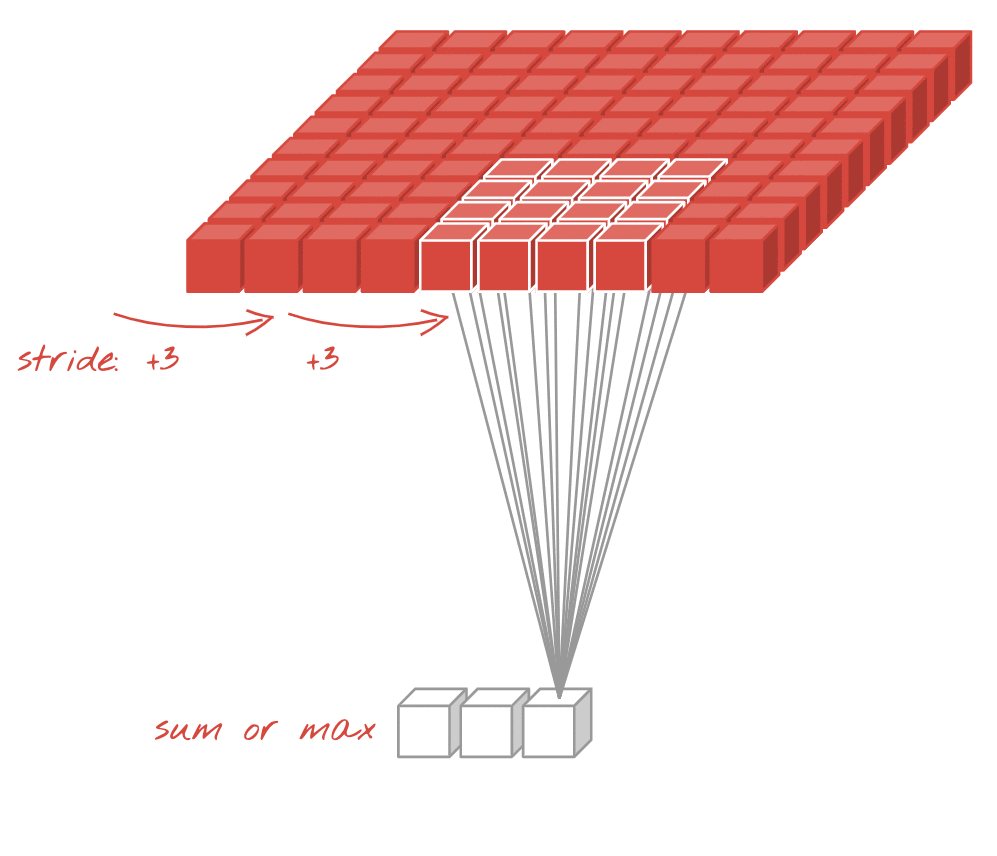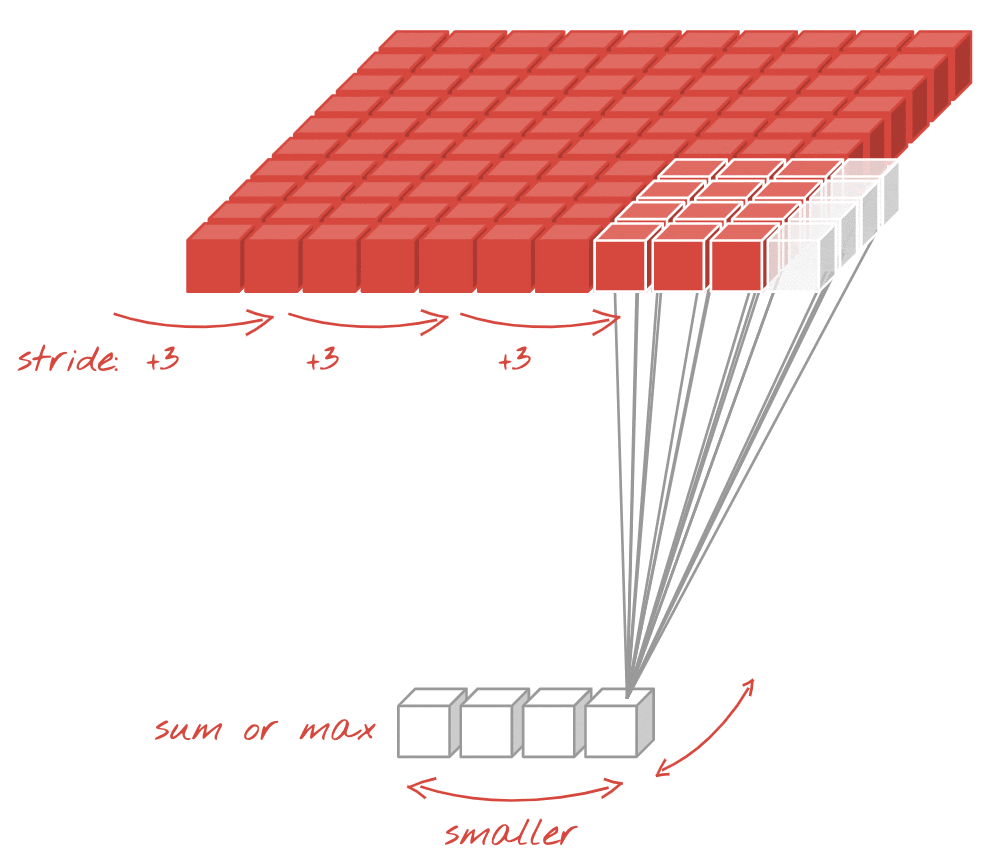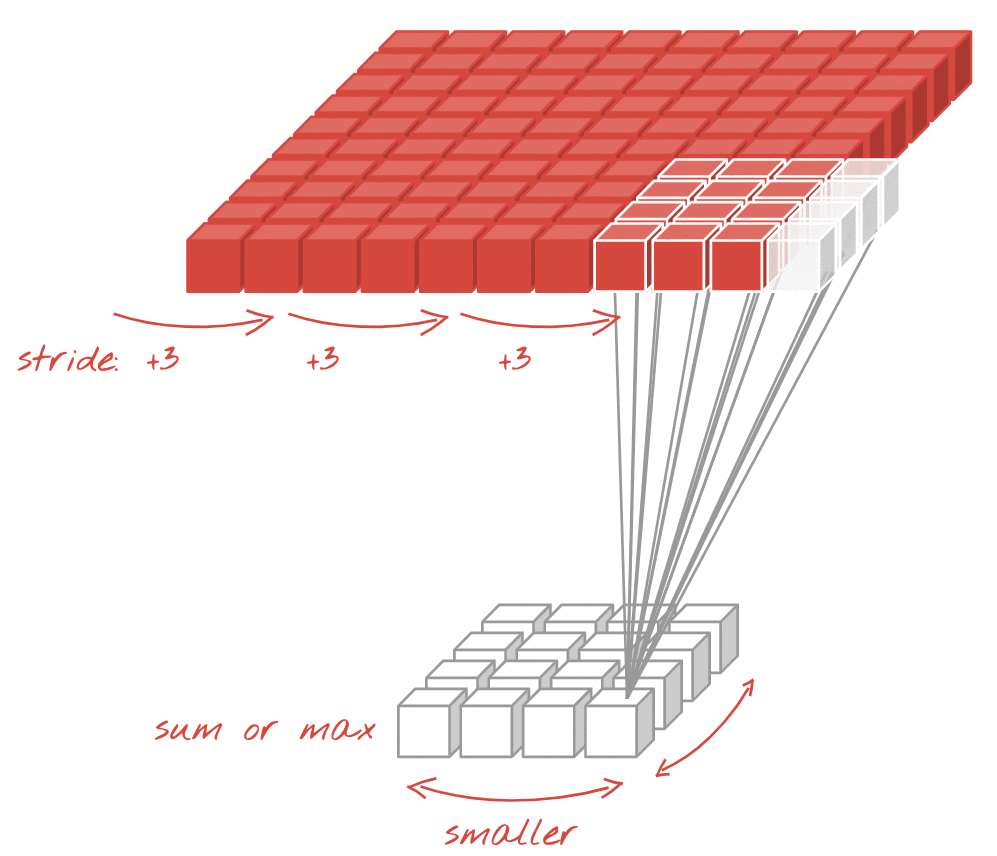
توضيح: يؤدي تحريك نافذة الحساب بمقدار 3 وحدات بكسل إلى الحصول على عدد أقل من قيم الإخراج. تُعدّ الالتفافات المخطوة أو التجميع الأقصى (الحد الأقصى في نافذة 2x2 تنزلق بخطوة 2) طريقة لتقليل مكعب البيانات في الأبعاد الأفقية.
الطبقة النهائية
بعد آخر طبقة التفافية، تكون البيانات على شكل "مكعّب". هناك طريقتان لتغذيتها من خلال الطبقة الكثيفة النهائية.
الطريقة الأولى هي تسوية مكعب البيانات إلى متّجه ثم إدخاله إلى طبقة softmax. في بعض الأحيان، يمكنك حتى إضافة طبقة كثيفة قبل طبقة softmax. ويميل هذا إلى أن يكون مكلفًا من حيث عدد الأوزان. يمكن أن تحتوي الطبقة الكثيفة في نهاية الشبكة الالتفافية على أكثر من نصف أوزان الشبكة العصبية بأكملها.
بدلاً من استخدام طبقة كثيفة مكلفة، يمكننا أيضًا تقسيم "مكعب" البيانات الواردة إلى أكبر عدد ممكن من الأجزاء التي لدينا فئات لها، ثم حساب متوسط قيمها وإدخالها من خلال دالة تنشيط softmax. لا تتطلّب طريقة إنشاء رأس التصنيف هذه أي أوزان. في Keras، هناك طبقة لهذا الغرض: tf.keras.layers.GlobalAveragePooling2D().

انتقِل إلى القسم التالي لإنشاء شبكة عصبية التفافية للمشكلة المطروحة.
11. شبكة التفافية
لننشئ شبكة تلافيفية للتعرّف على الأرقام المكتوبة بخط اليد. سنستخدم ثلاث طبقات التفافية في الأعلى، وطبقة قراءة softmax التقليدية في الأسفل، ونربطها بطبقة واحدة مكتملة الاتصال:

لاحظ أنّ الطبقتَين الالتفافيتَين الثانية والثالثة تتضمّنان خطوة بمقدار اثنَين، ما يفسّر سبب خفض عدد قيم الإخراج من 28x28 إلى 14x14 ثم إلى 7x7.
لنكتب رمز Keras البرمجي.
يجب الانتباه بشكل خاص قبل الطبقة الالتفافية الأولى. في الواقع، يتوقّع هذا النموذج مكعّبًا ثلاثي الأبعاد من البيانات، ولكن تم حتى الآن إعداد مجموعة البيانات الخاصة بنا للطبقات الكثيفة، وتم تسوية جميع وحدات البكسل في الصور إلى متّجه. علينا إعادة تشكيلها إلى صور بحجم 28x28x1 (قناة واحدة للصور ذات التدرّج الرمادي):
tf.keras.layers.Reshape(input_shape=(28*28,), target_shape=(28, 28, 1))
يمكنك استخدام هذا الخط بدلاً من طبقة tf.keras.layers.Input التي كنت تستخدمها حتى الآن.
في Keras، يكون بناء الجملة لطبقة التفافية مُنشَّطة باستخدام "relu" كما يلي:

tf.keras.layers.Conv2D(kernel_size=3, filters=12, padding='same', activation='relu')
بالنسبة إلى الالتفاف بخطوات متقطّعة، يمكنك كتابة:
tf.keras.layers.Conv2D(kernel_size=6, filters=24, padding='same', activation='relu', strides=2)
لتسوية مكعّب بيانات في متجه كي تتمكّن طبقة كثيفة من استخدامه، اتّبِع الخطوات التالية:
tf.keras.layers.Flatten()
بالنسبة إلى الطبقة الكثيفة، لم يتغير بناء الجملة:
tf.keras.layers.Dense(200, activation='relu')
هل تجاوز نموذجك حاجز الدقة البالغ% 99؟ قريب جدًا... ولكن انظر إلى منحنى فقدان صحة البيانات. هل يبدو هذا مألوفًا؟

اطّلِع أيضًا على التوقّعات. للمرة الأولى، من المفترض أن تلاحظ أنّه تم الآن التعرّف على معظم الأرقام التجريبية البالغ عددها 10,000 رقم بشكل صحيح. يتبقى حوالي 4 صفوف ونصف من عمليات الرصد الخاطئة (حوالي 110 أرقام من أصل 10,000)

إذا واجهت صعوبة، إليك الحلّ في هذه المرحلة:
12. التوقف عن المشاهدة مرة أخرى
يُظهر التدريب السابق علامات واضحة على الإفراط في التكيّف (ولا يزال أقل من دقة% 99). هل يجب أن نعيد تجربة التسرب؟
كيف كانت هذه المرة؟

يبدو أنّ ميزة "التوقف عن المشاهدة" قد نجحت هذه المرة. لم يعُد معدّل الخطأ في التحقّق يرتفع، ومن المفترض أن تكون الدقة النهائية أعلى بكثير من %99. تهانينا!
في المرة الأولى التي حاولنا فيها تطبيق أسلوب التساقط، اعتقدنا أنّ لدينا مشكلة في المطابقة بشكل مفرط، ولكن في الواقع كانت المشكلة في بنية الشبكة العصبونية. لم يكن بإمكاننا المتابعة بدون الطبقات الالتفافية، ولم يكن بإمكان التسرب فعل أي شيء حيال ذلك.
في هذه الحالة، يبدو أنّ المطابقة بشكل مفرط كانت سبب المشكلة، وقد ساعدت عملية الحذف في حلّها. تذكَّر أنّ هناك العديد من الأسباب التي يمكن أن تؤدي إلى حدوث اختلاف بين منحنيات فقدان التدريب والتحقّق، مع ارتفاع فقدان التحقّق. المطابقة بشكل مفرط (عدد كبير جدًا من درجات الحرية، تستخدمه الشبكة بشكل سيئ) هو أحد هذه الأسباب فقط. إذا كانت مجموعة البيانات صغيرة جدًا أو لم تكن بنية الشبكة العصبية مناسبة، قد تلاحظ سلوكًا مشابهًا في منحنيات الخسارة، ولكن لن يساعدك التوقف المؤقت.
13. التسوية على دفعات

أخيرًا، لنحاول إضافة تسوية الدُفعات.
هذه هي النظرية، ولكن في الواقع، ما عليك سوى تذكُّر قاعدتين:
لنلتزم بالأساسيات في الوقت الحالي ونضيف طبقة تسوية الدفعات إلى كل طبقة من طبقات الشبكة العصبية باستثناء الطبقة الأخيرة. لا تُضِفها إلى طبقة "softmax" الأخيرة. ولن يكون مفيدًا هناك.
# Modify each layer: remove the activation from the layer itself.
# Set use_bias=False since batch norm will play the role of biases.
tf.keras.layers.Conv2D(..., use_bias=False),
# Batch norm goes between the layer and its activation.
# The scale factor can be turned off for Relu activation.
tf.keras.layers.BatchNormalization(scale=False, center=True),
# Finish with the activation.
tf.keras.layers.Activation('relu'),
ما مدى دقة المعلومات الآن؟

مع بعض التعديلات (BATCH_SIZE=64، ومعلَمة انخفاض معدل التعلّم 0.666، ومعدل التسرب في الطبقة الكثيفة 0.3) وبعض الحظ، يمكنك الوصول إلى 99.5%. تم إجراء تعديلات على معدّل التعلّم ومعدّل التسرب وفقًا "لأفضل الممارسات" لاستخدام التسوية الدفعية:
- تساعد عملية التسوية الدفعية الشبكات العصبونية على التقارب وتتيح لك عادةً التدريب بشكل أسرع.
- تُعدّ عملية التسوية الدفعية أداة تسوية. يمكنك عادةً تقليل مقدار التسرّب الذي تستخدمه، أو حتى عدم استخدامه على الإطلاق.
يتضمّن دفتر ملاحظات الحلّ عملية تدريب بنسبة% 99.5:
14. التدريب على السحابة الإلكترونية باستخدام أجهزة قوية: AI Platform

ستجد نسخة من الرمز البرمجي جاهزة للاستخدام على السحابة الإلكترونية في مجلد mlengine على GitHub، بالإضافة إلى تعليمات لتشغيلها على Google Cloud AI Platform. قبل تشغيل هذا الجزء، عليك إنشاء حساب على Google Cloud وتفعيل الفوترة. يجب أن تكون الموارد اللازمة لإكمال المختبر أقل من بضعة دولارات (بافتراض ساعة واحدة من وقت التدريب على وحدة معالجة رسومات واحدة). لإعداد حسابك، اتّبِع الخطوات التالية:
- أنشئ مشروعًا على Google Cloud Platform ( http://cloud.google.com/console).
- فعِّل الفوترة.
- ثبِّت أدوات سطر الأوامر في Google Cloud Platform (حزمة تطوير البرامج (SDK) في Google Cloud Platform هنا).
- أنشئ حزمة في Google Cloud Storage (ضَعها في المنطقة
us-central1)، وسيتم استخدامها لتنظيم رمز التدريب وتخزين النموذج المدرَّب. - فعِّل واجهات برمجة التطبيقات اللازمة واطلب الحصص اللازمة (نفِّذ أمر التدريب مرة واحدة وستتلقّى رسائل خطأ تخبرك بما يجب تفعيله).
15. تهانينا!
لقد أنشأت أول شبكة عصبية ودربتها حتى وصلت دقتها إلى% 99. إنّ الأساليب التي تعلّمناها على طول الطريق ليست خاصة بمجموعة بيانات MNIST، بل إنّها تُستخدم على نطاق واسع عند العمل مع الشبكات العصبونية. كهدية وداع، إليك بطاقة "ملخّص" عن المختبر، في نسخة كرتونية. يمكنك استخدامها لتذكُّر ما تعلّمته:

الخطوات التالية
- بعد الشبكات العصبونية المتصلة بالكامل والشبكات العصبونية الالتفافية، عليك إلقاء نظرة على الشبكات العصبونية المتكررة.
- لتنفيذ التدريب أو الاستنتاج في السحابة الإلكترونية على بنية أساسية موزّعة، يوفّر Google Cloud خدمة AI Platform.
- أخيرًا، يسرّنا تلقّي ملاحظاتك. يُرجى إعلامنا إذا لاحظت أي خطأ في هذا المختبر أو إذا كنت تعتقد أنّه يجب تحسينه. نتعامل مع الملاحظات من خلال المشاكل التي يتم الإبلاغ عنها في GitHub [ رابط الملاحظات].

|
|
 الكاتب: مارتن غورنرTwitter:

جميع صور الرسوم المتحركة في هذا المختبر محمية بموجب حقوق الطبع والنشر: alexpokusay / 123RF stock photos