

1. סקירה כללית
המדריך הזה עודכן לגרסה 2.2 של Tensorflow!

בשיעור Codelab הזה תלמדו איך ליצור ולאמן רשת נוירונים שמזהה ספרות בכתב יד. במהלך הדרך, כשתשפרו את רשת הנוירונים כדי להגיע לדיוק של 99%, תגלו גם את הכלים המקצועיים שמשמשים מומחים ללמידה עמוקה לאימון יעיל של המודלים שלהם.
ב-Codelab הזה נשתמש במערך הנתונים MNIST, אוסף של 60,000 ספרות מתויגות שהעסיק דורות של דוקטורנטים במשך כמעט שני עשורים. תפתרו את הבעיה עם פחות מ-100 שורות של קוד Python / TensorFlow.
מה תלמדו
- מהי רשת נוירונים ואיך מאמנים אותה
- איך לבנות רשת נוירונים בסיסית עם שכבה אחת באמצעות tf.keras
- איך מוסיפים עוד שכבות
- איך מגדירים תזמון של קצב למידה
- איך בונים רשתות נוירונים מלאכותיות (CNN)
- איך משתמשים בטכניקות רגולריזציה: dropout, batch normalization
- מהי התאמת יתר
הדרישות
רק דפדפן. אפשר להשתמש בסדנה הזו באופן מלא באמצעות Google Colaboratory.
משוב
אם נתקלתם בבעיה ב-Google Lab הזה או אם יש לכם הצעות לשיפור, נשמח לשמוע מכם. אנחנו מטפלים במשוב באמצעות בעיות ב-GitHub [ קישור למשוב].
2. מדריך למתחילים ב-Google Colaboratory
ב-Lab הזה נעשה שימוש ב-Google Colaboratory, ולא נדרשת הגדרה מצדכם. אפשר להריץ אותו מ-Chromebook. כדאי לפתוח את הקובץ שלמטה ולהריץ את התאים כדי להכיר את קובצי ה-Notebook של Colab.

הוראות נוספות מפורטות בהמשך:
בחירת קצה עורפי של מעבד גרפי

בתפריט Colab, בוחרים באפשרות סביבת זמן הריצה > שינוי הסוג של סביבת זמן הריצה ואז בוחרים באפשרות GPU. החיבור לסביבת זמן הריצה יתבצע באופן אוטומטי בהרצה הראשונה, או שאפשר להשתמש בלחצן 'חיבור' בפינה השמאלית העליונה.
הפעלת Notebook
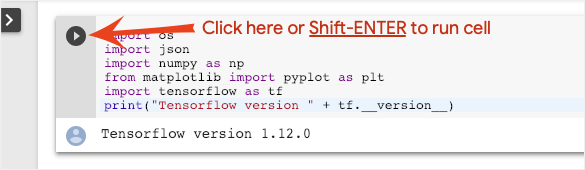
מריצים כל תא בנפרד על ידי לחיצה על תא והקשה על Shift-ENTER. אפשר גם להריץ את כל ה-notebook באמצעות סביבת זמן הריצה > הפעלת הכול.
תוכן העניינים

לכל המחברות יש תוכן עניינים. אפשר לפתוח אותו באמצעות החץ השחור שמימין.
תאים מוסתרים
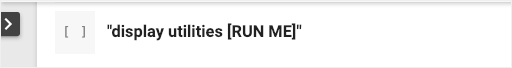
בחלק מהתאים יוצג רק השם שלהם. זו תכונה ספציפית של מחברות Colab. אפשר ללחוץ עליהם לחיצה כפולה כדי לראות את הקוד שבתוכם, אבל בדרך כלל הוא לא מעניין במיוחד. בדרך כלל תומכות בפונקציות של תצוגה או המחשה. עדיין צריך להריץ את התאים האלה כדי שהפונקציות שבתוכם יוגדרו.
3. אימון רשת נוירונים
קודם נצפה באימון של רשת נוירונים. עליך לפתוח את ה-notebook שבהמשך ולהריץ את כל התאים. אל תתייחסו לקוד עדיין, נסביר עליו בהמשך.
בזמן שמריצים את ה-notebook, מתמקדים בהדמיות. הסברים מופיעים בהמשך.
נתונים לאימון
יש לנו מערך נתונים של ספרות בכתב יד שסומנו כך שאנחנו יודעים מה כל תמונה מייצגת, כלומר מספר בין 0 ל-9. במחברת יופיע קטע:

רשת הנוירונים שנבנה תסווג את הספרות הכתובות בכתב יד ב-10 הכיתות שלהן (0, .., 9). הסיווג מתבצע על סמך פרמטרים פנימיים שצריכים להיות בעלי ערך נכון כדי שהסיווג יפעל בצורה טובה. הערך הנכון הזה נקבע בתהליך אימון שבו נעשה שימוש ב'מערך נתונים עם תוויות' שכולל תמונות ותשובות נכונות שמשויכות אליהן.
איך אפשר לדעת אם רשת הנוירונים שאומנה מניבה ביצועים טובים או לא? שימוש במערך הנתונים לאימון כדי לבדוק את הרשת יהיה רמאות. המודל כבר ראה את מערך הנתונים הזה כמה פעמים במהלך האימון, והוא בהחלט משיג ביצועים טובים מאוד לגביו. אנחנו צריכים עוד מערך נתונים עם תוויות, שלא נחשף במהלך האימון, כדי להעריך את הביצועים של הרשת ב'עולם האמיתי'. הוא נקרא מערך נתונים לאימות
הדרכה
במהלך האימון, כל פעם קבוצה אחת של נתוני אימון, הפרמטרים הפנימיים של המודל מתעדכנים והמודל משתפר יותר ויותר בזיהוי הספרות בכתב יד. אפשר לראות את זה בתרשים האימון:

בצד שמאל, ה'דיוק' הוא פשוט אחוז הספרות שזוהו בצורה נכונה. הערך הזה עולה ככל שהאימון מתקדם, וזה טוב.
בצד ימין אפשר לראות את ההפסד. כדי להפעיל את האימון, נגדיר פונקציית הפסד שמייצגת את רמת הדיוק של המערכת בזיהוי הספרות, וננסה למזער אותה. אפשר לראות שההפסד יורד גם בנתוני האימון וגם בנתוני האימות ככל שהאימון מתקדם: זה טוב. המשמעות היא שרשת הנוירונים לומדת.
ציר ה-X מייצג את מספר התקופות של זמן מערכת (epochs) או את מספר האיטרציות על מערך הנתונים כולו.
תחזיות
אחרי שהמודל מאומן, אפשר להשתמש בו כדי לזהות ספרות בכתב יד. בתרשים הבא אפשר לראות את הביצועים של המודל על כמה ספרות שמעובדות מגופנים מקומיים (השורה הראשונה), ואז על 10,000 הספרות של מערך הנתונים לאימות. הסיווג החזוי מופיע מתחת לכל ספרה, באדום אם הוא היה שגוי.

כפי שאפשר לראות, המודל הראשוני הזה לא טוב במיוחד, אבל הוא עדיין מזהה חלק מהספרות בצורה נכונה. רמת הדיוק הסופית של האימות היא בערך 90%, שזה לא רע בשביל מודל פשוט כמו זה שאיתו אנחנו מתחילים, אבל זה עדיין אומר שהוא מפספס 1,000 ספרות אימות מתוך 10,000. זה הרבה יותר ממה שאפשר להציג, ולכן נראה שכל התשובות שגויות (אדום).
טנסורים
הנתונים מאוחסנים במטריצות. תמונה בגווני אפור בגודל 28x28 פיקסלים מתאימה למטריצה דו-ממדית בגודל 28x28. אבל כדי להגדיר תמונה צבעונית, צריך להגדיר יותר ממד אחד. יש 3 ערכי צבע לכל פיקסל (אדום, ירוק, כחול), ולכן נדרש טבלה תלת-ממדית עם המאפיינים [28, 28, 3]. כדי לאחסן קבוצה של 128 תמונות צבעוניות, צריך טבלה ארבע-ממדית עם המימדים [128, 28, 28, 3].
הטבלאות הרב-ממדיות האלה נקראות טנסורים, ורשימת המאפיינים שלהן נקראת צורה.
4. [INFO]: neural networks 101
בקצרה
אם אתם כבר מכירים את כל המונחים שמודגשים בפסקה הבאה, אתם יכולים לעבור לתרגיל הבא. אם אתם רק מתחילים ללמוד על למידה עמוקה, אתם מוזמנים להמשיך לקרוא.

למודלים שנבנו כרצף של שכבות, Keras מציעה את Sequential API. לדוגמה, אפשר לכתוב מסווג תמונות באמצעות שלוש שכבות צפופות ב-Keras באופן הבא:
model = tf.keras.Sequential([
    tf.keras.layers.Flatten(input_shape=[28, 28, 1]),
    tf.keras.layers.Dense(200, activation="relu"),
    tf.keras.layers.Dense(60, activation="relu"),
    tf.keras.layers.Dense(10, activation='softmax') # classifying into 10 classes
])

# this configures the training of the model. Keras calls it "compiling" the model.
model.compile(
  optimizer='adam',
  loss= 'categorical_crossentropy',
  metrics=['accuracy']) # % of correct answers

# train the model
model.fit(dataset, ... )

שכבה צפופה אחת
ספרות בכתב יד במערך הנתונים MNIST הן תמונות בגווני אפור בגודל 28x28 פיקסלים. הגישה הפשוטה ביותר לסיווג שלהם היא להשתמש ב-784 הפיקסלים כקלט לרשת נוירונים עם שכבה אחת.

כל נוירון ברשת נוירונים מבצע סכום משוקלל של כל הקלטים שלו, מוסיף קבוע שנקרא 'הטיה' ואז מעביר את התוצאה דרך פונקציית הפעלה לא ליניארית. הפרמטרים "weights" ו-"biases" ייקבעו באמצעות אימון. בהתחלה, הם מאותחלים עם ערכים אקראיים.
התמונה שלמעלה מייצגת רשת נוירונים עם שכבה אחת ו-10 נוירונים של פלט, כי אנחנו רוצים לסווג ספרות ל-10 מחלקות (0 עד 9).
עם כפל מטריצות
כך אפשר לייצג שכבת רשת נוירונים שמבצעת עיבוד של אוסף תמונות באמצעות כפל מטריצות:

באמצעות העמודה הראשונה של המשקלים במטריצת המשקלים W, אנחנו מחשבים את הסכום המשוקלל של כל הפיקסלים בתמונה הראשונה. הסכום הזה תואם לנוירון הראשון. באמצעות העמודה השנייה של המשקלים, אנחנו עושים את אותו הדבר לנוירון השני וכן הלאה עד הנוירון העשירי. לאחר מכן נוכל לחזור על הפעולה לגבי 99 התמונות הנותרות. אם נסמן ב-X את המטריצה שמכילה את 100 התמונות שלנו, כל הסכומים המשוקללים של 10 הנוירונים שלנו, שמחושבים על 100 תמונות, הם פשוט X.W, כלומר מכפלת מטריצות.
עכשיו כל נוירון צריך להוסיף את ההטיה שלו (קבוע). מכיוון שיש לנו 10 נוירונים, יש לנו 10 קבועי הטיה. נקרא לווקטור הזה של 10 ערכים b. צריך להוסיף אותו לכל שורה במטריצה שחושבה קודם. אנחנו נשתמש בסימן פלוס פשוט כדי לכתוב את זה, בעזרת קסם שנקרא 'שידור'.
לבסוף, אנחנו מפעילים פונקציית הפעלה, למשל softmax (מוסבר בהמשך), ומקבלים את הנוסחה שמתארת רשת נוירונים עם שכבה אחת, שמוחלת על 100 תמונות:

ב-Keras
אם משתמשים בספריות של רשתות נוירונים ברמה גבוהה כמו Keras, לא צריך להטמיע את הנוסחה הזו. עם זאת, חשוב להבין ששכבת רשת נוירונים היא רק אוסף של פעולות כפל וחיבור. ב-Keras, שכבה צפופה תיכתב כך:
tf.keras.layers.Dense(10, activation='softmax')
להעמיק
קל מאוד לשרשר שכבות של רשתות נוירונים. השכבה הראשונה מחשבת סכומים משוקללים של פיקסלים. בשכבות הבאות מחושבים סכומים משוקללים של הפלטים של השכבות הקודמות.

ההבדל היחיד, מלבד מספר הנוירונים, יהיה הבחירה של פונקציית ההפעלה.
פונקציות הפעלה: relu, softmax ו-sigmoid
בדרך כלל משתמשים בפונקציית ההפעלה relu בכל השכבות מלבד האחרונה. השכבה האחרונה, במסווג, תשתמש בהפעלה מסוג softmax.

שוב, 'נוירון' מחשב סכום משוקלל של כל הקלט שלו, מוסיף ערך שנקרא 'הטיה' ומעביר את התוצאה דרך פונקציית ההפעלה.
פונקציית ההפעלה הכי פופולרית נקראת RELU, קיצור של Rectified Linear Unit (יחידה ליניארית מתוקנת). זו פונקציה פשוטה מאוד, כפי שאפשר לראות בגרף שלמעלה.
פונקציית ההפעלה המסורתית ברשתות עצביות הייתה 'סיגמואיד', אבל התגלה שלפונקציה 'relu' יש מאפייני התכנסות טובים יותר כמעט בכל מקום, ולכן היא עדיפה יותר.

הפעלת Softmax לסיווג
השכבה האחרונה של רשת הנוירונים שלנו כוללת 10 נוירונים כי אנחנו רוצים לסווג ספרות בכתב יד ל-10 מחלקות (0 עד 9). הפלט צריך להיות 10 מספרים בין 0 ל-1 שמייצגים את ההסתברות לכך שהספרה הזו תהיה 0, 1, 2 וכן הלאה. לשם כך, בשכבה האחרונה נשתמש בפונקציית הפעלה שנקראת softmax.
כדי להחיל softmax על וקטור, מחשבים את האקספוננט של כל רכיב ואז מבצעים נורמליזציה של הווקטור, בדרך כלל על ידי חלוקה בנורמה L1 (כלומר, סכום הערכים המוחלטים) כדי שהערכים המנורמלים יסתכמו ל-1 ויהיה אפשר לפרש אותם כהסתברויות.
הפלט של השכבה האחרונה, לפני ההפעלה, נקרא לפעמים "לוגיטים". אם הווקטור הזה הוא L = [L0, L1, L2, L3, L4, L5, L6, L7, L8, L9], אז:


Cross-entropy loss
עכשיו, אחרי שרשת הנוירונים שלנו מייצרת תחזיות מתמונות קלט, אנחנו צריכים למדוד את איכות התחזיות, כלומר את המרחק בין מה שהרשת אומרת לנו לבין התשובות הנכונות, שלרוב נקראות 'תוויות'. חשוב לזכור שיש לנו תוויות נכונות לכל התמונות במערך הנתונים.
כל מרחק יתאים, אבל לבעיות סיווג, מה שנקרא "מרחק אנטרופיה צולבת" הוא היעיל ביותר. נקרא לזה פונקציית השגיאה או פונקציית ההפסד:

Gradient descent
'אימון' רשת הנוירונים בעצם אומר שימוש בתמונות ובתוויות של אימון כדי להתאים את המשקלים וההטיות, כך שפונקציית ההפסד של האנטרופיה הצולבת תהיה מינימלית. כך זה עובד:
האנטרופיה הצולבת היא פונקציה של משקלים, הטיה, פיקסלים של תמונת האימון והסיווג הידוע שלה.
אם נחשב את הנגזרות החלקיות של האנטרופיה הצולבת ביחס לכל המשקלים ולכל ההטיות, נקבל 'גרדיאנט', שמחושב עבור תמונה, תווית וערך נוכחי של משקלים והטיות. חשוב לזכור שיכולים להיות מיליוני משקלים והטיות, ולכן חישוב הגרדיאנט נשמע כמו עבודה רבה. למזלנו, TensorFlow עושה את זה בשבילנו. המאפיין המתמטי של גרדיאנט הוא שהוא מצביע "למעלה". מכיוון שאנחנו רוצים להגיע למקום שבו האנטרופיה הצולבת נמוכה, אנחנו הולכים בכיוון ההפוך. אנחנו מעדכנים את המשקלים וההטיות בחלק קטן מהגרדיאנט. לאחר מכן אנחנו חוזרים על הפעולה שוב ושוב באמצעות קבוצות התמונות והתוויות הבאות לאימון, בלולאת אימון. התהליך הזה אמור להוביל למצב שבו האנטרופיה הצולבת היא מינימלית, אבל אין ערובה לכך שהמינימום הזה הוא ייחודי.

חלוקה לקבוצות קטנות ומומנטום
אפשר לחשב את הגרדיאנט רק על תמונה לדוגמה אחת ולעדכן את המשקלים וההטיות באופן מיידי, אבל אם עושים את זה על קבוצה של, למשל, 128 תמונות, מקבלים גרדיאנט שמייצג טוב יותר את האילוצים שמוטלים על ידי תמונות לדוגמה שונות, ולכן סביר להניח שהפתרון יתקבל מהר יותר. גודל המיני-batch הוא פרמטר שניתן להתאמה.
לטכניקה הזו, שנקראת לפעמים "ירידה סטוכסטית של גרדיאנט", יש יתרון נוסף ופרקטי יותר: עבודה עם קבוצות גם מאפשרת עבודה עם מטריצות גדולות יותר, ובדרך כלל קל יותר לבצע אופטימיזציה שלהן במעבדי GPU וב-TPU.
יכול להיות שההתכנסות עדיין תהיה קצת כאוטית, ואפילו תיפסק אם וקטור הגרדיאנט יהיה אפס. האם זה אומר שמצאנו מינימום? לא תמיד. רכיב של מעבר צבעים יכול להיות אפס במינימום או במקסימום. בווקטור גרדיאנט עם מיליוני רכיבים, אם כולם אפסים, ההסתברות שכל אפס מתאים לנקודת מינימום ואף אחד מהם לא מתאים לנקודת מקסימום היא קטנה למדי. במרחב עם הרבה ממדים, נקודות אוכף הן די נפוצות ואנחנו לא רוצים לעצור בהן.

איור: נקודת אוכף. השיפוע הוא 0, אבל זה לא מינימום בכל הכיוונים. (Attribution של התמונה Wikimedia: By Nicoguaro - Own work, CC BY 3.0)
הפתרון הוא להוסיף לאלגוריתם האופטימיזציה תנופה מסוימת, כדי שהוא יוכל לעבור את נקודות האוכף בלי לעצור.
מילון מונחים
אצווה או אצווה קטנה: האימון מתבצע תמיד על אצוות של נתוני אימון ותוויות. כך האלגוריתם יכול להתכנס. המאפיין 'batch' הוא בדרך כלל המאפיין הראשון של טנסורים של נתונים. לדוגמה, טנסור בצורה [100, 192, 192, 3] מכיל 100 תמונות בגודל 192x192 פיקסלים עם שלושה ערכים לכל פיקסל (RGB).
פונקציית אובדן של אנטרופיה צולבת: פונקציית אובדן מיוחדת שמשמשת לעיתים קרובות בסיווגים.
שכבה צפופה: שכבה של נוירונים שבה כל נוירון מחובר לכל הנוירונים בשכבה הקודמת.
תכונות: הקלטים של רשת נוירונים נקראים לפעמים 'תכונות'. האומנות של בחירת החלקים של מערך נתונים (או שילובים של חלקים) שיוזנו לרשת נוירונים כדי לקבל תחזיות טובות נקראת 'הנדסת תכונות'.
תוויות: שם נוסף ל'סיווגים' או לתשובות נכונות בבעיית סיווג עם פיקוח
קצב הלמידה: שבר של הגרדיאנט שלפיו המשקלים וההטיות מתעדכנים בכל איטרציה של לולאת האימון.
logits: הפלט של שכבת נוירונים לפני החלת פונקציית ההפעלה נקרא logits. המונח הזה מגיע מהפונקציה הלוגיסטית, שנקראת גם פונקציית סיגמואיד, שהייתה פונקציית ההפעלה הפופולרית ביותר. השם 'Neuron outputs before logistic function' (פלט של נוירון לפני פונקציה לוגיסטית) קוצר ל-'logits'.
loss: פונקציית השגיאה שמשווה בין התפוקות של רשת נוירונים לבין התשובות הנכונות
נוירון: מחשב את הסכום המשוקלל של הקלט שלו, מוסיף הטיה ומעביר את התוצאה דרך פונקציית הפעלה.
קידוד חם-יחיד: מחלקה 3 מתוך 5 מקודדת כווקטור של 5 אלמנטים, כולם אפסים חוץ מהאלמנט השלישי שהוא 1.
relu: יחידה לינארית מתוקנת. פונקציית הפעלה פופולרית לנוירונים.
sigmoid: פונקציית הפעלה נוספת שהייתה פופולרית בעבר ועדיין שימושית במקרים מיוחדים.
softmax: פונקציית הפעלה מיוחדת שפועלת על וקטור, מגדילה את ההפרש בין הרכיב הגדול ביותר לבין כל הרכיבים האחרים, וגם מבצעת נורמליזציה של הווקטור כך שהסכום שלו יהיה 1, כדי שאפשר יהיה לפרש אותו כווקטור של הסתברויות. השלב האחרון בתהליך הסיווג.
tensor: טנזור הוא כמו מטריצה, אבל עם מספר שרירותי של ממדים. טנסור חד-ממדי הוא וקטור. טנסור דו-ממדי הוא מטריצה. אחר כך אפשר ליצור טנסורים עם 3, 4, 5 או יותר מימדים.
5. בואו נתחיל לכתוב קוד
חוזרים לנוטבוק המחקר והפעם קוראים את הקוד.
בואו נעבור על כל התאים ב-notebook הזה.
התא 'פרמטרים'
כאן מוגדרים גודל האצווה, מספר התקופות של זמן המערכת לאימון ומיקום קובצי הנתונים. קובצי הנתונים מאוחסנים בקטגוריה של Google Cloud Storage (GCS), ולכן הכתובת שלהם מתחילה ב-gs://
התא 'ייבוא'
כל ספריות Python הנדרשות מיובאות כאן, כולל TensorFlow וגם matplotlib להדמיות.
תא visualization utilities [RUN ME]****
התא הזה מכיל קוד ויזואליזציה לא מעניין. הוא מכווץ כברירת מחדל, אבל אפשר לפתוח אותו ולעיין בקוד כשמתפנה זמן, באמצעות לחיצה כפולה עליו.
התא tf.data.Dataset: parse files and prepare training and validation datasets
בתא הזה נעשה שימוש ב-tf.data.Dataset API כדי לטעון את מערך הנתונים MNIST מקובצי הנתונים. לא צריך להשקיע יותר מדי זמן בתא הזה. אם אתם רוצים ללמוד על tf.data.Dataset API, תוכלו לעיין במדריך הבא: פייפליינים במהירות TPU. בשלב הזה, הדברים הבסיסיים הם:
תמונות ותוויות (תשובות נכונות) ממערך הנתונים של MNIST מאוחסנות ברשומות באורך קבוע ב-4 קבצים. אפשר לטעון את הקבצים באמצעות הפונקציה הייעודית של רשומה קבועה:
imagedataset = tf.data.FixedLengthRecordDataset(image_filename, 28*28, header_bytes=16)
עכשיו יש לנו מערך נתונים של בייטים של תמונות. צריך לפענח אותם לתמונות. אנחנו מגדירים פונקציה כדי לעשות את זה. התמונה לא דחוסה, ולכן הפונקציה לא צריכה לפענח שום דבר (decode_raw בעצם לא עושה כלום). לאחר מכן התמונה מומרת לערכים של נקודה צפה בין 0 ל-1. יכולנו לשנות את הצורה כאן לתמונה דו-ממדית, אבל אנחנו משאירים אותה כמערך שטוח של פיקסלים בגודל 28*28, כי זה מה שהשכבה הצפופה הראשונית שלנו מצפה לקבל.
def read_image(tf_bytestring):
    image = tf.io.decode_raw(tf_bytestring, tf.uint8)
    image = tf.cast(image, tf.float32)/256.0
    image = tf.reshape(image, [28*28])
    return image
אנחנו מפעילים את הפונקציה הזו על מערך הנתונים באמצעות .map ומקבלים מערך נתונים של תמונות:
imagedataset = imagedataset.map(read_image, num_parallel_calls=16)
אנחנו מבצעים קריאה ופענוח דומים של תוויות, ו.zip תמונות ותוויות יחד:
dataset = tf.data.Dataset.zip((imagedataset, labelsdataset))
עכשיו יש לנו מערך נתונים של זוגות (תמונה, תווית). זה מה שהמודל שלנו מצפה. אנחנו עדיין לא מוכנים להשתמש בו בפונקציית האימון:
dataset = dataset.cache()
dataset = dataset.shuffle(5000, reshuffle_each_iteration=True)
dataset = dataset.repeat()
dataset = dataset.batch(batch_size)
dataset = dataset.prefetch(tf.data.experimental.AUTOTUNE)
ב-API tf.data.Dataset יש את כל פונקציות השירות הנדרשות להכנת מערכי נתונים:
.cache שומר במטמון את מערך הנתונים ב-RAM. זו קבוצת נתונים קטנה מאוד, ולכן היא תפעל. .shuffle מערבב אותו עם מאגר של 5,000 רכיבים. חשוב שנתוני האימון יהיו מעורבבים היטב. .repeat חוזר על מערך הנתונים. נאמן את המודל על הנתונים האלה מספר פעמים (מספר תקופות של זמן מערכת). .batch מושך כמה תמונות ותוויות יחד לתוך מיני-batch. לבסוף, .prefetch יכול להשתמש ב-CPU כדי להכין את האצווה הבאה בזמן שהאצווה הנוכחית עוברת אימון ב-GPU.
מערך הנתונים validation מוכן באופן דומה. עכשיו אנחנו מוכנים להגדיר מודל ולהשתמש במערך הנתונים הזה כדי לאמן אותו.
התא Keras Model
כל המודלים שלנו יהיו רצפים ישרים של שכבות, כדי שנוכל להשתמש בסגנון tf.keras.Sequential כדי ליצור אותם. בהתחלה, זו שכבה צפופה אחת. יש בו 10 נוירונים כי אנחנו מסווגים ספרות בכתב יד ל-10 מחלקות. הוא משתמש בהפעלה מסוג softmax כי הוא השכבה האחרונה בסיווג.
מודל Keras צריך לדעת גם את הצורה של הקלט שלו. אפשר להשתמש ב-tf.keras.layers.Input כדי להגדיר אותו. כאן, וקטורי הקלט הם וקטורים שטוחים של ערכי פיקסלים באורך 28*28.
model = tf.keras.Sequential(
  [
    tf.keras.layers.Input(shape=(28*28,)),
    tf.keras.layers.Dense(10, activation='softmax')
  ])

model.compile(optimizer='sgd',
              loss='categorical_crossentropy',
              metrics=['accuracy'])

# print model layers
model.summary()

# utility callback that displays training curves
plot_training = PlotTraining(sample_rate=10, zoom=1)
הגדרת המודל מתבצעת ב-Keras באמצעות הפונקציה model.compile. בדוגמה הזו אנחנו משתמשים באופטימיזציה הבסיסית 'sgd' (Stochastic Gradient Descent). מודל סיווג דורש פונקציית אובדן של אנטרופיה צולבת, שנקראת 'categorical_crossentropy' ב-Keras. לבסוף, אנחנו מבקשים מהמודל לחשב את מדד 'accuracy', שהוא אחוז התמונות שסווגו בצורה נכונה.
Keras מציעה את כלי השירות model.summary() שמאפשר להדפיס את פרטי המודל שיצרתם. המדריך הנחמד שלך הוסיף את כלי השירות PlotTraining (מוגדר בתא 'כלי שירות להמחשה'), שיציג עקומות אימון שונות במהלך האימון.
התא Train and validate the model (אימון ואימות המודל)
בשלב הזה מתבצע האימון, על ידי קריאה ל-model.fit והעברה של מערכי הנתונים של האימון והאימות. כברירת מחדל, Keras מריץ סבב אימות בסוף כל תקופה.
model.fit(training_dataset, steps_per_epoch=steps_per_epoch, epochs=EPOCHS,
          validation_data=validation_dataset, validation_steps=1,
          callbacks=[plot_training])
ב-Keras, אפשר להוסיף התנהגויות מותאמות אישית במהלך האימון באמצעות קריאות חוזרות (callbacks). כך הטמענו את תרשים האימון שמתעדכן באופן דינמי בסדנה הזו.
התא 'הצגת חיזויים'
אחרי שמסיימים לאמן את המודל, אפשר לקבל ממנו חיזויים באמצעות הקריאה ל-model.predict():
probabilities = model.predict(font_digits, steps=1)
predicted_labels = np.argmax(probabilities, axis=1)
כאן הכנו קבוצה של ספרות מודפסות שנוצרו מגופנים מקומיים, כבדיקה. חשוב לזכור שהרשת העצבית מחזירה וקטור של 10 הסתברויות מהפונקציה הסופית שלה, softmax. כדי לקבל את התווית, צריך לגלות איזו הסתברות היא הכי גבוהה. np.argmax מהספרייה numpy עושה את זה.
כדי להבין למה צריך את הפרמטר axis=1, חשוב לזכור שעיבדנו קבוצה של 128 תמונות, ולכן המודל מחזיר 128 וקטורים של הסתברויות. הצורה של טנסור הפלט היא [128, 10]. אנחנו מחשבים את argmax על פני 10 ההסתברויות שמוחזרות לכל תמונה, ולכן axis=1 (הציר הראשון הוא 0).
המודל הפשוט הזה כבר מזהה 90% מהספרות. לא רע, אבל עכשיו תשפר את זה משמעותית.

6. הוספת שכבות

כדי לשפר את דיוק הזיהוי, נוסיף עוד שכבות לרשת נוירונים.

אנחנו משתמשים ב-softmax כפונקציית ההפעלה בשכבה האחרונה, כי היא הכי מתאימה לסיווג. לעומת זאת, בשכבות הביניים נשתמש בפונקציית ההפעלה הקלאסית ביותר: הסיגמואיד:
לדוגמה, המודל יכול להיראות כך (אל תשכחו את הפסיקים, tf.keras.Sequential מקבל רשימה מופרדת בפסיקים של שכבות):
model = tf.keras.Sequential(
  [
      tf.keras.layers.Input(shape=(28*28,)),
      tf.keras.layers.Dense(200, activation='sigmoid'),
      tf.keras.layers.Dense(60, activation='sigmoid'),
      tf.keras.layers.Dense(10, activation='softmax')
  ])
בודקים את הסיכום של המודל. עכשיו יש בו לפחות פי 10 יותר פרמטרים. הוא צריך להיות טוב פי 10! אבל משום מה, הוא לא ...

נראה שההפסד גם עלה בצורה משמעותית. נראה שמשהו לא בסדר.
7. טיפול מיוחד ברשתות עמוקות
הרגע חוויתם רשתות עצביות, כפי שאנשים נהגו לעצב אותן בשנות ה-80 וה-90. לא פלא שהם ויתרו על הרעיון, מה שהוביל למה שמכונה "חורף הבינה המלאכותית". למעשה, ככל שמוסיפים שכבות, לרשתות עצביות קשה יותר ויותר להתכנס.
מתברר שרשתות עצביות עמוקות עם הרבה שכבות (20, 50 ואפילו 100 כיום) יכולות לפעול בצורה טובה מאוד, בתנאי שמשתמשים בכמה טריקים מתמטיים כדי לגרום להן להתכנס. הגילוי של הטריקים הפשוטים האלה הוא אחת הסיבות לתחייה של למידה עמוקה בעשור השני של המאה ה-21.
הפעלת RELU

פונקציית ההפעלה הסיגמואידית היא בעייתית למדי ברשתות עמוקות. היא דוחסת את כל הערכים בין 0 ל-1, וכשעושים את זה שוב ושוב, הפלט של הנוירונים והגרדיאנטים שלהם יכולים להיעלם לגמרי. הוא מוזכר מסיבות היסטוריות, אבל ברשתות מודרניות נעשה שימוש ב-RELU (יחידה לינארית מתוקנת) שנראית כך:

לעומת זאת, ל-ReLU יש נגזרת של 1, לפחות בצד ימין שלה. עם הפעלת RELU, גם אם הגרדיאנטים שמגיעים מחלק מהנוירונים יכולים להיות אפס, תמיד יהיו אחרים שיספקו גרדיאנט ברור שאינו אפס, והאימון יכול להימשך בקצב טוב.
אופטימיזציה טובה יותר
במרחבים רב-ממדיים כמו כאן – יש לנו בסביבות 10,000 משקלים והטיות – 'נקודות אוכף' הן תופעה שכיחה. אלה נקודות שלא מייצגות מינימום מקומי, אבל הגרדיאנט בהן הוא אפס, והאופטימיזציה של ירידת הגרדיאנט נתקעת בהן. ל-TensorFlow יש מגוון רחב של אופטימיזטורים זמינים, כולל כאלה שפועלים עם כמות מסוימת של אינרציה ויעברו בבטחה על פני נקודות אוכף.
הפעלות אקראיות
אומנות ההגדרה של משקלים והטיות לפני אימון היא תחום מחקר בפני עצמו, ויש הרבה מאמרים שפורסמו בנושא. כאן אפשר לראות את כל הפונקציות הזמינות לאתחול ב-Keras. למזלנו, Keras עושה את הדבר הנכון כברירת מחדל ומשתמש ב'glorot_uniform' initializer שהוא הכי טוב כמעט בכל המקרים.
אין צורך לבצע שום פעולה, כי Keras כבר עושה את הפעולה הנכונה.
NaN ???
נוסחת האנטרופיה הצולבת כוללת לוגריתם, והלוגריתם של 0 הוא לא מספר (NaN, קריסה מספרית אם תרצו). האם הקלט של האנטרופיה הצולבת יכול להיות 0? הקלט מגיע מ-softmax, שהוא למעשה פונקציה אקספוננציאלית, ופונקציה אקספוננציאלית אף פעם לא שווה לאפס. אז אנחנו בטוחים!
באמת? בעולם היפה של המתמטיקה, היינו בטוחים, אבל בעולם המחשבים, exp(-150), שמיוצג בפורמט float32, הוא אפס, והאנטרופיה הצולבת קורסת.
למזלנו, גם כאן אין צורך לעשות דבר, כי Keras מטפלת בזה ומחשבת את softmax ואחריו את האנטרופיה הצולבת בצורה זהירה במיוחד כדי להבטיח יציבות מספרית ולמנוע את ה-NaN המפחידים.
הצלחה?

עכשיו רמת הדיוק צריכה להיות 97%. המטרה בסדנה הזו היא להגיע לערך גבוה משמעותית מ-99%, אז בואו נמשיך.
אם נתקעתם, הנה הפתרון בשלב הזה:
8. הפחתה של קצב הלמידה
אולי אפשר לנסות לאמן מהר יותר? קצב הלמידה שמוגדר כברירת מחדל באופטימיזציה של Adam הוא 0.001. אנסה להגדיל אותו.
הגברת המהירות לא עוזרת במיוחד, ומה זה כל הרעש הזה?

עקומות האימון מאוד רועשות, וגם עקומות האימות קופצות למעלה ולמטה. זה אומר שאנחנו מתקדמים מהר מדי. אפשר לחזור למהירות הקודמת, אבל יש דרך טובה יותר.

הפתרון הטוב הוא להתחיל מהר ולהקטין את קצב הלמידה באופן אקספוננציאלי. ב-Keras, אפשר לעשות את זה באמצעות הקריאה החוזרת tf.keras.callbacks.LearningRateScheduler.
קוד שימושי להעתקה והדבקה:
# lr decay function
def lr_decay(epoch):
  return 0.01 * math.pow(0.6, epoch)

# lr schedule callback
lr_decay_callback = tf.keras.callbacks.LearningRateScheduler(lr_decay, verbose=True)

# important to see what you are doing
plot_learning_rate(lr_decay, EPOCHS)
אל תשכחו להשתמש בlr_decay_callback שיצרתם. מוסיפים אותו לרשימת הפונקציות להפעלה חוזרת ב-model.fit:
model.fit(..., callbacks=[plot_training, lr_decay_callback])
ההשפעה של השינוי הקטן הזה היא מדהימה. אפשר לראות שרוב הרעשים נעלמו ודיוק הבדיקה עכשיו מעל 98% באופן קבוע.

9. נשירה, התאמת יתר
נראה שהמודל מתכנס עכשיו בצורה טובה. בואו ננסה להתעמק עוד יותר.
האם זה עזר?

לא ממש, רמת הדיוק עדיין תקועה על 98% ותסתכל על אובדן האימות. המספר עולה! אלגוריתם הלמידה פועל רק על נתוני האימון ומבצע אופטימיזציה של הפסד האימון בהתאם. הוא אף פעם לא רואה נתוני אימות, אז לא מפתיע שאחרי זמן מה העבודה שלו כבר לא משפיעה על הפסד האימות, שמפסיק לרדת ולפעמים אפילו עולה שוב.
הפעולה הזו לא משפיעה באופן מיידי על יכולות הזיהוי של המודל בעולם האמיתי, אבל היא תמנע מכם להריץ הרבה איטרציות, ובדרך כלל היא מעידה על כך שהאימון כבר לא משפיע באופן חיובי.

הניתוק הזה נקרא בדרך כלל 'התאמת יתר', וכשרואים אותו, אפשר לנסות להחיל טכניקת רגולריזציה שנקראת 'נשירה'. טכניקת ה-dropout משביתה נוירונים אקראיים בכל איטרציה של אימון.
זה עבד?

הרעש מופיע שוב (לא מפתיע בהתחשב באופן הפעולה של ניתוקים). נראה שההפסד באימות לא עולה יותר, אבל הוא גבוה יותר באופן כללי מאשר בלי dropout. ורמת הדיוק של האימות ירדה קצת. זו תוצאה די מאכזבת.
נראה שהפתרון של dropout לא היה נכון, או שאולי overfitting הוא מושג מורכב יותר וחלק מהגורמים שלו לא ניתנים לתיקון באמצעות dropout?
מה זה התאמת יתר? התאמת יתר מתרחשת כשמערכת של רשת נוירונים לומדת בצורה לא טובה, כלומר בצורה שמתאימה לדוגמאות האימון אבל לא מתאימה לנתונים מהעולם האמיתי. יש טכניקות רגולריזציה כמו dropout שיכולות לחייב את המודל ללמוד בצורה טובה יותר, אבל לבעיית ההתאמה העודפת יש גם שורשים עמוקים יותר.

התאמת יתר בסיסית מתרחשת כשרשת נוירונים כוללת יותר מדי דרגות חופש לבעיה שבה היא עוסקת. תארו לעצמכם שיש לנו כל כך הרבה נוירונים שהרשת יכולה לאחסן בהם את כל תמונות האימון שלנו ואז לזהות אותן באמצעות התאמת תבניות. הוא ייכשל לחלוטין בנתונים מהעולם האמיתי. צריך להגביל במידה מסוימת את רשת הנוירונים כדי שהיא תיאלץ להכליל את מה שהיא לומדת במהלך האימון.
אם יש לכם מעט מאוד נתונים לאימון, גם רשת קטנה יכולה ללמוד אותם בעל פה, ותראו "התאמת יתר". באופן כללי, תמיד צריך הרבה נתונים כדי לאמן רשתות נוירונים.
לבסוף, אם עשיתם הכול לפי הספר, ניסיתם גדלים שונים של רשת כדי לוודא שדרגות החופש שלה מוגבלות, הפעלתם dropout והרצתם אימון על הרבה נתונים, יכול להיות שעדיין תיתקעו ברמת ביצועים שלא נראה שאפשר לשפר אותה. המשמעות היא שהרשת העצבית שלכם, בצורה הנוכחית שלה, לא מסוגלת לחלץ מידע נוסף מהנתונים שלכם, כמו במקרה שלנו כאן.
זוכרים איך אנחנו משתמשים בתמונות שלנו, שמושטחות לווקטור יחיד? זה היה רעיון ממש גרוע. ספרות בכתב יד מורכבות מצורות, והשמטנו את פרטי הצורה כששיטחנו את הפיקסלים. עם זאת, יש סוג של רשת נוירונים שיכולה לנצל את המידע על הצורה: רשתות קונבולוציה. בוא ננסה אותם.
אם נתקעתם, הנה הפתרון בשלב הזה:
10. [INFO] רשתות קונבולוציה
בקצרה
אם אתם כבר מכירים את כל המונחים שמודגשים בפסקה הבאה, אתם יכולים לעבור לתרגיל הבא. אם אתם רק מתחילים להשתמש ברשתות נוירונים קונבולוציוניות, כדאי שתמשיכו לקרוא.

איור: סינון תמונה באמצעות שני מסננים עוקבים, כל אחד עם 48 משקלים שניתנים ללמידה (4x4x3=48).
כך נראית רשת נוירונים מתקפלת פשוטה ב-Keras:
model = tf.keras.Sequential([
    tf.keras.layers.Reshape(input_shape=(28*28,), target_shape=(28, 28, 1)),
    tf.keras.layers.Conv2D(kernel_size=3, filters=12, activation='relu'),
    tf.keras.layers.Conv2D(kernel_size=6, filters=24, strides=2, activation='relu'),
    tf.keras.layers.Conv2D(kernel_size=6, filters=32, strides=2, activation='relu'),
    tf.keras.layers.Flatten(),
    tf.keras.layers.Dense(10, activation='softmax')
])
בשכבה של רשת קונבולוציונית, 'נוירון' אחד מבצע סכום משוקלל של הפיקסלים שמעליו, רק באזור קטן של התמונה. הוא מוסיף הטיה ומזין את הסכום דרך פונקציית הפעלה, בדיוק כמו נוירון בשכבה צפופה רגילה. לאחר מכן הפעולה הזו חוזרת על עצמה בכל התמונה באמצעות אותם משקלים. חשוב לזכור שבשכבות צפופות, לכל נוירון יש משקלים משלו. כאן, 'תיקון' יחיד של משקלים מחליק על פני התמונה בשני הכיוונים ('קונבולוציה'). בפלט יש מספר ערכים ששווה למספר הפיקסלים בתמונה (אבל צריך להוסיף קצת ריפוד בשוליים). זו פעולת סינון. באיור שלמעלה, נעשה שימוש במסנן של 4x4x3=48 משקלים.
עם זאת, 48 משקלים לא יספיקו. כדי להוסיף עוד דרגות חופש, חוזרים על אותה פעולה עם קבוצה חדשה של משקלים. הפעולה הזו יוצרת קבוצה חדשה של פלט מסנן. נקרא לזה 'ערוץ' של פלט,בהקבלה לערוצי ה-R, G ו-B בתמונת הקלט.

אפשר לסכם את שני (או יותר) מערכי המשקלים לטנזור אחד על ידי הוספת מימד חדש. כך מקבלים את הצורה הגנרית של טנסור המשקלים בשכבת קונבולוציה. מכיוון שמספר ערוצי הקלט והפלט הם פרמטרים, אפשר להתחיל להוסיף שכבות של רשתות קונבולוציה.

איור: רשת נוירונים מלאכותית (CNN) מבצעת טרנספורמציה של 'קוביות' נתונים ל'קוביות' נתונים אחרות.
קיפולים (קונבולציות) עם צעדים, יצירת מאגרים מקסימליים
אם מבצעים את הקונבולוציות עם צעד של 2 או 3, אפשר גם להקטין את קוביית הנתונים שמתקבלת בממדים האופקיים שלה. יש שתי דרכים נפוצות לעשות את זה:
- קונבולוציה עם צעדים: מסנן הזזה כמו למעלה, אבל עם צעד >1
- איגום מקסימלי: חלון הזזה שמחיל את פעולת ה-MAX (בדרך כלל על תיקוני 2x2, שחוזרים על עצמם כל 2 פיקסלים)

איור: הזזה של חלון החישוב ב-3 פיקסלים מובילה לפחות ערכי פלט. הפעלת קונבולוציה עם דילוג או איגום מקסימלי (מקסימום בחלון 2x2 עם דילוג של 2) היא דרך לצמצם את קוביית הנתונים בממדים האופקיים.
השכבה הסופית
אחרי שכבת הקונבולוציה האחרונה, הנתונים הם בצורת "קוביה". יש שתי דרכים להעביר אותו דרך השכבה הדחוסה הסופית.
האפשרות הראשונה היא לשטח את קוביית הנתונים לווקטור ואז להזין אותו לשכבת ה-softmax. לפעמים אפשר אפילו להוסיף שכבה צפופה לפני שכבת ה-softmax. השיטה הזו בדרך כלל יקרה מבחינת מספר המשקלים. שכבה צפופה בסוף של רשת קונבולוציה יכולה להכיל יותר ממחצית המשקלים של כל רשת הנוירונים.
במקום להשתמש בשכבה צפופה ויקרה, אפשר גם לפצל את הנתונים הנכנסים לכל כך הרבה חלקים כמו שיש לנו מחלקות, לחשב את הממוצע של הערכים שלהם ולהזין אותם דרך פונקציית הפעלה מסוג softmax. הדרך הזו לבניית ראש הסיווג לא כרוכה בעלויות משקל. ב-Keras, יש שכבה לזה: tf.keras.layers.GlobalAveragePooling2D().

בקטע הבא נסביר איך לבנות רשת קונבולוציה לבעיה שמוצגת כאן.
11. רשת קונבולוציה
בואו ניצור רשת קונבולוציה לזיהוי ספרות בכתב יד. נשתמש בשלוש שכבות קונבולוציה בחלק העליון, בשכבת הקריאה המסורתית של softmax בחלק התחתון, ונקשר ביניהן באמצעות שכבה אחת שמחוברת באופן מלא:

שימו לב שלשכבות הקונבולוציה השנייה והשלישית יש צעד של שתיים, ולכן הן מקטינות את מספר ערכי הפלט מ-28x28 ל-14x14 ואז ל-7x7.
עכשיו נכתוב את הקוד של Keras.
לפני השכבה הראשונה של הקונבולוציה נדרשת תשומת לב מיוחדת. למעשה, הוא מצפה לקבל 'קוביה' תלת-ממדית של נתונים, אבל מערך הנתונים שלנו הוגדר עד עכשיו לשכבות צפופות, וכל הפיקסלים של התמונות משוטחים לווקטור. אנחנו צריכים לשנות את הצורה שלהן בחזרה לתמונות בגודל 28x28x1 (ערוץ אחד לתמונות בגווני אפור):
tf.keras.layers.Reshape(input_shape=(28*28,), target_shape=(28, 28, 1))
אפשר להשתמש בשורה הזו במקום בשכבת tf.keras.layers.Input שהייתה לכם עד עכשיו.
ב-Keras, התחביר של שכבת קונבולוציה עם הפעלה מסוג relu הוא:

tf.keras.layers.Conv2D(kernel_size=3, filters=12, padding='same', activation='relu')
כדי ליצור קונבולוציה עם צעדים, כותבים:
tf.keras.layers.Conv2D(kernel_size=6, filters=24, padding='same', activation='relu', strides=2)
כדי לשטח קובייה של נתונים לווקטור שאפשר להשתמש בו בשכבה צפופה:
tf.keras.layers.Flatten()
גם עבור שכבה צפופה, התחביר לא השתנה:
tf.keras.layers.Dense(200, activation='relu')
האם המודל שלך עבר את מחסום הדיוק של 99%? די קרוב… אבל כדאי להסתכל על עקומת הירידה באימות. האם זה נשמע לך מוכר?

כדאי גם לעיין בחיזויים. בפעם הראשונה, אמור להופיע שרוב 10,000 הספרות לבדיקה מזוהות עכשיו בצורה נכונה. נשארו רק כ-4 שורות וחצי של זיהויים שגויים (כ-110 ספרות מתוך 10,000)

אם נתקעתם, הנה הפתרון בשלב הזה:
12. נשירה נוספת
האימון הקודם מראה סימנים ברורים של התאמת יתר (overfitting) (ועדיין לא מגיע ל-99% דיוק). רוצה לנסות שוב את ההגדרה 'נשירה'?
איך היה הפעם?

נראה שהפעם ההשמטה עבדה. ההפסד של האימות לא עולה יותר, והדיוק הסופי צריך להיות גבוה בהרבה מ-99%. מעולה!
בפעם הראשונה שניסינו להשתמש בשיטת ה-dropout, חשבנו שיש לנו בעיה של התאמת יתר (overfitting), אבל למעשה הבעיה הייתה בארכיטקטורה של רשת הנוירונים. לא יכולנו להמשיך בלי שכבות קונבולוציה, ואין שום דבר ש-dropout יכול לעשות בנוגע לכך.
הפעם נראה שהתאמת יתר הייתה הגורם לבעיה, והשימוש ב-dropout באמת עזר. חשוב לזכור שיש הרבה דברים שיכולים לגרום לניתוק בין עקומות ההפסד של האימון והאימות, כשההפסד של האימות עולה בהדרגה. התאמת יתר (יותר מדי דרגות חופש, שנעשה בהן שימוש לא נכון ברשת) היא רק אחת מהן. אם מערך הנתונים קטן מדי או שהארכיטקטורה של רשת הנוירונים לא מתאימה, יכול להיות שתראו התנהגות דומה בעקומות ההפסד, אבל dropout לא יעזור.
13. נורמליזציה באצווה

לבסוף, ננסה להוסיף נורמליזציה של קבוצות.
זו התיאוריה, אבל בפועל, חשוב לזכור רק כמה כללים:
נפעל לפי הספר בינתיים ונוסיף שכבת נורמליזציה של אצווה לכל שכבת רשת נוירונים, למעט האחרונה. לא מוסיפים אותו לשכבת ה-softmax האחרונה. היא לא תהיה שימושית שם.
# Modify each layer: remove the activation from the layer itself.
# Set use_bias=False since batch norm will play the role of biases.
tf.keras.layers.Conv2D(..., use_bias=False),
# Batch norm goes between the layer and its activation.
# The scale factor can be turned off for Relu activation.
tf.keras.layers.BatchNormalization(scale=False, center=True),
# Finish with the activation.
tf.keras.layers.Activation('relu'),
מה רמת הדיוק עכשיו?

עם שינויים קלים (BATCH_SIZE=64, פרמטר של ירידה בקצב הלמידה 0.666, שיעור הנשירה בשכבה הצפופה 0.3) ומעט מזל, אפשר להגיע ל-99.5%. התאמות של קצב הלמידה והנשירה בוצעו בהתאם לשיטות המומלצות לשימוש בנורמליזציה של אצווה:
- נורמליזציה של קבוצות עוזרת לרשתות נוירונים להתכנס ומאפשרת בדרך כלל אימון מהיר יותר.
- נורמליזציה של קבוצות היא שיטה להסדרת נתונים. בדרך כלל אפשר להקטין את כמות ה-dropout שבה משתמשים, או אפילו לא להשתמש ב-dropout בכלל.
מחברת הפתרון כוללת הרצת אימון של 99.5%:
14. אימון בענן על חומרה עוצמתית: AI Platform

גרסה של הקוד שמוכנה לשימוש בענן נמצאת בתיקייה mlengine ב-GitHub, יחד עם הוראות להרצה שלה ב-Google Cloud AI Platform. כדי להריץ את החלק הזה, צריך ליצור חשבון Google Cloud ולהפעיל את החיוב. המשאבים שנדרשים להשלמת המעבדה צריכים לעלות פחות מכמה דולרים (בהנחה של שעת אימון אחת ב-GPU אחד). כדי להכין את החשבון:
- יוצרים פרויקט ב-Google Cloud Platform ( http://cloud.google.com/console).
- מפעילים את החיוב.
- מתקינים את כלי שורת הפקודה של GCP ( GCP SDK כאן).
- יוצרים קטגוריה של Google Cloud Storage (במיקום
us-central1). הקטגוריה תשמש להכנת קוד האימון ולאחסון המודל שאומן. - מפעילים את ממשקי ה-API הנדרשים ומבקשים את המכסות הנדרשות (מריצים את פקודת ההדרכה פעם אחת וצריכות להופיע הודעות שגיאה שמציינות מה צריך להפעיל).
15. מעולה!
בנית רשת נוירונים ראשונה ואימנת אותה עד לרמת דיוק של 99%. הטכניקות שנלמדו לאורך הדרך לא ספציפיות למערך הנתונים של MNIST, למעשה הן נמצאות בשימוש נרחב כשעובדים עם רשתות נוירונים. כמתנת פרידה, הנה כרטיס 'הערות על הצוק' של ה-Lab, בגרסת קריקטורה. אתם יכולים להשתמש בו כדי לזכור מה למדתם:

השלבים הבאים
- אחרי רשתות קונבולוציה ורשתות עם חיבור מלא, כדאי לעיין ברשתות נוירונים חוזרות.
- כדי להריץ את האימון או את ההסקות בענן בתשתית מבוזרת, Google Cloud מספקת את AI Platform.
- בסופו של דבר, נשמח לקבל משוב. אם נתקלתם בבעיה ב-Google Lab הזה או אם יש לכם הצעות לשיפור, נשמח לשמוע מכם. אנחנו מטפלים במשוב באמצעות בעיות ב-GitHub [ קישור למשוב].

|
|
 המחבר: Martin GörnerTwitter:

כל התמונות המצוירות ב-Lab הזה מוגנות בזכויות יוצרים: alexpokusay / 123RF stock photos