

1. ภาพรวม
บทแนะนำนี้ได้รับการอัปเดตสำหรับ Tensorflow 2.2 แล้ว

ใน Codelab นี้ คุณจะได้เรียนรู้วิธีสร้างและฝึกโครงข่ายประสาทเทียมที่จดจำตัวเลขที่เขียนด้วยลายมือ ในระหว่างนี้ เมื่อคุณปรับปรุงโครงข่ายระบบประสาทเทียมเพื่อให้ได้ความแม่นยำ 99% คุณจะได้ค้นพบเครื่องมือที่ผู้เชี่ยวชาญด้านการเรียนรู้เชิงลึกใช้เพื่อฝึกโมเดลอย่างมีประสิทธิภาพ
Codelab นี้ใช้ชุดข้อมูล MNIST ซึ่งเป็นชุดตัวเลขที่มีป้ายกำกับ 60,000 รายการที่ทำให้ผู้ที่จบปริญญาเอกหลายรุ่นต้องทำงานมาเกือบ 2 ทศวรรษ คุณจะแก้ปัญหานี้ได้ด้วยโค้ด Python / TensorFlow ไม่ถึง 100 บรรทัด
สิ่งที่คุณจะได้เรียนรู้
- โครงข่ายระบบประสาทเทียมคืออะไรและจะฝึกได้อย่างไร
- วิธีสร้างโครงข่ายประสาทเทียมแบบ 1 เลเยอร์พื้นฐานโดยใช้ tf.keras
- วิธีเพิ่มเลเยอร์
- วิธีตั้งค่ากำหนดเวลาอัตราการเรียนรู้
- วิธีสร้างโครงข่ายประสาทเทียมแบบคอนโวลูชัน
- วิธีใช้เทคนิคการทำให้เป็นปกติ: Dropout, การทําให้เป็นปกติแบบกลุ่ม
- Overfitting คืออะไร
สิ่งที่คุณต้องมี
ใช้แค่เบราว์เซอร์ เวิร์กช็อปนี้สามารถดำเนินการได้ทั้งหมดด้วย Google Colaboratory
ความคิดเห็น
โปรดแจ้งให้เราทราบหากคุณพบสิ่งผิดปกติในฟีเจอร์ทดลองนี้หรือหากคิดว่าควรมีการปรับปรุง เราจัดการความคิดเห็นผ่านปัญหาใน GitHub [feedback link]
2. คู่มือเริ่มต้นฉบับย่อของ Google Colaboratory
แล็บนี้ใช้ Google Colaboratory และคุณไม่จำเป็นต้องตั้งค่าใดๆ คุณเรียกใช้ได้จาก Chromebook โปรดเปิดไฟล์ด้านล่างและเรียกใช้เซลล์เพื่อให้คุ้นเคยกับสมุดบันทึก Colab

ดูวิธีการเพิ่มเติมด้านล่าง
เลือกแบ็กเอนด์ GPU

ในเมนู Colab ให้เลือกรันไทม์ > เปลี่ยนประเภทรันไทม์ แล้วเลือก GPU การเชื่อมต่อกับรันไทม์จะเกิดขึ้นโดยอัตโนมัติเมื่อมีการดำเนินการครั้งแรก หรือคุณจะใช้ปุ่ม "เชื่อมต่อ" ที่มุมขวาบนก็ได้
การดำเนินการ Notebook
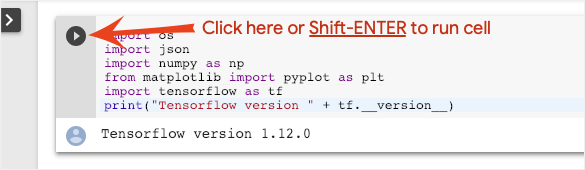
เรียกใช้เซลล์ทีละเซลล์โดยคลิกเซลล์และใช้ Shift-ENTER คุณยังเรียกใช้ทั้ง Notebook ได้ด้วยรันไทม์ > เรียกใช้ทั้งหมด
สารบัญ

Notebook ทุกรายการมีสารบัญ คุณเปิดได้โดยใช้ลูกศรสีดำทางด้านซ้าย
เซลล์ที่ซ่อนอยู่
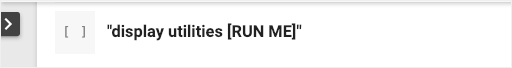
บางเซลล์จะแสดงเฉพาะชื่อ ฟีเจอร์นี้เป็นฟีเจอร์สมุดบันทึกเฉพาะของ Colab คุณดับเบิลคลิกเพื่อดูโค้ดภายในได้ แต่โดยปกติแล้วโค้ดดังกล่าวไม่ค่อยน่าสนใจ โดยปกติจะเป็นฟังก์ชันการสนับสนุนหรือการแสดงภาพ คุณยังคงต้องเรียกใช้เซลล์เหล่านี้เพื่อให้ฟังก์ชันภายในได้รับการกำหนด
3. ฝึกโครงข่ายระบบประสาทเทียม
ก่อนอื่นเราจะดูการฝึกโครงข่ายระบบประสาทเทียม โปรดเปิดสมุดบันทึกด้านล่างและเรียกใช้เซลล์ทั้งหมด อย่าเพิ่งสนใจโค้ด เราจะเริ่มอธิบายในภายหลัง
ขณะรัน Notebook ให้โฟกัสที่การแสดงภาพ ดูคำอธิบายด้านล่าง
ข้อมูลฝึกฝน
เรามีชุดข้อมูลตัวเลขที่เขียนด้วยลายมือซึ่งติดป้ายกำกับไว้เพื่อให้ทราบว่าแต่ละรูปภาพแสดงถึงอะไร เช่น ตัวเลขระหว่าง 0 ถึง 9 คุณจะเห็นข้อความที่ตัดตอนมาใน Notebook

โครงข่ายประสาทเทียมที่เราจะสร้างจะจัดประเภทตัวเลขที่เขียนด้วยลายมือใน 10 คลาส (0, .., 9) โดยจะพิจารณาจากพารามิเตอร์ภายในซึ่งต้องมีค่าที่ถูกต้องเพื่อให้การจัดประเภททำงานได้ดี "ค่าที่ถูกต้อง" นี้ได้มาจากการฝึกกระบวนการที่ต้องใช้ "ชุดข้อมูลที่มีป้ายกำกับ" ซึ่งมีรูปภาพและคำตอบที่ถูกต้องที่เกี่ยวข้อง
เราจะทราบได้อย่างไรว่าโครงข่ายระบบประสาทเทียมที่ฝึกแล้วทำงานได้ดีหรือไม่ การใช้ชุดข้อมูลการฝึกเพื่อทดสอบเครือข่ายถือเป็นการโกง โมเดลเห็นชุดข้อมูลนั้นหลายครั้งแล้วในระหว่างการฝึก และแน่นอนว่าโมเดลจะทำงานได้ดีมากกับชุดข้อมูลนั้น เราต้องการชุดข้อมูลที่มีป้ายกำกับอีกชุดหนึ่ง ซึ่งไม่เคยเห็นในระหว่างการฝึก เพื่อประเมินประสิทธิภาพ "ในโลกแห่งความเป็นจริง" ของเครือข่าย ซึ่งเรียกว่า "ชุดข้อมูลการตรวจสอบ"
ฝึกอบรม
เมื่อการฝึกดำเนินไปทีละชุดข้อมูลฝึกฝน พารามิเตอร์โมเดลภายในจะได้รับการอัปเดต และโมเดลจะจดจำตัวเลขที่เขียนด้วยลายมือได้ดียิ่งขึ้น คุณจะเห็นข้อมูลนี้ในกราฟการฝึก

ทางด้านขวา "ความแม่นยำ" คือเปอร์เซ็นต์ของตัวเลขที่จดจำได้อย่างถูกต้อง ซึ่งจะเพิ่มขึ้นเมื่อการฝึกคืบหน้า ซึ่งเป็นเรื่องดี
ทางด้านซ้าย เราจะเห็น "การสูญเสีย" ในการขับเคลื่อนการฝึก เราจะกำหนดฟังก์ชัน "การสูญเสีย" ซึ่งแสดงถึงความผิดพลาดของระบบในการจดจำตัวเลข และพยายามลดการสูญเสียนี้ สิ่งที่คุณเห็นที่นี่คือการสูญเสียลดลงทั้งในข้อมูลการฝึกและข้อมูลการตรวจสอบเมื่อการฝึกดำเนินไป ซึ่งเป็นเรื่องดี ซึ่งหมายความว่าโครงข่ายระบบประสาทเทียมกำลังเรียนรู้
แกน X แสดงจํานวน "Epoch" หรือการวนซ้ำผ่านชุดข้อมูลทั้งหมด
การคาดการณ์
เมื่อฝึกโมเดลแล้ว เราจะใช้โมเดลนี้เพื่อจดจำตัวเลขที่เขียนด้วยลายมือได้ ภาพข้อมูลถัดไปแสดงประสิทธิภาพของโมเดลในตัวเลข 2-3 หลักที่แสดงผลจากแบบอักษรในเครื่อง (บรรทัดแรก) และในตัวเลข 10,000 หลักของชุดข้อมูลการตรวจสอบ คลาสที่คาดการณ์จะปรากฏใต้ตัวเลขแต่ละตัวเป็นสีแดงหากคาดการณ์ผิด

ดังที่เห็น โมเดลเริ่มต้นนี้ไม่ค่อยดีนัก แต่ก็ยังจดจำตัวเลขบางตัวได้อย่างถูกต้อง ความแม่นยำในการตรวจสอบขั้นสุดท้ายอยู่ที่ประมาณ 90% ซึ่งถือว่าไม่แย่สำหรับโมเดลที่เรียบง่ายที่เราเริ่มต้นด้วย แต่ก็ยังหมายความว่าโมเดลนี้พลาดตัวเลขการตรวจสอบ 1, 000 ตัวจาก 10,000 ตัว ซึ่งมีมากกว่าจำนวนที่แสดงได้ จึงทำให้ดูเหมือนว่าคำตอบทั้งหมดผิด (สีแดง)
เทนเซอร์
ระบบจะจัดเก็บข้อมูลในเมทริกซ์ รูปภาพระดับสีเทาขนาด 28x28 พิกเซลจะพอดีกับเมทริกซ์ 2 มิติขนาด 28x28 แต่สำหรับรูปภาพสี เราต้องใช้มิติข้อมูลเพิ่มเติม มีค่าสี 3 ค่าต่อพิกเซล (แดง เขียว น้ำเงิน) ดังนั้นจึงต้องใช้ตารางสามมิติที่มีมิติข้อมูล [28, 28, 3] และหากต้องการจัดเก็บรูปภาพสี 128 รูปเป็นชุด คุณจะต้องใช้ตาราง 4 มิติที่มีขนาด [128, 28, 28, 3]
ตารางหลายมิตินี้เรียกว่า "เทนเซอร์" และรายการมิติข้อมูลของเทนเซอร์คือ"รูปร่าง"
4. [ข้อมูล]: โครงข่ายประสาทเทียมเบื้องต้น
ข้อมูลโดยสรุป
หากคุณทราบคำศัพท์ทั้งหมดที่ตัวหนาในย่อหน้าถัดไปแล้ว ให้ไปที่แบบฝึกหัดถัดไป หากคุณเพิ่งเริ่มต้นเรียนรู้เชิงลึก ขอต้อนรับและโปรดอ่านต่อ

สำหรับโมเดลที่สร้างเป็นลำดับของเลเยอร์ Keras มี Sequential API ตัวอย่างเช่น ตัวแยกประเภทรูปภาพที่ใช้เลเยอร์แบบหนาแน่น 3 เลเยอร์สามารถเขียนใน Keras ได้ดังนี้
model = tf.keras.Sequential([
    tf.keras.layers.Flatten(input_shape=[28, 28, 1]),
    tf.keras.layers.Dense(200, activation="relu"),
    tf.keras.layers.Dense(60, activation="relu"),
    tf.keras.layers.Dense(10, activation='softmax') # classifying into 10 classes
])

# this configures the training of the model. Keras calls it "compiling" the model.
model.compile(
  optimizer='adam',
  loss= 'categorical_crossentropy',
  metrics=['accuracy']) # % of correct answers

# train the model
model.fit(dataset, ... )

ชั้นหนาแน่นเดียว
ตัวเลขที่เขียนด้วยลายมือในชุดข้อมูล MNIST เป็นรูปภาพระดับสีเทาขนาด 28x28 พิกเซล แนวทางที่ง่ายที่สุดในการจัดประเภทคือการใช้ 28x28=784 พิกเซลเป็นอินพุตสำหรับโครงข่ายระบบประสาทเทียมแบบ 1 ชั้น

"นิวรอน"แต่ละตัวในโครงข่ายระบบประสาทเทียมจะหาผลรวมแบบถ่วงน้ำหนักของอินพุตทั้งหมด จากนั้นจะบวกค่าคงที่ที่เรียกว่า "ไบแอส" แล้วส่งผลลัพธ์ผ่าน"ฟังก์ชันการเปิดใช้งาน"แบบไม่เชิงเส้น "น้ำหนัก" และ "อคติ" คือพารามิเตอร์ที่จะกำหนดผ่านการฝึก โดยจะเริ่มต้นด้วยค่าแบบสุ่มก่อน
รูปภาพด้านบนแสดงโครงข่ายระบบประสาทเทียมแบบ 1 ชั้นที่มีนิวรอนเอาต์พุต 10 ตัว เนื่องจากเราต้องการจัดประเภทตัวเลขเป็น 10 คลาส (0 ถึง 9)
ด้วยการคูณเมทริกซ์
ต่อไปนี้คือวิธีที่เลเยอร์ของโครงข่ายระบบประสาทเทียมที่ประมวลผลคอลเล็กชันรูปภาพแสดงด้วยการคูณเมทริกซ์

การใช้คอลัมน์แรกของน้ำหนักในเมทริกซ์น้ำหนัก W เราจะคำนวณผลรวมแบบถ่วงน้ำหนักของพิกเซลทั้งหมดของรูปภาพแรก ผลรวมนี้สอดคล้องกับนิวรอนแรก เมื่อใช้คอลัมน์ที่ 2 ของน้ำหนัก เราจะทำเช่นเดียวกันกับนิวรอนที่ 2 และอื่นๆ จนถึงนิวรอนที่ 10 จากนั้นเราก็ทำซ้ำการดำเนินการกับรูปภาพที่เหลืออีก 99 รูป หากเราเรียก X ว่าเมทริกซ์ที่มีรูปภาพ 100 รูป ผลรวมที่ถ่วงน้ำหนักทั้งหมดสำหรับนิวรอน 10 ตัวที่คำนวณจากรูปภาพ 100 รูปก็คือ X.W ซึ่งเป็นการคูณเมทริกซ์
ตอนนี้แต่ละนิวรอนต้องเพิ่มค่าอคติ (ค่าคงที่) เนื่องจากเรามีนิวรอน 10 ตัว เราจึงมีค่าคงที่อคติ 10 ตัว เราจะเรียกเวกเตอร์ของค่า 10 ค่านี้ว่า b โดยต้องเพิ่มลงในแต่ละบรรทัดของเมทริกซ์ที่คำนวณไว้ก่อนหน้านี้ เราจะเขียนสิ่งนี้ด้วยเครื่องหมายบวกง่ายๆ โดยใช้เทคนิคเล็กๆ น้อยๆ ที่เรียกว่า "การออกอากาศ"
สุดท้าย เราจะใช้ฟังก์ชันการเปิดใช้งาน เช่น "softmax" (อธิบายไว้ด้านล่าง) และรับสูตรที่อธิบายโครงข่ายระบบประสาทเทียมแบบ 1 ชั้น ซึ่งใช้กับรูปภาพ 100 รูป

ใน Keras
ไลบรารีโครงข่ายระบบประสาทเทียมระดับสูงอย่าง Keras จะช่วยให้เราไม่ต้องใช้สูตรนี้ อย่างไรก็ตาม สิ่งสำคัญที่ควรทราบคือเลเยอร์ของโครงข่ายระบบประสาทเทียมเป็นเพียงการคูณและการบวกจำนวนมาก ใน Keras เลเยอร์ Dense จะเขียนได้ดังนี้
tf.keras.layers.Dense(10, activation='softmax')
เจาะลึก
การเชื่อมต่อเลเยอร์ของโครงข่ายประสาทนั้นทำได้ง่ายมาก เลเยอร์แรกจะคำนวณผลรวมแบบถ่วงน้ำหนักของพิกเซล เลเยอร์ถัดไปจะคำนวณผลรวมแบบถ่วงน้ำหนักของเอาต์พุตของเลเยอร์ก่อนหน้า

ความแตกต่างเพียงอย่างเดียว นอกเหนือจากจำนวนนิวรอน คือการเลือกฟังก์ชันการเปิดใช้งาน
ฟังก์ชันการเปิดใช้งาน: relu, softmax และ sigmoid
โดยปกติแล้ว คุณจะใช้ฟังก์ชันการกระตุ้น "relu" สำหรับทุกเลเยอร์ยกเว้นเลเยอร์สุดท้าย เลเยอร์สุดท้ายในตัวแยกประเภทจะใช้การเปิดใช้งาน "softmax"

อีกครั้งที่ "นิวรอน" จะคำนวณผลรวมแบบถ่วงน้ำหนักของอินพุตทั้งหมด เพิ่มค่าที่เรียกว่า "อคติ" และป้อนผลลัพธ์ผ่านฟังก์ชันกระตุ้น
ฟังก์ชันการเปิดใช้งานที่ได้รับความนิยมมากที่สุดเรียกว่า "RELU" สำหรับ Rectified Linear Unit ฟังก์ชันนี้ใช้งานง่ายมาก ดังที่เห็นในกราฟด้านบน
ฟังก์ชันการเปิดใช้งานแบบดั้งเดิมในโครงข่ายระบบประสาทเทียมคือ "sigmoid" แต่ "relu" แสดงให้เห็นว่ามีคุณสมบัติการบรรจบกันที่ดีกว่าเกือบทุกที่และตอนนี้เป็นที่นิยมมากกว่า

การเปิดใช้งาน Softmax สำหรับการจัดประเภท
เลเยอร์สุดท้ายของโครงข่ายประสาทเทียมมีนิวรอน 10 ตัวเนื่องจากเราต้องการจัดประเภทตัวเลขที่เขียนด้วยลายมือเป็น 10 คลาส (0,..9) โดยควรแสดงตัวเลข 10 ตัวระหว่าง 0 ถึง 1 ซึ่งแสดงถึงความน่าจะเป็นที่ตัวเลขนี้จะเป็น 0, 1, 2 และอื่นๆ สำหรับเลเยอร์สุดท้าย เราจะใช้ฟังก์ชันการเปิดใช้งานที่เรียกว่า "softmax"
การใช้ Softmax กับเวกเตอร์ทำได้โดยการหาเลขชี้กำลังของแต่ละองค์ประกอบ แล้วทำให้เวกเตอร์เป็นปกติ โดยปกติจะหารด้วยนอร์ม "L1" (เช่น ผลรวมของค่าสัมบูรณ์) เพื่อให้ค่าที่ทำให้เป็นปกติมีผลรวมเป็น 1 และสามารถตีความเป็นความน่าจะเป็นได้
บางครั้งเราจะเรียกเอาต์พุตของเลเยอร์สุดท้ายก่อนการเปิดใช้งานว่า "ลอจิท" หากเวกเตอร์นี้คือ L = [L0, L1, L2, L3, L4, L5, L6, L7, L8, L9] จะได้ว่า


การสูญเสียแบบ Cross-Entropy
เมื่อโครงข่ายระบบประสาทเทียมสร้างการคาดการณ์จากรูปภาพอินพุตแล้ว เราต้องวัดว่าการคาดการณ์นั้นดีเพียงใด กล่าวคือ ระยะห่างระหว่างสิ่งที่โครงข่ายระบบประสาทเทียมบอกกับคำตอบที่ถูกต้อง ซึ่งมักเรียกว่า "ป้ายกำกับ" โปรดทราบว่าเรามีป้ายกำกับที่ถูกต้องสำหรับรูปภาพทั้งหมดในชุดข้อมูล
ระยะทางใดก็ได้ แต่สำหรับปัญหาการจัดประเภท "ระยะทางครอสเอนโทรปี" ที่เรียกว่ามีประสิทธิภาพมากที่สุด เราจะเรียกฟังก์ชันนี้ว่าฟังก์ชันข้อผิดพลาดหรือ "การสูญเสีย"

การไล่ระดับสี
"การฝึก" โครงข่ายระบบประสาทเทียมหมายถึงการใช้รูปภาพและป้ายกำกับการฝึกเพื่อปรับน้ำหนักและอคติเพื่อลดฟังก์ชันการสูญเสียเอนโทรปีแบบครอสให้เหลือน้อยที่สุด วิธีการทำงานมีดังนี้
Cross-Entropy เป็นฟังก์ชันของน้ำหนัก อคติ พิกเซลของรูปภาพการฝึก และคลาสที่ทราบ
หากเราคำนวณอนุพันธ์ย่อยของครอสเอนโทรปีเทียบกับน้ำหนักทั้งหมดและอคติทั้งหมด เราจะได้ "การไล่ระดับสี" ซึ่งคำนวณสำหรับรูปภาพ ป้ายกำกับ และค่าปัจจุบันของน้ำหนักและอคติที่กำหนด โปรดทราบว่าเรามีค่าถ่วงน้ำหนักและไบแอสหลายล้านรายการ ดังนั้นการคำนวณการไล่ระดับจึงดูเหมือนเป็นงานที่ต้องใช้ความพยายามอย่างมาก โชคดีที่ TensorFlow จัดการเรื่องนี้ให้เรา คุณสมบัติทางคณิตศาสตร์ของค่าการไล่ระดับสีคือจะชี้ "ขึ้น" เนื่องจากเราต้องการไปในทิศทางที่ครอสเอนโทรปีต่ำ เราจึงไปในทิศทางตรงกันข้าม เราอัปเดตน้ำหนักและอคติด้วยเศษส่วนของค่าการไล่ระดับ จากนั้นเราจะทำซ้ำไปเรื่อยๆ โดยใช้รูปภาพและป้ายกำกับการฝึกชุดถัดไปในลูปการฝึก หวังว่าการดำเนินการนี้จะทำให้เกิดจุดที่ครอสเอนโทรปีน้อยที่สุด แม้ว่าจะไม่มีอะไรรับประกันว่าค่าต่ำสุดนี้จะเป็นค่าเดียวก็ตาม

การประมวลผลแบบมินิแบทช์และโมเมนตัม
คุณสามารถคำนวณการไล่ระดับสีในรูปภาพตัวอย่างเพียงรูปเดียวและอัปเดตน้ำหนักและอคติได้ทันที แต่การทำเช่นนี้กับรูปภาพเป็นกลุ่ม เช่น 128 รูป จะทำให้ได้การไล่ระดับสีที่แสดงถึงข้อจำกัดที่กำหนดโดยรูปภาพตัวอย่างต่างๆ ได้ดีกว่า ดังนั้นจึงมีแนวโน้มที่จะบรรลุโซลูชันได้เร็วขึ้น ขนาดของมินิแบตช์เป็นพารามิเตอร์ที่ปรับได้
เทคนิคนี้ซึ่งบางครั้งเรียกว่า "การไล่ระดับความชันแบบสุ่ม" มีประโยชน์อีกอย่างที่ใช้งานได้จริงมากกว่า นั่นคือการทำงานกับกลุ่มข้อมูลยังหมายถึงการทำงานกับเมทริกซ์ขนาดใหญ่ขึ้นด้วย ซึ่งมักจะเพิ่มประสิทธิภาพใน GPU และ TPU ได้ง่ายกว่า
อย่างไรก็ตาม การบรรจบกันอาจยังคงวุ่นวายเล็กน้อยและอาจหยุดลงได้หากเวกเตอร์การไล่ระดับเป็น 0 ทั้งหมด ซึ่งหมายความว่าเราพบค่าต่ำสุดแล้วใช่ไหม ไม่เสมอไป คอมโพเนนต์การไล่ระดับสีอาจเป็น 0 ในค่าต่ำสุดหรือค่าสูงสุด เมื่อมีเวกเตอร์การไล่ระดับที่มีองค์ประกอบหลายล้านรายการ หากองค์ประกอบทั้งหมดเป็น 0 ความน่าจะเป็นที่ 0 ทุกตัวจะสอดคล้องกับจุดต่ำสุดและไม่มีตัวใดสอดคล้องกับจุดสูงสุดจะค่อนข้างน้อย ในพื้นที่ที่มีหลายมิติ จุดอานมักจะพบได้ทั่วไป และเราไม่ต้องการหยุดที่จุดอาน

ภาพ: จุดอานม้า ความชันเป็น 0 แต่ไม่ใช่ค่าต่ำสุดในทุกทิศทาง (การระบุแหล่งที่มาของรูปภาพ Wikimedia: By Nicoguaro - Own work, CC BY 3.0)
วิธีแก้คือการเพิ่มโมเมนตัมให้กับอัลกอริทึมการเพิ่มประสิทธิภาพเพื่อให้ผ่านจุดอานม้าไปได้โดยไม่ต้องหยุด
อภิธานศัพท์
กลุ่มหรือกลุ่มย่อย: การฝึกจะดำเนินการกับกลุ่มข้อมูลฝึกฝนและป้ายกำกับเสมอ ซึ่งจะช่วยให้อัลกอริทึมทำงานได้ มิติข้อมูล "กลุ่ม" มักจะเป็นมิติข้อมูลแรกของเทนเซอร์ข้อมูล เช่น Tensor ที่มีรูปร่าง [100, 192, 192, 3] มีรูปภาพ 100 รูปขนาด 192x192 พิกเซล โดยมีค่า 3 ค่าต่อพิกเซล (RGB)
การสูญเสียแบบครอสเอนโทรปี: ฟังก์ชันการสูญเสียพิเศษที่มักใช้ในตัวแยกประเภท
เลเยอร์แบบหนาแน่น: เลเยอร์ของนิวรอนที่นิวรอนแต่ละตัวเชื่อมต่อกับนิวรอนทั้งหมดในเลเยอร์ก่อนหน้า
ฟีเจอร์: บางครั้งอินพุตของโครงข่ายระบบประสาทเทียมเรียกว่า "ฟีเจอร์" ศิลปะในการพิจารณาว่าควรป้อนส่วนใดของชุดข้อมูล (หรือการรวมกันของส่วนต่างๆ) ลงในโครงข่ายระบบประสาทเทียมเพื่อให้ได้การคาดการณ์ที่ดีเรียกว่า "Feature Engineering"
ป้ายกำกับ: ชื่ออื่นของ "คลาส" หรือคำตอบที่ถูกต้องในปัญหาการแยกประเภทภายใต้การดูแล
อัตราการเรียนรู้: เศษส่วนของค่าการไล่ระดับที่ใช้ในการอัปเดตน้ำหนักและอคติในแต่ละการวนซ้ำของลูปการฝึก
ลอจิท: เอาต์พุตของเลเยอร์ของนิวรอนก่อนที่จะใช้ฟังก์ชันการกระตุ้นเรียกว่า "ลอจิท" คำนี้มาจาก "ฟังก์ชันโลจิสติก" หรือที่เรียกว่า "ฟังก์ชันซิกมอยด์" ซึ่งเคยเป็นฟังก์ชันกระตุ้นที่ได้รับความนิยมมากที่สุด "เอาต์พุตของนิวรอนก่อนฟังก์ชันลอจิสติก" เปลี่ยนชื่อเป็น "ลอจิท"
loss: ฟังก์ชันข้อผิดพลาดที่เปรียบเทียบเอาต์พุตของโครงข่ายระบบประสาทเทียมกับคำตอบที่ถูกต้อง
นิวรอน: คำนวณผลรวมแบบถ่วงน้ำหนักของอินพุต เพิ่มอคติ และป้อนผลลัพธ์ผ่านฟังก์ชันการเปิดใช้งาน
การเข้ารหัสแบบ One-hot: ระบบจะเข้ารหัสคลาส 3 จาก 5 เป็นเวกเตอร์ที่มีองค์ประกอบ 5 รายการ ซึ่งเป็น 0 ทั้งหมด ยกเว้นรายการที่ 3 ซึ่งเป็น 1
relu: หน่วยเชิงเส้นที่แก้ไขแล้ว ฟังก์ชันการเปิดใช้งานยอดนิยมสำหรับนิวรอน
sigmoid: ฟังก์ชันกระตุ้นอีกฟังก์ชันหนึ่งที่เคยได้รับความนิยมและยังคงมีประโยชน์ในกรณีพิเศษ
softmax: ฟังก์ชันการกระตุ้นพิเศษที่ทำงานกับเวกเตอร์ เพิ่มความแตกต่างระหว่างคอมโพเนนต์ที่ใหญ่ที่สุดกับคอมโพเนนต์อื่นๆ ทั้งหมด และยังปรับเวกเตอร์ให้มีผลรวมเป็น 1 เพื่อให้ตีความได้เป็นเวกเตอร์ของความน่าจะเป็น ใช้เป็นขั้นตอนสุดท้ายในตัวแยกประเภท
เทนเซอร์: "เทนเซอร์" คล้ายกับเมทริกซ์ แต่มีจำนวนมิติข้อมูลเท่าใดก็ได้ Tensor 1 มิติคือเวกเตอร์ Tensor 2 มิติคือเมทริกซ์ จากนั้นคุณก็จะมีเทนเซอร์ที่มี 3, 4, 5 มิติ หรือมากกว่านั้น
5. มาดูโค้ดกันเลย
กลับไปที่ Notebook สำหรับการเรียนรู้ แล้วมาอ่านโค้ดกัน
มาดูเซลล์ทั้งหมดในสมุดบันทึกนี้กัน
เซลล์ "พารามิเตอร์"
ขนาดกลุ่ม จำนวน Epoch การฝึก และตำแหน่งของไฟล์ข้อมูลจะกำหนดไว้ที่นี่ ไฟล์ข้อมูลโฮสต์อยู่ใน Bucket ของ Google Cloud Storage (GCS) ที่อยู่จึงเริ่มต้นด้วย gs://
เซลล์ "การนำเข้า"
เราจะนำเข้าไลบรารี Python ที่จำเป็นทั้งหมดที่นี่ รวมถึง TensorFlow และ matplotlib สำหรับการแสดงภาพ
เซลล์ "visualization utilities [RUN ME]****"
เซลล์นี้มีโค้ดการแสดงข้อมูลผ่านภาพที่ไม่น่าสนใจ โดยจะยุบอยู่โดยค่าเริ่มต้น แต่คุณสามารถเปิดและดูโค้ดได้เมื่อมีเวลาด้วยการดับเบิลคลิก
เซลล์ "tf.data.Dataset: แยกวิเคราะห์ไฟล์และเตรียมชุดข้อมูลการฝึกและชุดข้อมูลการตรวจสอบ"
เซลล์นี้ใช้ tf.data.Dataset API เพื่อโหลดชุดข้อมูล MNIST จากไฟล์ข้อมูล คุณไม่จำเป็นต้องใช้เวลากับเซลล์นี้มากเกินไป หากคุณสนใจ tf.data.Dataset API โปรดดูบทแนะนำที่อธิบายเรื่องนี้ที่Data Pipeline ที่ทำงานด้วยความเร็วของ TPU ตอนนี้ข้อมูลพื้นฐานมีดังนี้
รูปภาพและป้ายกำกับ (คำตอบที่ถูกต้อง) จากชุดข้อมูล MNIST จะจัดเก็บไว้ในบันทึกที่มีความยาวคงที่ใน 4 ไฟล์ คุณโหลดไฟล์ได้โดยใช้ฟังก์ชันบันทึกแบบคงที่โดยเฉพาะ ดังนี้
imagedataset = tf.data.FixedLengthRecordDataset(image_filename, 28*28, header_bytes=16)
ตอนนี้เรามีชุดข้อมูลไบต์ของรูปภาพแล้ว โดยต้องถอดรหัสเป็นรูปภาพ เรากำหนดฟังก์ชันเพื่อดำเนินการดังกล่าว โดยจะไม่มีการบีบอัดรูปภาพ ดังนั้นฟังก์ชันจึงไม่จำเป็นต้องถอดรหัสใดๆ (decode_raw ไม่ได้ทำอะไรเลย) จากนั้นระบบจะแปลงรูปภาพเป็นค่าทศนิยมระหว่าง 0 ถึง 1 เราสามารถปรับรูปร่างที่นี่เป็นรูปภาพ 2 มิติได้ แต่จริงๆ แล้วเราจะเก็บไว้เป็นอาร์เรย์พิกเซลแบบแบนขนาด 28*28 เนื่องจากเป็นสิ่งที่เลเยอร์หนาแน่นเริ่มต้นของเราคาดหวัง
def read_image(tf_bytestring):
    image = tf.io.decode_raw(tf_bytestring, tf.uint8)
    image = tf.cast(image, tf.float32)/256.0
    image = tf.reshape(image, [28*28])
    return image
เราใช้ฟังก์ชันนี้กับชุดข้อมูลโดยใช้ .map และได้รับชุดข้อมูลรูปภาพ
imagedataset = imagedataset.map(read_image, num_parallel_calls=16)
เราจะอ่านและถอดรหัสป้ายกำกับในลักษณะเดียวกัน และ.zipรูปภาพและป้ายกำกับเข้าด้วยกัน
dataset = tf.data.Dataset.zip((imagedataset, labelsdataset))
ตอนนี้เรามีชุดข้อมูลของคู่ (รูปภาพ ป้ายกำกับ) แล้ว ซึ่งเป็นสิ่งที่โมเดลของเราคาดหวัง เรายังไม่พร้อมที่จะใช้ฟีเจอร์นี้ในฟังก์ชันการฝึกอบรม
dataset = dataset.cache()
dataset = dataset.shuffle(5000, reshuffle_each_iteration=True)
dataset = dataset.repeat()
dataset = dataset.batch(batch_size)
dataset = dataset.prefetch(tf.data.experimental.AUTOTUNE)
API tf.data.Dataset มีฟังก์ชันยูทิลิตีที่จำเป็นทั้งหมดสำหรับการเตรียมชุดข้อมูล
.cache จะแคชชุดข้อมูลใน RAM นี่คือชุดข้อมูลขนาดเล็ก จึงจะใช้งานได้ .shuffle จะสับเปลี่ยนรายการโดยใช้บัฟเฟอร์ที่มีองค์ประกอบ 5,000 รายการ ข้อมูลฝึกฝนต้องได้รับการสับเปลี่ยนอย่างดี .repeat จะวนซ้ำชุดข้อมูล เราจะฝึกโมเดลหลายครั้ง (หลายยุค) .batch จะดึงรูปภาพและป้ายกำกับหลายรายการมารวมกันเป็นมินิแบทช์ สุดท้าย .prefetch สามารถใช้ CPU เพื่อเตรียมชุดข้อมูลถัดไปขณะที่ GPU กำลังฝึกชุดข้อมูลปัจจุบัน
ระบบจะจัดเตรียมชุดข้อมูลการตรวจสอบในลักษณะที่คล้ายกัน ตอนนี้เราพร้อมที่จะกำหนดโมเดลและใช้ชุดข้อมูลนี้เพื่อฝึกโมเดลแล้ว
เซลล์ "โมเดล Keras"
โมเดลทั้งหมดของเราจะเป็นลำดับเลเยอร์ตรงๆ เพื่อให้เราใช้สไตล์ tf.keras.Sequential ในการสร้างโมเดลได้ ในตอนแรกที่นี่เป็นเลเยอร์หนาแน่นเดียว โดยมีนิวรอน 10 ตัวเนื่องจากเราจัดประเภทตัวเลขที่เขียนด้วยลายมือเป็น 10 คลาส โดยใช้การเปิดใช้งาน "softmax" เนื่องจากเป็นเลเยอร์สุดท้ายในตัวแยกประเภท
โมเดล Keras ยังต้องทราบรูปร่างของอินพุตด้วย tf.keras.layers.Input ใช้เพื่อกำหนดได้ ในที่นี้ เวกเตอร์อินพุตคือเวกเตอร์แบบแบนของค่าพิกเซลที่มีความยาว 28*28
model = tf.keras.Sequential(
  [
    tf.keras.layers.Input(shape=(28*28,)),
    tf.keras.layers.Dense(10, activation='softmax')
  ])

model.compile(optimizer='sgd',
              loss='categorical_crossentropy',
              metrics=['accuracy'])

# print model layers
model.summary()

# utility callback that displays training curves
plot_training = PlotTraining(sample_rate=10, zoom=1)
การกำหนดค่าโมเดลทำได้ใน Keras โดยใช้ฟังก์ชัน model.compile ในที่นี้เราใช้ตัวเพิ่มประสิทธิภาพพื้นฐาน 'sgd' (Stochastic Gradient Descent) โมเดลการแยกประเภทต้องมีฟังก์ชันการสูญเสียแบบ Cross-Entropy ซึ่งเรียกว่า 'categorical_crossentropy' ใน Keras สุดท้าย เราขอให้โมเดลคำนวณเมตริก 'accuracy' ซึ่งเป็นเปอร์เซ็นต์ของรูปภาพที่จัดประเภทอย่างถูกต้อง
Keras มีmodel.summary()ยูทิลิตีที่ยอดเยี่ยมซึ่งจะพิมพ์รายละเอียดของโมเดลที่คุณสร้างขึ้น ผู้สอนได้เพิ่มยูทิลิตี PlotTraining (กำหนดไว้ในเซลล์ "ยูทิลิตีการแสดงภาพ") ซึ่งจะแสดงเส้นโค้งการฝึกต่างๆ ในระหว่างการฝึก
เซลล์ "ฝึกและตรวจสอบโมเดล"
ซึ่งการฝึกจะเกิดขึ้นที่นี่โดยการเรียกใช้ model.fit และส่งทั้งชุดข้อมูลการฝึกและชุดข้อมูลการตรวจสอบ โดยค่าเริ่มต้น Keras จะเรียกใช้รอบการตรวจสอบเมื่อสิ้นสุดแต่ละ Epoch
model.fit(training_dataset, steps_per_epoch=steps_per_epoch, epochs=EPOCHS,
          validation_data=validation_dataset, validation_steps=1,
          callbacks=[plot_training])
ใน Keras คุณสามารถเพิ่มลักษณะการทำงานที่กำหนดเองในระหว่างการฝึกได้โดยใช้การเรียกกลับ เราจึงใช้พล็อตการฝึกที่อัปเดตแบบไดนามิกสำหรับเวิร์กช็อปนี้
เซลล์ "แสดงภาพการคาดการณ์"
เมื่อฝึกโมเดลแล้ว เราจะรับการคาดการณ์จากโมเดลได้โดยการเรียกใช้ model.predict():
probabilities = model.predict(font_digits, steps=1)
predicted_labels = np.argmax(probabilities, axis=1)
เราได้เตรียมชุดตัวเลขที่พิมพ์ออกมาซึ่งแสดงผลจากแบบอักษรในเครื่องเพื่อใช้ในการทดสอบ โปรดทราบว่าโครงข่ายระบบประสาทเทียมจะแสดงเวกเตอร์ของความน่าจะเป็น 10 รายการจาก "softmax" สุดท้าย หากต้องการป้ายกำกับ เราต้องหาว่าความน่าจะเป็นใดสูงที่สุด np.argmax จากไลบรารี numpy จะทำสิ่งนั้น
หากต้องการทราบเหตุผลที่ต้องใช้พารามิเตอร์ axis=1 โปรดทราบว่าเราประมวลผลรูปภาพ 128 รูปพร้อมกัน ดังนั้นโมเดลจึงแสดงผลเวกเตอร์ความน่าจะเป็น 128 รายการ รูปร่างของเทนเซอร์เอาต์พุตคือ [128, 10] เรากำลังคำนวณ argmax ในความน่าจะเป็น 10 รายการที่แสดงผลสำหรับแต่ละรูปภาพ ดังนั้น axis=1 (แกนแรกคือ 0)
โมเดลอย่างง่ายนี้จดจำตัวเลขได้ถึง 90% ไม่แย่ แต่ตอนนี้คุณจะปรับปรุงให้ดีขึ้นได้มาก

6. การเพิ่มเลเยอร์

เราจะเพิ่มชั้นในโครงข่ายระบบประสาทเทียมเพื่อปรับปรุงความแม่นยำในการจดจำ

เราใช้ Softmax เป็นฟังก์ชันกระตุ้นในเลเยอร์สุดท้ายเนื่องจากเป็นฟังก์ชันที่เหมาะกับการจัดประเภทมากที่สุด แต่ในเลเยอร์กลาง เราจะใช้ฟังก์ชันกระตุ้นที่คลาสสิกที่สุด นั่นคือ ซิกมอยด์
เช่น โมเดลของคุณอาจมีลักษณะดังนี้ (อย่าลืมใส่คอมมา tf.keras.Sequential รับรายการเลเยอร์ที่คั่นด้วยคอมมา)
model = tf.keras.Sequential(
  [
      tf.keras.layers.Input(shape=(28*28,)),
      tf.keras.layers.Dense(200, activation='sigmoid'),
      tf.keras.layers.Dense(60, activation='sigmoid'),
      tf.keras.layers.Dense(10, activation='softmax')
  ])
ดู "สรุป" ของโมเดล ตอนนี้มีพารามิเตอร์มากกว่าเดิมอย่างน้อย 10 เท่า ซึ่งควรจะดีกว่าเดิมถึง 10 เท่า แต่ไม่รู้ทำไมมันถึงไม่เป็นแบบนั้น ...

ดูเหมือนว่าการสูญเสียจะพุ่งสูงขึ้นด้วย มีบางอย่างไม่ถูกต้อง
7. การดูแลเป็นพิเศษสำหรับเครือข่ายแบบลึก
คุณเพิ่งได้สัมผัสกับโครงข่ายประสาทเทียม ซึ่งเป็นสิ่งที่ผู้คนเคยออกแบบในยุค 80 และ 90 จึงไม่แปลกใจเลยว่าทำไมพวกเขาจึงล้มเลิกแนวคิดนี้ ซึ่งนำไปสู่สิ่งที่เรียกว่า "ยุคน้ำแข็งของ AI" ยิ่งคุณเพิ่มเลเยอร์มากเท่าใด เครือข่ายประสาทก็จะยิ่งพบปัญหาในการบรรจบกันมากขึ้นเท่านั้น
ปรากฏว่าโครงข่ายประสาทแบบลึกที่มีหลายชั้น (ปัจจุบันมี 20, 50 หรือแม้แต่ 100 ชั้น) สามารถทำงานได้ดีมาก เพียงแค่ใช้เทคนิคทางคณิตศาสตร์เล็กๆ น้อยๆ เพื่อให้โครงข่ายประสาทแบบลึกทำงานร่วมกัน การค้นพบเคล็ดลับง่ายๆ เหล่านี้เป็นเหตุผลหนึ่งที่ทำให้เกิดการฟื้นฟูการเรียนรู้เชิงลึกในช่วงปี 2010
การเปิดใช้งาน RELU

ฟังก์ชันกระตุ้นแบบซิคมอยด์มีปัญหาค่อนข้างมากในเครือข่ายแบบลึก โดยจะบีบอัดค่าทั้งหมดระหว่าง 0 ถึง 1 และเมื่อทำเช่นนี้ซ้ำๆ เอาต์พุตของนิวรอนและค่าการไล่ระดับสีอาจหายไปโดยสิ้นเชิง มีการกล่าวถึงด้วยเหตุผลทางประวัติศาสตร์ แต่เครือข่ายสมัยใหม่ใช้ RELU (Rectified Linear Unit) ซึ่งมีลักษณะดังนี้

ในทางกลับกัน relu มีอนุพันธ์เป็น 1 อย่างน้อยก็ทางด้านขวา การเปิดใช้งาน RELU จะทำให้มีนิวรอนอื่นๆ ที่ให้การไล่ระดับที่ไม่ใช่ 0 อย่างชัดเจนเสมอ แม้ว่าการไล่ระดับที่มาจากนิวรอนบางตัวจะเป็น 0 ก็ตาม และการฝึกก็สามารถดำเนินต่อไปได้ในอัตราที่ดี
เครื่องมือเพิ่มประสิทธิภาพที่ดีขึ้น
ในพื้นที่ที่มีมิติสูงมาก เช่น ที่นี่ ซึ่งมีน้ำหนักและอคติประมาณ 10,000 รายการ "จุดอานม้า" มักจะเกิดขึ้นบ่อย จุดเหล่านี้ไม่ใช่จุดต่ำสุดเฉพาะที่ แต่เป็นจุดที่ค่าการไล่ระดับเป็น 0 และเครื่องมือเพิ่มประสิทธิภาพการไล่ระดับแบบไล่ลงจะติดอยู่ที่จุดนั้น TensorFlow มีตัวเพิ่มประสิทธิภาพที่พร้อมใช้งานครบทุกรูปแบบ รวมถึงตัวเพิ่มประสิทธิภาพบางตัวที่ทำงานร่วมกับปริมาณโมเมนตัมและจะผ่านจุดอานได้อย่างปลอดภัย
การเริ่มต้นแบบสุ่ม
การเริ่มต้นค่าเริ่มต้นของน้ำหนักก่อนการฝึกเป็นหัวข้อการวิจัยในตัวของมันเอง โดยมีเอกสารจำนวนมากที่เผยแพร่ในหัวข้อนี้ คุณดูตัวเริ่มต้นทั้งหมดที่มีใน Keras ได้ที่นี่ โชคดีที่ Keras ทำสิ่งที่ถูกต้องโดยค่าเริ่มต้นและใช้'glorot_uniform'ตัวเริ่มต้นซึ่งดีที่สุดในเกือบทุกกรณี
คุณไม่ต้องดำเนินการใดๆ เนื่องจาก Keras ทำสิ่งที่ถูกต้องอยู่แล้ว
NaN ???
สูตร Cross-Entropy เกี่ยวข้องกับลอการิทึมและ log(0) ไม่ใช่ตัวเลข (NaN ซึ่งเป็นข้อขัดข้องทางตัวเลขหากคุณต้องการ) อินพุตของ Cross-Entropy เป็น 0 ได้ไหม อินพุตมาจาก Softmax ซึ่งเป็นฟังก์ชันเลขชี้กำลัง และฟังก์ชันเลขชี้กำลังจะไม่มีค่าเป็น 0 เราจึงปลอดภัย
จริงเหรอ ในโลกที่สวยงามของคณิตศาสตร์ เราจะปลอดภัย แต่ในโลกคอมพิวเตอร์ exp(-150) ซึ่งแสดงในรูปแบบ float32 จะเป็น 0 และ Cross-Entropy จะหยุดทำงาน
โชคดีที่คุณไม่ต้องทำอะไรที่นี่เช่นกัน เนื่องจาก Keras จะจัดการเรื่องนี้และคำนวณ Softmax ตามด้วย Cross-Entropy อย่างระมัดระวังเป็นพิเศษเพื่อให้มั่นใจถึงความเสถียรของตัวเลขและหลีกเลี่ยง NaN ที่น่ากลัว
สำเร็จไหม

ตอนนี้คุณควรมีความแม่นยำถึง 97% แล้ว เป้าหมายในการเวิร์กช็อปนี้คือการเพิ่มความแม่นยำให้สูงกว่า 99% อย่างมาก ดังนั้นมาลุยกันต่อเลย
หากคุณติดขัด โปรดดูวิธีแก้ปัญหาในตอนนี้
8. การลดอัตราการเรียนรู้
เราอาจลองฝึกให้เร็วขึ้นได้ไหม อัตราการเรียนรู้เริ่มต้นในเครื่องมือเพิ่มประสิทธิภาพ Adam คือ 0.001 มาลองเพิ่มกัน
การเร่งความเร็วดูเหมือนจะไม่ช่วยอะไรมาก แล้วเสียงรบกวนทั้งหมดนี้คืออะไร

เส้นโค้งการฝึกนั้นมีสัญญาณรบกวนมาก และดูเส้นโค้งการตรวจสอบทั้ง 2 เส้นโค้งจะเห็นว่าเส้นโค้งขึ้นๆ ลงๆ ซึ่งหมายความว่าเรากำลังไปเร็วเกินไป เราอาจกลับไปใช้ความเร็วเดิมได้ แต่ก็มีวิธีที่ดีกว่า

วิธีแก้ปัญหาที่ดีคือการเริ่มต้นอย่างรวดเร็วและลดอัตราการเรียนรู้แบบเอ็กซ์โปเนนเชียล ใน Keras คุณทำได้โดยใช้tf.keras.callbacks.LearningRateSchedulerการเรียกกลับ
โค้ดที่มีประโยชน์สำหรับการคัดลอกและวาง
# lr decay function
def lr_decay(epoch):
  return 0.01 * math.pow(0.6, epoch)

# lr schedule callback
lr_decay_callback = tf.keras.callbacks.LearningRateScheduler(lr_decay, verbose=True)

# important to see what you are doing
plot_learning_rate(lr_decay, EPOCHS)
อย่าลืมใช้ lr_decay_callback ที่คุณสร้างขึ้น เพิ่มลงในรายการการเรียกกลับใน model.fit โดยทำดังนี้
model.fit(..., callbacks=[plot_training, lr_decay_callback])
การเปลี่ยนแปลงเล็กๆ น้อยๆ นี้ส่งผลลัพธ์ที่น่าทึ่ง คุณจะเห็นว่าเสียงรบกวนส่วนใหญ่หายไปแล้ว และความแม่นยำของการทดสอบตอนนี้สูงกว่า 98% อย่างต่อเนื่อง

9. Dropout, Overfitting
ตอนนี้โมเดลดูเหมือนจะทำงานได้ดี มาเจาะลึกกันอีก
วิธีนี้ช่วยได้ไหม

ไม่จริง ความแม่นยำยังคงอยู่ที่ 98% และดูการสูญเสียการตรวจสอบ กำลังเพิ่มขึ้น อัลกอริทึมการเรียนรู้จะทำงานกับข้อมูลการฝึกเท่านั้นและเพิ่มประสิทธิภาพการสูญเสียการฝึกตามนั้น เนื่องจากไม่เคยเห็นข้อมูลการตรวจสอบ จึงไม่น่าแปลกใจที่หลังจากผ่านไปสักระยะ การทำงานของโมเดลจะไม่ส่งผลต่อการสูญเสียการตรวจสอบอีกต่อไป ซึ่งจะหยุดลดลงและบางครั้งอาจเพิ่มขึ้นด้วย
การดำเนินการนี้จะไม่ส่งผลต่อความสามารถในการจดจำในโลกแห่งความเป็นจริงของโมเดลในทันที แต่จะทำให้คุณไม่สามารถเรียกใช้การทำซ้ำหลายครั้งได้ และโดยทั่วไปแล้วจะเป็นสัญญาณว่าการฝึกไม่ได้ให้ผลลัพธ์ในเชิงบวกอีกต่อไป

การแยกส่วนนี้มักเรียกว่า "Overfitting" และเมื่อเห็นการแยกส่วนนี้ คุณสามารถลองใช้เทคนิคการปรับค่าปกติที่เรียกว่า "Dropout" เทคนิค Dropout จะยิงนิวรอนแบบสุ่มในการวนซ้ำการฝึกแต่ละครั้ง
ทำงานได้ดีหรือไม่

สัญญาณรบกวนจะปรากฏขึ้นอีกครั้ง (ไม่น่าแปลกใจเนื่องจากลักษณะการทำงานของการขาดหาย) การสูญเสียการตรวจสอบดูเหมือนจะไม่เพิ่มขึ้นอีกต่อไป แต่โดยรวมแล้วสูงกว่ากรณีที่ไม่มี Dropout และความแม่นยำในการตรวจสอบก็ลดลงเล็กน้อย ซึ่งเป็นผลลัพธ์ที่ค่อนข้างน่าผิดหวัง
ดูเหมือนว่า Dropout ไม่ใช่โซลูชันที่ถูกต้อง หรืออาจเป็นเพราะ "Overfitting" เป็นแนวคิดที่ซับซ้อนกว่า และสาเหตุบางอย่างของ Overfitting ไม่สามารถแก้ไขได้ด้วย "Dropout"
"Overfitting" คืออะไร Overfitting เกิดขึ้นเมื่อโครงข่ายระบบประสาทเทียมเรียนรู้ "ไม่ดี" ในลักษณะที่ใช้ได้กับตัวอย่างการฝึก แต่ใช้ได้ไม่ดีนักกับข้อมูลในโลกแห่งความเป็นจริง มีเทคนิคการปรับค่าปกติ เช่น การดรอปเอาต์ ซึ่งบังคับให้โมเดลเรียนรู้ได้ดีขึ้น แต่การเกิด Overfitting ก็มีรากฐานที่ลึกกว่านั้น

การเกิด Overfitting ขั้นพื้นฐานเกิดขึ้นเมื่อโครงข่ายระบบประสาทเทียมมีระดับอิสระมากเกินไปสำหรับปัญหาที่กำลังพิจารณา ลองนึกภาพว่าเรามีนิวรอนจำนวนมากจนเครือข่ายสามารถจัดเก็บรูปภาพการฝึกทั้งหมดไว้ในนิวรอนเหล่านั้น แล้วจดจำรูปภาพได้ด้วยการจับคู่รูปแบบ และจะใช้งานกับข้อมูลในโลกแห่งความเป็นจริงไม่ได้เลย โครงข่ายระบบประสาทเทียมต้องมีข้อจำกัดบางอย่างเพื่อให้ต้องสรุปสิ่งที่เรียนรู้ระหว่างการฝึก
หากมีข้อมูลการฝึกน้อยมาก แม้แต่เครือข่ายขนาดเล็กก็สามารถจดจำข้อมูลนั้นได้ และคุณจะเห็น "การปรับมากเกินไป" โดยทั่วไปแล้ว คุณต้องมีข้อมูลจำนวนมากเสมอเพื่อฝึกโครงข่ายประสาทเทียม
สุดท้ายนี้ หากคุณทำทุกอย่างตามที่แนะนำ ทดลองใช้เครือข่ายขนาดต่างๆ เพื่อให้แน่ใจว่าระดับอิสระของเครือข่ายถูกจำกัด ใช้ Dropout และฝึกโมเดลด้วยข้อมูลจำนวนมาก คุณอาจยังคงติดอยู่ที่ระดับประสิทธิภาพที่ดูเหมือนว่าจะไม่มีอะไรปรับปรุงได้ ซึ่งหมายความว่าโครงข่ายประสาทเทียมในรูปแบบปัจจุบันไม่สามารถดึงข้อมูลเพิ่มเติมจากข้อมูลของคุณได้ ดังเช่นกรณีของเราที่นี่
คุณยังจำได้ไหมว่าเราใช้รูปภาพโดยแปลงเป็นเวกเตอร์เดียวได้อย่างไร นั่นเป็นความคิดที่แย่มาก ตัวเลขที่เขียนด้วยลายมือประกอบด้วยรูปร่างต่างๆ และเราทิ้งข้อมูลรูปร่างเมื่อทำให้พิกเซลแบน อย่างไรก็ตาม มีโครงข่ายระบบประสาทเทียมประเภทหนึ่งที่ใช้ประโยชน์จากข้อมูลรูปร่างได้ นั่นคือ โครงข่ายประสาทแบบคอนโวลูชัน มาลองใช้กัน
หากคุณติดขัด โปรดดูวิธีแก้ปัญหาในตอนนี้
10. [INFO] เครือข่าย Convolutional
ข้อมูลโดยสรุป
หากคุณทราบคำศัพท์ทั้งหมดที่ตัวหนาในย่อหน้าถัดไปแล้ว ให้ไปที่แบบฝึกหัดถัดไป หากคุณเพิ่งเริ่มต้นใช้งาน Convolutional Neural Network โปรดอ่านต่อ

ภาพ: การกรองรูปภาพด้วยฟิลเตอร์ 2 รายการที่ต่อเนื่องกันซึ่งประกอบด้วยน้ำหนักที่เรียนรู้ได้ขนาด 4x4x3=48
โครงข่ายระบบประสาทเทียมแบบ Convolution อย่างง่ายใน Keras มีลักษณะดังนี้
model = tf.keras.Sequential([
    tf.keras.layers.Reshape(input_shape=(28*28,), target_shape=(28, 28, 1)),
    tf.keras.layers.Conv2D(kernel_size=3, filters=12, activation='relu'),
    tf.keras.layers.Conv2D(kernel_size=6, filters=24, strides=2, activation='relu'),
    tf.keras.layers.Conv2D(kernel_size=6, filters=32, strides=2, activation='relu'),
    tf.keras.layers.Flatten(),
    tf.keras.layers.Dense(10, activation='softmax')
])
ในเลเยอร์ของเครือข่าย Convolutional "นิวรอน" จะทำการหาผลรวมแบบถ่วงน้ำหนักของพิกเซลที่อยู่เหนือขึ้นไปในบริเวณเล็กๆ ของรูปภาพเท่านั้น โดยจะเพิ่มอคติและป้อนผลรวมผ่านฟังก์ชันการเปิดใช้งาน เช่นเดียวกับที่นิวรอนในเลเยอร์ Dense ปกติจะทำ จากนั้นจะดำเนินการนี้ซ้ำกับทั้งรูปภาพโดยใช้น้ำหนักเดียวกัน โปรดทราบว่าในเลเยอร์แบบหนาแน่น นิวรอนแต่ละตัวจะมีน้ำหนักของตัวเอง ในที่นี้ "แพตช์" ของน้ำหนักจะเลื่อนไปทั่วรูปภาพในทั้ง 2 ทิศทาง (ซึ่งเรียกว่า "การสังวัตนาการ") เอาต์พุตมีค่ามากเท่ากับจำนวนพิกเซลในรูปภาพ (แม้ว่าอาจต้องมีการเว้นขอบบ้าง) ซึ่งเป็นการดำเนินการกรอง ในภาพด้านบน ใช้ตัวกรองที่มีน้ำหนัก 4x4x3=48
อย่างไรก็ตาม น้ำหนัก 48 รายการยังไม่เพียงพอ หากต้องการเพิ่มระดับอิสระ เราจะดำเนินการเดียวกันซ้ำโดยใช้ชุดน้ำหนักใหม่ ซึ่งจะสร้างเอาต์พุตตัวกรองชุดใหม่ เราจะเรียกช่องทางนี้ว่า "ช่องทาง" ของเอาต์พุตโดยเปรียบเทียบกับช่องทาง R,G,B ในรูปภาพอินพุต

คุณสามารถรวมชุดน้ำหนัก 2 ชุด (หรือมากกว่า) เป็น Tensor เดียวได้โดยการเพิ่มมิติข้อมูลใหม่ ซึ่งจะทำให้เราได้รูปร่างทั่วไปของเทนเซอร์น้ำหนักสำหรับเลเยอร์ Convolutional เนื่องจากจำนวนช่องอินพุตและเอาต์พุตเป็นพารามิเตอร์ เราจึงเริ่มซ้อนและเชื่อมโยงเลเยอร์ Convolutional ได้

ภาพประกอบ: โครงข่ายระบบประสาทเทียมแบบคอนโวลูชันจะเปลี่ยน "ก้อน" ข้อมูลให้เป็น "ก้อน" ข้อมูลอื่นๆ
การสังวัตน์แบบก้าวกระโดด การรวมสูงสุด
การดำเนินการ Convolution ด้วย Stride 2 หรือ 3 จะช่วยให้เราลดขนาด Data Cube ที่ได้ในมิติแนวนอนได้ด้วย ซึ่งมีวิธีทั่วไป 2 วิธีดังนี้
- การสังวัตน์แบบมีระยะก้าวกระโดด: ตัวกรองแบบเลื่อนตามที่อธิบายไว้ข้างต้น แต่มีระยะก้าวกระโดด > 1
- Max pooling: หน้าต่างเลื่อนที่ใช้การดำเนินการ MAX (โดยปกติจะใช้กับแพตช์ 2x2 ซึ่งทำซ้ำทุกๆ 2 พิกเซล)

ภาพประกอบ: การเลื่อนหน้าต่างการคำนวณ 3 พิกเซลจะทำให้ค่าเอาต์พุตน้อยลง การผสานรวมแบบ Strided หรือการรวมสูงสุด (สูงสุดในหน้าต่าง 2x2 ที่เลื่อนตามระยะก้าวย่าง 2) เป็นวิธีลดขนาดก้อนข้อมูลในมิติแนวนอน
เลเยอร์สุดท้าย
หลังจากเลเยอร์ Convolutional สุดท้าย ข้อมูลจะอยู่ในรูปแบบ "คิวบ์" การป้อนข้อมูลผ่านเลเยอร์ Dense สุดท้ายทำได้ 2 วิธี
วิธีแรกคือการทำให้คิวบ์ข้อมูลแบนราบเป็นเวกเตอร์ แล้วป้อนไปยังเลเยอร์ Softmax บางครั้งคุณอาจเพิ่มเลเยอร์ Dense ก่อนเลเยอร์ Softmax ได้ด้วย ซึ่งมักจะมีค่าใช้จ่ายสูงในแง่ของจำนวนพารามิเตอร์ ชั้นหนาแน่นที่ส่วนท้ายของเครือข่าย Convolutional อาจมีน้ำหนักมากกว่าครึ่งหนึ่งของโครงข่ายระบบประสาทเทียมทั้งหมด
เรายังสามารถแบ่ง "ก้อน" ข้อมูลขาเข้าออกเป็นหลายส่วนตามจำนวนคลาส เฉลี่ยค่า และป้อนค่าเหล่านี้ผ่านฟังก์ชันการเปิดใช้งาน Softmax แทนการใช้เลเยอร์แบบหนาแน่นที่มีราคาแพงได้ด้วย การสร้างส่วนหัวการแยกประเภทด้วยวิธีนี้จะไม่มีค่าใช้จ่าย ใน Keras มีเลเยอร์สำหรับสิ่งนี้: tf.keras.layers.GlobalAveragePooling2D()

ข้ามไปยังส่วนถัดไปเพื่อสร้างเครือข่าย Convolutional สำหรับปัญหาที่กำลังพิจารณา
11. เครือข่าย Convolutional
มาสร้างเครือข่าย Convolutional สำหรับการจดจำตัวเลขที่เขียนด้วยลายมือกัน เราจะใช้เลเยอร์ Convolutional 3 เลเยอร์ที่ด้านบน เลเยอร์อ่านค่า Softmax แบบดั้งเดิมที่ด้านล่าง และเชื่อมต่อเลเยอร์เหล่านั้นด้วยเลเยอร์ Fully-Connected 1 เลเยอร์

โปรดสังเกตว่าเลเยอร์ Convolutional ที่ 2 และ 3 มีระยะก้าวยาว 2 ซึ่งอธิบายได้ว่าเหตุใดเลเยอร์ดังกล่าวจึงลดจำนวนค่าเอาต์พุตจาก 28x28 เป็น 14x14 และจากนั้นเป็น 7x7
มาเขียนโค้ด Keras กัน
ต้องพิจารณาเป็นพิเศษก่อนเลเยอร์ Convolutional แรก ซึ่งคาดหวังว่าจะมี "ลูกบาศก์" ข้อมูล 3 มิติ แต่ชุดข้อมูลของเราได้รับการตั้งค่าสำหรับเลเยอร์หนาแน่นและพิกเซลทั้งหมดของรูปภาพจะแบนเป็นเวกเตอร์ เราต้องปรับรูปร่างกลับเป็นรูปภาพขนาด 28x28x1 (1 แชแนลสำหรับรูปภาพระดับสีเทา)
tf.keras.layers.Reshape(input_shape=(28*28,), target_shape=(28, 28, 1))
คุณใช้บรรทัดนี้แทนเลเยอร์ tf.keras.layers.Input ที่คุณมีจนถึงตอนนี้ได้
ใน Keras ไวยากรณ์สำหรับเลเยอร์ Convolution ที่เปิดใช้งาน "relu" คือ

tf.keras.layers.Conv2D(kernel_size=3, filters=12, padding='same', activation='relu')
สำหรับการ Convolution ที่มีระยะก้าวนั้น คุณจะเขียนได้ดังนี้
tf.keras.layers.Conv2D(kernel_size=6, filters=24, padding='same', activation='relu', strides=2)
หากต้องการแปลงคิวบ์ข้อมูลเป็นเวกเตอร์เพื่อให้เลเยอร์หนาแน่นใช้ได้ ให้ทำดังนี้
tf.keras.layers.Flatten()
และสำหรับเลเยอร์หนาแน่น ไวยากรณ์จะยังคงเหมือนเดิม
tf.keras.layers.Dense(200, activation='relu')
โมเดลของคุณทำลายกำแพงความแม่นยำ 99% ได้ไหม เกือบถูกแล้ว... แต่ดูที่เส้นโค้งการสูญเสียการตรวจสอบ คุณคุ้นๆ ไหม

และดูการคาดการณ์ด้วย เป็นครั้งแรกที่คุณควรเห็นว่าระบบจดจำตัวเลขทดสอบ 10,000 ตัวส่วนใหญ่ได้อย่างถูกต้องแล้ว เหลือเพียงประมาณ 4½ แถวที่ตรวจจับผิดพลาด (ประมาณ 110 หลักจาก 10,000 หลัก)

หากคุณติดขัด โปรดดูวิธีแก้ปัญหาในตอนนี้
12. Dropout อีกครั้ง
การฝึกก่อนหน้านี้แสดงให้เห็นสัญญาณที่ชัดเจนของการเกิด Overfitting (และยังคงมีความแม่นยำไม่ถึง 99%) เราควรลองใช้ Dropout อีกครั้งไหม
ครั้งนี้เป็นอย่างไรบ้าง

ดูเหมือนว่าการดรอปเอาต์จะใช้ได้ในครั้งนี้ การสูญเสียการตรวจสอบไม่เพิ่มขึ้นอีกต่อไป และความแม่นยำสุดท้ายควรสูงกว่า 99% ยินดีด้วย
ครั้งแรกที่เราพยายามใช้ Dropout เราคิดว่าเรามีปัญหา Overfitting แต่จริงๆ แล้วปัญหาอยู่ที่สถาปัตยกรรมของโครงข่ายระบบประสาทเทียม เราไม่สามารถดำเนินการต่อได้หากไม่มีเลเยอร์ Convolutional และไม่มีอะไรที่ Dropout จะทำได้
คราวนี้ดูเหมือนว่า Overfitting เป็นสาเหตุของปัญหา และการดรอปเอาต์ช่วยได้จริง โปรดทราบว่ามีหลายสิ่งหลายอย่างที่อาจทำให้เส้นโค้งการสูญเสียการฝึกและเส้นโค้งการสูญเสียการตรวจสอบไม่สอดคล้องกัน โดยการสูญเสียการตรวจสอบจะเพิ่มขึ้น การปรับมากเกินไป (มีระดับอิสระมากเกินไป ซึ่งเครือข่ายใช้ไม่ดี) เป็นเพียงหนึ่งในนั้น หากชุดข้อมูลมีขนาดเล็กเกินไปหรือสถาปัตยกรรมของโครงข่ายระบบประสาทเทียมไม่เพียงพอ คุณอาจเห็นลักษณะการทำงานที่คล้ายกันในเส้นโค้งการสูญเสีย แต่ Dropout จะไม่ช่วย
13. การแปลงข้อมูลเป็นรูปแบบมาตรฐานแบบกลุ่ม

สุดท้าย ลองเพิ่มการทําให้เป็นมาตรฐานแบบกลุ่ม
ในทางทฤษฎีแล้ว คุณเพียงแค่ต้องจำกฎ 2-3 ข้อต่อไปนี้
ตอนนี้เรามาทำตามตำรากันก่อนและเพิ่มเลเยอร์ Batch Norm ในแต่ละเลเยอร์ของโครงข่ายระบบประสาทเทียม ยกเว้นเลเยอร์สุดท้าย อย่าเพิ่มลงในเลเยอร์ "softmax" สุดท้าย ซึ่งจะไม่มีประโยชน์ในกรณีดังกล่าว
# Modify each layer: remove the activation from the layer itself.
# Set use_bias=False since batch norm will play the role of biases.
tf.keras.layers.Conv2D(..., use_bias=False),
# Batch norm goes between the layer and its activation.
# The scale factor can be turned off for Relu activation.
tf.keras.layers.BatchNormalization(scale=False, center=True),
# Finish with the activation.
tf.keras.layers.Activation('relu'),
ตอนนี้ความแม่นยำเป็นอย่างไร

เพียงปรับแต่งเล็กน้อย (ขนาดกลุ่ม=64, พารามิเตอร์การลดอัตราการเรียนรู้ 0.666, อัตราการหลุดบนชั้นหนาแน่น 0.3) และโชคดีเล็กน้อย คุณก็จะได้ 99.5% การปรับอัตราการเรียนรู้และการปรับ Dropout ดำเนินการตาม "แนวทางปฏิบัติแนะนำ" สำหรับการใช้ Batch Norm
- Batch Norm ช่วยให้โครงข่ายประสาทเทียมบรรจบกันและมักจะช่วยให้คุณฝึกได้เร็วขึ้น
- Batch Norm เป็นตัวควบคุม โดยปกติแล้ว คุณสามารถลดจำนวนการดรอปเอาต์ที่ใช้ หรือแม้แต่ไม่ใช้การดรอปเอาต์เลยก็ได้
สมุดบันทึกโซลูชันมีการฝึก 99.5% ดังนี้
14. ฝึกในระบบคลาวด์บนฮาร์ดแวร์ประสิทธิภาพสูง: AI Platform

คุณจะเห็นโค้ดเวอร์ชันที่พร้อมใช้งานในระบบคลาวด์ในโฟลเดอร์ mlengine บน GitHub พร้อมกับวิธีการเรียกใช้ใน AI Platform ของ Google Cloud ก่อนที่จะเรียกใช้ส่วนนี้ คุณจะต้องสร้างบัญชี Google Cloud และเปิดใช้การเรียกเก็บเงิน ทรัพยากรที่จำเป็นในการทำแล็บควรมีมูลค่าไม่เกิน 2 ดอลลาร์ (สมมติว่าใช้เวลาฝึก 1 ชั่วโมงใน GPU เครื่องเดียว) วิธีเตรียมบัญชี
- สร้างโปรเจ็กต์ Google Cloud Platform ( http://cloud.google.com/console)
- เปิดใช้การเรียกเก็บเงิน
- ติดตั้งเครื่องมือบรรทัดคำสั่งของ GCP ( GCP SDK ที่นี่)
- สร้าง Bucket ของ Google Cloud Storage (วางไว้ในภูมิภาค
us-central1) ระบบจะใช้ Bucket นี้เพื่อจัดเตรียมโค้ดการฝึกและจัดเก็บโมเดลที่ฝึกแล้ว - เปิดใช้ API ที่จำเป็นและขอโควต้าที่จำเป็น (เรียกใช้คำสั่งการฝึก 1 ครั้ง แล้วคุณจะได้รับข้อความแสดงข้อผิดพลาดที่บอกให้คุณเปิดใช้)
15. ยินดีด้วย
คุณได้สร้างโครงข่ายระบบประสาทเทียมแรกและฝึกให้มีความแม่นยำถึง 99% เทคนิคที่ได้เรียนรู้ตลอดเส้นทางนี้ไม่ได้เจาะจงเฉพาะชุดข้อมูล MNIST แต่จริงๆ แล้วเทคนิคเหล่านี้มีการใช้กันอย่างแพร่หลายเมื่อทำงานกับโครงข่ายประสาท เราขอมอบการ์ด "สรุปย่อ" สำหรับห้องทดลองในเวอร์ชันการ์ตูนให้คุณเป็นของขวัญส่งท้าย คุณสามารถใช้ฟีเจอร์นี้เพื่อจดจำสิ่งที่ได้เรียนรู้ได้โดยทำดังนี้

ขั้นตอนถัดไป
- หลังจากเครือข่ายที่เชื่อมต่ออย่างสมบูรณ์และเครือข่าย Convolutional แล้ว คุณควรดูเครือข่ายประสาทแบบเกิดซ้ำ
- Google Cloud มี AI Platform เพื่อเรียกใช้การฝึกหรือการอนุมานในระบบคลาวด์บนโครงสร้างพื้นฐานแบบกระจาย
- สุดท้ายนี้ เรายินดีรับฟังความคิดเห็น โปรดแจ้งให้เราทราบหากคุณพบสิ่งผิดปกติในฟีเจอร์ทดลองนี้หรือหากคิดว่าควรมีการปรับปรุง เราจัดการความคิดเห็นผ่านปัญหาใน GitHub [feedback link]

|
|
 ผู้เขียน: Martin GörnerTwitter:

ภาพการ์ตูนทั้งหมดในห้องทดลองนี้มีลิขสิทธิ์ของ alexpokusay / 123RF stock photos